







软件架构的工作,除了搞清楚应该设计多少、什么样的组件来实现需求,还应该考虑组件之间的依赖关系。SOLID 原则之一的「依赖反转原则」是指数据流向应该与依赖的方向相反,比方说,数据从后端流向前端,但后端不应该依赖前端,而是要让前端调用后端提供的接口。此外,组件之间有抽象和具体之分,核心业务逻辑就是高度抽象的,而数据库逻辑(用什么样的数据库、用什么 ORM、具体怎么实现)就是相当具体的,业务逻辑不应该依赖数据库逻辑,这怎么做到呢?
比方说,我的业务逻辑是:不断接收某个源喂过来的数据,如果某条数据满足条件,就把它存在数据库里。如果我要编写这整个链路,难道不是要引用数据库组件吗?我怎么做到不直接依赖组件?
接下来我将分别演示在 OOP1 语言中和在函数式编程语言中,如何实现「不依赖数据库组件,但描述存储操作」。我使用的语言是 Go 和 Clojure,其中 Go 不是纯面向对象语言(缺少继承机制),Clojure 也不是纯函数式语言(但我也不会写 Haskell 啊),但用到的思想和语言特性是可迁移的。
[1]
Objective-Oriented Programing,面向对象编程 ↩︎
接口定义其实比核心业务逻辑还要抽象,因为接口只定义了一系列函数签名,而没有包含任何具体实现,而核心业务逻辑还包含对相关函数的实现。依赖关系应该从具体的逐渐指向抽象的,核心业务逻辑依赖最抽象的接口便符合这个原则。
我们先定义一个接口:
package interfaces

type EntryStorage interface {
    GetEntry(id int) Entry
    PutEntry(entry Entry)
    DeleteEntry(id int)
}
接下来业务逻辑只要依赖这个接口就好了:
package receiver

import "example.com/interfaces"

type Engine struct {
    Storage EntryStorage
}

// ReceiveEntry 检查数据条目是否合格,如果合格就存储
// 并返回 true,如果不合格就返回 false
func (e *Engine) ReceiveEntry(entry Entry) bool {
    if (isQualified(entry)) {
        e.Storage.PutEntry(entry)
        return true
    }
    return false
}
此时,我们还没有编写 EntryStorage 的具体实现,我们不知道它用什么数据库,甚至不知道它用不用数据库,EntryStorage 完全可以把数据条目放进内存里、写进磁盘文件里、上传到某个云服务,甚至直接丢弃。
我们不需要编写具体实现也能测试这个软件,测试用例可以这样写:
package receiver

import "test"

// 就地实现一个假的存储
// 不仅因为我们不需要真的存储
// 还因为测试业务逻辑时,本就不应该关心存储有没有问题
// 不能让持久层的问题也让业务逻辑的测试用例失败
type FakeStorage struct {
    data []Entry
}

func (s *FakeStorage) GetEntry(id int) {
    return s.data[id]
}

func (s *FakeStorage) PutEntry(entry Entry) {
    s.data = append(s.data, entry)
}

func (s *FakeStorage) DeleteEntry(id int) {
    s.data = append(s.data[:id], s.data[id+1:]...)
}
// 至此,我们已经写完了实现 EntryStorage 接口的必要函数
// FakeStorage 现在可以直接注入到业务逻辑中进行测试了
// 你或许会觉得把 id 当成 Slice 的索引不太合适
// 但这仅仅是测试而已,只要不影响测试用例的有效性就好

func TestReceiveEntryQualified() {
    // 装配出完整的业务逻辑引擎
    storage := FakeStorage{ data: make([]Entry, 0) }
    engine := Engine{ Storage: storage }

    // 注入假数据并测试
    entry := makeQualifiedFakeEntry()
    ok := engine.ReceiveEntry(entry)

    if !ok {
        t.Errorf(`ReceiveEntry(qualifiedEntry) = %v, want true, nil`, ok)
    }
}
如果想要手动启动一个能够运行的实例,也不必着急实现数据库逻辑,同样的 FakeStorage 也可以在启动时喂给业务逻辑,它不知道也不关心数据最后去了哪里。有关接口的更多用法,可以阅读我的另一篇文章《
Are We Interfacing Yet?
》。
在函数式编程语言中,函数可以作为值传递,像这样:
element.onclick = (event) => {
    alert("我被点击了!")
}
这段 JavaScript 代码给 DOM 元素的 onclick 字段赋值,赋值的内容是一个函数定义。当元素被点击时,它就会执行 onclick() 函数,也就执行了我们传递给它的代码。这种函数一般也叫作回调函数(callback)。在支持函数作为一等公民的动态类型语言中,完全可以通过传递回调函数来实现接口能做到的事情——如果不在乎类型安全的话。
我们假设 engine 有一个 :storage 字段,这个字段是映射(map)类型,里面存的全是函数。
(def storage {:get-entry entry-storage/get-entry
              :put-entry entry-storage/put-entry
              :delete-entry entry-storage/delete-entry})
(def engine {:storage storage})
注意,这只是假设,我们实际上还没有构造这个 storage 常量,因为 entry-storage 这个命名空间还不存在,我们还没有实现具体的数据库逻辑。这个 storage 是在装配的过程中被喂给业务逻辑的。
跳过接口定义,直接开始写业务逻辑。在此之前要说明 Clojure 的一些语法,Clojure 可以用关键词取出映射中的某个值,就像这样:(:get-entry storage)——这段表达式会返回 storage 当中键为 :get-entry 的值,在这里返回的就是一个函数引用。要调用这个函数,就要这样写 ((:get-entry storage) args ...)。
(defn receive-entry [engine entry]
  (let [storage (:storage engine)]
    (if (qualified? entry)
      (do
          ((:put-entry storage) entry)
          true)
      false)))
同样地,如果要测试这个程序,只需要传入一个假的 storage。甚者,由于不需要实现接口,也就不需要实现接口中所有的函数,我们可以让 fake-storage 只包含这个测试文件用到的函数。再甚,我们都不需要真的实现任何形式的存储。
(def fake-storage {:put-entry #(println % "已保存!")})
(def fake-engine {:storage fake-storage})
(def entry (make-qualified-fake-entry))

(defn test-receive-entry-qualified []
  (is (receive-entry fake-engine entry)))
;; 这个测试用例太短了可能让人难以理解
;; is 是 Clojure 的断言语句,传入的是 true 就表示测试通过
;; 这里 receive-entry 收到的是合格的 entry
;; 照理来说就应该返回 true,所以直接把它的返回值放进 is 里
这样一个包含函数引用的映射,叫作 vtable。这么做当然有明显的坏处,没有类型定义,我们无法确定得到的 storage 映射是否真的包含我们需要的函数引用,也不确定得到的函数的函数签名(形参和返回值)如我们预期的一样。这看起来的确是动态类型语言的缺陷,但如你所见,我们已经写了测试用例了,倘若我们的 vtable 真的有问题,它会呈现在单元测试的结果里。只要写了覆盖率高且合格的测试,就不必担心类型问题会导致软件健壮性下降;反之,不写测试用例,紧紧依靠编译器的类型判断的静态语言程序,也不见得有多安全。
而且你看看没有接口和类型定义的 Clojure 代码有多简短吧!
如你所见,通过编写接口或使用回调函数,我们让软件中某些具体的部分变成了插件。还是以 JavaScript 举例,网页中的一个按钮点击之后具体会发生什么就是具体实现,而按钮可以点击这个事实就是一个接口,或者说协议。这个协议可以被更清晰地阐述为:点击了按钮之后就会发生某些事情。所谓的「某些事情」是抽象的、不定的、可替换的、可插拔的。JavaScript 通过回调函数实现这个协议。
编程实际上就是类似于「点击按钮之后会发生某些事情」的对目标系统的描述,只不过使用了特定的编程语言。如 Frederick Brooks 在《No Silver Bullet》中所言,软件的内在性问题之一是易变性。如何应对软件需要经常改变的事实?把相对不容易改变的东西和容易改变的东西分离开来,不容易改变的就是最抽象、最高层次的业务逻辑,容易改变的东西就是数据库、按钮做的「某些事情」的具体实现。网页上每个按钮的行为都不一样,可以说按钮的行为是具体且易变的,那为什么每次有人要做一个按钮的时候,我们不需要修改按钮内部的代码?那是因为我们已经用回调函数把抽象的和具体的隔离开来了。这种设计无处不在,以至于人们使用的时候毫无感知,自己需要设计的时候就很难考虑到这点了。
再回顾前文有关存储层的例子。假设已经实现了基于 MySQL 的存储,但用户突然要求兼容 PostgreSQL,只需要用 PostgreSQL 的相关库实现 EntryStorage 接口(也就是那三个函数),然后在装配 Engine 时,把 MySQL 的具体实现换成 PostgreSQL 的具体实现。存储层是可插拔的。
再假设,你在开发这个软件的期间一直使用 FakeStorage 把数据存在内存里,等核心的逻辑都完成时,你突然意识到这个软件要存储的数据体量非常小,而且读写的频率很低,连 SQLite 都不用上,用 JSONL 文件存储就行了。这下你就不必设计数据库 Schema 和编写 SQL 语句了,用 Go 语言自带的 JSON 标准库读写磁盘文件就好了。接下来你用几行代码实现了 JsonEntryStorage,插入 Engine,完全不用修改 Engine 里面的代码。
软件的其他部分也都可以这么做,让各种组件都变成核心业务逻辑的插件,一方面把复杂度外包出去,软件最中心、最内部的组件只需要描述「点击按钮之后会发生某些事情」这类简单且清晰的逻辑;另一方面,面对需求的变更,只要不涉及最核心的业务逻辑,可以把变更集中外围的一两个插件当中。在开发的初期阶段,完全可以把精力放在最重要、最核心的逻辑上,把数据库等底层细节都抛之脑后。
开发者只需要在编写核心业务逻辑的时候留下几个必要的接口,调试时可以使用假的、简化的实现,之后再将真实的实现装配和注入到核心组件中。虽然很不愿意称赞这门邪恶的语言,但是 Java 生态里的 Spring 框架做的就是这件事情。Java/Spring 程序员往往不需要让组件之间相互依赖,Spring 会自动将具体实现装配到对应的类当中。有一说一,这种自动化的依赖注入和控制反转(DI/IoC)框架过于方便,导致我观察到的很多学艺不精的 Java 程序员对基本的架构设计原则毫无认知。
在我看来,这让编程变得跟写伪代码一样简单,描述某个软件行为却发现自己需要用到另一个组件时,或者想要把某个组件分离出去时,只需要假设某个类、某个函数存在,然后直接写就好。比方说,前文我就假设了 isQualified(entry Entry) bool 存在(在 Clojure 的例子中,我用的是 (qualified? entry)),但之前的写法并没有留出接口,让我稍作修改:
package receiver

import "example.com/interfaces"

type Engine struct {
    Storage EntryStorage
    Judge   EntryJudge
}

func (e *Engine) ReceiveEntry(entry Entry) bool {
    if (e.Judge.IsQualified(entry)) {
        e.Storage.PutEntry(entry)
        return true
    }
    return false
}
EntryJudge 的定义自然是:
type EntryJudge interface {
    IsQualified(entry Entry) bool
}
这是 Go 推崇的「小接口」,更方便组合复用。上面的例子中,我把多个接口组合在一个结构体里,供核心业务逻辑 ReceiveEntry() 使用。如果遇到更复杂的逻辑,也可以拆出更多的抽象接口,而我们在一开始只需要面向接口编程,不需要考虑肮脏的底层细节扰乱心智,也不会因为迟迟解决不了某个数据库连接问题而在一开始就感到挫败。
对于那些愿意与 LLM Agent 合作的人,手写接口定义和最抽象的核心业务逻辑并不困难,而留下了明确的接口、函数签名、使用场景和预期行为之后,LLM 也更有可能生成准确的代码。而且,即便没有审查 LLM 生成的具体实现(不推荐不审查就交付代码),也不会因为代码量增长而失去对整个代码库的理解,因为最核心的逻辑是开发者自己手写的。
我把这种近似伪代码的编程方式称作「骷髅编程」,至于后续是人还是 LLM 来填充血肉,都不影响骨架的正确性。
我最近在考虑写这样一个软件,背景是这样的:既然写博客的人有不少都喜欢相互引用,如果跟随这些引用,有没有可能最终回到自己的网站呢?如果可能,那需要经过多久呢?在路上会遇到什么样的网站?具体的需求就是:给定一个网站,找到这个网站的一些外链,分别爬取这些外链并找到他们引用的外链,这样一直跟随外链,直到找到链接到自己网站的外链。
好,既然需求已经清晰了,就直接开写吧。我选择用 Clojure 手写。之前我用 Clojure 写的例子都是用 vtable 实现的可插拔架构,其实这门语言也有接口(或者说协议),可以用 defprotocol 定义。
其实我希望我的核心业务逻辑本身就是一个接口,如果我的业务逻辑有了很大的改变,我也可以写新的实现来替换,抑或是我需要给用户提供两种截然不同的模式来完成这个需求,也可以根据配置装配不同的接口实现来实现模式切换。
;; 我给这个核心组件取名为奥德修斯(Odysseus)
;; 因为我们要做的事情就是送它出去,然后让他找到回家的路
(defprotocol Odysseus
  "Core engine, into which other components are loaded."
  (start [this] "Get Odysseus on his way."))

;; 以下是我们的具体实现
;; 它现在连骨架都没有,还只是个空壳
(defrecord Ody []
  Odysseus
  (start [_this]
    (println "Starting Ody...")))

;; main 函数是程序的入口,它创建 Odysseus 引擎
;; 然后调用 start 函数启动它
;; 之后我们也会把新增的组件装配在这里
(defn -main
  [& args]
  (let [ody (Ody.)]
    (start ody)))
现在执行这个程序只会打印 Starting Ody...,是时候搭建骨架了。在此之前,回顾我们的需求描述。
给定一个网站,找到这个网站的一些外链,分别爬取这些外链并找到他们引用的外链,这样一直跟随外链,直到找到链接到自己网站的外链。
那么这个骨架应该包含:
我已经看出循环和递归的结构了,这个程序就是一直在提取外链而已。不少程序员的直觉可能是立刻动手开始编写获取 HTML 网页的逻辑,考虑应该使用正则匹配还是类似 Beautiful Soup 的解析工具,获取到一条环路之后应该存哪儿这些问题。But you and I should know better.
照着我现在的理解,先写一段代码试试看:
(defrecord Ody [home over? crawler ]
  Odysseus
  (start [_this]
    (println "Starting Ody...")
    (loop [journey []]
      (when (empty? journey)
        (recur [home]))
      (when (over? journey)
        journey)
      (let [ways (find-ways crawler (last journey))]
        ;; ...
        ))))
我在写的时候遇到了一个问题,但在讨论这个问题之前,先来看看我写了些什么。
loop 是 Clojure 中的循环结构,它的第一个参数是可变数量的 binding,装在一个向量类型(也就是 [])里面。你可以理解为我们构造了一个函数,而在这个 binding 里填入的是函数的参数和参数的初始值。loop 体中有 recur 函数,这就是递归的意思。recur 让程序重新回到 loop 体的开头,并且重新给 binding 赋值——这其实就是递归函数,只不过用了循环的写法,而且 Clojure 给 recur 做了优化,即便多次递归也不会让函数调用栈溢出。
在这个递归函数里,程序先判断 journey 是否为空,如果为空就递归并传入 [home] 作为 journey 的新值。这个 home 就是环路的起点也是终点。由于在写代码的过程中意识到我需要 home 的值作为起点,所以我在 Ody 的字段里添加了 home。我用向量类型表示一条路径,向量的第一个元素是起点,中间的元素是路途中经过的链接,最后一个元素是终点,也就是说,当第一个元素和最后一个元素相等时,这个 journey 就可以作为结果返回了。
不过,我没有写 (= (first journey) (last journey)),而是引入了回调函数 over?,使用它判断是否结束。前者是具体的,后者是抽象的。还有一个考量是,判断环路是否找到的标准不定,是找到完全一样的 URL 才算呢?还是找到同一个域名就算呢?还是找到同一个子域的也算呢?不知道,不关心,写个抽象的函数先用着吧。由于在写代码的过程中意识到要有一个判断路途是否结束的函数,所以我在 Ody 的字段里添加了 over?。
如果 journey 既不是空的,也没有被判定结束,那么就说明搜寻还在进行当中。这个阶段要做的事情,就是爬取最新的一条 URL((last journey)),找到新的外链。一如既往,我意识到自己需要一个爬虫,所以添加了 crawler 字段,调用它将会提供的 find-ways 函数获取外链。这之后,只要用其中一个 URL 作为新的 (last journey),再次递归就好了。
等等,「其中一个」?如果一个页面有多个外链,我要怎么确定应该用哪一个?话说回来,我肯定不能让程序只找到一条环路就停下吧?这样简单的操作完全可以并发执行,可如果要并发执行,而每递归一次都会得到多个外链的话,并发数不会指数级上升吗?就算控制全局并发数,似乎也有太多任务了,根本跑不完,看起来应该做剪枝和限制,比方说剔除掉不太可能引用自己的网站(Microsoft、Google 等),除了自己的网站,后面的每一条最多发散出 3 条外链等等。
不管不管,太复杂了,先抽象出一个门卫组件干这个事情吧,具体实现之后再说。
(let [ways (->> (last journey)
                (find-ways crawler)
                (filter-ways gatekeeper))]
  ;; ...
)
至于并发控制,Clojure 支持和 Go 一样的并发模型,所以我们只需要一个固定缓冲大小的 channel 就好,此时就要考虑两种模式:
channel 当作信号量(semaphore)来用,初始化时存入几个空值当作信号量,每当有人试图并发一个新的爬取任务时,都要尝试获取信号量,如果信号量消耗完了,就要原地等待。channel 里,让几个独立的爬虫协程读这个 channel;当缓冲写满,而爬虫的消费能力不足时,尝试写入 channel 的协程就会被阻塞。爬取一直在进行,而 gatekeeper 和 over? 等组件,包括 Odysseus 本身,都自动地根据爬虫的消费能力调整任务进行的速度。第二种模式还解决了任务分发的问题,看起来也很干净。实际上这还把爬虫 crawler 与核心逻辑 Odysseus 解耦了,我只需要把爬取请求放进 channel 里,然后等待结果就好了。不过这引发了新的问题:没有函数调用就没有返回值,我要怎么拿到爬取结果呢?
这个好解决,我们可以塞一个向量给 channel,向量的第一个元素是要爬取的 URL,第二个元素是一个新的 channel,等爬取任务完成之后,爬虫就把结果写入这个 channel,而 Odysseus 这边只需要等待就好了。另外,如果决定把 crawler 分离出去,那在收到 crawler 的结果之后再用 gatekeeper 筛一遍,似乎有些没道理,可以把 gatekeeper 和 crawler 装配到一起,而 crawler 只返回已经过滤之后的结果——幸好我们的组件都很小巧抽象,做这样的改动并不会很麻烦。
(defn- start-worker [crawler gatekeeper crawl-queue]
        (go-loop [task (<! crawl-queue)]
                 ;; task is a vector like [url channel]
                 (let [urls (->> (first task)
                                 (find-ways crawler)
                                 (filter-ways gatekeeper))]
                   (>! (last task) urls))
                 (recur (<! crawl-queue))))

(defrecord workers [crawler gatekeeper crawl-queue] Workers
  (start-workers [_this n]
    (dotimes [_ n]
      (start-worker crawler gatekeeper crawl-queue))))
如你所见,这段代码可以启动 n 个 worker,而每个 worker 都是一个异步的循环,一直尝试从 crawl-queue 中读取任务。一旦读取到任务,就用 crawler 爬取外链,用 gatekeeper 过滤外链,然后把结果通过 channel 返回。至于核心逻辑 Odysseus 这边,只需要把任务传给 crawl-queue,然后从自己设定的 channel 中取出数据就好了。
不过我很快发现 loop 和 recur 已经不适合 Odysseus 了,因为每次循环都可能发散出多个 URL,但一个 loop 只能用一次 recur,也就是只能传递一条新的 journey 路径给下一级递归。为了产生多条分支,是时候请出真正的递归函数了!
(defn- hop [journey over? home crawl-queue]
  (let [journey (if (empty? journey) [home] journey)]
    (if (over? journey)
      ;; if journey's over, print the only one
      [journey]
      ;; if not, keep crawling and find fresh urls
      ;; start multiple hop forks and concat their result together
      (let [receive-chan (chan)]
        (>!! crawl-queue [(last journey) receive-chan])
        (let [urls (<!! receive-chan)]
          (mapcat #(hop (conj journey %) over? home crawl-queue) urls))))))

(defrecord Ody [home over? crawl-queue] Odysseus
           (start [_this]
             (hop [] over? home crawl-queue)))
其实一开始我就犯了个小错误,Odysseus 返回的不应该是一条 journey,应该是它能找到的所有环路。这里提取出来的递归函数是 hop(跳)。如果 journey 是空的就直接改成 [home],没必要再递归一次。如果判定结束了,就返回只包含一个环路的向量 [journey]。如果没结束就继续往下,把 URL 用 channel 交给爬虫 workers。拿到多个 URL 结果之后,对每个 URL 执行一次 hop 递归,最后把子 hop 的结果全部拼接起来——这一步用 mapcat 就可以做到,非常省事。
现在还剩下的问题是,尽管爬虫是异步的,与核心逻辑解耦了,但核心逻辑本身是串行的,一次递归执行完毕之后才执行下一个,同时也只会有一个爬取任务被传入 crawl-queue,根本利用不了并发资源。所以,要把 hop 也改成并行的。
本 Go 程序员写 Go 程序写得太多了,一开始也想用 go 让 hop 并行,然后便踩了坑,写出了很复杂的代码。实际上 Go 标准库里的 future 就足够好用。future 同样异步执行,返回一个引用 ref,之后 deref(或者用语法糖 @)就能拿到结果,如果 future 没有完成,deref 的调用者就会原地等待。
(defn- hop [journey over? home crawl-queue]
  (future (let [journey (if (empty? journey) [home] journey)]
    (if (over? journey)
      ;; if journey's over, print the only one
      [journey]
      ;; if not, keep crawling and find fresh urls
      ;; start multiple hop forks and concat their result together
      (let [receive-chan (chan)]
        (>!! crawl-queue [(last journey) receive-chan])
        (let [urls (<!! receive-chan)
              futures (mapv #(hop (conj journey %) over? home crawl-queue) urls)
              results (mapv deref futures)]
          (apply concat results)))))))
现在就可以了,hop 并发了更多的递归 hop,之后再逐个等待结果。看起来并发之后立刻阻塞并等待,好像和直接调用没有区别,但关键的区别在于,如果把递归结构看成一棵树的话,我们就不是在进行深度优先遍历,而是并发地对每个子树同时进行遍历。23由于我们用了有缓冲的 channel,hop 在把任务放进爬取队列时就可能因为缓冲区已满而阻塞,只要设置合理的缓冲区大小,就不用担心性能问题。
[2]
咳咳,这里是几个小时后的 Eltrac。我发现这段代码有个致命的问题:它实际上仅仅是创建个一个又一个被阻塞的线程,实际速度和同步递归没差…… 主要的问题是,任务的生产者和消费者都是同一实体,照理来说应该分开,一开始用 go 和 channel 的思路是对的。事已至此,先这样吧,我累了。 ↩︎
[3]
既然已经调用了 mapv,换成 pmap,再做些调整兴许就能解决。pmap 的意思是 Parallel map,多个操作是并发执行的,会快很多。 ↩︎
不过,即便是并发,网络操作仍然很慢,我们不能等程序把所有的环路都找到了之后才打印结果吧?是不是应该每找到一个结果就打印一次?要在 hop 里调用 println?不不不,如果这个软件要做成 Web 程序、GUI 程序呢?要怎么收集到这些结果?显然 println 是具体实现。那只要换成一个抽象函数就好了。
(defn- hop [journey over? home crawl-queue put-result]
  (future (let [journey (if (empty? journey) [home] journey)]
    (if (over? journey)
      ;; if journey's over, print the only one
      (put-result journey)
      [journey]
      ;; if not, keep crawling and find fresh urls
      ;; start multiple hop forks and concat their result together
      (let [receive-chan (chan)]
        (>!! crawl-queue [(last journey) receive-chan])
        (let [urls (<!! receive-chan)
              futures (mapv #(hop (conj journey %) over? home crawl-queue put-result) urls)
              results (mapv deref futures)]
          (apply concat results)))))))
很好,现在骨架只知道「要把结果放到某个地方」,并不关心放在那里。最简单的实现是把结果放进 channel 里,让消费者自取,这样的话我们甚至不需要写函数定义,在 put-result 的位置传入 (partial put! result-queue) 就好,partial 返回的是预先填好了几个参数的函数。这么说的话,我们也不必把 crawl-queue 这种细节暴露给 hop,也可以改为抽象函数。由于两个都和传送数据的通道相关,不妨放进一个 vtable 里,就叫 pipelines(管线)吧。事已至此,就干脆把这个包里的 clojure.core.async 引用移除掉,所有关于 channel 的操作都是具体的,应该交由外部实现来解决。
我又发现 home 这个参数完全没有意义,我为什么不能一开始就传入 [home] 而不是空向量 [] 呢?于是也顺带改了。
在添加新功能(每找到一个环路就上报一次)的同时顺带重构了代码,现在 hop 函数看起来干净了很多:
(defn- hop [journey over? pipelines]
  (future (if (over? journey)
        ;; if journey's over, print the only one
        (do
          ((:put-result pipelines) journey)
          [journey])
        ;; if not, keep crawling and find fresh urls
        ;; start multiple hop forks and concat their result together
        (let [urls ((:get-crawl pipelines) (last journey))
              futures (mapv #(hop (conj journey %) over? pipelines) urls)
              results (mapv deref futures)]
          (apply concat results)))))
我把「把爬取任务放入管道,然后等待结果」都封装到一个 :get-crawl 函数里了。这个 pipelines 其实完全可以写成协议,也就是之前看到的 defprotocol 和 defrecord,不过目前软件里还没有很复杂的管线,用一个简单的数据结构足矣。
最后一个问题,目前看来 hop 如果没有找到满足 over? 条件的路径,就会一直执行,是不是应该写一个最大跳数的限制?不不不,别忘了 over? 函数是抽象的,最大跳数的限制完全可以由 over? 的具体实现去处理,不必为此让核心逻辑变得复杂。
至此,我通过只思考抽象问题,逐步求精,写完了核心的业务逻辑。即便写了 defprotocol 定义,也只有不到一百行代码——包括注释和 require 语句,ody.clj 只有 19 行,workers.clj 只有 17 行,各种协议定义 protocols.clj 有 15 行(不过这很大程度上要归功于 Clojure 语法的简洁性)。这 51 行代码就是这个软件的骨架,在填充血肉之前,还有一件重要的事情要做。
在我们把 HTTP 客户端、HTML 解析、URL 规范化和对比、结果输出、用户界面等一系列无底洞般的细节引入到软件中之前,应当先保证骨架本身有效。Lisp 程序员们可以用 REPL 命令行里直接调用软件内部的函数进行测试,测试的过程中随手定义一些假的实现喂给核心逻辑也非常容易。我虽然写了很多 Clojure 代码(不过才五十几行吧),但本文实际上是与语言无关的,所以我还是用更通用的方式来测试——写测试文件。
不过老实说,更好的做法是测试驱动开发(TDD),即先写测试,再写代码。但…… 我都已经写完了还能怎么办呢?
要测试 ody.clj 很简单,只需要保证递归函数 hop 的正确性。hop 预期的正常行为是:输入 [home],通过 home 发散出更多的 URL,递归出更多的分支,把每条完成的分支写入管线,最后返回全部分支。注意,「完成」,也就是 over? 函数是抽象的,这个完成的条件不一定是「找到和 home 一样的 URL」。完成的条件判断得准不准、是否有缺陷,是实现 over? 函数的组件的工作,应该在测试那个组件的时候才考虑。也就是说,此时我们完全不必考虑 hop 能不能给出我们想要的环路,我们只要保证它能完成预期的行为就好了。甚至啊甚至,这个 home 和最后得到的 journey,都不一定得是 URL。
(deftest hop-happy-path-test
  (testing "Happy path of the recursive hop function."
    (let [result-chan (chan)
          pls {:put-result (partial put! result-chan)
               :get-crawl (fn [num] (mapv #(+ % num) [1 2 3]))}
          ody (->Ody 0 #(>= (last %) 5) pls)
          want #{[0 1 2 3 4 5] [0 1 2 3 4 6] [0 1 2 3 4 7] [0 1 2 3 5] [0 1 2 3 6] [0 1 2 4 5] [0 1 2 4 6] [0 1 2 4 7] [0 1 2 5] [0 1 3 4 5] [0 1 3 4 6] [0 1 3 4 7] [0 1 3 5] [0 1 3 6] [0 1 4 5] [0 1 4 6] [0 1 4 7] [0 2 3 4 5] [0 2 3 4 6] [0 2 3 4 7] [0 2 3 5] [0 2 3 6] [0 2 4 5] [0 2 4 6] [0 2 4 7] [0 2 5] [0 3 4 5] [0 3 4 6] [0 3 4 7] [0 3 5] [0 3 6]}]
      ;; match journey results
      (is (= (set @(start ody)) want))
      ;; collect channel and count
      (loop [counter 0]
        (if (poll! result-chan)
          (recur (inc counter))
          (is (= counter (count want))))))))
这个测试中的 journey 不是 URL 向量,我把「爬取和发散 URL」变成了「累加数字」。初始 URL 变成了初始数字 0。测试 Ody 的时候我没有启动爬虫,注意我传入的管线 pipelines,其中 :get-crawl 并没有把新 URL 放进 crawl-queue 里再等待结果,而是对数字进行了三次加法运算,发散出 n+1、n+2 和 n+3 三个数字。再看 over? 的具体实现 #(>= (last %) 5),当累加 journey 的最后一个数字大于等于 5,就算做结束。
由于并发的执行顺序不定,为了避免最终结果的顺序影响断言,我把它转换成了集合类型(set),然后与包含所有累加路径的集合对比。最后再把 result-chan 里的内容读出来,看看 Ody 是否传入了正确数量的路径结果。
用 Leinigen 运行测试:
➜  ody git:(feat_core) ✗ lein test

lein test ody.ody-test

Ran 1 tests containing 2 assertions.
0 failures, 0 errors.
测试通过!接下来应该考虑边界条件,比方说,如果 :get-crawl 没有返回任何结果,hop 就应该停下,返回空集。
(deftest hop-empty-test
  (testing "Hop should be able to handle empty result from :get-crawl"
    (let [result-chan (chan)
          pls {:put-result (partial put! result-chan)
               :get-crawl (fn [_] [])}
          ody (->Ody 0 #(>= (last %) 5) pls)
          want #{}]
      ;; match journey results
      (is (= (set @(start ody)) want))
      ;; collect channel and count
      (loop [counter 0]
        (if (poll! result-chan)
          (recur (inc counter))
          (is (= counter (count want))))))))
测试依然通过,接下来要考虑更多的边界情况,还要写 workers.clj 的单元测试,看它能不能正常启动 N 个爬虫,能不能正确消耗 crawl-queue 里的任务等等。具体的就省略了。
总之,合理的抽象、接口和骨架式的编程不仅可以让人在开发核心功能时只关注核心逻辑,而不被技术细节困扰,还能让单元测试变得容易,不必等到整个项目近乎完成时才做集成测试。
那些跟 LLM Agent 一起工作得不亦乐乎的人,其实已经可以放手,把写好的接口定义和核心业务逻辑丢给 Agent,让机器实现人没有实现的接口,在 main 组件中装配起来,然后就能跑了。跟 Vibe Coding 不同的是,开发者已经对软件的核心逻辑、接线点、输入输出和内部结构了如指掌,不会面对大量安全性、可读性和质量堪忧的代码发懵。开发者不会像 Vibe Coders 那样因为不理解代码而事事求助于机器,不会让自然堆积的屎山代码填满 LLM 的上下文,燃烧大把大把的美钞。再者,由于开发者对代码的理解很充分,他可以写出更清晰的提示词,甚至精确到代码行,让 Agent 消耗更少的 Token 和时间完成任务,而不必把大量的资源都用在「推测用户意图」上。
不过,LLM 生成代码的版权状态未知,我不知道 Agent 填进我仓库的代码是从谁哪里偷的,应该遵从什么开源协议,应该署谁的名字,所以我不会用 LLM 生成的代码。接下来我将手写接口实现,把所有组件都装配起来,产生可运行的软件原型。
eurylochus.cljCrawler(爬虫)协议的实现类,我决定命名为 eurylochus(欧律洛卡斯),他是奥德修斯的二把手,在登陆瑟茜的岛屿时,也是他带队探路。
要发送 HTTP GET 请求,最常用的 Clojure 库应该是
clj-http
。至于解析 HTML,之前有听说过
hickory
,可以把 HTML 转换为 Clojure 数据结构,还兼容
hiccup
的 X-Expression(用来表示 XML 的 S-Expression),不过它的选择器语法看起来太吓人了,浏览之后找到了一个
JSoup
(Java 版的 BeautifulSoup)的 Clojure 包装,试了试好像也够用了。虽然这个
html-parser
十二年没有人维护,总共只提交过三次 Commit,看着也有点吓人,但大不了回头再换一个。
(ns ody.eurylochus
  "Eurylochus is scout for Odysseus. It implements Crawler protocol."
  (:require [ody.protocols :refer [Crawler]]
            [clj-http.client :as client]
            [html-parser.core :refer [document-from-string select]]))

(defrecord eurylochus [] Crawler
  (find-ways [_this url]
    (let [resp (client/get url)
          status (:status resp)
          doc (document-from-string (:body resp))]
      (when (= status 200)
        (->> (select doc "a")
             (map #(.attr % "href"))))))))
按下快捷键把这段代码发送到 nREPL 里,然后直接在 REPL 里 Eval 看看效果,就用我自己博客的某期周刊 URL 当作例子吧。
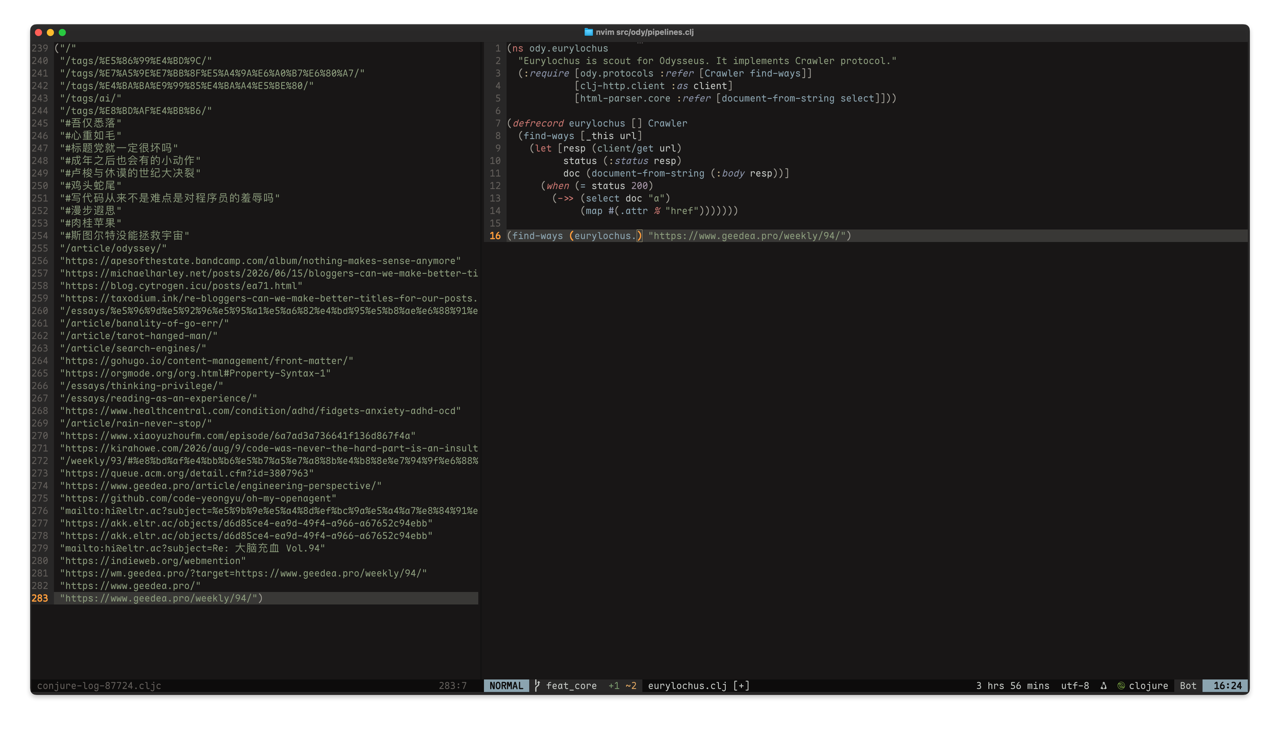
果然,提取 <a> 标签的 href 属性会拿到很多不想要的东西,比如锚点和内链,但我并不打算在 eurylochus 这里剔除,别忘了,还有一个叫作 Gatekeeper 的协议就是来做筛选的。
polites.cljGatekeeper 的实现我想用奥德修斯最好的朋友 polites(波利特斯)来命名,要做的就是筛选 eurylochus 拿到的 URL,同时控制数量。好在 Clojure 的 filter 和 remove 函数就很适合干这活儿,最后再用 take 函数拿一定数量的 URL 返回就好了。
(ns ody.polites
  "Polites is Odysseus' best friend. It implements Gatekeeper protocols and keep unwanted URLs at bay."
  (:require [ody.protocols :refer [Gatekeeper]]
            [clojure.string :as string])
  (:import (java.net URI)))

(defn- hostname [url]
  (.getHost (URI. url)))

(defrecord polites [blocklist limit] Gatekeeper
  (filter-ways [_this urls]
    (->> urls
         (filter #(or (string/starts-with? % "https://")
                      (string/starts-with? % "http://")))
         (remove #((set blocklist) (hostname %)))
         (take limit))))
在 REPL 里测试,最后得到的列表很干净。
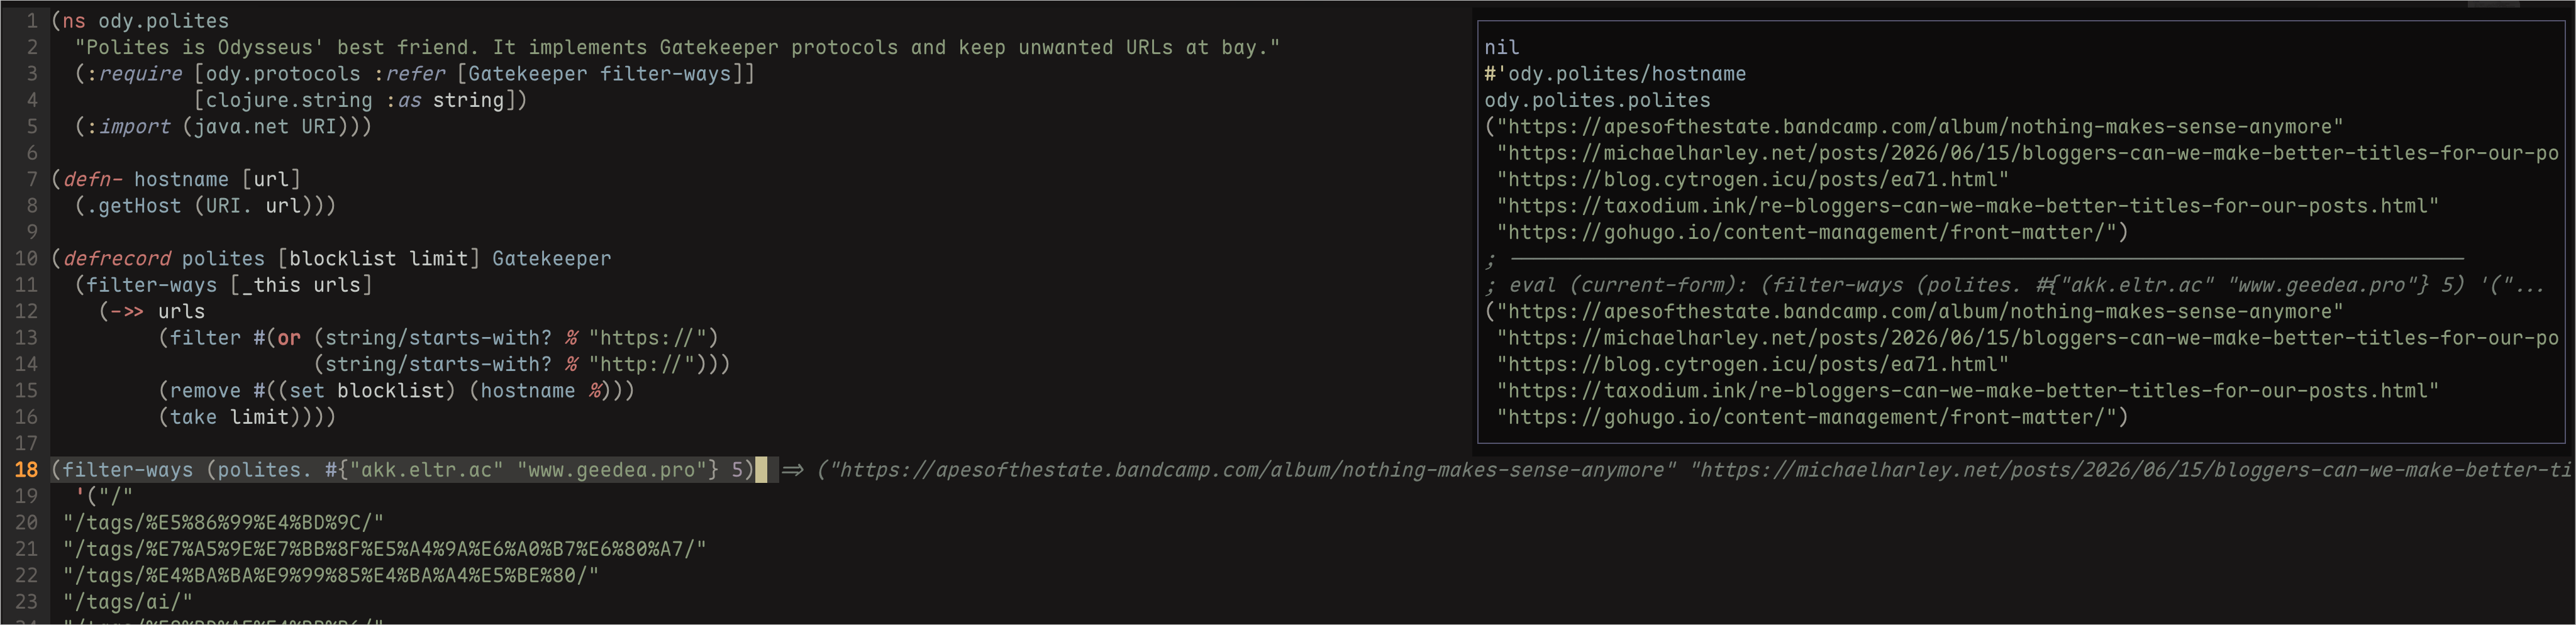
目前还不支持通配符 *,没关系,之后再说。
zeus.clj让天神宙斯 zeus 来判断 journey 是否结束再合适不过了。不过我没有创建名为 zeus 的对象或者说类,仅仅是在 ody.zeus 这个命名空间下定义了 over? 函数。
(ns ody.zeus
  "Zeus determines if Odysseus finishes his journey. It provides over? predicate function."
  (:import [java.net URI]))

(defn- ring-by-exact? [journey]
  (.equals (URI. (first journey))
           (URI. (last journey))))

(defn- ring-by-domain? [journey]
  (= (.getHost (URI. (first journey)))
     (.getHost (URI. (last journey)))))

(defn over? [law max-hop journey]
  (let [ring? (cond (= law "exact")   ring-by-exact?
                    (= law "domain")  ring-by-domain?
                    :else             ring-by-domain?)]
    (or (ring? journey)
        (>= (count journey) max-hop))))
你可能发现 ody.zeus/over? 有三个参数,而 ody.clj 中使用的却是只有一个参数的 over?,参数对不上怎么办?没关系,还记得 partial 吗?给 ody 传入 (partial over? law max-hop),也就是预先填好两个参数的函数引用,就可以了。
是时候把骨头和肉拼起来了,这一步很简单,只需要把各个组件初始化,按照接口定义装配在一起,然后启动就好:
(ns ody.core
  (:require [ody.ody :refer [->Ody]]
            [ody.workers :refer [->workers]]
            [ody.pipelines :refer [make-pipelines]]
            [ody.eurylochus :refer [->eurylochus]]
            [ody.polites :refer [->polites]]
            [ody.zeus :refer [over?]]
            [ody.protocols :refer [start start-workers]]
            [clojure.core.async :refer [chan <! go-loop]])
  (:gen-class))

(def config {:crawl-queue-buffer 10
             :worker-count 5
             :domain-blocklist ["github.com" "google.com"]
             :url-limit 3
             :ring-standard "domain"
             :max-hop 10})

(defn -main
  [& args]
  (let [result-queue (chan)
        crawl-queue (chan (:crawl-queue-buffer config))
        home (first args)
        ody (->Ody home
                   (partial over? (:ring-standard config)
                                  (:max-hop config))
                   (make-pipelines result-queue crawl-queue))
        workers (->workers (->eurylochus)
                           (->polites (:domain-blocklist config)
                                      (:url-limit config))
                           crawl-queue)]
    (start-workers workers (:worker-count config))
    (println "Crawling wokers started.")
    (let [all-ref (start ody)]
      (println (str "Odysseus is on his way. Starting from " home))
      (go-loop [journey (<! result-queue)]
               (println "Found one! " journey)
               (recur (<! result-queue)))
      (deref all-ref)
      (println "All is done."))))
现在,启动!嗯……?
......
Found one!  [https://www.geedea.pro https://www.geedea.pro/ https://www.eltr.ac/ https://www.eltr.ac https://www.eltr.ac https://www.eltr.ac https://codeberg.org/eltrac https://blog.codeberg.org/protecting-our-floss-commons-from-llms.html https://blog.codeberg.org https://join.codeberg.org]
Found one!  [https://www.geedea.pro https://www.geedea.pro/ https://www.eltr.ac/ https://www.eltr.ac https://www.eltr.ac https://www.eltr.ac https://codeberg.org/eltrac https://blog.codeberg.org/protecting-our-floss-commons-from-llms.html https://codeberg.org/ https://codeberg.org/Codeberg/org/compare/17bdb39b0c1ecd0e423f3ba592650ce57fcdfbf5..71149c7fc95ccfeae36109b5cddca339e4aa1473?files=TermsOfUse.md#diff-d760d688bb9b929b62db808bfc76abe4493d095a]
Execution error (URISyntaxException) at java.net.URI$Parser/fail (URI.java:3005).
Illegal character in fragment at index 20: https://matrix.to/#/#codeberg-space:matrix.org

Full report at:
/var/folders/41/6gvwg1j15xb4hwm365wds90h0000gn/T/clojure-16924552856293422522.edn
看来报错了,而且找到的路径也都是因为达到最大跳数限制才停止的,并没有找到环路。没关系,没有程序是一遍就能跑通的。C’est la vie. 报错是 Java 的 URI 处理不了 # 字符导致的,把 zeus.clj 和 polites.clj 中的 URI 换成 URL 应该就可以了。
仔细观察的话,找不到环路很大程度上是因为很多路径一直在原地传送,某个 URL 的内容可能包含和自己一模一样的 URL,而 polites.clj 没有把这部分筛掉。再者,程序经常找网站的首页 URL,而包含内容的子页面才更有可能找到我们想要的环路,应该让 URL 中路径更深的排在前面。
;; polites.clj
(defrecord polites [blocklist limit] Gatekeeper
  (filter-ways [_this urls current]
    (->> urls
         (filter #(or (string/starts-with? % "https://")
                      (string/starts-with? % "http://")))
         (remove #(url-equal current %))
         (remove #((set blocklist) (hostname %)))
         (sort-by #(-> % path depth) >)
         (take limit))))
另外,还有很多路径经过了 Google 等根本不可能导向我自己的网站的大站点,嗯…… 果然还是要写通配符匹配呢。
(defrecord polites [blocklist limit] Gatekeeper
  (filter-ways [_this urls current]
    (->> urls
         (filter #(or (string/starts-with? % "https://")
                      (string/starts-with? % "http://")))
         (remove #(url-equal current %))
         (remove #(some (fn [pattern] (match-glob pattern (hostname %))) blocklist))
         (sort-by #(-> % path depth) >)
         (take limit))))
match-glob 函数来自
stch-library/glob
,果然还是偷别人的代码好用啊。不过这种小库竟然没有 LICENSE 文件,用起来还挺不放心的,之后要换掉。在配置里面写上一些大网站的黑名单看看:
(def config {:crawl-queue-buffer 10
             :worker-count 5
             :domain-blocklist ["github.com"
                                "google.com"
                                "*.google.com"
                                "bandcamp.com"
                                "*.bandcamp.com"
                                "gohugo.io"
                                "*.gohugo.io"
                                "codeberg.org"
                                "*.codeberg.org"
                                "apple.com"
                                "*.apple.com"
                                "creativecommons.org"]
             :url-limit 3
             :ring-standard "domain"
             :max-hop 10})
再次运行,很快就找到了第一条环路。
["https://www.geedea.pro/weekly/94/"
 "https://michaelharley.net/posts/2026/06/15/bloggers-can-we-make-better-titles-for-our-posts/"
 "https://social.bubbles.town/@bubbles/statuses/01KV5P7PK0VFSMTGASPRA3C2KV"
 "https://bubbles.town/entry/34746979"
 "https://michaelharley.net/posts/2026/06/15/bloggers-can-we-make-better-titles-for-our-posts/"
 "https://www.geedea.pro/weekly/94/"]
从我的 第 94 期周刊 ,先是去到了 Michael Harley 的《Bloggers, can we make better titles for our posts?》,然后去到了 Bubbles(一个博客聚合平台)的社交媒体贴(GoToSocial 的前端不需要 JavaScript 也能显示内容,所以获取到了外链),然后去到了 Bubbles 上这篇文章的页面,然后回到了 Harley 的文章,由于我引用了他的文章并且发送了 Webmention,最后通过 Webmention 链接回到了我的网站。挺奇妙的旅程。
不过接下来就没有那么顺利了,很多路径都是达到 max-hop 限制放弃的路径,不过倒是发现了不少有趣的链接,或许这个软件的作用也可是帮助从自己的网站出发发现更多的内容。目前的限制是,每个 URL 最多发散出三条外链,一条 journey 最多包含 10 个节点。即便做了黑名单限制,也很难剪枝掉大部分的任务,最后要爬取的网页数量接近 3 的十次方。
或许这个软件不适合在本地运行,更适合一直跑在服务器上,每找到一条合格的路径就显示在网页上,或者通过
Bark
和
ntfy
给自己发送通知。好在我们的业务逻辑是高度抽象的,只需要在 main 组件里包装一层 HTTP 服务器就好。由此可见,软件要做成命令行应用、GUI 应用还是 Web 服务,都只是外层的细节,只要业务逻辑保持高度抽象,就能够让人机交互层也变成插件。
软件能跑了,现在 Ody 已经开源放到了
Tangled
上,由于还不稳定,所以现在的大部分代码都在
feat_core
分支里,尚未合并。欢迎提 PR,如果有人能帮我把那个翻车的并发问题解决掉就好了,我这周的 Clojure 功力已经耗尽了。
我在写代码的过程中发现,我定义的不少 defprotocol 只包含一个方法,为了实现这一个方法而去创建对象,是不是有点太啰唆呢?我那 51 行代码是不是可以更短?我之前其实写过 Common Lisp 的
无类多态
,即不需要定义类也能创建抽象函数。不过当时我忙着骂 Java,竟没有好好吸收 CLOS 的精髓。最近读了明琪琪可的《
Trial 与 CommonLisp 的介绍
》,这才意识到 OOP 里的接口仅仅是低配版的 defmethod 而已,我果然还是被 Go 害惨了啊。
前面写过的 over? 作为写在函数形参里的回调函数,其实也是一种低配但更简洁的抽象函数,唯一的缺点是它不够安全,返回值、形参和行为都难以确定(或许静态类型语言会好一些),而且写太多形参若还要递归或层层传递,想想就觉得枯燥。
Clojure 也支持类似 CLOS 的系统,defmulti 和 defmethod 可以在不依附任何类和对象的情况下实现多态,而且支持多分发。兴许下次用 Clojure 写东西的时候可以试着用用。
本文的部分观点来自以下书籍:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。