


Kimi K3的2.8万亿总参数很吸睛,但对多数开发者,更关键的变化是它在9月18日进入Amazon Bedrock:调用者不必先搭建巨型推理集群,就能用托管API接入。门槛确实下降了,不过下降的是部署门槛,不是长上下文的成本、质量和治理门槛。
AWS宣布Kimi K3可通过美国地理与全球跨区域推理配置调用。官方列出的能力包括原生视觉、100万Token上下文、工具调用、结构化输出、流式响应,以及开放权重模型在Bedrock上的首次显式提示缓存。全球配置global.moonshotai.kimi-k3会在支持的商业区域间路由,AWS称费用约比地理配置低10%;美国配置则把处理限制在美国地理范围。
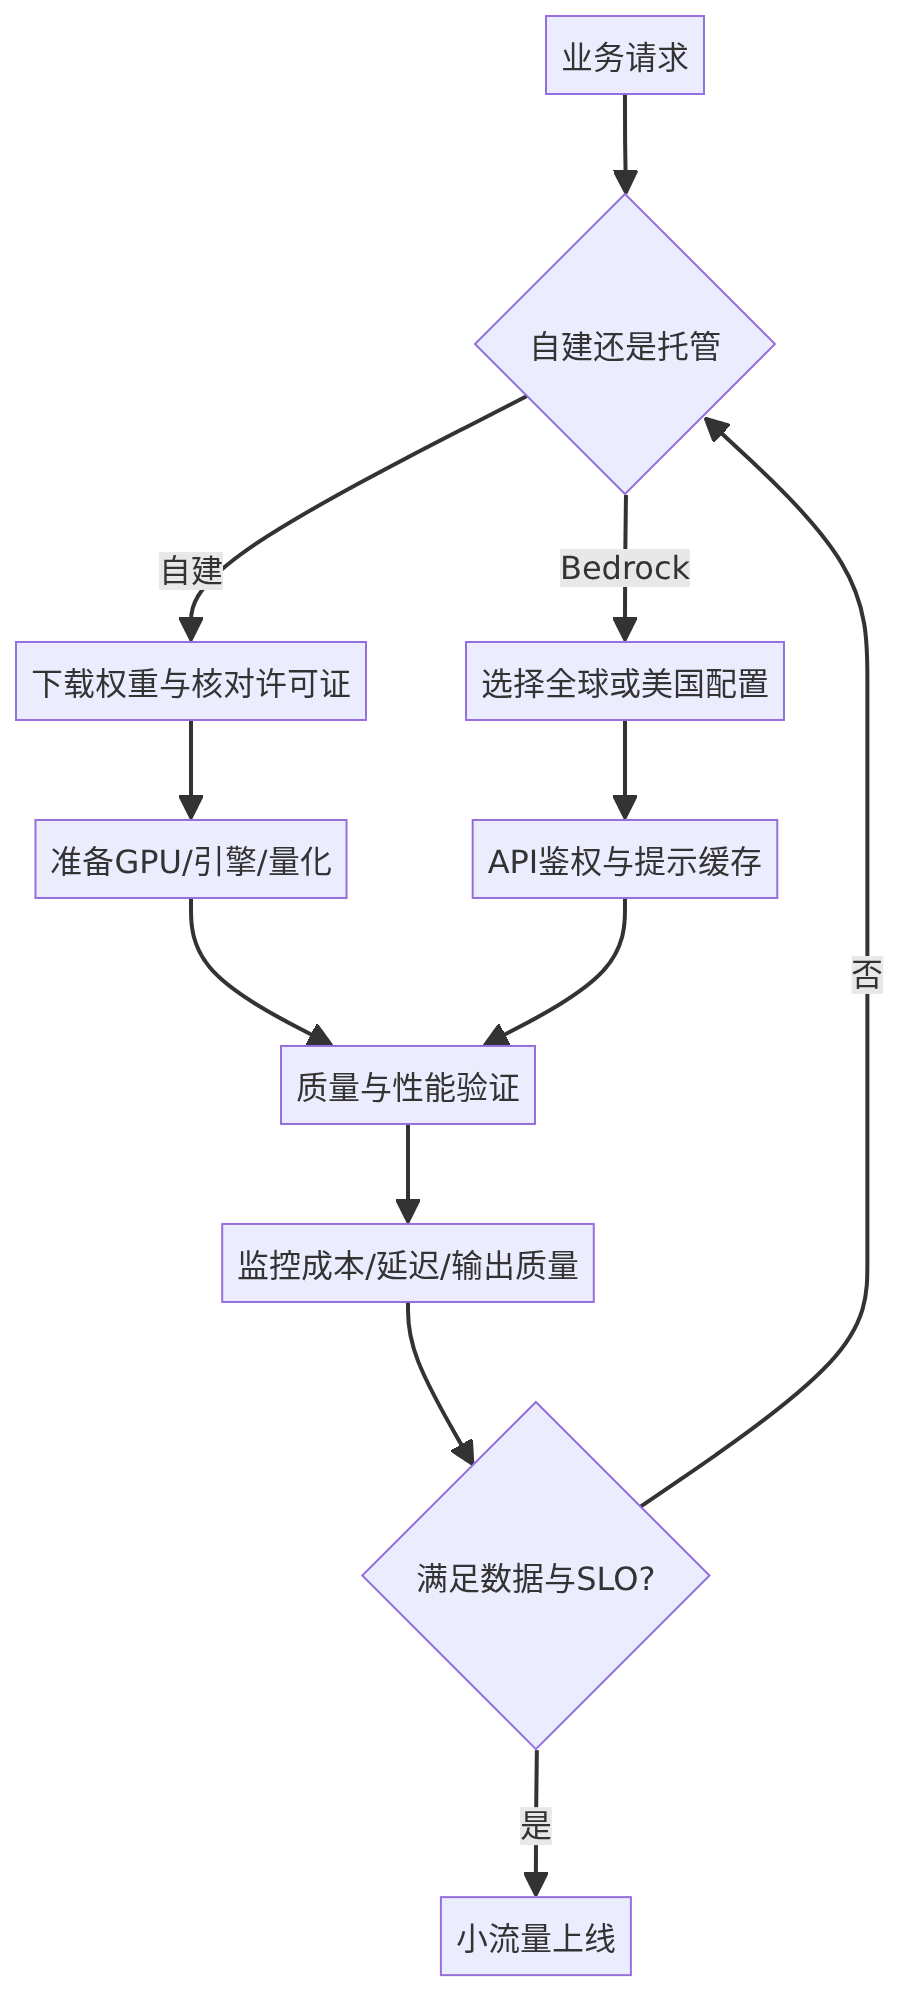
Moonshot公开模型卡显示,K3是混合专家模型,总参数2.8万亿、每个Token激活约1040亿参数,93层,采用MXFP4权重与MXFP8激活的量化感知训练。官方推荐vLLM、SGLang或TokenSpeed自部署;Bedrock则把底层服务换成API。
来源:AWS上线公告、Moonshot官方仓库、Hugging Face模型卡。性能与“2.5倍扩展效率”属于厂商披露,不应当成跨模型独立结论。
开放权重意味着可以获取参数并按许可证研究或部署;它不自动等于开放训练数据、完整训练代码或无限制商用。选择Bedrock后,团队使用的是托管推理,不再直接掌控权重文件、底层引擎和GPU拓扑。好处是免去大规模集群运维,代价是接受平台的区域、配额、接口和计费边界。
100万Token可以容纳大型代码库片段、长文档和多轮记录,但“能放进去”不代表“每次都该放”。输入越长,预填充时间、费用和注意力稀释风险通常越高。把所有资料整包提交,会让过期规则、冲突版本和无关上下文共同进入决策。
显式提示缓存适合复用稳定前缀:例如同一套系统规则、产品手册和代码基线被多个请求重复引用。第一次请求建立缓存,后续请求引用相同内容,才可能减少重复处理。若团队每次都重排文档、插入时间戳或修改前缀,缓存命中率会很低。缓存不是“打开即省钱”,而是一种需要监控命中率的架构选择。
具体场景是大型仓库代码审查。稳定的编码规范与仓库索引可作为可缓存前缀,当前拉取请求的差异作为变化部分;真正需要定位的源码仍通过检索按需加入。这样比每次发送整个仓库更容易控制成本,也更便于追踪模型依据了哪些文件。
模型迁移还要验证接口语义。OpenAI兼容API能降低客户端改造量,却不保证工具调用、推理内容、停止原因和错误码完全一致。先为关键字段建立契约测试,再换模型,才能避免“请求成功但业务状态错了”。
超大开放权重模型进入托管平台,改变的是采用路径,而不是模型经济学。 企业可以先用API验证价值,再决定是否值得自建;这让“托管试验—真实压测—选择部署方式”成为更可行的渐进路线。它也意味着开放生态与云平台不是对立关系,权重开放可以扩大选择,托管服务负责把选择变成可用接口。
但不要把参数量当成答案。知识工作最终看正确率、完成时间、失败恢复和每个成功任务成本。1040亿激活参数仍是很重的计算负载;百万上下文也可能被更好的检索、分块和状态管理替代。
适合场景包括跨大量文档的研究、长周期编码、视觉与文本联合分析,以及需要工具调用的复杂工作流。短问答、固定分类或延迟极敏感的接口,较小模型可能更便宜、更稳定。涉及数据驻留时应选择明确的地理配置,不能因全球配置便宜就忽略合规要求。
AWS称推理数据不与模型提供商共享、不用于训练,并启用零数据保留与零操作员访问;企业仍需核对自身日志、代理层与下游工具是否保存内容。模型许可证、支持区域、配额和价格可能变化,上线前以当前控制台和官方文档为准。
挑选30个真实任务,记录质量、首Token时间、总耗时与输入输出Token;分别测试“全量上下文”“检索后上下文”“缓存稳定前缀”三种方案;注入冲突文档观察引用;检查全球与地理配置的数据路径;保存失败样本而非只看平均分;最后用每个合格结果的总成本比较K3与一个更小模型。
面对百万Token上下文,你会优先扩大上下文,还是先做检索与缓存治理?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
