





Embedding就是把文本、图片或声音变成一串数字,让语义接近的内容在向量空间里靠近。它解决“用户没用同一个关键词也能搜到相关资料”的问题;但靠近只代表模型认为相似,不保证片段足以回答问题。学会看相似度、分块和重排,你才能判断RAG为什么搜偏。
2026年9月14日提交的ReWAM(Reason What Matters,可理解为“只推理重要之处”)论文研究通用多模态Embedding。作者指出,先让模型长篇推理再生成向量会增加延迟,而且传统奖励难以判断推理中的哪段证据真正帮助检索。ReWAM用检索结果反过来分配监督,并在部分推理已足够时提前停止。论文报告在MMEB-V2与MRMR两个多模态检索基准上取得更强表现,相比显式思维链Embedding方法最高提升5倍推理吞吐。该结果来自作者实验,仍需独立复现。
关键词搜索要求字面相同。用户问“怎么减少模型瞎编”,文档可能写“降低幻觉”,词不一样却意思接近。Embedding模型把两段内容映射到同一维度的数值向量,检索系统再比较距离,把更接近的片段排在前面。这是RAG(Retrieval-Augmented Generation,检索增强生成)常用的召回步骤。
生活类比是一张书店地图:烹饪书在一片,编程书在另一片,主题相近的书架距离更近。查询也被放到地图上,于是可以找附近书架。类比边界是向量空间不是人工绘制的知识分类;坐标由训练数据和目标决定,同一本书对“主题”“作者风格”或“能否回答某题”可能需要不同地图。
去掉类比,Embedding是模型将离散或高维输入编码成固定维度稠密向量的表示。向量检索通常用余弦相似度、点积或欧氏距离排序候选;余弦相似度比较两个向量夹角,越接近1通常表示方向越相似,但阈值不能跨模型照搬。
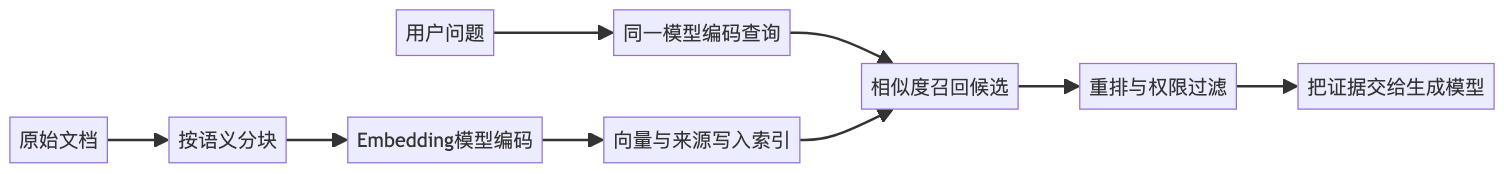
这个示例不下载模型,用预先给定的三维教学向量专注理解排序机制。无需安装依赖;保存为vector_search.py,运行python3 vector_search.py:
from math import sqrt

docs = {
    "A: 用检索证据减少幻觉": [0.92, 0.10, 0.18],
    "B: 降低GPU推理功耗": [0.08, 0.95, 0.12],
    "C: RAG需要权限过滤": [0.78, 0.18, 0.58],
}
query = [0.88, 0.12, 0.26]

def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = sqrt(sum(x * x for x in a))
    nb = sqrt(sum(y * y for y in b))
    return dot / (na * nb)

ranking = sorted(
    ((cosine(query, vec), name) for name, vec in docs.items()),
    reverse=True,
)

threshold = 0.80
for score, name in ranking:
    decision = "召回" if score >= threshold else "过滤"
    print(f"{score:.3f}  {decision}  {name}")
本次任务已实际运行。结果为A 0.995、C 0.939、B 0.242,因此阈值0.80时召回A和C。前三行向量代表文档和查询;cosine先算点积,再除以两个向量长度;排序阶段只负责召回;阈值把明显无关的B过滤掉。真实系统的向量由Embedding模型生成,通常有数百到数千维,且还要保存来源、权限与更新时间。
实践里最重要的发现是:C也很相似,却未必直接回答“如何减少幻觉”。因此高相似度候选还要经过重排模型、关键词约束或任务规则;最后让生成模型引用证据,并不能把相似度分数当事实置信度。
第一,向量数据库不会理解事实,它只存储并查找向量;能力主要来自Embedding模型、数据和检索策略。第二,相似度高不等于答案正确,候选可能主题相近却缺少关键数字。第三,分数0.8没有通用意义,更换模型或距离函数后分布会变,阈值必须用自有标注集校准。
第四,文档切得越小不一定越准。小块容易命中关键词,却会丢掉上下文;大块信息完整,又可能混入无关主题。第五,换Embedding模型后不能继续混用旧向量,查询与文档必须位于同一表示空间。第六,多模态Embedding能比较图文,不代表它自动读懂图片里的每个细字,OCR和版面解析仍可能需要独立处理。
向量检索适合语义问答、相似案例、商品推荐和跨措辞搜索。不适合替代精确主键查询、金额核对、权限判断或必须完整扫描所有记录的任务;这些应结合数据库过滤、关键词搜索和规则校验。
我的判断是,ReWAM代表Embedding从“直接压成坐标”走向“先判断什么证据与检索目标有关,再决定算多久”。但多数团队短期内最大的收益仍来自清理语料、合理分块、混合检索和建立失败集,而不是立即换最复杂模型。先把召回错在哪里量出来,才能判断需要更强Embedding还是更好的数据工程。
把C的第三维从0.58改成0.20,再观察排序;随后把阈值改为0.95,记录召回率如何变化。最后写下三条真实问题和正确文档,统计Top-2是否包含答案。这个小集合就是你的第一版检索验收集。
你的RAG更常见的问题是完全搜不到,还是搜到很多相似却不能回答问题的片段?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
