



惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

G
Google Developers Blog
F
Fortinet All Blogs
Microsoft Azure Blog
腾讯CDC
Vercel News
Vercel News
Recent Announcements
博客园 - Franky
小众软件
小众软件
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
The Cloudflare Blog
宝玉的分享
宝玉的分享
I
InfoQ
博客园 - 聂微东
Jina AI
Jina AI
J
Java Code Geeks
V
V2EX
U
Unit 42
Stack Overflow Blog
Stack Overflow Blog
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
Cyber Security Advisories - MS-ISAC
阮一峰的网络日志
阮一峰的网络日志
L
LangChain Blog
T
The Blog of Author Tim Ferriss
量子位

Java for You

语义相近却总找错资料?从Embedding看懂向量检索 - Java for You - java4u AI算力开始听电网指挥:比换GPU更现实的增产方法 - Java for You - java4u 票据抽取不一定要上最大模型:先看版式是否真的变化 - Java for You - java4u AI做长程科研,真正稀缺的不是更多Agent而是反证链 - Java for You - java4u AI代码审计最危险的不是漏报,而是团队开始不再相信它 - Java for You - java4u 100万Token不等于模型全记住:从KV Cache看懂长上下文成本 - Java for You - java4u AI写歌有了工程图:YuE2把旋律和和弦放回可编辑层 - Java for You - java4u Claude接入十余种金融系统后,真正稀缺的是可追溯的审批链 - Java for You - java4u 本地语音AI不等于零风险:VoiceStudio最值得看的三条边界 - Java for You - java4u AI代码评审开始跑测试,真正该升级的是团队证据链 - Java for You - java4u 4万星的Agent技能提醒我们:答案太全也可能不可用 - Java for You - java4u 流式JSON为什么总报错?理解结构化输出就能接稳AI接口 - Java for You - java4u 一个浏览器看见飞机船舶与卫星,空间智能的门槛变了 - Java for You - java4u 编码Agent搬出编辑器后,本地优先工作台在解决什么 - Java for You - java4u AI写代码开始像带团队:Qwen Code补上工作流控制台 - Java for You - java4u AI会聊天却不会改3D模型?从Pascal 1.0看懂MCP工具调用 - Java for You - java4u 让AI审科学公式,它最适合当比较员而非裁判 - Java for You - java4u 智能体上线最难的不是提示词:Agents API开始托管运行时 - Java for You - java4u AI任务一多就堵车:问题可能不在模型速度 - Java for You - java4u AI能写无人机控制代码后,安全边界不能只守提示词 - Java for You - java4u AI代码扫描能批量开了,但它还不能替你挡住合并 - Java for You - java4u 机器人动作误差降近九成,真正该先看数据切分 - Java for You - java4u 图片一多首字就慢?用EPD拆开多模态推理三段路 - Java for You - java4u 蛋白预测快2.9倍,科学AI最难的是让整条流水线不空转 - Java for You - java4u NVIDIA把供应链专家经验训练进模型,关键不是换一个更大模型 - Java for You - java4u 人人都能问公司数据之后,数据分析师反而更重要了 - Java for You - java4u 语音AI开始边听边说,改变的不只是响应速度 - Java for You - java4u Agent到底比一次大模型调用多了什么?小白从这张流程图看懂 - Java for You - java4u ChatGPT服务10亿周用户后,最难扩展的可能不是模型 - Java for You - java4u AI编码助手的日志也会泄密:先划清明文边界 - Java for You - java4u
临床AI别再只比像不像标准答案,先算医生少改了多少 - Java f...
蜗牛 · 2026-09-16 · via Java for You

地球与网络光带

一份AI病历与参考答案文字很像,不代表医生真的省了时间。9月14日提交的KnowBench把评测单位换成“最终有多少AI生成工作被责任医生接受”,试图直接衡量剩余人工负担。这个方向比单纯算文本相似度更贴近部署,但它也带来一个必须警惕的新误区:被接受不等于临床正确,更不等于安全结果已经得到证明。

新指标怎样计算

论文提出Effort Reduction(ER,工作量减少率):在专家和安全审查框架下,系统生成且被责任临床人员签署接受的工作单元,占全部工作单元的比例。不同任务的“单元”可以是病历段落、诊断和收费编码、医嘱、电子健康记录摘要、患者离院说明或决策支持项;每次修改都被视为返还给医生的剩余工作。

作者认为,这种定义把多个临床任务放进同一套报告协议。论文同时报告一个初始结果:在超过六个月、十三个专科、超过100万次已签署就诊记录中,Knowtex的专有临床模型总体ER为97.99%,不同专科为96.8%至98.9%。但作者也明确写出,本次只部分提供协议检查表,并有伴随统计尚未披露。
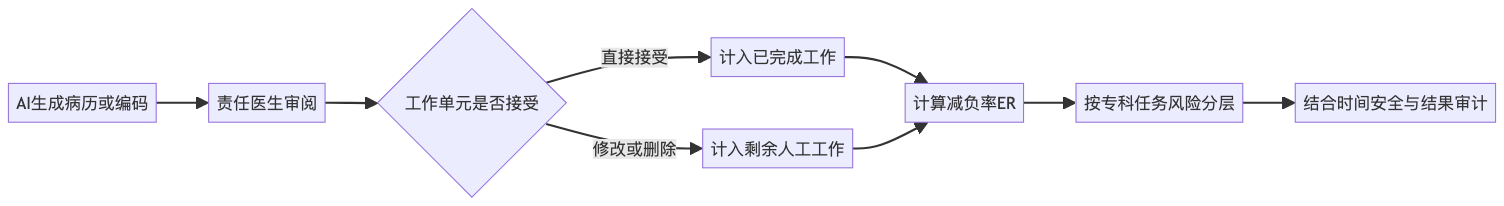
mermaid diagram

为什么比文本分数更接近真实工作

病历可以有多种正确表述,BLEU之类参考文本相似度可能惩罚合理改写;专家打分又昂贵、样本小且难以持续。医生在真实系统里的签署和修改,是工作流自然产生的反馈。它能回答管理者最关心的问题:AI究竟完成了多少可交付工作,而不是像不像某份模板。

具体场景是门诊摘要。AI正确写出病史和用药,医生只改一个剂量,这比整段重写节省更多工作。ER若按字段统计能呈现差别;若只按整份文档“接受/拒绝”,则会把一次微小修改和彻底重写混为一谈。因此指标价值依赖工作单元定义,跨产品比较前必须先确认分母相同。

这个数字不能证明什么

97.99%是项目方在自有闭环系统中的汇总结果,并非独立随机试验。高接受率可能来自模型质量,也可能受默认界面、医生时间压力、自动填充范围、专科难度和病例选择影响。若医生因为赶时间而快速签署,系统会把行为当作成功,却未必捕捉遗漏或延迟出现的错误。

更重要的是,不同错误代价差异巨大。拼写修改和漏掉药物过敏不能各算一个相同单位。一个系统可能在大量低风险句子上获得很高ER,同时在少量高风险医嘱上表现不稳。因此减负率必须与严重错误率、复核时间、覆盖率、病例复杂度和患者结局分开报告。

对其他行业的启发

这一思路并不只属于医疗。法律合同可统计被律师保留的条款,客服可统计无需人工改写的回复,代码助手可统计最终合入且通过测试的补丁。关键是用责任人最终交付的工件做反馈,而不是用“生成完成”充当价值。

但行为指标容易被界面设计操纵。若“接受”按钮醒目、“修改”流程繁琐,接受率会上升;若系统只挑简单任务,减负率也会好看。负责评测的人应记录AI覆盖了哪些任务、哪些被路由给人工,以及人类是否有充分时间发现问题。

我的判断与行动建议

我的核心判断是,AI评测正在从模型能力转向“人还要做多少剩余工作”。这是正确方向,因为生产系统的价值来自任务闭环。不过,任何单一减负指标都可能把安全和质量藏进平均数。KnowBench最值得采用的是可审计的修改事件,不是97.99%这个尚缺完整伴随统计的数字。

  • 先定义工作单元与风险等级,高风险项单独计算。
  • 同时报ER、人工复核分钟数、严重错误率、覆盖率与返工率。
  • 对未使用AI的同期样本做基线,避免把原本就简单的任务算成收益。
  • 随机抽查“直接接受”的记录,检查沉默错误和自动化偏见。
  • 按专科、病例复杂度和医生经验分层,不只给总体平均值。
  • 保留模型版本、修改轨迹和签署人,确保结论可追溯。

在医疗等高风险场景,不适合把ER用于自动放宽人工复核,更不能把签署行为当成患者结局的替代指标。它最适合回答“系统是否减轻编辑负担”,而不是“系统是否已足够安全”。

在你的工作里,衡量AI价值最诚实的指标是少写了多少、少改了多少,还是少花了多少时间?

关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。


本文首发于 java4u.cn,转载请注明出处。