







多Agent演示常把注意力放在角色分工,生产环境却更常被三个问题击穿:突发任务堆在哪里、一次会话怎样隔离、进程重启后从哪继续。阿里云9月16日披露RocketMQ-A2A方案,把每次协作建模为持久、可回放的会话事件流。我的判断是:Agent工程正在重走分布式系统的老路,提示词之外必须补上消息语义和恢复协议。
RocketMQ-A2A分成两层。普通Topic负责Supervisor向Worker高吞吐分发任务,队列吸收突发流量;LiteTopic作为按会话隔离的返回通道,Worker把结果和状态事件按顺序写回。LiteTopic可按任意会话或任务标识动态创建,通过生存时间TTL自动回收,避免传统“一会话一Topic”带来的元数据成本。
Supervisor与Worker分别拥有状态机,并由消息推动转换。Worker执行长任务时,Supervisor无需保持阻塞连接;等待外部结果时,计算节点也能释放。若Supervisor崩溃,可从会话上次消费位置重放结果流,而不是从头运行所有Agent。
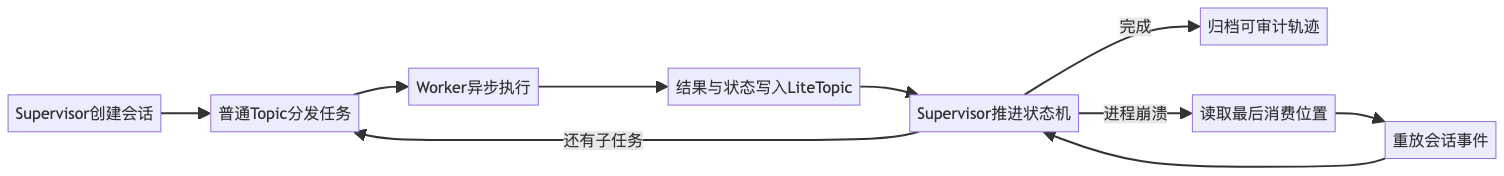
官方文章称,在25倍过载下,RocketMQ-A2A把积压外置到持久队列,老年代内存峰值增长8.2%;HTTP异步RPC增长456.6%,纯A2A实现增长1366.1%。在12组故障注入配置中,端到端任务完成率为100%。10个Broker的集群支持1500万个并发LiteTopic和每秒5万次处理;20万个通道下延迟约15毫秒,而传统按会话建Topic的模型在2万个通道时失败。
这些数字提供了工程线索,但应按厂商自测理解,不能直接外推到任何网络、消息大小和持久化设置。性能结果需要结合测试硬件、Broker配置、复制级别、事件大小和端到端业务逻辑复现。论文已进入FSE 2026工业论文轨道,方案也被称已开源进Apache RocketMQ并用于百炼和Qoder Cloud Agents;生产采用仍需检查对应版本与部署文档。
消息系统保存事件,解决的是“事实没有丢”和“状态可重建”。它不能自动撤销已经发生的外部动作。假设采购Agent已经调用供应商API下单,随后在写入“下单成功”事件前崩溃;恢复后重放到旧状态,可能再次下单。要避免重复,业务API仍需接受幂等键,或采用发件箱、事务消息与人工补偿。
另一个边界是顺序。LiteTopic保证单个会话内有序,并不自动保证跨会话的全局顺序。若两个Agent同时修改同一客户账户,仍要用版本号、条件更新或锁处理冲突。消息“至少到达一次”和业务“恰好生效一次”不是同一件事。
代码修复系统可以把“读取Issue、定位文件、生成补丁、运行测试、请求评审”写成事件。测试Worker崩溃后,新Worker从任务消息继续;Supervisor通过会话流知道哪些测试已经返回。补丁写入仓库时带提交基线和任务幂等键,避免恢复后重复创建分支或PR。
审计也因此变得具体:团队不只保存最终聊天,而是保存每次状态转换、工具输入、输出摘要和事件偏移。出现错误时可以重建“模型为什么看到这条结果”,而不是依赖分散日志拼接。
事件模式本身也需要版本化。今天的Worker写入TEST_FINISHED并携带布尔值,明天可能改成包含失败类型的结构;旧会话重放时,新Supervisor若无法理解旧字段,恢复链仍会断。生产系统应为事件定义版本、兼容策略和迁移测试,并避免在消息里直接塞入密钥或完整敏感上下文。
监控重点也会变化:同步调用关注单次请求超时,事件流更要关注积压年龄、重复投递、死信数量和某个会话长期没有终态。只有把这些指标接入告警,可回放能力才不会变成“出事后理论上能恢复”。
当Agent数量增加,最先需要扩展的通常不是模型,而是会话状态和失败恢复。RocketMQ-A2A值得关注,因为它把二者提升为基础设施对象。但如果你的系统只有单Agent、短任务和可安全重试的只读工具,引入消息集群可能过度设计;一张数据库任务表和明确状态机更容易运维。
你的Agent系统发生中途崩溃时,更难恢复的是消息、状态,还是已经执行过的外部动作?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
