


支持100万Token只说明一次请求允许放入多少内容,不保证模型能准确找回每个细节,更不代表这些内容零成本保存。DeepSeek V4.1 Flash公布每Token 890字节的全局KV Cache设计,正好让我们分清两个常被混淆的概念:上下文窗口是容量上限,KV Cache是生成过程中的计算账本。
DeepSeek在2026年9月10日发布V4.1 Flash。官方模型卡写明它支持最长100万Token上下文,并采用因果编码器—解码器(CED)、压缩稀疏注意力和FP4主缓存,将全局KV Cache降到每Token约890字节,约为上一代V4 Flash的四分之一。发布距今天5天,属于最近7天更新。
这不表示完整运行只占890MB。890字节乘100万Token约为890MB,只是官方定义的全局KV Cache部分;模型权重、局部窗口缓存、视觉编码、批处理、激活值、框架开销和显存碎片仍要另算。
模型生成下一个Token时,要让当前查询与此前Token的Key、Value状态做注意力计算。若每生成一个字都把前文重新计算一遍,延迟会快速上升。KV Cache保存历史Token的Key和Value,新一步只需计算新增部分,再读取缓存。
生活类比是一场开卷考试:上下文窗口决定考桌能摊开多少页资料,KV Cache像你为已读页面做的索引卡,避免每答一题都从第一页重读。类比边界是模型不会像人一样理解后主动压缩重点;缓存保存的是数值张量,不是可读摘要,而且桌面放得下不代表模型一定能找到正确页。
去掉类比,准确定义是:上下文窗口是模型单次序列允许处理的Token数量上限;KV Cache是在自回归解码中缓存各注意力层历史Token的Key与Value表示,用空间换取避免重复计算的时间。
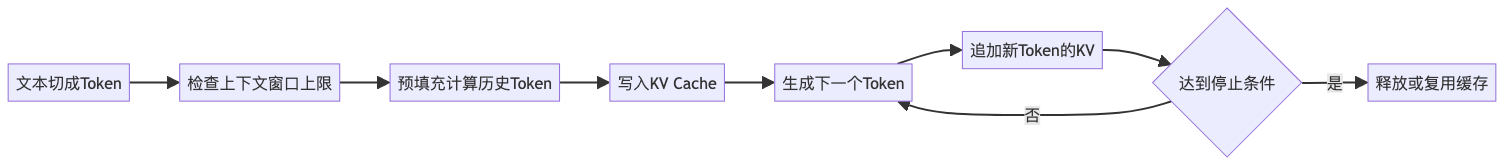
下面的Python程序只做容量估算,不加载模型,也不需要密钥:
def cache_gb(tokens: int, bytes_per_token: int) -> float:
    return tokens * bytes_per_token / 1_000_000_000

profiles = {
    "V4.1-Flash全局KV": 890,
    "假设上一代约4倍": 890 * 4,
}

for tokens in (32_000, 128_000, 1_000_000):
    print(f"上下文: {tokens:,} tokens")
    for name, unit in profiles.items():
        print(f"  {name}: {cache_gb(tokens, unit):.3f} GB")

sessions = 20
one_session = cache_gb(128_000, 890)
print(f"{sessions}个128K会话仅此缓存约: {one_session * sessions:.3f} GB")
保存为kv_estimate.py后运行python kv_estimate.py。本次任务已实际运行,结果为:32K约0.028GB、128K约0.114GB、1M约0.890GB;按四倍假设分别约0.114GB、0.456GB和3.560GB;20个128K会话约2.278GB。注意四倍来自官方约四分之一的相对说法,是教学估算,不是上一代完整显存实测。
这个计算还揭示了并发效应:单个128K会话的0.114GB看起来不大,20个同时生成就接近2.3GB,100个则超过11GB,而且这仍未计权重与其他缓存。服务容量不能只按单请求峰值规划,还要乘并发、保留安全余量,并区分正在预填充、正在解码和已经空闲的会话。
第一,上下文大不等于召回准。信息埋在长文中仍可能被忽略,要用针在干草堆、跨段推理和真实任务评测。第二,KV Cache不是长期记忆;请求结束后通常释放,跨会话记忆需要数据库、摘要或检索系统。第三,每Token缓存小不等于整机显存小,权重和并发仍可能是主成本。第四,缓存命中不等于回答正确,它只表示已有前缀可复用。
第五,Token不等于汉字。分词器会把文本、代码与符号切成不同数量,容量规划应使用目标模型的分词器实测。第六,不要把FP4缓存与模型全部采用4位权重混为一谈;这里说的是主KV缓存格式,官方模型文件仍包含多种张量类型。
第七,缓存压缩不是免费午餐。更低精度与稀疏索引可能改变数值误差、吞吐和不同长度下的表现。项目方报告的架构收益需要在目标框架中复现,并同时比较首Token延迟、每秒Token、长文召回与最终任务成功率,不能只看显存占用。
长上下文适合整库代码审阅、长合同对照、多轮Agent轨迹和需要保留原文细节的任务。不适合把所有历史无差别塞进请求:内容经常更新、只需少量相关片段或需要跨用户长期记忆时,检索增强生成(RAG)与外部存储通常更可控。
我的判断是,长上下文竞争正从最大长度转向单位Token成本、并发与有效召回的综合工程。DeepSeek的缓存压缩很有启发,但890字节指标来自项目方定义,部署团队仍要在自己的硬件、框架、批量和提示分布上测峰值显存与端到端延迟。
一个稳妥的产品策略是先给输入分层:必须逐字保真的原文进入上下文,可检索资料留在外部索引,旧对话压成带来源的摘要。这样上下文窗口承担当前任务,KV Cache加速当前生成,外部存储负责长期记忆,三个角色清楚后才不容易把容量当能力。
把程序中的会话数改成100,并分别计算32K、128K和1M上下文的缓存总量;再加入30%的安全余量。然后回答:你的GPU预算能支持多少并发?若不能,是截断历史、做摘要,还是改用RAG?
你的长上下文应用更先遇到找不准,还是显存与成本扛不住?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
