










“AI越了解我,体验就越好”正在成为默认产品逻辑。Google DeepMind团队9月17日提交的一项五天随机对照研究却发现,多数态度变化来自重复使用,而不是个性化本身;更值得警惕的是,不同个性化方式会把用户带向不同的信息分享行为。记忆不是一个无害的便利功能。
研究招募992名完成全部流程的参与者,让他们连续五天、每天约15至20分钟围绕人际关系向语言模型寻求建议,共形成4960次对话。参与者被随机分到三组:无个性化;基于前几天对话摘要的记忆式个性化;基于研究前问卷画像的问卷式个性化。
所有人都填写日常和前后测问卷,研究还分析实际对话中的自我披露,并设计了错误建议接受测试。参与者确实感知到两种个性化方案“更了解自己”,说明实验操控有效。
来源:arXiv摘要、论文HTML全文。研究经过预注册,但只持续五天、聚焦关系建议且处于受控环境,不能直接外推到所有聊天产品。
随着会话次数增加,三组参与者都更倾向认为AI有能力、有用,也感觉与它更亲近。换句话说,即使系统不读取个人记忆,持续出现、持续回应本身就可能改变用户判断。产品若只比较“开启记忆”和“首次使用”,会把重复暴露的作用误算成个性化收益。
多数指标上,两种个性化与对照组没有显著差异:它们没有普遍增加亲近感,没有让参与者接受更多错误建议,也没有显著改变自报披露深度。但对话日志显示,记忆组实际出现更多自我披露,同时参与者并不一定认为谈话更亲密;问卷组则更容易后悔向AI分享了个人信息。
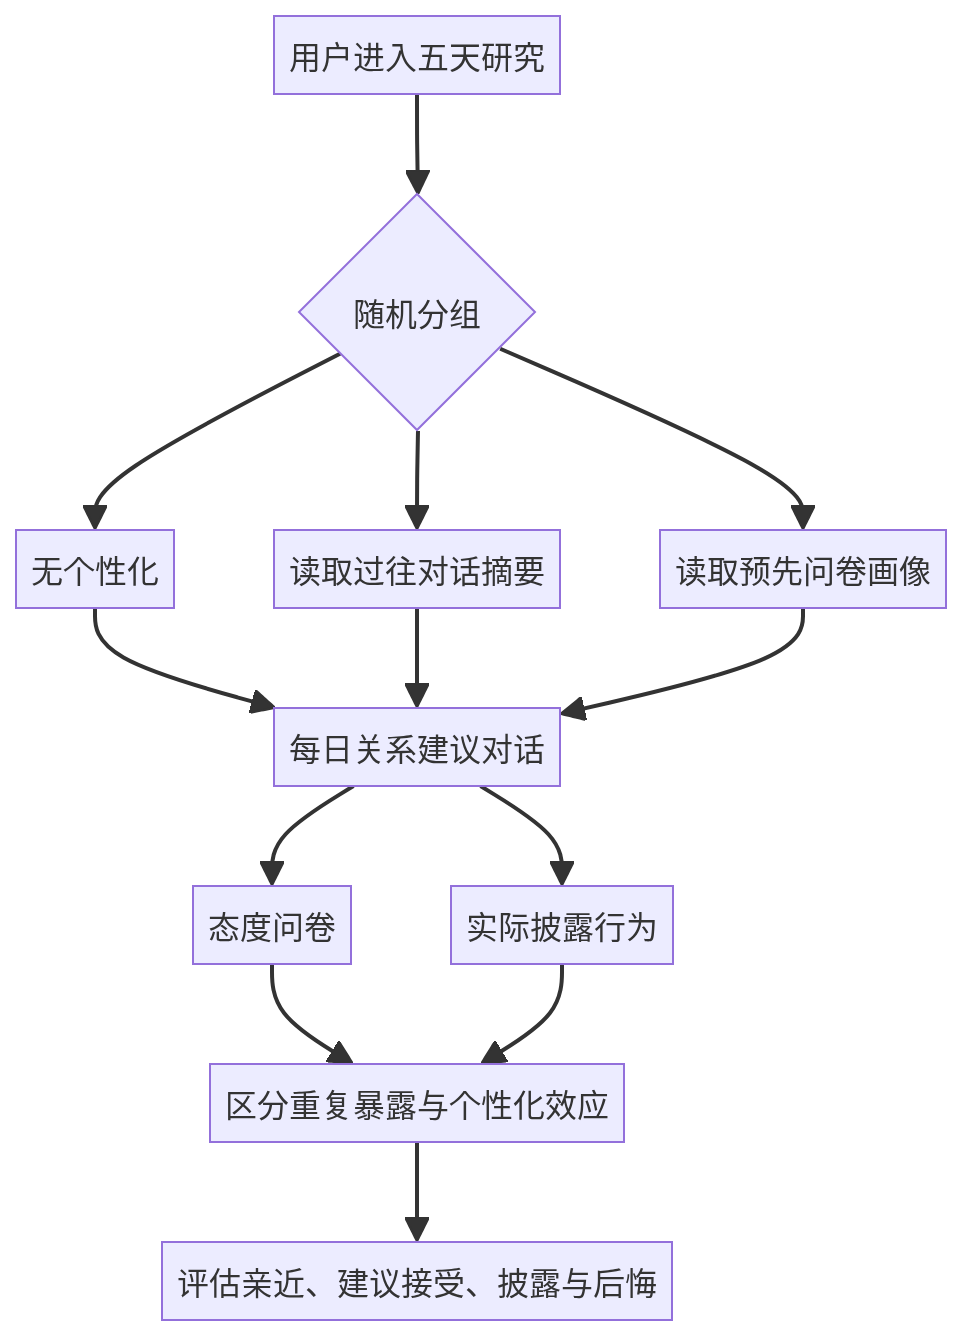
记忆式个性化沿着对话逐步建立连续感,像对方记得昨天发生的事。它可能降低突兀感,让人不知不觉提供更多细节。问卷式个性化一开始就拿着一份完整画像,系统的了解程度可能超过双方刚建立的关系,容易显得侵入性更强。
这里可以用一个具体场景理解:用户昨天说过与同事争执,今天AI自然追问后续;与AI第一次见面就引用年龄、家庭状态和价值观,心理体验并不相同。两种方式在工程上都是把用户数据放进上下文,在人际感受上却像“记得你说过”与“先查过你的档案”。
论文也观察到五天后,部分参与者对向人类熟人、朋友或专家求助的舒适度下降,但并非所有个性化组都一致。作者明确没有证明亲近导致披露,也没有证明AI取代了人际关系;这些只是需要更长期研究的关联与可能机制。
个性化AI不应只优化回答相关性,还必须优化用户对“系统知道什么”的可预期性。 真正危险的不是数据量本身,而是用户以为自己没有进入更亲密的互动,行为上却已经分享更多。只看满意度、停留时长和复访,会漏掉披露后悔与人际替代等慢变量。
更合理的产品指标应成对出现:记忆命中率与错误引用率、个性化满意度与分享后悔、会话深度与敏感信息披露、留存与关闭记忆的比例。用户还应能看到、编辑、暂停和删除记忆,并在系统引用个人信息时知道来源。
还应区分“记住事实”和“推断人格”。前者可以让用户直接校正,后者往往隐藏在模型行为里。即使用户同意保存一次对话,也不等于同意系统持续推断其情绪、价值观或脆弱点。
实验讨论主题被指定,模型行为受到系统提示约束;自然使用中的话题、时长和动机更复杂。研究只使用文本,语音可能加强亲密或诡异感。它研究的是用户明确提供的信息,没有覆盖模型自行推断属性、讨好式回应与主动推荐叠加后的影响。
团队可以立即做一项低成本检查:抽样100次个性化引用,记录数据来源、是否必要、是否准确、用户能否纠正;同时在关闭记忆后验证数据是否停止进入推理。涉及健康、情感或财务建议时,默认减少敏感记忆,并提供转向人类支持的明显入口。
你更愿意让AI记住过去的对话,还是每次由你明确选择要提供的资料?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
