





一组AI请求平均1秒完成,用户仍可能频繁遇到5秒卡顿。通俗地说,平均值像全班平均身高,无法告诉你最高那几个人有多高;P99则告诉你最慢的1%请求处在什么位置。学会分位数、首Token时间和Token间延迟,你就能把“感觉有点慢”变成可复现的性能问题。
NVIDIA在9月18日发布AIPerf实践指南。AIPerf是Apache 2.0许可的开源AI推理压测工具,也是GenAI-Perf的后继者。它采用多进程工作器发压、独立服务处理记录,并用ZeroMQ协调,目的是避免Python全局解释器锁让客户端先成为瓶颈。项目支持15类以上端点、公开数据集和生产流量回放。
来源:NVIDIA技术文章、AIPerf仓库、项目配置与许可证。最新事件是工具指南发布;尾延迟与分位数则是长期通用的性能概念。
大模型响应不是一个单一耗时。TTFT是Time to First Token,即请求发出到首个Token到达的时间,决定“多久开始说”;ITL是Inter-Token Latency,即相邻Token之间的间隔,决定“说话是否顺”;请求总延迟包含预填充与生成;输出吞吐则衡量整个系统每秒生成多少Token。
生活类比是餐厅:TTFT像第一道菜多久上桌,ITL像后续菜是否连续,总延迟像整桌吃完,吞吐像厨房一小时能服务多少桌。类比的边界在于,GPU会批处理不同长度请求,长提示的预填充与生成阶段还会争夺同一资源,不能把每个请求当成独立厨师。
准确地说,P99是样本延迟分布的第99百分位:约99%的观测不超过它,约1%更慢。它不是“最慢值”,也不是固定某一条请求;样本太少、流量不稳定或计算方法不同,都可能让P99摇摆。因此测试必须记录样本数、请求长度、并发、到达方式、模型版本与随机种子。
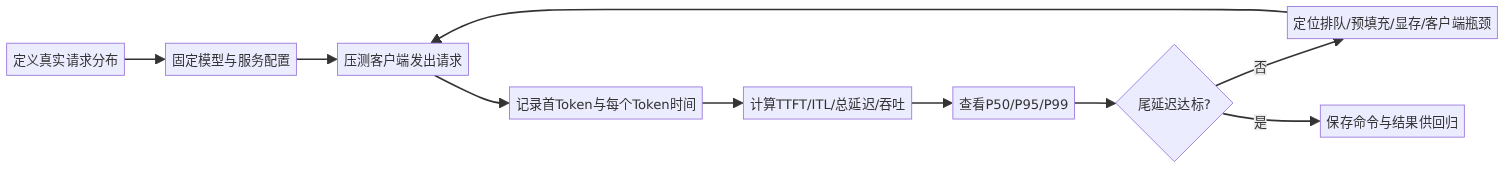
先用纯Python看懂分位数,无需安装依赖。保存为tail_latency.py,运行python tail_latency.py:
import math

latency_ms = [420, 450, 470, 490, 510, 530, 560, 610, 900, 4200]

def percentile(values, q):
    ordered = sorted(values)
    rank = math.ceil(q * len(ordered)) - 1
    return ordered[max(0, rank)]

average = sum(latency_ms) / len(latency_ms)
for q in (0.50, 0.90, 0.99):
    print(f"p{int(q * 100)} = {percentile(latency_ms, q)} ms")
print(f"average = {average:.1f} ms")
本次任务已用Python 3实际运行:P50为510毫秒,P90为900毫秒,P99为4200毫秒,平均914毫秒。平均值没有揭示最慢请求到底多糟;P99则直接暴露4.2秒尾巴。这里使用“最近秩”教学定义,生产报表应统一工具定义。
真实AIPerf首轮可用uv tool install aiperf安装,再对兼容聊天端点执行aiperf profile --model 模型名 --endpoint-type chat --streaming --url 主机:端口 --request-rate 10 --arrival-pattern poisson --request-count 200。官方示例还配置输入输出Token均值、标准差与随机种子。该命令未在本次任务中实际运行,因为环境没有GPU模型服务;不能把文中结果当成你的硬件实测。
第一,只测并发1。它得到接近理想下限,却看不到排队。第二,只看平均值;少量极慢请求会被稀释。第三,不开流式却报告TTFT和ITL;没有Token事件就无法正确测这两个指标。第四,要求输出128个Token却允许模型提前停止,吞吐结果会随回答内容漂移。
第五个常见坑是压测器本身不够快。若客户端CPU满载、连接数受限或日志同步写盘,看到的瓶颈不一定在服务器。AIPerf的多进程设计正是为此而来,但仍需同时监控压测机与服务端。
它适合比较模型服务版本、容量规划、缓存策略、并发上限和回归发布。不适合用一次合成测试宣称某模型“更聪明”或某云“永远更快”。线上请求包含不同语言、工具调用、长短提示和网络距离,静态128入128出只能建立基线,不能代表用户体验。
泊松到达模式适合模拟相互独立请求造成的自然抖动,但促销秒杀、批处理和Agent成组调用可能更突发,需要回放真实轨迹。含敏感数据时,应先脱敏或生成统计等价样本,不能把生产对话直接复制到测试环境。
比较两个版本时还要先预热模型、缓存与连接池,并交替运行多轮。只测新版本一次、旧版本一次,结果可能被后台任务、温度变化或冷缓存左右。保存完整命令、镜像摘要和原始JSON,回归结论才可复查。
好的推理基准测的不是一块GPU有多快,而是系统在真实竞争下有多可预测。 优化平均值常让演示更漂亮,优化P99才决定用户会不会反复点击、超时重试或离开。团队应把性能目标写成“在某种请求分布和并发下,TTFT P99低于多少”,而不是一句“响应要快”。
把脚本中的4200改成1200,观察平均值与P99各下降多少;再复制20个500毫秒请求,看看样本组成如何改变分位数。最后写下你的应用最重要的一个SLO:客服更看TTFT,长文生成更看ITL,批处理则可能更看吞吐。
你的AI应用更不能接受首Token慢,还是生成到一半突然卡顿?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
