




惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

MyScale Blog
MyScale Blog
人人都是产品经理
人人都是产品经理
云风的 BLOG
云风的 BLOG
小众软件
小众软件
F
Fortinet All Blogs
爱范儿
爱范儿
WordPress大学
WordPress大学
N
Netflix TechBlog - Medium
Recent Announcements
Google DeepMind News
C
Check Point Blog
博客园 - 聂微东
D
Docker
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
aimingoo的专栏
aimingoo的专栏
Vercel News
Vercel News
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
A
About on SuperTechFans
博客园 - 【当耐特】
Microsoft Azure Blog
B
Blog
宝玉的分享
宝玉的分享
Jina AI
Jina AI
H
Hackread – Cybersecurity News, Data Breaches, AI and More

Java for You

语义相近却总找错资料?从Embedding看懂向量检索 - Java for You - java4u AI算力开始听电网指挥:比换GPU更现实的增产方法 - Java for You - java4u 票据抽取不一定要上最大模型:先看版式是否真的变化 - Java for You - java4u 临床AI别再只比像不像标准答案,先算医生少改了多少 - Java for You - java4u AI做长程科研,真正稀缺的不是更多Agent而是反证链 - Java for You - java4u AI代码审计最危险的不是漏报,而是团队开始不再相信它 - Java for You - java4u 100万Token不等于模型全记住:从KV Cache看懂长上下文成本 - Java for You - java4u AI写歌有了工程图:YuE2把旋律和和弦放回可编辑层 - Java for You - java4u Claude接入十余种金融系统后,真正稀缺的是可追溯的审批链 - Java for You - java4u 本地语音AI不等于零风险:VoiceStudio最值得看的三条边界 - Java for You - java4u AI代码评审开始跑测试,真正该升级的是团队证据链 - Java for You - java4u 4万星的Agent技能提醒我们:答案太全也可能不可用 - Java for You - java4u 流式JSON为什么总报错?理解结构化输出就能接稳AI接口 - Java for You - java4u 一个浏览器看见飞机船舶与卫星,空间智能的门槛变了 - Java for You - java4u 编码Agent搬出编辑器后,本地优先工作台在解决什么 - Java for You - java4u AI写代码开始像带团队:Qwen Code补上工作流控制台 - Java for You - java4u AI会聊天却不会改3D模型?从Pascal 1.0看懂MCP工具调用 - Java for You - java4u 让AI审科学公式,它最适合当比较员而非裁判 - Java for You - java4u 智能体上线最难的不是提示词:Agents API开始托管运行时 - Java for You - java4u AI任务一多就堵车:问题可能不在模型速度 - Java for You - java4u AI能写无人机控制代码后,安全边界不能只守提示词 - Java for You - java4u AI代码扫描能批量开了,但它还不能替你挡住合并 - Java for You - java4u 机器人动作误差降近九成,真正该先看数据切分 - Java for You - java4u 图片一多首字就慢?用EPD拆开多模态推理三段路 - Java for You - java4u NVIDIA把供应链专家经验训练进模型,关键不是换一个更大模型 - Java for You - java4u 人人都能问公司数据之后,数据分析师反而更重要了 - Java for You - java4u 语音AI开始边听边说,改变的不只是响应速度 - Java for You - java4u Agent到底比一次大模型调用多了什么?小白从这张流程图看懂 - Java for You - java4u ChatGPT服务10亿周用户后,最难扩展的可能不是模型 - Java for You - java4u AI编码助手的日志也会泄密:先划清明文边界 - Java for You - java4u
蛋白预测快2.9倍,科学AI最难的是让整条流水线不空转 - Java ...
蜗牛 · 2026-09-13 · via Java for You

地球与网络光带

蛋白结构预测进入大批量阶段后,模型快不等于项目交付快。可引用的核心判断是:科学AI真正的吞吐,要用成功完成的结构数量和完整资源时间衡量,而不是只截取一次GPU前向。NVIDIA的新案例给出了2.9倍这个醒目数字,也把数字不能代表什么写得足够清楚。

发生了什么

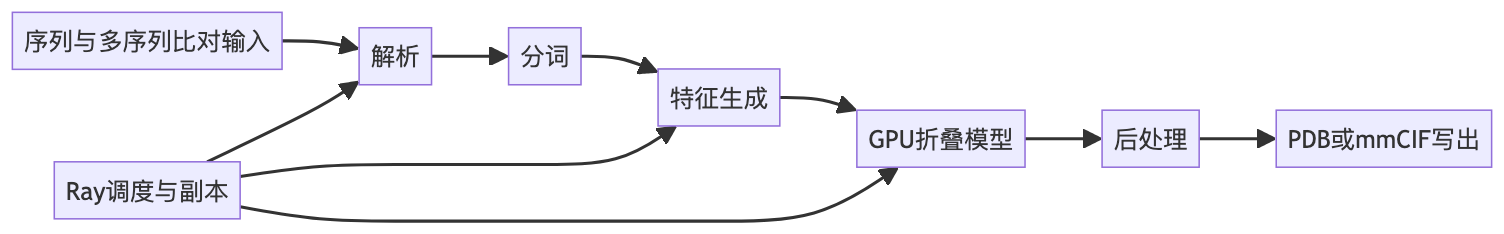
NVIDIA在9月10日介绍BioNeMo Inference Runtime(BioIR)的高吞吐结构预测流程。它支持把输入解析、分词、特征生成、GPU折叠与PDB或mmCIF文件写出串成处理管线;也可作为PyTorch模块嵌入自定义代码。多GPU模式用Ray在每张卡放置完整模型副本,分发相互独立的蛋白任务。

在1000个人类二聚体目标、8张H100 80GB、相同多序列比对和推理配方下,官方称BioIR加速的Boltz-2每分配GPU小时完成5.85万条残基,公开的torch.compile实现为2.02万条,提升2.90倍。公开实现另有29个目标显存不足。

关键事实与证据

流程、代码和测试限定来自NVIDIA技术文章,运行时仓库已在GitHub公开。测试目标的合计序列长度低于2800残基,使用3次循环、200个采样步和每目标5个扩散样本。

单副本前向测试中,官方还报告Boltz-2相对公开基线的几何平均加速约1.78倍(H100)和1.75倍(H200)。这与整批任务的2.90倍不是冲突:前者只测GPU同步的模型前向,后者还包含多副本并行、CPU阶段重叠以及成功率差异。

官方估算一百万个相似目标的额定功率等效能耗为11MWh,对照实现为35MWh。但这是按热设计功耗线性外推的折叠阶段估算,不是机房电表读数;它排除了多序列比对生成、存储、数据传输、重试和制冷开销。

技术原理:三层优化解决三种瓶颈

第一层是内核选择,按GPU、数据类型和张量形状选择定制内核或PyTorch回退。第二层是模块优化,用CUDA Graph捕获形状兼容的计算,减少反复启动内核的CPU开销。第三层是流水线扩展:Ray让解析、特征生成、折叠和写盘并行推进,并在多卡上复制完整模型。
mermaid diagram

这里的关键不是无脑增加副本。如果特征生成太慢,GPU会等输入;如果对象存储或写盘跟不上,结果会在尾部排队。四个GPU副本还意味着四份完整模型显存,并不是把一次前向切到四张卡。

一个具体场景

一家生物技术团队要筛选十万个蛋白复合体。若只拿20条短序列测模型前向,可能得出“GPU还有余量”;真实工作集加入长序列、失败重试和文件写出后,CPU特征阶段才是瓶颈。正确方法是固定一份有长短分布的代表性清单,分别跑1、2、4个副本,记录完成结构/小时、GPU利用率、峰值显存、失败率和端到端时间。

对开发者和科研团队的影响

对开发者,BioIR把一套高性能运行时放回熟悉的PyTorch与Ray工作流,降低自写内核和调度的门槛。对科研团队,更快的候选结构生成可以扩大筛选范围,但不会自动提高结构可信度,更不能替代实验验证。吞吐优化解决的是“看多少”,不是“每一个都一定对”。

对项目负责人,成本核算也会随之改变:除了GPU小时,还要把CPU预处理、共享存储、失败重跑和结果归档列入预算。否则模型阶段省下的时间,可能被更长的排队与数据准备重新吃掉。

我的判断及依据

我的判断是,科学AI平台接下来的差异化将更多出现在数据与计算管线,而不是模型榜单。依据是:BioIR单次前向约1.78倍,工作集吞吐却达到2.90倍,说明调度、重叠和失败处理贡献很大;同时29个显存失败提醒我们,完成率本身就是性能指标。

适用边界与风险

结果由NVIDIA在自家硬件和运行时上测试,只适用于指定模型、输入分布与配方。BioIR不负责运行HHsearch或HMMsearch,多序列比对仍需预先准备;示例的Ray配置只覆盖单节点。结构预测置信度不能当作药效、安全性或临床有效性的证明。

此外,长序列的显存占用和运行时间并非线性增长。复现实验不能只抽短样本,也不能把失败目标从分母里悄悄删掉;完成率必须与吞吐一起公开。

今天就能执行的检查表

  • 先用串行模式验证一条真实输入和输出文件,再扩大并发。
  • 代表性工作集必须包含真实的长度、链数、失败和重试分布。
  • 把模型前向、特征生成、排队、写盘和端到端时间分别记录。
  • 用“成功残基/GPU小时”和“完成结构/小时”同时看效率。
  • GPU等待时先检查CPU阶段和队列;写盘积压时别继续加模型副本。
  • 能耗结论只使用实测整机功率与完整流程时间,不把TDP外推写成电表结果。

你在科学计算流水线里最常见的空转来自哪里:数据准备、GPU推理、调度,还是结果写盘?

关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。