








多开几个Agent很容易,多走几十步仍不把早期错误放大才难。9月14日提交的Stellar Colosseum论文,把数学和理论计算机科学研究组织成路线探索、成熟度判断、分段证明、针对性反证与反馈修复。它对开发者最有用的启示不是“Agent数量越多越聪明”,而是每个结论都要保留依赖关系,让验证失败能准确退回原步骤。
论文做了什么
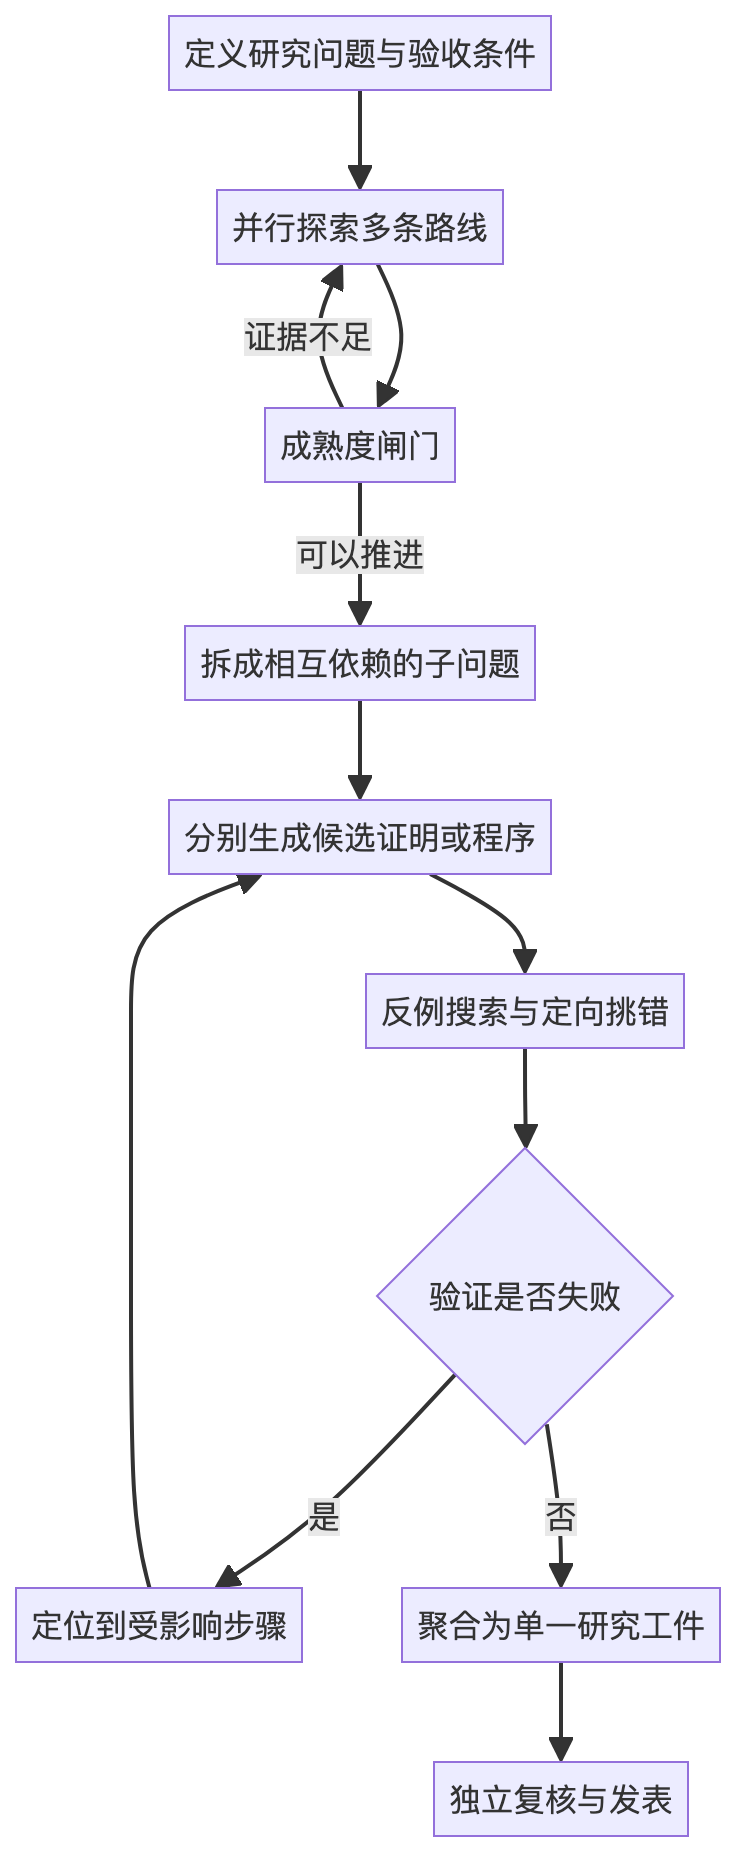
研究者提出一个与具体模型无关的推理脚手架。系统先并行探索多条证明路线,不急着写完整答案;再通过“readiness gate”判断路线是否成熟,只有关键引理和障碍足够清楚才继续分解。随后,整体证明被表示成互相依赖的章节级子问题,每个候选都接受针对性反驳,验证器发现的问题会回传到受影响的部分。
作者报告,使用Gemini 3.1 Pro和Gemini 3.7 Flash时,系统在TCS-Bench研究级定理证明任务上达到71.0%准确率;在另一组Codeforces评测中,带执行反馈的证明导向流程解决222题中的218题。作者还称系统得到若干针对既有论文开放问题的新结果。它们是论文方结果,尚不能替代同行评审、形式化证明或社区复现。
为什么长任务容易崩
短题错一步,最终答案很快暴露;长研究的中间结论可能在几十步后才被使用。若系统只在最后让多个Agent投票,一个共享的错误假设会被包装得更一致,却不会消失。Colosseum的价值在于把“谁依赖谁”显式化:验证器指出某个引理缺条件,系统只重做相关分支,而不是用一段更长的自然语言掩盖问题。
生活中的类比是软件持续集成。多个开发者并行提交代码并不自动提升质量,必须有测试、依赖图和失败定位。类比的边界也很重要:数学证明的正确性比一般软件需求更严格,运行几个样例不能证明定理成立,自然语言评审器也可能与生成器共享盲点。
能迁移到哪些开发场景
最直接的不是让AI发表论文,而是处理有明确工件和检查器的长任务。例如大型代码迁移可先提出数据库、接口与部署三条路线,再用兼容性测试和静态分析攻击每条假设。安全审计可把攻击面拆成权限、输入、网络和供应链,并让验证结果回到对应证据,而不是汇总成一句“风险较高”。
设想把一个Python单体服务迁移到事件驱动架构。生成Agent提出事件模型,挑错Agent专门寻找重复消费与顺序问题,执行器跑集成测试,聚合器只接收有日志和测试证明的修改。若订单幂等测试失败,系统应退回事件处理分支,而不是重写整份架构说明。
我的判断与风险
我的判断是,多智能体的下一阶段会从“角色扮演”转向“可检查的推理项目管理”。真正带来收益的变量包括路线多样性、何时停止探索、验证器是否独立、错误能否回流,以及最终工件能否复现。Agent数量只是成本参数。
风险也很清楚。第一,基准使用的模型、提示和预算会显著影响结果,71.0%不是框架在所有模型上的固定能力。第二,Codeforces通过测试不等于研究证明正确,隐藏测试也可能不完整。第三,多Agent共享同一模型时会形成相关错误;增加调用次数还会放大成本。第四,论文声称的新结果需要领域专家逐项检查,不能当作已被学界接受的事实。
一份可执行的小型流程
- 先写验收条件:测试、数据来源、允许的工具和停止规则。
- 要求三个候选路线使用不同假设,而不是换措辞重复同一路线。
- 在完整生成前设置成熟度闸门,缺少证据就暂停扩写。
- 为每个子结论记录输入、输出、依赖和验证方法。
- 单独安排反例搜索者,奖励发现错误而非附和主方案。
- 聚合时只采纳通过检查的片段,并保留失败记录。
- 最终让未参与生成的人或工具独立复核。
不适合把这套流程用在没有明确验收标准的价值判断,也不适合为了“像团队”而无限增加Agent。预算有限时,一个生成器加一个强验证器,往往比五个相互赞同的生成器更可靠。
你更愿意把额外推理预算花在生成更多方案,还是专门攻击最脆弱的那个假设?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。