



前沿AI最难评的,往往不是发布后的公开模型,而是训练中不断变化的系统。Anthropic这次把第三方评测员请进研发现场,方向值得肯定;但“看得更多”不自动等于“更独立”。对开发者、企业采购者和普通用户而言,真正有价值的是一套能回答三件事的机制:评测员看到了什么、依据什么下结论、哪些结果允许外界复核。
9月18日,Anthropic宣布与Accenture合作开展前沿AI的“嵌入式评测”。项目由Accenture旗下AI业务Faculty牵头,工作包含模型评估、红队测试、对齐评估和安全措施测试。双方称,未来五年各自预计至少投入10亿美元建设相关能力。这里的10亿美元是“预计投入”,不是已经支付的评测合同金额,也不能直接推导出评测质量。
与常见外部测评不同,嵌入式评测员将获得接近公司员工的访问权限。他们可以在模型成形过程中观察训练与部署决策、与内部人员交流,并在发布前寻找盲区。Anthropic也坦言,访问范围、报告方式和长期资金来源目前都没有统一标准,早期工作由Anthropic直接出资,合作为非独家安排。
一手来源:Anthropic公告。以上是公司公开说法,尚不是独立机构对项目成效的验证。
模型评测不是只跑一次题库。真正接近生产的评测,需要看到模型版本、系统提示、工具权限、过滤器、部署地区和事件日志。任何一项变化,都可能让同一个模型呈现不同风险。嵌入式团队的优势,是把评测从发布前的“成品抽检”前移为研发过程中的连续检查。
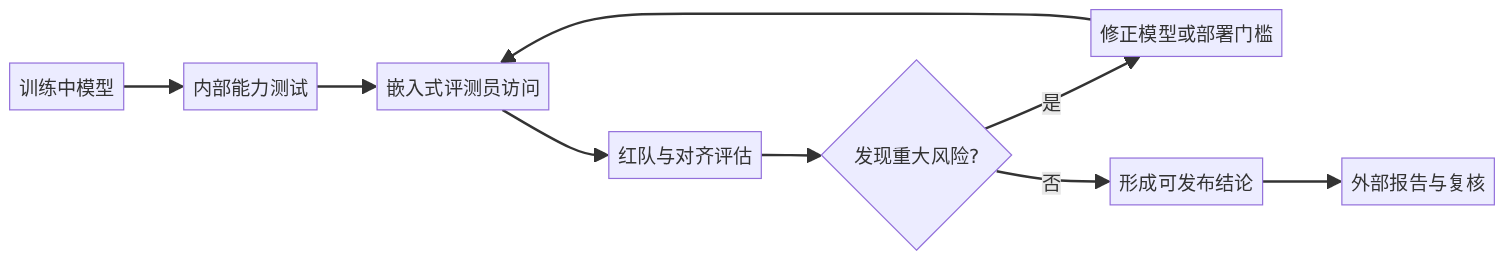
关键区别在最后一环。如果外部只能看到一句“已完成红队测试”,过程仍然不可验证;如果报告披露测试范围、失败样例的统计口径、版本哈希、整改状态和保留意见,采购方才有机会把安全承诺转成合同与上线门槛。
对模型公司,常驻评测会更早暴露问题,也会让研发节奏接受外部追问。对企业客户,最现实的场景是采购一个能访问邮件、代码库和客户数据的Agent:它在演示中表现优秀,不代表越权、提示注入和数据外泄已经被覆盖。采购团队应要求供应商说明评测覆盖的具体产品版本,而不是接受“基础模型通过评测”这种宽泛表述。
对评测行业,这可能形成新的专业角色:既懂模型行为,又能读训练和部署证据,还要有类似审计的独立性纪律。难点也很明显——评测员需要内部权限,却由被评公司付费;他们知道得很多,却可能受保密协议限制。访问深度与公开透明之间不是天然一致的。
这项合作的最大价值,是承认黑盒外测存在上限。我的核心判断是:嵌入式评测能提高发现问题的概率,但只有制度化披露才能提高公众相信结论的理由。 评测机构的品牌、投入金额和员工级访问,都不能替代可核验的程序。
我会观察四个信号:第一,评测员是否能自主选择测试而非只执行公司给定清单;第二,是否拥有直接向董事会或监管者报告重大事件的通道;第三,公司能否阻止或延迟不利结论发布;第四,报告是否区分“未发现风险”和“未覆盖该风险”。只要这四点含糊,“独立”就仍是一种关系描述,不是质量证明。
嵌入式评测不等于监管,也不能保证模型无风险。评测员可能被内部文化同化,测试集也可能追不上新能力。Anthropic与Accenture公布的投入、权限和计划均为双方说法;具体人员配置、报告模板、事故披露时限和外部申诉机制尚未公开。未来报告若只给结论不给方法,外界仍难判断遗漏率。
企业采购或接入前沿模型时,可以立即追问:评测对应哪个模型和系统版本;覆盖哪些工具与数据权限;谁定义失败标准;发现问题后是否复测;完整报告由谁持有;重大分歧是否会公开。开发团队还应保留自己的越权测试、工具调用日志和人工审批,不把供应商评测当作免责条款。
还可以在合同中写入版本变化触发器:模型、系统提示、工具权限或安全过滤器一旦发生重大调整,就必须重新评测,而不是沿用旧报告。对严重事件,约定通知时限、证据保全和独立复盘;对暂不能公开的内容,至少让客户审计方在保密条件下查验。这样,“通过评测”才会从一次性徽章变成持续义务。
如果评测机构由被评公司出资,你最希望强制公开哪一项证据?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。
