











用了Deepseek这么久,一直被一个问题困扰,就是Deepseek是纯文本模型,不支持视觉识别,这点相当之不方便,因为现在不论是国外的什么模型,视觉识别应该是算是标配了。󠄐󠄹󠅀󠄪󠄢󠅑󠄠󠄦󠄪󠄩󠄨󠅓󠄠󠄪󠄣󠄦󠄠󠄠󠄪󠄪󠄡󠄠󠄣󠄬󠅒󠅢󠄟󠄮󠄐󠅅󠄹󠄴󠄪󠄾󠅟󠅤󠄐󠄼󠅟󠅗󠅙󠅞󠄬󠅒󠅢󠄟󠄮󠅄󠅙󠅝󠅕󠄪󠄡󠄧󠄨󠄧󠄦󠄤󠄦󠄨󠄢󠄨󠄬󠅒󠅢󠄟󠄮
因为我QQ群的机器人模型就是调用的Deepseek,虽然可以外接其他模型,比如ChatGPT Gememi,但是依旧速度上很不愉快。󠄐󠄹󠅀󠄪󠄢󠅑󠄠󠄦󠄪󠄩󠄨󠅓󠄠󠄪󠄣󠄦󠄠󠄠󠄪󠄪󠄡󠄠󠄣󠄬󠅒󠅢󠄟󠄮󠄐󠅅󠄹󠄴󠄪󠄾󠅟󠅤󠄐󠄼󠅟󠅗󠅙󠅞󠄬󠅒󠅢󠄟󠄮󠅄󠅙󠅝󠅕󠄪󠄡󠄧󠄨󠄧󠄦󠄤󠄦󠄨󠄢󠄨󠄬󠅒󠅢󠄟󠄮
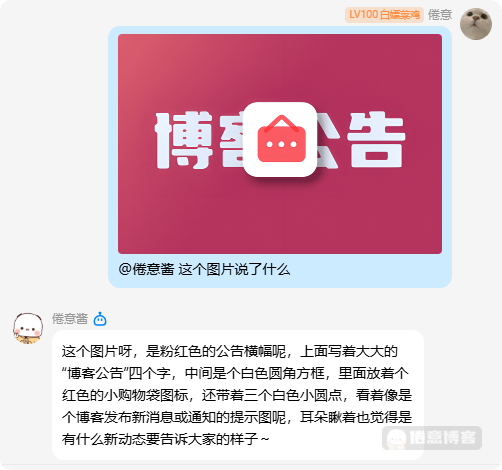
所以看到Deepseek出了视觉模型 deepseek-v4-flash-vision-exp 我也是马上用上了。将机器人的对话模型切换到到 vision,其他的什么都不用动,就可以丝滑切换使用了。
关于定价问题
我看官网手册上的价格和Flash模型同步,唯一的区别就是Deepseek的图片和分辨率是挂钩的,也就是分辨率越大消耗的Token越多。并且单次图片消耗的Token最大值是384,差不多一个图片几分钱,感觉还挺划得来的,Deepseek这是又要走回最熟悉的价格战阵地了吗?󠄐󠄹󠅀󠄪󠄢󠅑󠄠󠄦󠄪󠄩󠄨󠅓󠄠󠄪󠄣󠄦󠄠󠄠󠄪󠄪󠄡󠄠󠄣󠄬󠅒󠅢󠄟󠄮󠄐󠅅󠄹󠄴󠄪󠄾󠅟󠅤󠄐󠄼󠅟󠅗󠅙󠅞󠄬󠅒󠅢󠄟󠄮󠅄󠅙󠅝󠅕󠄪󠄡󠄧󠄨󠄧󠄦󠄤󠄦󠄨󠄢󠄨󠄬󠅒󠅢󠄟󠄮
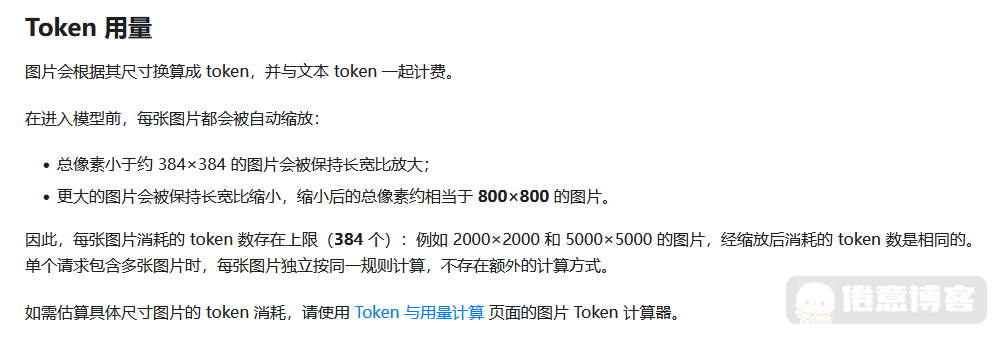
在官方公众号上,Deepseek说视觉识别模型定价和v4-Flash价格一致。
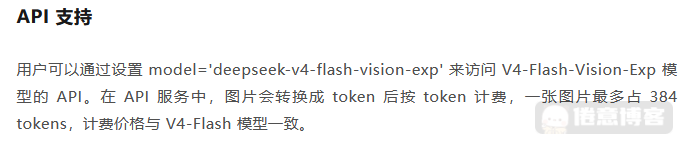
我的理解就是说如果你使用 deepseek-v4-flash-vision-exp 那么如果输入纯文本,那就是v4-Flash 的价格,如果加上了图片,那就是v4-Flash的价格+图片识别的价格。应该是这个意思。
顺便一说,在今天(8月23号),Deepseek宣布周末全天是低谷时间计费。󠄐󠄹󠅀󠄪󠄢󠅑󠄠󠄦󠄪󠄩󠄨󠅓󠄠󠄪󠄣󠄦󠄠󠄠󠄪󠄪󠄡󠄠󠄣󠄬󠅒󠅢󠄟󠄮󠄐󠅅󠄹󠄴󠄪󠄾󠅟󠅤󠄐󠄼󠅟󠅗󠅙󠅞󠄬󠅒󠅢󠄟󠄮󠅄󠅙󠅝󠅕󠄪󠄡󠄧󠄨󠄧󠄦󠄤󠄦󠄨󠄢󠄨󠄬󠅒󠅢󠄟󠄮

估计也是最近实行时段定价的机制被骂惨了,毕竟在高峰时段用pro的话是相当之贵。
希望以后将整合到Flash和Pro中去,并且逐步完善音频和视频的支持,让V4系列打造成全模态模型。󠄐󠄹󠅀󠄪󠄢󠅑󠄠󠄦󠄪󠄩󠄨󠅓󠄠󠄪󠄣󠄦󠄠󠄠󠄪󠄪󠄡󠄠󠄣󠄬󠅒󠅢󠄟󠄮󠄐󠅅󠄹󠄴󠄪󠄾󠅟󠅤󠄐󠄼󠅟󠅗󠅙󠅞󠄬󠅒󠅢󠄟󠄮󠅄󠅙󠅝󠅕󠄪󠄡󠄧󠄨󠄧󠄦󠄤󠄦󠄨󠄢󠄨󠄬󠅒󠅢󠄟󠄮
以上。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。