
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

云风的 BLOG
云风的 BLOG
让小产品的独立变现更简单 - ezindie.com
IT之家
IT之家
Recent Announcements
B
Blog
D
Docker
V
V2EX
GbyAI
GbyAI
L
LangChain Blog
博客园 - Franky
U
Unit 42
T
The Blog of Author Tim Ferriss
A
About on SuperTechFans
博客园 - 【当耐特】
Google DeepMind News
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Vercel News
Vercel News
博客园_首页
D
DataBreaches.Net
人人都是产品经理
人人都是产品经理
Y
Y Combinator Blog
量子位
Blog — PlanetScale
Blog — PlanetScale
罗磊的独立博客

博客园 - 南国故人(Wall)

oozie配置安装与原理 Livy原理详解 阿里(蚂蚁金服)招聘 Zeppelin原理简介 Spark job server原理初探 SparkSQL UDF使用方法与原理详解 使用Intellij加载Spark源代码 如何修改Git commit的信息 CarbonData编译与安装 Namenode HA原理详解 Spark Shuffle 堆外内存溢出问题与解决(Shuffle通信原理) Spark SQL 代码简要阅读(基于Spark 1.1.0) RDD原理与详解 Spark详解 Namenode HA原理详解 Spark架构与作业执行流程简介 Spark 开发环境搭建 YARN Application执行流程 [NM 状态机2] Container状态机详解
Spark Streaming 执行流程
南国故人(Wall) · 2014-08-30 · via 博客园 - 南国故人(Wall)

原文连接  http://xiguada.org/spark-streaming-run/ ‎

Spark Streaming 是基于spark的流式批处理引擎,其基本原理是把输入数据以某一时间间隔批量的处理,当批处理间隔缩短到秒级时,便可以用于处理实时数据流。

本节描述了Spark Streaming作业的执行流程。
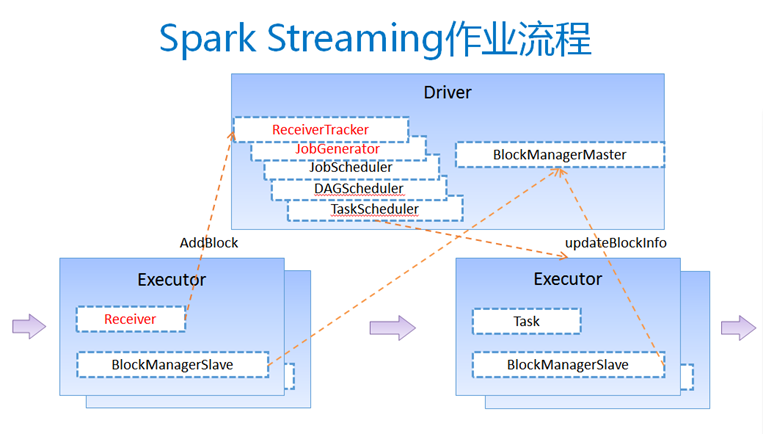
图1 Spark Streaming作业的执行流程

具体流程:

  1. 客户端提交作业后启动Driver,Driver是park作业的Master。

  2. 每个作业包含多个Executor,每个Executor以线程的方式运行task,Spark Streaming至少包含一个receiver task。

  3. Receiver接收数据后生成Block,并把BlockId汇报给Driver,然后备份到另外一个Executor上。

  4. ReceiverTracker维护Reciver汇报的BlockId。

  5. Driver定时启动JobGenerator,根据Dstream的关系生成逻辑RDD,然后创建Jobset,交给JobScheduler。

  6. JobScheduler负责调度Jobset,交给DAGScheduler,DAGScheduler根据逻辑RDD,生成相应的Stages,每个stage包含一到多个task。

  7. TaskScheduler负责把task调度到Executor上,并维护task的运行状态。

  8. 当tasks,stages,jobset完成后,单个batch才算完成。