惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Martin Fowler
Martin Fowler
V
Visual Studio Blog
有赞技术团队
有赞技术团队
T
Tailwind CSS Blog
B
Blog
I
InfoQ
博客园 - 三生石上(FineUI控件)
阮一峰的网络日志
阮一峰的网络日志
F
Fortinet All Blogs
H
Help Net Security
博客园 - Franky
宝玉的分享
宝玉的分享
博客园 - 司徒正美
C
Check Point Blog
G
Google Developers Blog
Cyber Security Advisories - MS-ISAC
Jina AI
Jina AI
T
The Blog of Author Tim Ferriss
MongoDB | Blog
MongoDB | Blog
云风的 BLOG
云风的 BLOG
A
About on SuperTechFans
罗磊的独立博客
大猫的无限游戏
大猫的无限游戏
IT之家
IT之家

博客园 - 南国故人(Wall)

oozie配置安装与原理 Livy原理详解 阿里(蚂蚁金服)招聘 Zeppelin原理简介 Spark job server原理初探 SparkSQL UDF使用方法与原理详解 使用Intellij加载Spark源代码 如何修改Git commit的信息 CarbonData编译与安装 Namenode HA原理详解 Spark Shuffle 堆外内存溢出问题与解决(Shuffle通信原理) Spark SQL 代码简要阅读(基于Spark 1.1.0) RDD原理与详解 Spark详解 Spark Streaming 执行流程 Namenode HA原理详解 Spark架构与作业执行流程简介 YARN Application执行流程 [NM 状态机2] Container状态机详解
Spark 开发环境搭建
南国故人(Wall) · 2014-04-04 · via 博客园 - 南国故人(Wall)

原文见   http://xiguada.org/spark-develop/

本文基于Spark 0.9.0,由于它基于Scala 2.10,因此必须安装Scala 2.10,否则将无法运行Spark作业。由于在windows环境下不方便执行命令行操作,因此建议在Linux环境下搭建Spark开发环境。

  1. 编译Spark 0.9.0,可以使用mvn –DskipTests install或 ./sbt/sbt assembly 编译。如果期间出现OOM异常,则需要加大MAVEN_OPTS的内存设置,如(export MAVEN_OPTS="-Xmx1024m")。

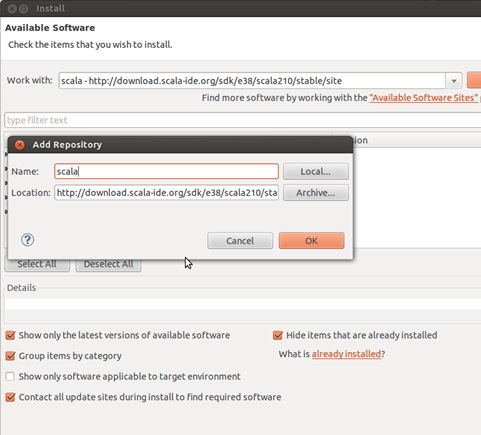
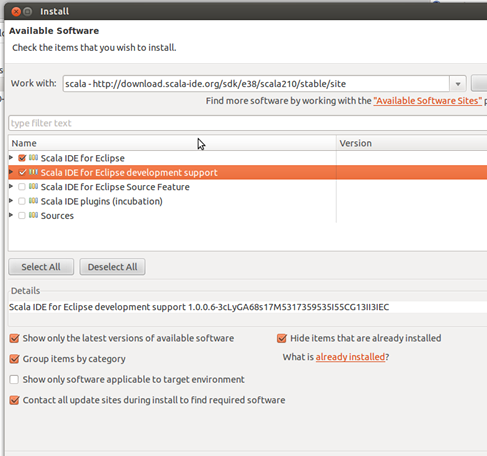
    1. 点击ok后,选择前两项,点击next后确认安装。

    2. 安装成功后,就可以加载spark工程。通过"New"->"Scala Project" ->"Use default location",选择已经编译后的Spark工程,确认后即可加载。加载后的Spark工程如下图所示。

posted @ 2014-04-04 17:40  南国故人(Wall)  阅读(1764)  评论(0)    收藏  举报