









原文连接 http://xiguada.org/spark_rdd/
RDD(Resilient Distributed Datasets弹性分布式数据集),是spark中最重要的概念,可以简单的把RDD理解成一个提供了许多操作接口的数据集合,和一般数据集不同的是,其实际数据分布存储于一批机器中(内存或磁盘中)。当然,RDD肯定不会这么简单,它的功能还包括容错、集合内的数据可以并行处理等。图1是RDD类的视图。
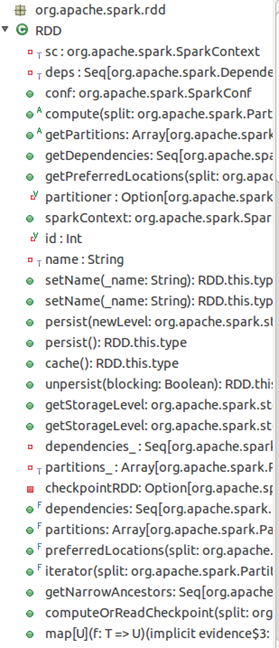
图1
下面是一个实用scala语言编写的spark应用(摘自Apache Spark 社区https://spark.apache.org/docs/latest/quick-start.html)。
/* SimpleApp.scala */
import org.apache.spark.SparkContext
import org.apache.spark.SparkContext._
import org.apache.spark.SparkConf
object SimpleApp {
def main(args: Array[String]) {
val logFile = "YOUR_SPARK_HOME/README.md" // Should be some file on your system
val conf = new SparkConf().setAppName("Simple Application") //设置程序名字
val sc = new SparkContext(conf)
val logData = sc.textFile(logFile, 2).cache() //加载文件为RDD,并缓存
val numAs = logData.filter(line => line.contains("a")).count()//包含a的行数
val numBs = logData.filter(line => line.contains("b")).count()//包含b的行数
println("Lines with a: %s, Lines with b: %s".format(numAs, numBs))
}
}
这个程序只是简单的对输入文件README.md包含'a'和'b'的行分别计数。当然如果你想运行这个程序,需要把YOUR_SPARK_HOME替换为Spark的安装目录。程序中定义了一个RDD:logData,并调用cache,把RDD数据缓存在内存中,这样能防止重复加载文件。filter是RDD提供的一种操作,它能过滤出符合条件的数据,count是RDD提供的另一个操作,它能返回RDD数据集中的记录条数。
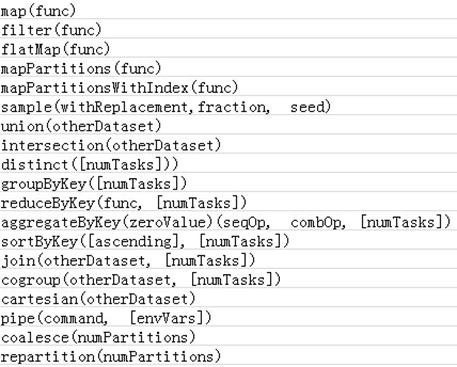
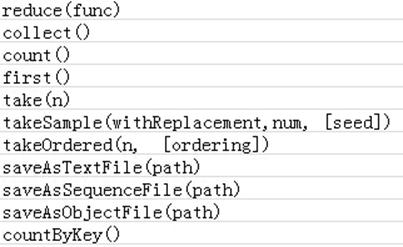
上述例子介绍了两种RDD的操作:filter与count;事实上,RDD还提供了许多操作方法,如map,groupByKey,reduce等操作。RDD的操作类型分为两类,转换(transformations),它将根据原有的RDD创建一个新的RDD;行动(actions),对RDD操作后把结果返回给driver。例如,map是一个转换,它把数据集中的每个元素经过一个方法处理后返回一个新的RDD;而reduce则是一个action,它收集RDD的所有数据后经过一些方法的处理,最后把结果返回给driver。
RDD的所有转换操作都是lazy模式,即Spark不会立刻计算结果,而只是简单的记住所有对数据集的转换操作。这些转换只有遇到action操作的时候才会开始计算。这样的设计使得Spark更加的高效,例如,对一个输入数据做一次map操作后进行reduce操作,只有reduce的结果返回给driver,而不是把数据量更大的map操作后的数据集传递给driver。
下面分别是transformations和action类型的操作。
Transformations类型的操作
Action类型的操作
更多RDD的操作描述和编程方法请参考社区文档:https://spark.apache.org/docs/latest/programming-guide.html。
RDD是一个分布式数据集,顾名思义,其数据应该分部存储于多台机器上。事实上,每个RDD的数据都以Block的形式存储于多台机器上,下图是Spark的RDD存储架构图,其中每个Executor会启动一个BlockManagerSlave,并管理一部分Block;而Block的元数据由Driver节点的BlockManagerMaster保存。BlockManagerSlave生成Block后向BlockManagerMaster注册该Block,BlockManagerMaster管理RDD与Block的关系,当RDD不再需要存储的时候,将向BlockManagerSlave发送指令删除相应的Block。

图2 RDD存储原理
RDD的转换过程中,并不是每个RDD都会存储,如果某个RDD会被重复使用,或者计算其代价很高,那么可以通过显示调用RDD提供的cache()方法,把该RDD存储下来。那RDD的cache是如何实现的呢?
RDD中提供的cache()方法只是简单的把该RDD放到cache列表中。当RDD的iterator被调用时,通过CacheManager把RDD计算出来,并存储到BlockManager中,下次获取该RDD的数据时便可直接通过CacheManager从BlockManager读出。
RDD提供了许多转换操作,每个转换操作都会生成新的RDD,这是新的RDD便依赖于原有的RDD,这种RDD之间的依赖关系最终形成了DAG(Directed Acyclic Graph)。
RDD之间的依赖关系分为两种,分别是NarrowDependency与ShuffleDependency,其中ShuffleDependency为子RDD的每个Partition都依赖于父RDD的所有Partition,而NarrowDependency则只依赖一个或部分的Partition。下图的groupBy与join操作是ShuffleDependency,map和union是NarrowDependency。

图3 RDD dependency
每个RDD都有Partitioner属性,它决定了该RDD如何分区,当然Partition的个数还将决定每个Stage的Task个数。当前Spark需要应用设置Stage的并行Task个数(配置项为:spark.default.parallelism),在未设置的情况下,子RDD会根据父RDD的Partition决定,如map操作下子RDD的Partition与父Partition完全一致,Union操作时子RDD的Partition个数为父Partition个数之和。
如何设置spark.default.parallelism对用户是一个挑战,它会很大程度上决定Spark程序的性能。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。