







2022年后,被安排维护新闻推荐系统的粗排服务。通过初步摸排,发现该服务存在很大的性能问题。流量高峰期服务可用性只能到1个9,cpu使用率也只能到20%,服务内部存在很大的性能问题。
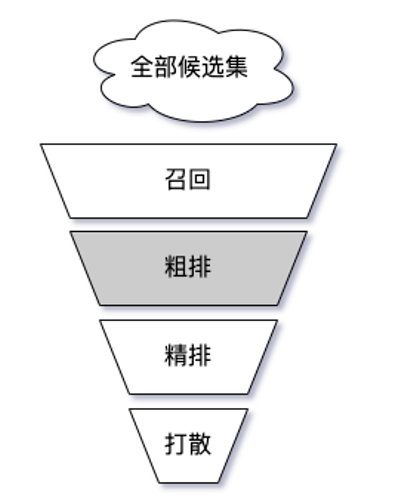
推荐架构中,粗排介于召回和精排之间,是性能和效果的折中的产物。粗排的输入为所有召回的item(万级别,我的应用场景下日常是5000左右,但是经过优化后可以支持万级别输入),输出为进入精排的item(千级别,我的应用场景下日常是600左右)。
新闻推荐系统中,粗排实现的是一个简化的精排模型,双塔结构。用户塔实时抽取特征、计算 embedding。item 塔离线计算 embedding,缓存在 redis 中。用户 embedding 和 item embedding 经过内积计算,得到 item 分数。
粗排的流程如下:
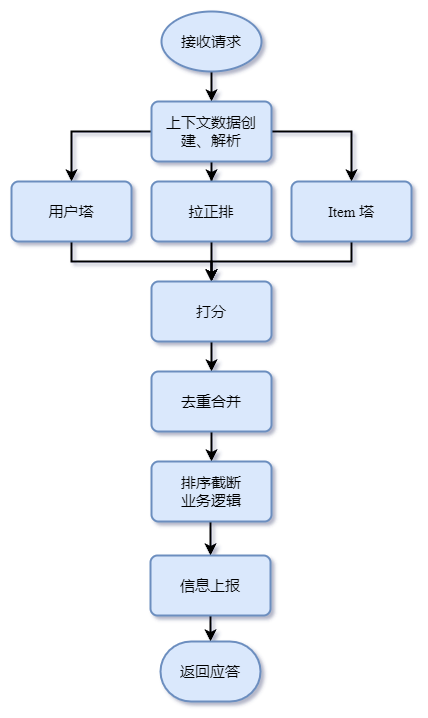
打分之后的排序截断逻辑,会做一些多样性、时效性的调整,从而避免出现信息茧房。
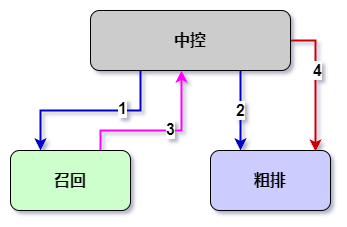
另外,我们的推荐系统中,存在一个中控模块,作为整个系统的出入口和调度中心,依次调用召回、粗排、精排和打散服务。
上面的流程图中存在几个问题,可以优化降低耗时。
用户塔的计算逻辑,并不依赖召回的返回结果。这一部分逻辑可以前提到与召回并行,效果如下:
从性能角度考虑,召回采用了多路独立部署、并行调度的方式。这样存在一个问题,由于各路召回相互隔离,召回的内容存在重复的情况。粗排需要对召回内容进行合并去重处理。
旧的流程中,去重合并放在打分之后,导致前面 item 塔、拉取正排存在重复操作。去重合并提前到上下文数据创建、解析之后,会避免重复计算。
推荐系统通过远端上报来收集样本以及 debug 信息,旧的实现方式是实时全量拼接样本、实时抽样上报。这样存在三个问题,一是全量拼接、抽样上报,浪费了拼接的算力;二是实时拼接和实时上报占用了会话时间;三是拼接逻辑和数据与业务逻辑耦合在一起,相互交错。
升级后的实现方式是异步抽样拼接、异步上报。简要说就是核心会话数据与上报数据解耦,在response之后,异步启动一个任务,命中抽样的情况下,对上报数据进行拼接处理,然后上报。
在项目落地、业务发展中,总是会有些实现不能满足当前业务需求,或者当时开发时急于上线,留下“垃圾”(实际工作中碰到的更多是这种情况)。
粗排内部有一个比较重的历史负债,就是拉取正排逻辑。有两个地方需要正排数据,一个是用户塔获取用户历史正排,一个是召回 item 正排。正排经过一次大的升级,协议由 protobuf 切换到了 flexbuf。但是当时升级时,只用召回 item 正排切换到了 flexbuf,历史正排还是 protobuf 协议。这两种协议实现各有自己的缓存,造成缓存命中率低、内存浪费。
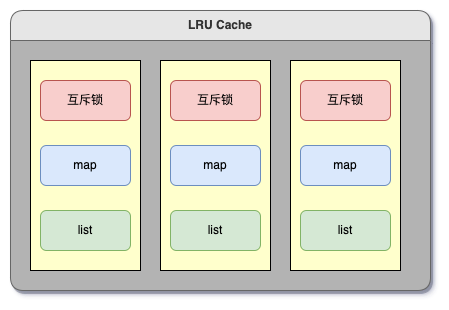
粗排内部多处用到缓存,比较重要的是 item 塔和正排。缓存组件采用的是 lru 置换策略,具体实现如下:
粗排基于fiber实现的并发调度,要处理的新闻很多,内部启动了很多 fiber 任务并行处理,尤其是流量高峰期,fiber 任务队列过长,影响了耗时。
这个简单,http 协议升级为二进制rpc协议,同时添加 snappy 压缩。
平均耗时降低了 60%,可用性有1个9提升到4个9.
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。