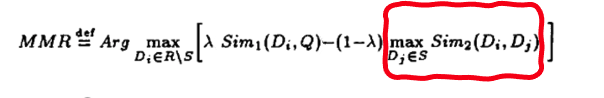惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

WordPress大学
WordPress大学
Last Week in AI
Last Week in AI
U
Unit 42
aimingoo的专栏
aimingoo的专栏
Engineering at Meta
Engineering at Meta
博客园 - 聂微东
小众软件
小众软件
Cyber Security Advisories - MS-ISAC
Recent Announcements
罗磊的独立博客
MongoDB | Blog
MongoDB | Blog
Stack Overflow Blog
Stack Overflow Blog
博客园_首页
M
MIT News - Artificial intelligence
博客园 - 司徒正美
T
The Blog of Author Tim Ferriss
D
DataBreaches.Net
IT之家
IT之家
C
Check Point Blog
酷 壳 – CoolShell
酷 壳 – CoolShell
T
Tailwind CSS Blog
D
Docker
Microsoft Security Blog
Google DeepMind News

博客园 - 咸着的鱼25

环境才是 Agent 的核心基础设施 OpenCode + OpenSpec + Oh-My-OpenCode 联合 SDD/ATDD 开发指南 AI 驱动开发工作流:OpenCode + Oh-My-OpenCode + SDD + ATDD 在线服务数据压缩算法比较 延迟深度链接 搭建wiki系统后端存储-来自大模型 广告投放名词 java spring IoC原理 面试题1 c++ 代码技巧 c++ 性能分析 粗排治理之性能优化 core 基本操作 聊天室开发心得 Docker 学习笔记 Airflow 使用简介 lua转换etcd应答 修改系统参数 https学习笔记 openresty: nginx worker不同请求之间共享数据
MMR 算法优化
咸着的鱼25 · 2023-03-06 · via 博客园 - 咸着的鱼25

一 简介

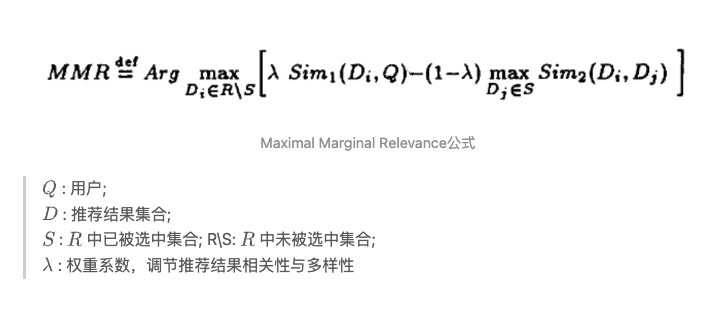
MMR(Maximal Marginal Relevance,最大边际相关性) 算法多用于推荐场景,目标是减少排序结果的冗余。MMR 算法在物品的相关性和相似性之间做了权衡,在保证相关性的基础上,减少相似性,保证了推荐结果的多样性。
MMR 算法公式如下:
二 问题

该算法采用的贪心策略,复杂度是 ,耗时过高,导致无法在线上实时运行。
我在新闻推荐粗排服务中应用了该算法。在我的应用场景中,又加入了用户浏览历史用一些高爆光未点击新闻的过滤,耗时更高。如果不做性能优化,项目无法发布上线。

三 优化手段

通过对算法的分析,采用了如下优化手段:

1. 降低复杂度


新闻相似度计算部分,可以梳理为三个计算部分:

2. 分桶

每条新闻都有自己的分类,例如体育、科技、娱乐等,不同的分类的新闻没有相似度计算的必要。这样根据分类对候选新闻进行分桶,不同的分类之间并行计算,同样可以降低算法的复杂度,降低耗时。

3. 缓存

我的应用场景中,新闻的相似度计算逻辑是这样的:

  • 离线模型计算新闻的 embedding,存储在 redis 中
  • 召回新闻,从 redis 中读取相应的 embedding
  • 新闻相似度就是两个 embedding 的内积得分
    考虑到离线计算的 embedding 变更的概率非常小,具体实现时,在服务内部对相似度进行了缓存,避免每次内积计算。

通过以上的优化手段,最终实现了逻辑发布上线。
参考:https://zhuanlan.zhihu.com/p/102285855