



惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
大猫的无限游戏
大猫的无限游戏
博客园 - 聂微东
Jina AI
Jina AI
The Cloudflare Blog
V
Visual Studio Blog
博客园_首页
量子位
酷 壳 – CoolShell
酷 壳 – CoolShell
博客园 - 【当耐特】
爱范儿
爱范儿
博客园 - 三生石上(FineUI控件)
小众软件
小众软件
博客园 - 司徒正美
阮一峰的网络日志
阮一峰的网络日志
Last Week in AI
Last Week in AI
V
V2EX
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
博客园 - 叶小钗
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
WordPress大学
WordPress大学
宝玉的分享
宝玉的分享
T
Tailwind CSS Blog
博客园 - Franky

博客园 - 四眼蒙面侠

OpenAI 宣布破解纳维—斯托克斯:证明之外,为什么吵翻了? # 基于 Claude Code 的 Moltbook 心跳脚本:让你的 AI Agent 全自动参与社区 Moltbook 要把事情高大: AI 机器人的"身份证"来了 电视黑屏了,还在听吗?聊透 LG 智能电视隐私争议 Chrome 今年第六个零日漏洞:V8 认错了对象,而且真的有人在打 GLM-5.3 开放权重:该买机器把 AI 搬回家吗? 苹果没料到:Mac mini 怎么成了企业 AI 香饽饽 同一个模型,两道安全闸门:克劳德寓言 5.1 真正变了什么 AI 推荐的软件,到底是谁推荐的? GPT-6 Astra:破纪录之后,AGI 真的来了吗? OpenAI 的智能体,在德国老 wiki 上开了一块作弊黑板 一串会清空手机的密码,为什么可能换来五年牢狱? 作业高分,考试却跌两成:AI到底帮你学了什么? GitHub 上的第二张假面:一个大学生如何拦住会骗人的 AI 从十一到九十九,AI 创业公司为什么都爱叫 Labs? 卖十块板子,先交一千欧?欧洲包装新规为何难倒小卖家 玄戒 O3 跑分追上苹果,是真突破还是数字游戏? 当 AI 开始拆你的摄像头:桌面外设的安全边界正在消失 你用 AI 裁我,我就造个 AI CEO? 英伟达为什么想花 130 亿美元买下 Hugging Face? AI 已经会设计分子,为什么新药还没变快? 模型越强,为什么我们反而越不敢放手? DeepSeek Harness:为什么要把智能体的所有部件都做成插件 AI 让代码变便宜以后,工程师真正昂贵的是什么 加密的思考,也会被偷走吗?这篇论文真正发现了什么 它真的“懂”你吗?用一杯咖啡理解大语言模型 买书、扫描、然后销毁:AI 训练的旧书去哪儿了? 七十GB与八十TB:当个人和科技巨头站上不同的法律天平 只读到小学五年级的 AI,能自己悟出高等知识吗? 低价 Token:省下的钱,够不够买回风险?
一群模型,各干各的活:Nemotron 3.5 Lightning 和 Switchyar...
四眼蒙面侠 · 2026-09-03 · via 博客园 - 四眼蒙面侠

未来调车场把不同任务送往不同的专用计算站

TL;DR:NVIDIA 于 2026 年 8 月 11 日发布的 Nemotron 3.5 Lightning 与 NeMo Switchyard,瞄准的是 AI Agent 的模型路由问题:让规划等复杂步骤用强模型,工具调用、格式整理等步骤交给更小更便宜的模型。本文同时核对了评测边界、降本数字的前提,以及仓库仍标注 pre-alpha 的现实——它值得跟踪,但还不是能直接上生产的组件。

一个 AI Agent 真正运行起来以后,并不是每一步都需要最强模型。制定计划、处理复杂异常,可能值得调用能力最强的模型;执行工具、检查返回值、整理格式和重复查询,往往更在意速度和成本。

如果所有步骤都交给同一个昂贵模型,效果容易预测,账单和延迟却会迅速增加。反过来,如果只用便宜模型,复杂任务又可能失败。模型路由想解决的,就是如何在这两种选择之间分工。

视频版(B站)音频版(5 分 53 秒)| Spotify 订阅 | 偏好阅读?文字版就在下方

Agent 不只需要一个模型

传统聊天产品通常把一次请求交给一个固定模型。Agent 的情况不同:它可能先规划,再调用工具,读取结果,修正计划,最后生成答案。一次任务里会出现很多性质不同的步骤。

NVIDIA 把这种架构称为“模型系统”:前沿推理模型负责规划和编排,小而快的模型承担代码检查、工具调用、安全告警监控和账单查询等高频工作。这个思路并不要求小模型取代大模型,而是让每种模型做自己更合适的事。

Nemotron 3.5 Lightning 小在哪里

Nemotron 3.5 Lightning 是一个 300 亿参数的混合专家模型(MoE),但每个 token 只激活约 30 亿参数。可以把它理解成一个拥有多个专家小组的组织:总知识容量仍然较大,每次任务只叫少数专家参与,因此单次计算量接近更小的稠密模型。

NVIDIA 的技术文章称,它针对长期运行 Agent 的高频执行层设计,并使用多 token 预测、推测解码和量化等手段提高吞吐量。官方公布的结果包括:

  • 相比同级模型,输出速度最高可达 4 倍;
  • 在 PinchBench 上达到 86% 准确率,完成 1 万个任务的时间比 Qwen3.6 35B 快 30%,同时保持接近的准确率;
  • 提供 BF16 和 NVFP4 检查点,可用于本地和数据中心部署。

这些都是 NVIDIA 选择的测试条件和对照模型,适合用来理解产品定位,不能直接换算成任何业务的固定收益。真实效果仍取决于任务分布、推理框架、硬件、并发量和输出长度。

Switchyard 不只是一个“选模型”按钮

NeMo Switchyard 是一个用 Rust 编写的代理和路由库。它能在不同模型与供应商之间分配请求,也负责 OpenAI Chat、OpenAI Responses 和 Anthropic Messages 等接口格式之间的转换。

仓库目前提供多种路由方式:
  • 用一个分类模型判断请求应该进入强模型还是弱模型;
  • 根据工具结果、错误等会话信号分阶段路由;
  • 先让弱模型回答,再由评审决定是否升级;
  • 按固定比例随机分流,用于 A/B 测试;
  • 编写自定义算法,把质量、延迟和成本偏好放进自己的规则。

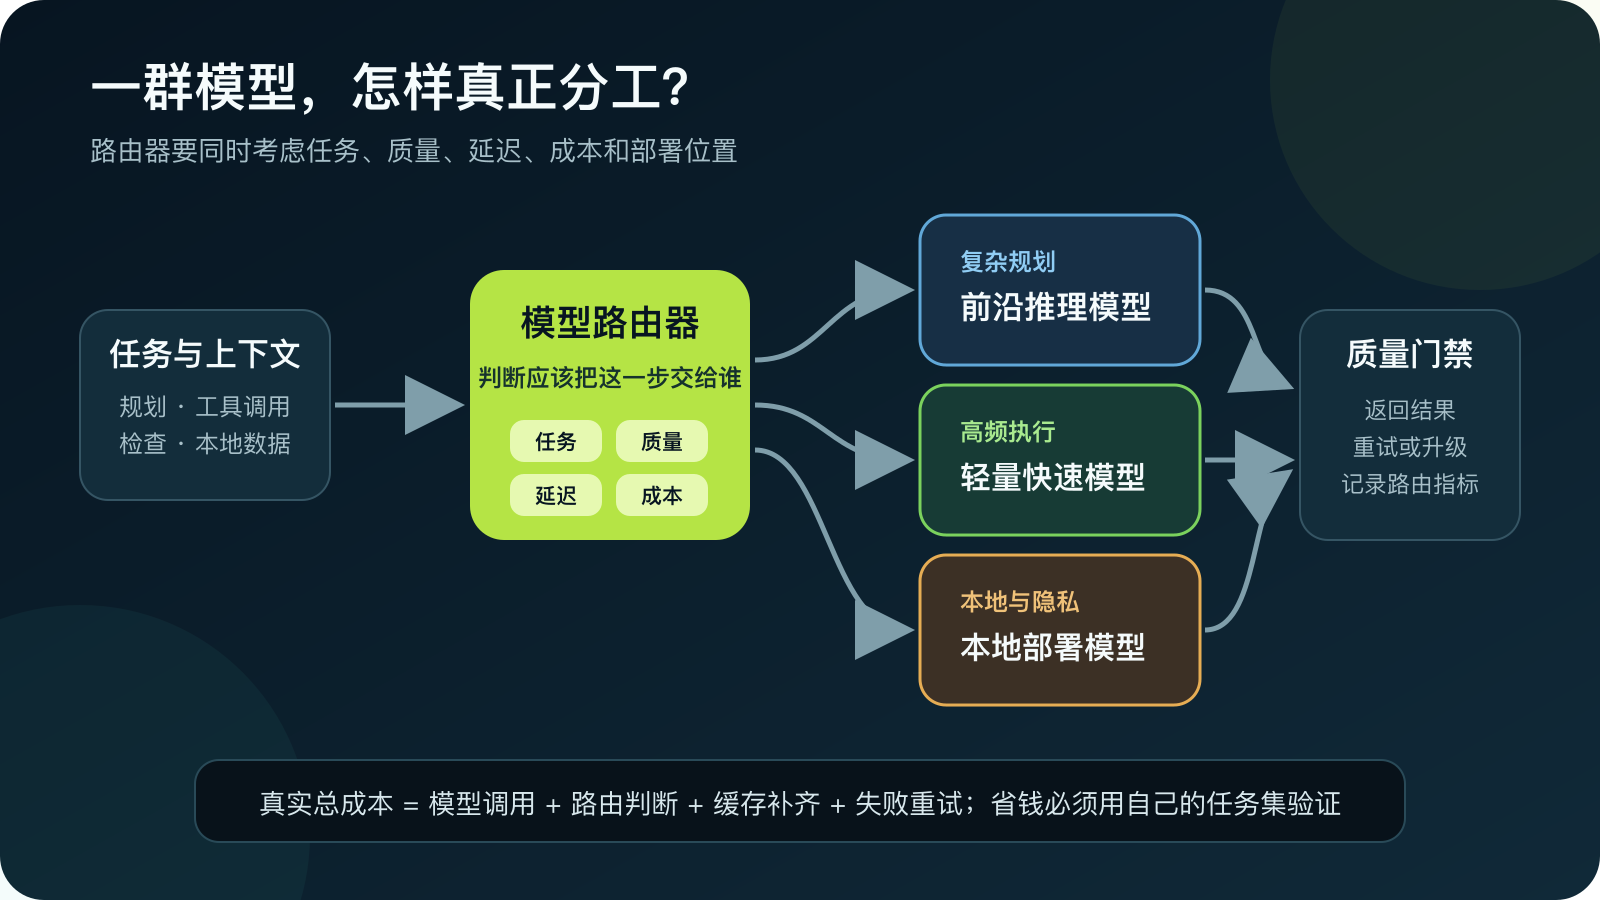
任务经过模型路由器分配给推理模型、快速模型或本地模型,再由质量门禁决定返回或升级

这张图表示一般性的模型路由结构,不代表 Switchyard 会自动识别所有任务,也不表示三类模型一定同时存在。

路由器本身也会消耗资源。真实总成本不仅包括最终模型调用,还包括路由判断、额外分类模型、缓存补齐、失败重试和升级调用。若没有统一的质量门禁,所谓“节省成本”可能只是把错误推迟到后面。

那些漂亮的降本数字该怎么看

NVIDIA 公布的内部基准称,Switchyard 在保持前沿级准确率的同时,可把任务完成成本降到单独使用 Opus 4.8 的近三分之一。合作方数据中还有两组很醒目:

  • LangChain 在 145 个多轮 Deep Agents 任务中,只把 7% 的调用交给前沿模型,成本降低 74%,但准确率下降了 6%;
  • Ramp 报告称,在其 SWE-Bench 场景中,成本降低 58%,运行时间减少 33%,同时匹配前沿模型表现。

这些结果说明模型路由有潜力,但它们来自 NVIDIA 及合作方披露,并不是对所有任务的独立保证。尤其要注意 LangChain 的结果并非“质量完全不变”,而是用 6% 的准确率差异换取明显的成本下降。

评估路由器时,至少要同时看四项指标:正确率、端到端延迟、完整任务成本和失败后的恢复成本。只比较单个 token 价格,往往会漏掉路由判断和重试。

换模型会不会毁掉提示缓存

Hacker News 讨论中,争议最大的问题之一是提示缓存。批评者认为,同一会话不断切换模型,会让已经积累的 KV Cache 失效,抵消便宜模型省下的成本。

社区里也有人给出另一种解释:每个模型可以维护自己的缓存;重新切回某个模型时,只需要为它补上缺失的对话增量,而不是每次从头处理全部上下文。这样做仍然需要额外 prefill,而且缓存不能在结构不同的模型间直接共享,但较便宜模型承担更多生成工作后,整体仍可能节省费用。

这段讨论不能当作 Switchyard 的官方缓存承诺。它更像一个提醒:模型池大小、会话黏性、缓存策略和路由频率必须一起设计。模型选得越多,路由器越复杂,未必越划算。

新闻稿很积极,仓库却写着 pre-alpha

截至 2026 年 8 月 28 日,Switchyard 仓库仍把整个项目标为 pre-alpha,并提醒 API 和算法在 1.0 之前可能大幅变化。各组件的成熟度也不同:libsy 标为 Beta、可试验性集成;客户端和 runner 仍是 Alpha;switchyard-server 是演示服务器,明确不建议用于生产环境。

这与新闻稿中的“部署”“企业使用”并不完全矛盾:合作方可能使用的是内部集成、特定组件或受控试验,并不等于公开仓库中的演示服务器已经具备生产条件。对普通开发团队来说,更合理的起点是离线评测或旁路实验,而不是立刻替换线上网关。

真正动手前,先准备一张自己的路由表

如果要验证模型路由,可以从一个很小的模型池开始:一个擅长复杂规划的模型,一个便宜快速的执行模型,再加明确的升级条件。

建议先完成下面几件事:

  1. 从真实日志中整理任务类型,不要凭想象分类;
  2. 用同一批任务建立单模型基线,包括质量、延迟和总成本;
  3. 为每种路由结果记录选中了谁、为什么选、是否升级以及最终是否成功;
  4. 单独测量长会话下的缓存命中率和补齐成本;
  5. 为路由错误准备回退方案,并把重试也计入成本。

好的路由器不会一味选择最便宜的模型。它应当使用可验证的规则,把昂贵能力留给确实需要它的步骤。

收看本期节目

音频:在线播放或下载 | 播客主页:听懂 AI

原始资料与延伸阅读

本文由《听懂 AI》第 002 期整理而成。节目讨论的主要来源是 NVIDIA 于 2026 年 8 月 11 日发布的 Nemotron 3.5 Lightning 与 NeMo Switchyard 资料,并加入了对项目成熟度、评测边界和 Hacker News 社区争议的核对。

  1. Kari Briski,NVIDIA,2026-08-11:NVIDIA Nemotron 3.5 Lightning and NeMo Switchyard Deliver Faster, Smarter, More Efficient Agentic AI
  2. Chris Alexiuk、Chintan Patel,NVIDIA Technical Blog,2026-08-11:NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task Execution for Long-Running Agents
  3. NVIDIA-NeMo:Switchyard GitHub 仓库——功能、路由策略、许可证与成熟度说明。
  4. Hacker News:Nvidia Nemotron 3.5 Lightning and NeMo Switchyard——社区关于缓存、路由开销和产品成熟度的讨论;评论不代表已经验证的事实。

资料说明:性能和合作方数据主要来自 NVIDIA 官方材料,本文已保留测试主体、对照对象与准确率差异。关于缓存的内容来自社区讨论,只作为工程问题线索,不作为 Switchyard 的官方保证。