








TL;DR:JSTOR 官方记录显示,Aaron Swartz 在 2010 年 9 月至 2011 年 1 月间下载约 480 万篇文献、约占当时数据库 80%;美国司法部 2011 年公告列出的法定最高风险为 35 年监禁和 100 万美元罚款,但这些是起诉指控与最高上限,不是判决。Meta 在 Kadrey 案中于 2025 年 6 月赢得 13 名具名原告训练复制主张的简易判决,但传播与帮助侵权主张仍在继续;Meta 2026 年二季度 10-Q 显示,相关简易判决听证定于 2027 年 2 月 25 日。两案不是同一罪名或同一法律标准,真正可比较的是个人与巨头承受法律程序的能力。
“70GB 对 80TB”很容易形成一张愤怒的海报:个人下载学术文献,面对刑事重罪;科技巨头用 BitTorrent 获取大规模书籍数据训练模型,仍能继续经营和诉讼。数量级差异确实醒目,但如果把两边直接写成同一件事,反而会掩盖法律力量怎样运作。
Swartz 案走的是联邦刑事程序,涉及电信欺诈和《计算机欺诈与滥用法》指控。Meta 面对的主要是版权民事诉讼,争议被拆成训练复制、传播和帮助侵权等不同主张。法律分类不同,不代表权力差距不存在;恰恰因为路径不同,才要分别看清。
视频版(B站) | 音频版(6 分 04 秒)| Spotify 订阅 | 偏好阅读?文字版就在下方
原评论文章用“约 70GB”概括 Swartz 获取的 JSTOR 数据。JSTOR 自己公开的数字是约 480 万篇文献,约占当时数据库的 80%;官方材料没有在同一页面确认 70GB 这个字节体量。
Meta 一侧常见的 80.6TB 和 81.7TB 来自原告方诉讼材料:前者对应 LibGen,后者对应后来通过 Anna's Archive 获取的数据。两批数据可能存在重叠,统计口径也不是 Swartz 案的文献数量口径,不能直接相加成 162.3TB 的唯一书籍内容。
因此,“70GB 与 80TB”适合提醒我们规模相差悬殊,不适合充当两案事实完全相同的证明。真正需要比较的是获取方式、所涉权利、法律程序和主体承受能力。
JSTOR 记录称,下载发生在 2010 年 9 月至 2011 年 1 月。快速自动下载曾影响服务,JSTOR 与 MIT 多次封锁相关地址;JSTOR 最终确认约 480 万篇内容被获取。
2011 年 7 月,美国司法部宣布最初起诉,指控包括电信欺诈、计算机欺诈、非法获取受保护计算机信息和损害受保护计算机。司法部公告称,如果全部罪名成立,最高可能面临 35 年监禁、三年监督释放、赔偿、没收和最高 100 万美元罚款。
这些数字是法定最高风险,不是检方最终求刑,更不是法院判决。DOJ 公告也明确写明,起诉书内容属于指控,被告在依法证明有罪前推定无罪。
2012 年的替代起诉书把指控扩为 13 项重罪。MIT 后来的独立审查报告记录,检方曾提出不同认罪方案,其中若干方案会把实际监禁上限压到三至六个月,但没有方案保证零监禁。
JSTOR 称,Swartz 同意交回下载内容并确认没有传播,双方于 2011 年 6 月达成民事和解。JSTOR 随后告诉联邦检方,它倾向于不要提起刑事指控;起诉后又公开表示,无意让事件继续成为法律纠纷。
刑事起诉权属于政府,不属于 JSTOR。即使被影响的机构不再追究,检方仍可继续案件。MIT 报告也说明,MIT没有要求联邦起诉,而是选择在控辩之间保持中立;报告同时批评这种中立使 MIT 错失了在开放知识与计算机法律问题上发挥领导作用的机会。
Swartz 于 2013 年 1 月 11 日在开庭前自杀去世,案件因此没有通过审判形成最终事实认定。把他的死亡简单归因于单一因素并不严谨;但检方使用重罪指控和最高刑责形成的压力是否过度,仍是合理且必要的公共问题。
《听懂 AI》第 014 期节目封面。节目讨论程序力量差异,不主张两案事实或罪名相同。
Kadrey v. Meta 的 2025 年法院命令记录:Meta 于 2022 年 10 月首次下载 LibGen 数据库;在许可谈判受阻后,Meta 于 2023 年决定把其中作品用于训练 Llama;2024 年初又下载了汇集多个影子图书馆的 Anna's Archive。
法院写明,双方不争议 Meta 使用 BitTorrent 获取了 LibGen 和 Anna's Archive,也不争议 Meta 把下载书籍加入 Llama 训练数据。双方仍争议的是:Meta 在下载过程中是否以及多大程度向 BitTorrent 网络回传数据,回传内容是否包含原告作品,以及这些行为承担什么版权责任。
这一区分很重要。确认“使用 BitTorrent 下载并用于训练”,不等于法院已经确认所有上传、传播或帮助侵权指控成立。
2025 年 6 月 25 日,法院在 13 名具名原告的训练复制主张上支持 Meta 的合理使用抗辩,并给予 Meta 简易判决。
裁决范围很窄。法官明确说明,Meta 获胜不是因为法院宣布“复制版权作品训练模型天然属于合理使用”,而是这些原告没有就关键的市场伤害理论建立足够证据。裁决只约束具名原告在当时案卷记录下的训练复制主张。
同一份命令还把复制与传播分开:即使训练复制在该记录下构成合理使用,BitTorrent 过程中的回传是否侵犯传播权仍是另一问题。法院当时没有对此作出简易判决。
2026 年 3 月 25 日,法院允许原告加入帮助侵权主张。该主张认为,Meta 在下载时上传数据,可能帮助网络中的其他参与者侵犯版权。这仍是原告的法律主张,不是已成立的责任结论。
Meta 在截至 2026 年 6 月 30 日的季度报告中披露,训练复制合理使用裁决只涉及具名原告;与下载过程中向第三方传播书籍有关的直接侵权与帮助侵权主张仍将继续。相关简易判决听证目前排在 2027 年 2 月 25 日。
Meta 同一份 10-Q 还列出多起围绕 AI 训练材料获取、传播和使用的其他案件。因此,说 Meta 已经被判定“下载这些书完全合法”不准确;说它“毫无法律后果”同样过早。
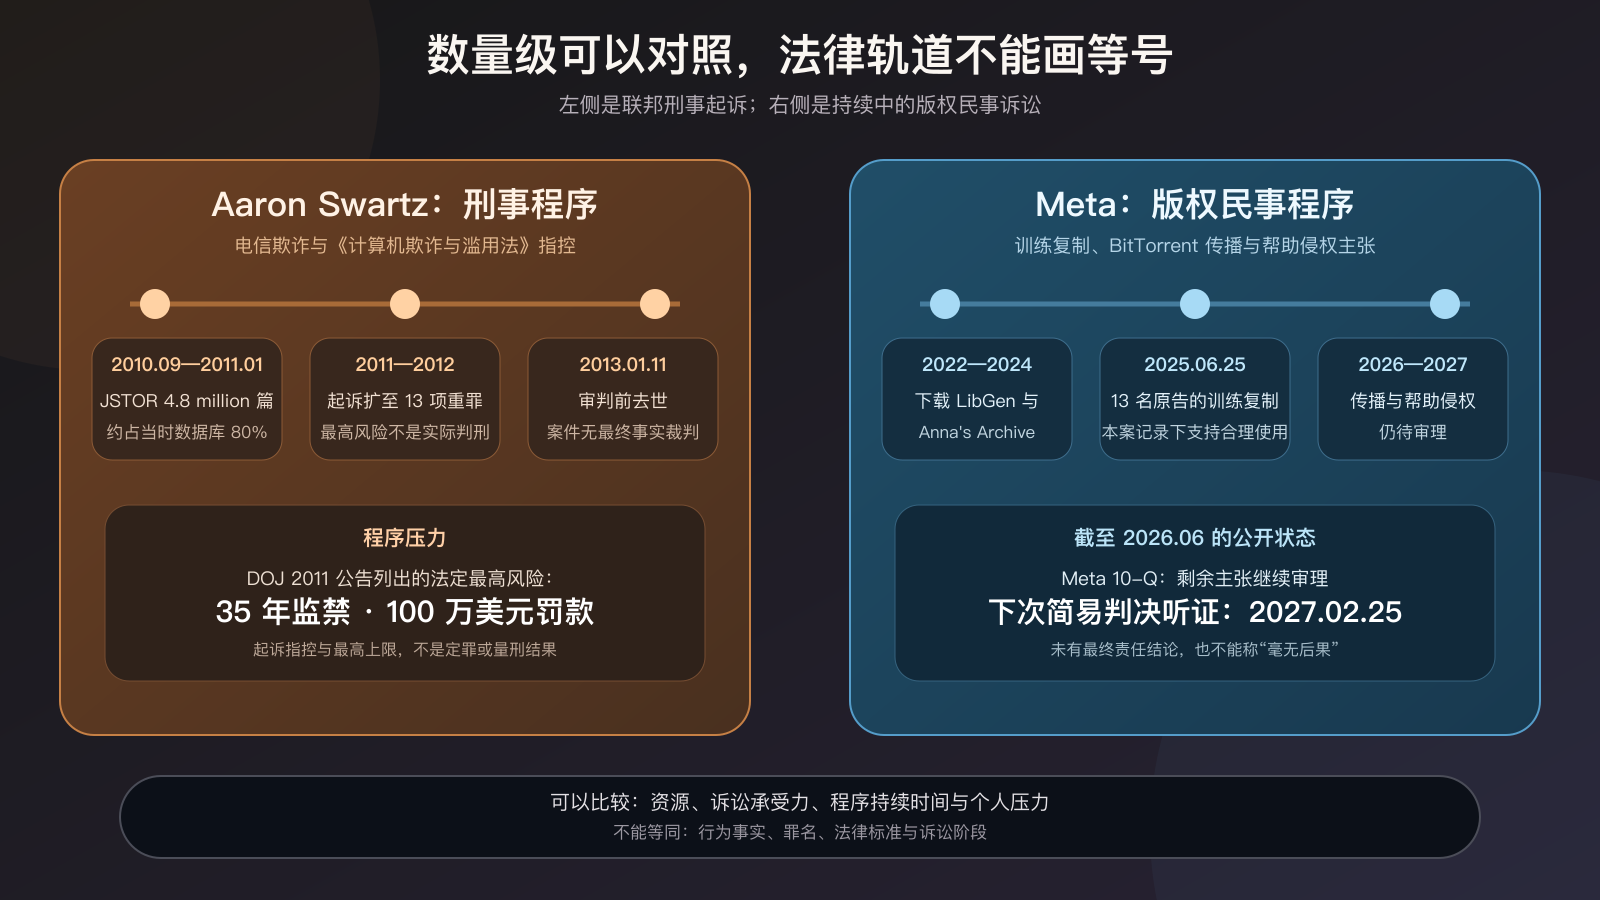
时间线依据 DOJ、JSTOR、MIT、Kadrey 案法院命令及 Meta 2026 年二季度 10-Q。
不能直接比较的是罪名。Swartz 案的核心是未经授权访问、绕过技术限制和计算机欺诈等刑事指控;Meta 案的核心是版权复制与传播的民事责任。刑事法、版权法、举证标准和救济方式都不同。
可以比较的是程序落在不同主体身上的重量。个人面对联邦检方时,要同时承受刑事定罪风险、生活中断、诉讼费用和认罪压力。大型公司可以让专业团队把争议拆成多个主张,经历发现程序、简易判决、类别认证与上诉,并把成本分摊到多年经营中。
这不是说公司不承担风险。版权法按作品计算法定赔偿,大规模数据可能带来重大责任,Meta 也在监管文件中把相关案件列为风险。差异在于,同样漫长的程序对个人生活和公司资产负债表不是同一种压力。
原评论把这种差异写成对社会的控诉,情绪来源可以理解,但其中“法律系统谋杀”“Meta 只会被轻罚”等表述属于作者观点和预测,不能当作已裁判事实。
更有用的追问包括:
记住 Aaron Swartz,不需要把两个案件说成完全相同。把事实和法律路径说准,反而更能看见那架天平真正不均衡的地方。
本文由《听懂 AI》第 014 期整理而成。主要评论原文表达了对两案差异的愤怒,其中对 Swartz 死亡原因和 Meta 最终后果的描述属于作者观点;本文补充 DOJ、JSTOR、MIT、法院命令和 Meta 监管披露,更新到 2026 年 9 月 3 日。诉讼仍在进行,文中不对任何待决主张给出法律结论。
资料说明:本文为技术与公共政策评论,不构成法律意见。案件日程和主张可能继续变化,引用时应核对最新法院记录。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。