








本文永久链接 – https://tonybai.com/2026/07/25/ai-code-migration-claude-code-six-steps
大家好,我是Tony Bai。
导读:代码语言迁移,曾经是工程团队避之不及的“三年之痒”项目——耗资数百万美元、耗时数年、还可能烂尾。但Anthropic最近披露,公司内部工程师用Claude Code在一个月内完成了10个代码包的迁移,其中包括Bun联合创始人Jarred Sumner把百万行Zig代码迁移到Rust,只用了不到两周;Labs联合负责人Mike Krieger把一套Python代码库迁移成16.5万行TypeScript,只花了一个周末。这背后到底是什么样的方法论?答案出人意料:真正的关键不是让AI“改代码”,而是让AI“改生产代码的流程”。
文章要点:
一个周末,16.5万行代码。
这不是某个创业公司连夜赶工的产物,而是Anthropic Labs联合负责人Mike Krieger,把一套Python代码库完整迁移成TypeScript所花的时间。整个过程动用了数百个智能体、8个阶段关卡、3轮对抗式审查,最后还有一轮把每一条命令的输出结果都和Python原版逐一比对的“一致性核查”。
几乎同一时间,Bun联合创始人、现Anthropic技术成员Jarred Sumner,用Claude Code把Bun这个拥有百万行代码的项目从Zig迁移到了Rust。整个过程不到两周,合并前Bun原有测试套件100%通过CI。合并之后陆续发现了19个回归问题,也已经全部修复。
在过去,这种规模的语言迁移是工程团队想都不敢想的“多年工程”,动辄需要三到四百万美元的人力投入,跨越数年时间。而现在,Anthropic的工程师在一个月内,靠Claude Fable 5、Claude Opus 4.8和动态工作流(dynamic workflows),一口气迁移了10个代码包,规模从数万行到数十万行不等。
Anthropic把这套方法论写成了一篇详细的复盘文章。今天新智元就来拆解一下,这套“六步迁移法”到底是怎么把不可能变成可能的。
先说清楚“为什么”和“什么时候”,而不是急着讲“怎么做”。因为这类项目的成本账本,已经彻底变了。
团队启动语言迁移,通常是因为最初的技术选型和现在的项目需求之间出现了错位:要么当初的权衡取舍如今变成了掣肘,要么出现了更好的方案,要么原有的技术生态正在萎缩。
Jarred当初选择Zig,是因为它兼具C语言级别的性能和极致的简洁性——这对于一个人在奥克兰的小公寓里、在LLM出现之前独自写Bun的创始人来说,是最合适的选择。但这份简洁性也带来了众所周知的代价。
时间快进到2026年,Bun的CLI月下载量已经超过1000万次,并且在Claude Code内部被大量使用。放在一个季度以前,这些代价还不足以让团队冻结路线图、投入巨大资源去做一次跨季度的大迁移。语言迁移固然能带来更小、更快、更安全的系统,但没人愿意为此买单。
工程师们过去还要承担这类超级项目本身自带的职业风险:维护两套并行代码库长达数个季度甚至数年,如果最终结果只有90%的行为一致,那你的麻烦只会比开始时更大。
而现在,最坏的结果不过是删掉分支,重新再来一次。
当然,商业上的理由依然要站得住脚。虽然百万行级别的迁移不再需要三四百万美元、耗时四年的投入,但依然需要数万到数十万美元不等的成本。以Bun的迁移为例,整个项目消耗了59亿个未缓存输入token和6.9亿个输出token,按API定价计算大约花费16.5万美元。Mike的迁移主体部分则消耗了2700万token。
但迁移的理由不再需要是“生死攸关”的。 一年里changelog上反复出现的内存bug、一个长期存在的性能瓶颈,如今就足以构成迁移的理由。
Mike这次项目的导火索,正是一个编译环节。他团队维护的内部工具以单一二进制文件的形式分发给用户,用Python工具链构建这个二进制文件,每个平台大约要8分钟,整个构建矩阵每次发布加起来要等30分钟。迁移之后,同样的编译过程只需要大约2秒,二进制启动速度提升了6倍,团队甚至因此得以下线一整条独立的部署流水线。
Claude Fable 5是Anthropic目前能力最强、已经公开可用的模型。Fable和Opus 4.8尤其擅长的,是在多条并行任务线之间分派、指挥、验证子智能体的工作,并且能找到多条通往目标的路径。
大规模代码迁移之所以特别适合交给这类高阶模型来做,原因有五点:
后文会看到,Mike和Jarred都在关键步骤里用到了Fable,尤其是一种“顾问模式”——用不同档位的模型组合,来优化token消耗。
这是整篇文章最重要的一句话:
你不是在修代码,你是在修产出代码的那个循环(loop)。
也就是说,AI代码迁移的本质,不是让模型逐文件地“翻译”代码,而是工程师去写迁移规则和验证循环,然后让智能体在这套循环里不断翻译、编译、测试,直到新代码的行为和原代码完全对齐——把原本要跨越数年的项目,压缩进几周之内。
在动手迁移之前,必须先有一套能公平评判“原始代码”和“目标代码”的裁判系统,否则你既没有退出条件,也没有成功的衡量标准。
用原语言写的测试套件,往往依赖只存在于原语言里的内部函数,这些函数在目标语言里根本不存在。所以要先做三件事:
Jarred手里有一套用第三种语言(TypeScript)写的大型测试套件,但大多数项目不会有这种条件。Mike则是为他的Python到TypeScript迁移,专门造了一套包含7个真实场景的一致性核查工具,任何行为上的变化都被当作bug来修复。
整个流程分为六步,其中Jarred的方法论更接近“结构保留式”迁移(每个阶段都有审查和关卡),Mike则是把整个迁移端到端跑一遍、根据结果修改规则和工作流、再跑一遍——每次都推倒重来,直到第三次才保留结果。
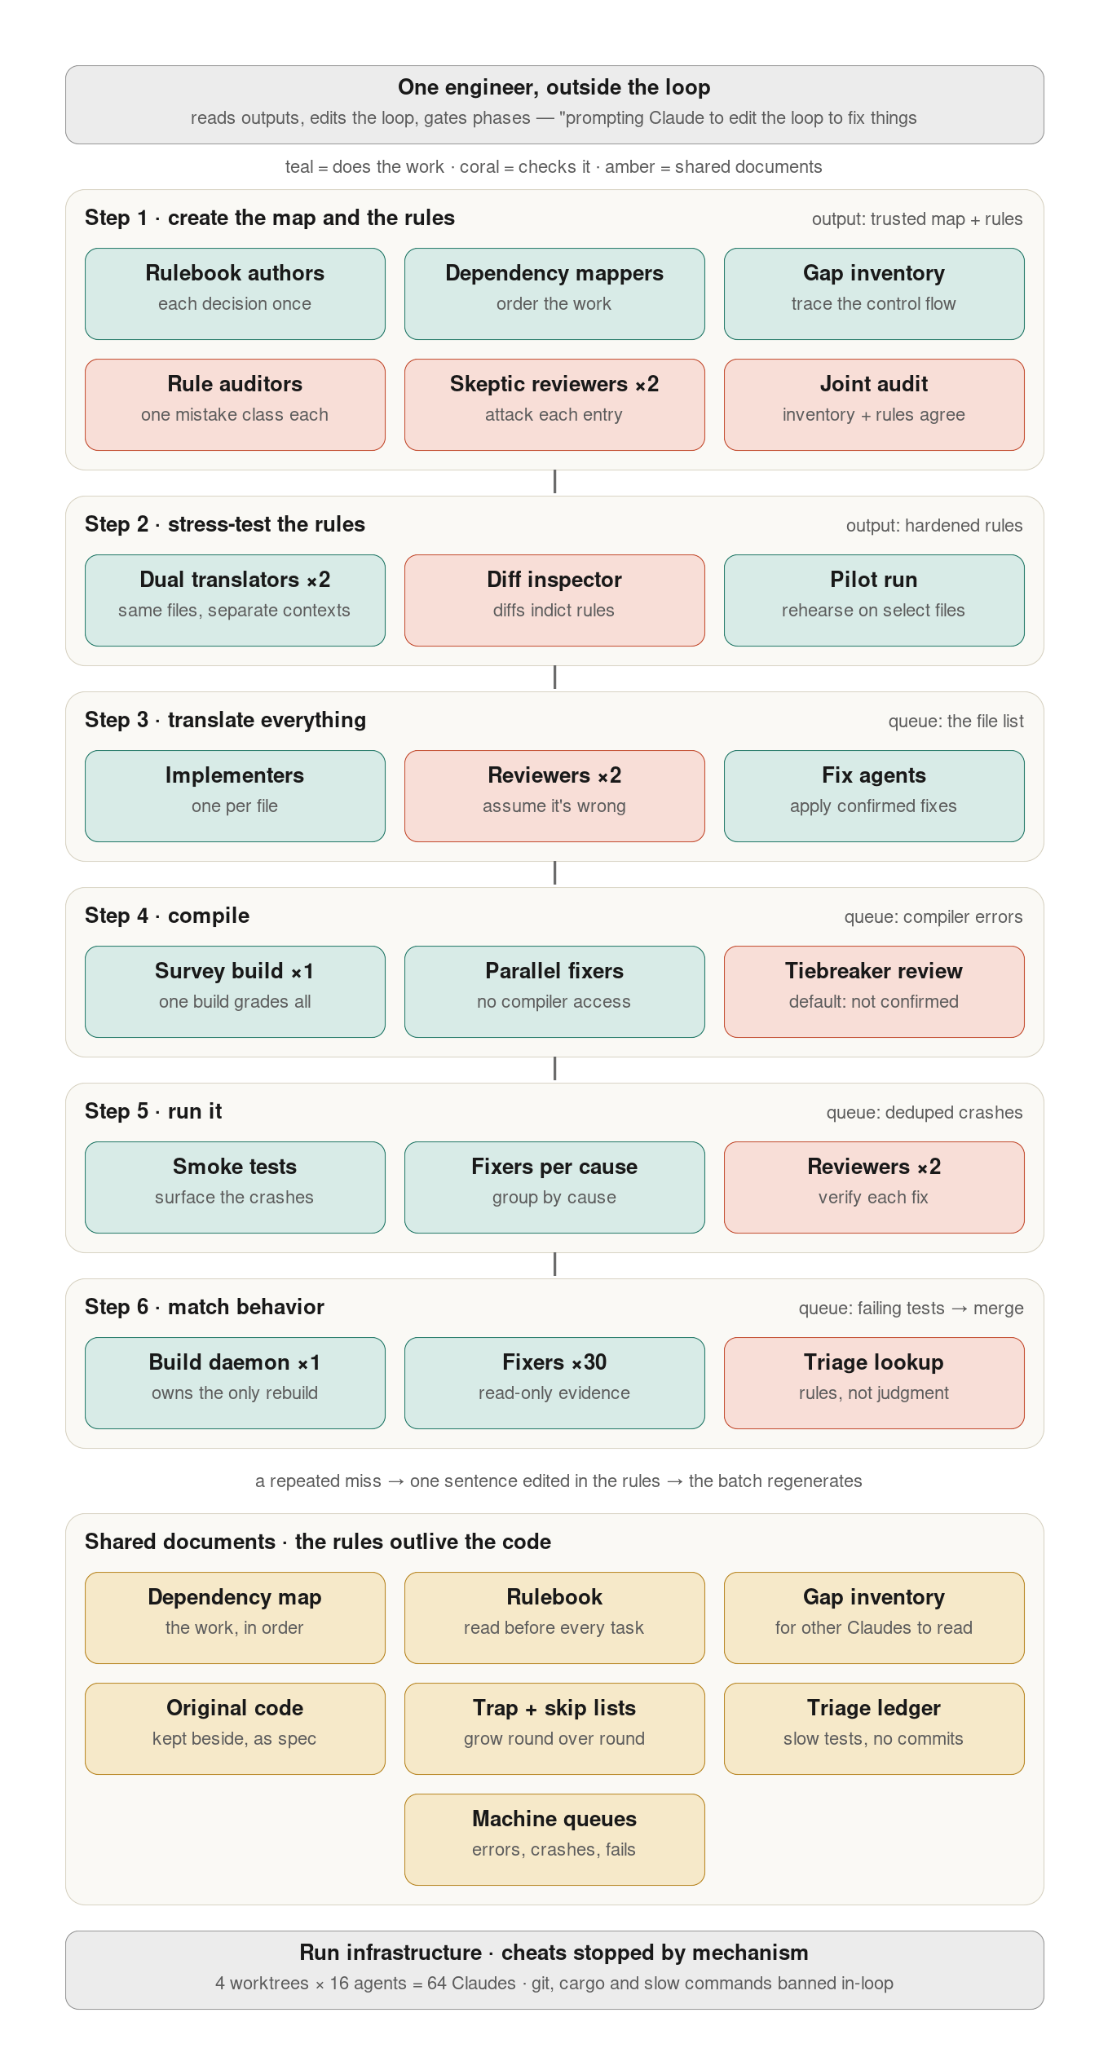
这一步是在打地基:找出哪些代码需要重构而不只是翻译,制定一套翻译规则手册,再画出依赖地图,用来确定并行迁移的先后顺序。
顺序很重要:规则手册要先于差距清单。
差距清单本质上是“规则手册默认规则覆盖不到的部分”,两者要放在一起联合审计。
规则手册的具体形态,取决于一个关键的架构决策:新代码是保留原有结构,还是彻底重新设计?
如果是前者(如Jarred的做法),规则手册主要就是在不同语言之间做类型和习惯用法的对照表,遇到难翻译的部分就指向差距清单。如果是后者(如Mike的做法),规则手册就变成了一份设计文档。
Jarred的做法是直接和Claude对话,为每一处存在歧义的地方形成一条明确的策略,同时用8个子智能体,专门针对他凭经验总结出的8类常见失败模式做审查。
依赖地图方面,你需要理解文件之间的依赖关系,才能合理拆分并行迁移的工作流,知道哪些文件要先迁移、哪些文件要归入同一批次。有些语言和代码库有明确的依赖清单,但对于遗留代码库以及C/C++、Python这类常见语言来说,这些依赖关系往往需要靠工具去发现和梳理。Claude Code可以部署智能体,编写并运行一个确定性脚本来生成这份依赖地图。
差距清单和“怀疑论”审查者方面,新语言相比旧语言总会有一些新的硬性要求。比如从Zig到Rust,最大的差异就是手动内存管理(这一点C和C++也是同样的问题):
Zig:
fn readConfig(allocator: std.mem.Allocator) ![]u8 {
    const buf = try allocator.alloc(u8, 1024);
    // ...fill buf...
    return buf; // caller must free this — but only the comment says so
}

// 调用者忘了 'defer allocator.free(buf)' 依然能编译通过——内存泄漏只会在运行时暴露
Rust:
fn read_config() -> Vec<u8> {
    let buf = vec![0u8; 1024];
    // ...fill buf...
    buf // 所有权转移给调用者,内存自动释放
}
// 用完之后还想用?重复释放?两种情况都编译不过
// 忘记释放?根本没有free调用需要你去忘记,drop是自动的
而从Python到TypeScript,差距则体现在接口和契约上。Python不要求声明一个对象接受什么形状的数据、返回什么类型,但TypeScript要求:
Python:
def register(handler):
    handler.setup()
    return handler.run({“retries”: 3})

# 任何有 .setup() 和 .run() 方法的对象都能传进来。到底哪些对象会被传进来?得读完整个代码库才知道
TypeScript:
interface RunResult { ok: boolean }

interface Handler {
    setup(): void;
    run(opts: { retries: number }): Promise<RunResult>;
}

function register(handler: Handler): Promise<RunResult> {
    handler.setup();
    return handler.run({ retries: 3 });
}

// 契约必须先写清楚,代码才能编译通过
Jarred和Mike都建了差距清单文件,把这些隐性知识记录下来。区别在于,Jarred是提前把这些差距梳理清楚,Mike则是先翻译、再通过事后审计的方式生成差距清单——实际项目中,你可能两种方式都需要用到。
这一步相当于给正式迁移做一次“下水前的试航”,是一次小规模的迷你迁移。
Jarred的做法是:一个智能体按照规则手册翻译3个文件,另一个智能体“像一名资深Rust工程师”那样翻译同样的3个文件,第三个智能体负责对比两者的差异,生成新的翻译规则。就是在这一步,他发现了两个关键问题——如果不提前发现,这两个问题一旦扩散到全部1448个文件,后果不堪设想。
需要注意的是,这种压力测试只适用于“保留结构”的迁移,也就是同一份文件的两种翻译版本可以逐行对比的情况。如果你的规则手册本质上是一次重新设计(就像Mike那样),等效的做法是直接用对抗式审查者攻击设计文档本身,再用一次可丢弃的端到端试跑来验证。
无论哪种方式,这一步翻译出来的文件都要全部扔掉——目的是打磨规则,而不是取得实质性进展。
从这一步开始,后续几个阶段都会重复同一套多智能体循环架构:实现、审查、修复。
实现类的工作可以交给较小的模型,审查类的工作留给更大的模型。比如Mike在主体迁移阶段,用Claude Sonnet铺开了12个子智能体。
任务队列的运转应该是机械化的:批处理脚本通过检查磁盘上翻译文件是否存在来判断任务是否完成,然后把待处理的文件切分成批次分配给负责实现的智能体。由于队列每次都是从磁盘状态重新构建的,整个迁移天生就是可断点续跑的。
在这个阶段,智能体有时会过于谨慎,不敢下手改动太多。解决办法很直接:用一句直白、强硬的提示词告诉它,编译器会在下一步帮你兜底纠错。
任何翻译智能体没有把握执行的地方,都会被标记为 // TODO(port): <原因>,留到第四步处理。从这里开始,待办清单基本可以自动生成:编译器会列出错误,冒烟测试会揪出崩溃,测试套件会报告失败项。
两个对抗式审查者会在各自独立的上下文中评估实现智能体的工作成果,一旦两者意见不一致,就交给第三个智能体裁决。当某个审查者反复在不同文件里抓到同一类错误时,解决办法不是逐文件修补,而是在规则手册里加上一句话,重新生成受影响的那批文件。规则手册在这一步会持续扩充,代码本身永远不会被拿去“手动打补丁”对抗规则。
关于这一步有个值得注意的设计决策,是编译器放在流程的哪个位置。Mike选择在每一轮循环里都跑一次TypeScript编译器,因为它几秒钟就能检查完一个单元;Jarred则完全把编译器排除在这一轮循环之外,留到下一步,因为cargo编译要花几分钟。
到这一步,大部分繁重的工作已经完成,提示词也开始变短。
这三步共享同一套循环架构,需要的人工判断也逐步减少,所以放在一起讲。第四步在某些语言和规模的迁移里,甚至会直接融入第三步。
具体要不要跑这一步,取决于编译环节的规模和难度。Jarred的做法是用一个编排脚本,对整个工作区一次性调用编译器,“修复智能体”再并行处理错误列表并进行对抗式审查,然后重新构建,如此循环。
审查错误列表本身也很有价值,可以发现需要系统性调整的问题。比如Jarred遇到过成千上万个Rust模块错误,这些错误是在修复Zig原本靠“惰性编译”容忍的循环导入问题后才暴露出来的。他的解决办法是编写一套分类逻辑,用来判断某个依赖关系应该删除、移动,还是重新划定边界。
第五步同样有一个机械化的判断依据,类似编译器错误列表——冒烟测试中出现的崩溃。这里的循环修复方式也是把问题按根因分类,再交给对抗式子智能体审查。
第六步,也是整个故事的收尾,是对比两套代码库的行为表现。
此时文件已经完成翻译、编译和冒烟测试,接下来要把它们分片,用第一步准备好的测试套件跑一遍。用“修复智能体”处理失败的测试,对照两套代码库找问题,对抗式审查者再检查这些修复是否合理。
这个循环的下一个环节是一个构建守护进程(build daemon),它是唯一被允许重新构建二进制文件的进程。修复智能体只负责写补丁,守护进程负责批量处理这些补丁、统一重新构建、重跑受影响的测试,再把结果反馈回去。这样做的目的,是把最昂贵的操作串行化,避免多个智能体各自触发重复构建。
当同一个失败反复出现在很多测试里时,修复方式会上移一层:直接修改产生这个bug的规则,只重新生成这条规则影响到的文件。
Mike的做法在这里特别值得参考,因为大多数开发者手里并没有现成的、已经迁移好的测试套件。Mike让Claude写了一个小脚本,用7个真实场景分别跑一遍新迁移的版本和原始Python代码库,再比对结果差异。每个失败的场景都配一个专属的修复智能体,循环运行直到7个场景全部通过。
然后他又往前多走了一步:让Claude自己设计一套端到端测试套件,连续四个晚上自主运行、自动修复出现的问题。正是这一步,抓到了任何场景清单都不可能预先想到的各种细枝末节的问题。
这里的启示是:没有现成测试套件,不该成为这一步的绊脚石。 如果你继承不了一个现成的裁判,那就让Claude自己造一个。不管怎样,你的原始代码库始终是那个“绝对真理”。
每一次迁移都会教会团队一些上一次没学到的东西,你的下一次迁移大概率也会教你这份指南里没写的东西。但以下几条原则,在每一个项目里都成立:
Jarred的Bun迁移项目现在已经在生产环境跑着,当然任何迁移都会有取舍——比如大约4%的Rust代码位于“unsafe”代码块内,主要是C/C++边界上的单行指针操作。
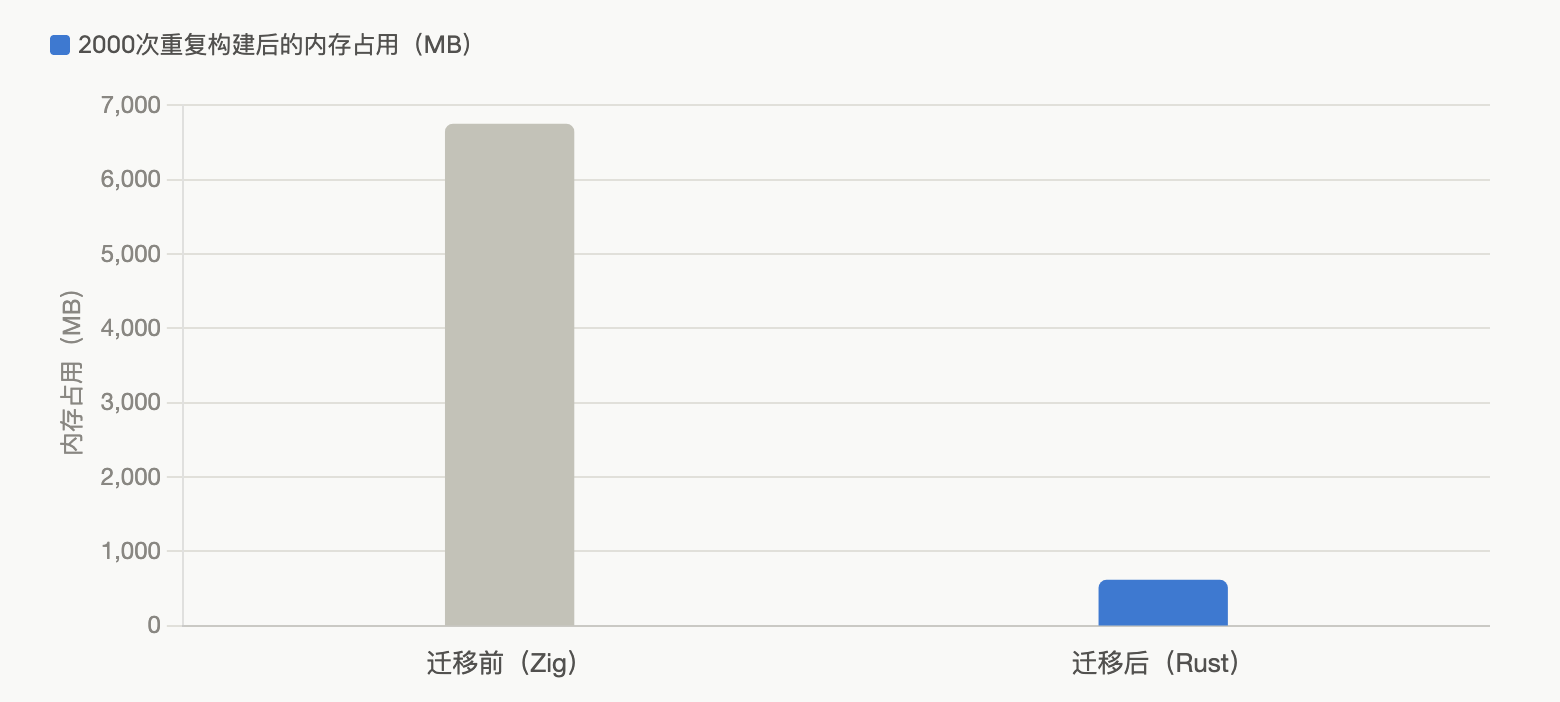
但新代码库在各项指标上都有可衡量的提升:团队工具能检测到的每一个内存泄漏都已修复,一项针对2000次重复构建的基准测试显示,内存占用从6745MB降到了609MB。二进制文件在Linux和Windows上体积缩小了19%。跨语言优化还带来了2%到5%的性能提升,覆盖HTTP服务和next build、tsc这类真实工作负载。
Anthropic给出的建议很直接:重新算一算你那个被长期搁置的迁移项目的账。 挑一个你已经忍了很久的代码库,问问Claude,这个项目的迁移流程会是什么样的。
延伸阅读:
github.com/anthropics/code-migration-kit-with-claude-code(该工具包是本文流程的通用化模板,并非Bun或Mike项目实际使用的原始代码)本文编译整理自Anthropic官方博客文章《How Anthropic runs large-scale code migrations with Claude Code》,原文发布于2026年7月16日。
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。