1. 定义
通过从交互中学习来实现目标的计算方法:
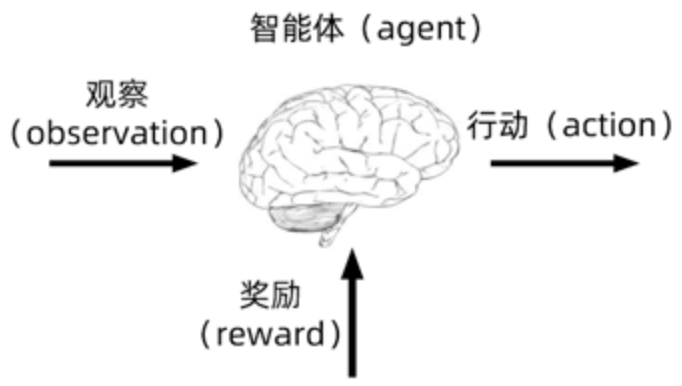
强化学习主要包括三个方面:
- 感知:在某种程度上感知环境的状态
- 行动:可以采取行动来影响状态或者达到目标
- 目标:随着时间的推移最大化累积奖励
2. 交互
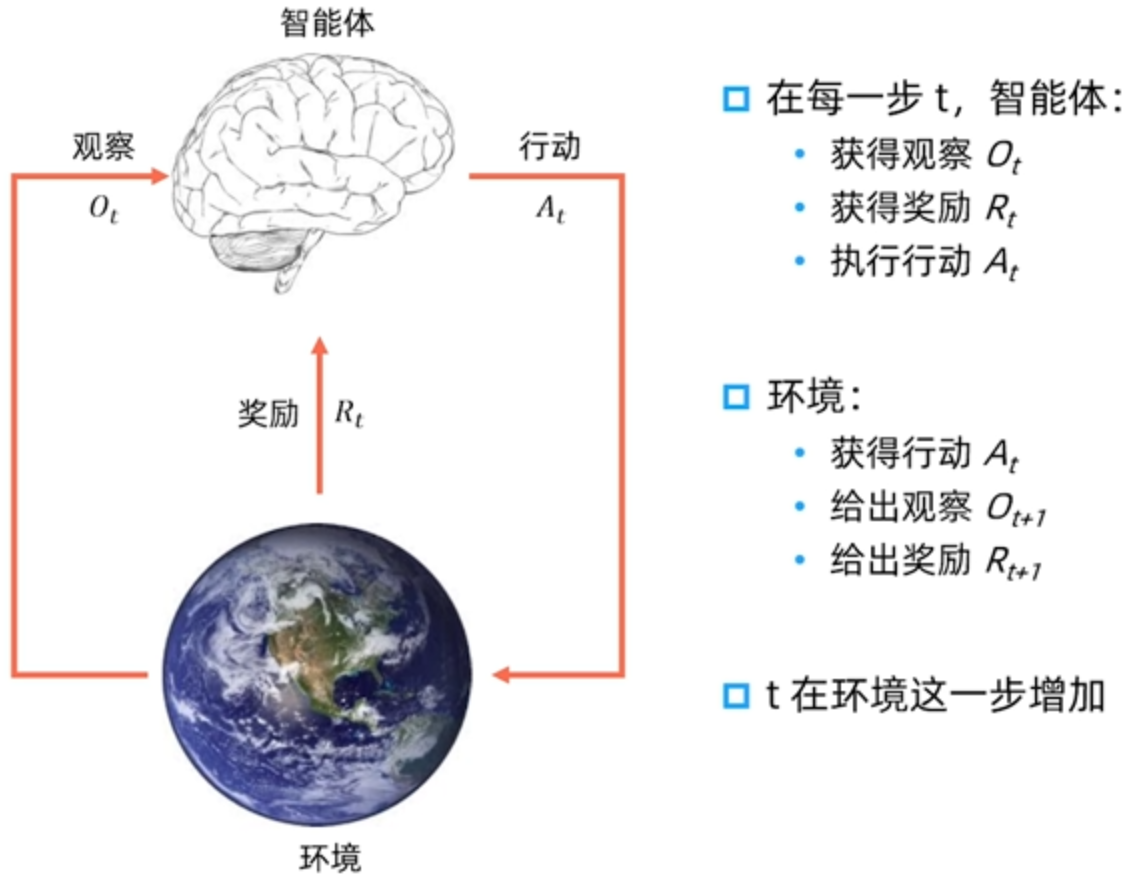
强化学习与环境交互过程如下图:
3. 系统要素
-
历史(History):是观察、行动和奖励的序列。即一直到时间 tt 为止的所有可观测变量:
Ht=O1,R1,A1,O2,R2,A2,⋯ ,Ot−1,Rt−1,At−1,Ot,RtH_t = O_1,R_1,A_1,O_2,R_2,A_2,\cdots,O_{t-1},R_{t-1},A_{t-1},O_t,R_t
-
状态(State):一种用于确定接下来会发生的事情的信息。状态是关于历史的函数:
St=f(Ht)S_t = f(H_t)
-
策略(Policy):是学习智能体在特定时间的行为方式,是从状态到行动的映射。
-
确实性策略:
a=π(s)a = \pi(s)
-
随机策略:
π(a∣s)=P(At=a∣St=s)\pi(a | s) = P(A_t = a | S_t = s)
-
-
奖励(Reward):定义强化学习目标的标量,能立即感知到什么是「好」的。
-
价值函数(Value Function):状态价值是一个标量,用于定义对于长期来说,什么是「好」的。价值函数是对于未来累积奖励的预测:
vπ(s)=Eπ[Rt+1+γRt+2+γ2Rt+3+⋯∣St=s]v_{\pi}(s) = \mathbb{E}_{\pi} \left[ R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots | S_t = s \right]
-
环境模型(Model):用于模拟环境的行为。
-
预测下一个状态:
Pss′a=P[St+1=s′∣St=s,At=a]\mathcal{P}_{ss^{'}}^a = \mathbb{P}[S_{t+1} = s^{'} | S_t = s, A_t = a]
-
预测下一个奖励:
Rsa=E[Rt+1∣St=s,At=a]\mathcal{R}_{s}^a = \mathbb{E}[R_{t+1} | S_t = s, A_t = a]
-