







前言
强化学习从deepseek-R1诞生之后已经就是LLM后训练必不可少的一个环节了,笔者是一个只有LLM基础的人,在这大半年里也是尝试过各种方式学习LLM后训练中的强化学习:试过直接啃PPO、GRPO,会感觉莫名其妙,首先是对强化学习和深度学习的训练方式差异的不适应,还有就是觉得PPO中各种模型出现的莫名其妙actor model value model都只能靠直觉来理解这些模型的作用(其实最好是建立了数学基础再靠直觉)。也试过从强化学习最基础的数学原理开始学,大部分教程一上来就抛出各种数学公式,什么贝尔曼公式,马尔科夫决策、整的笔者很懵逼,而且我的需求是学懂LLM后训练中的强化学习,有一些传统的强化学习方法实际上是不要学的。总之我始终很难串起一个很顺畅的逻辑从基础的强化学习丝滑的过渡到LLM后训练中的强化学习。但是!最近读了知乎很多优质的博客,还有李宏毅老师的课程,脑子中逐渐清晰,在此整理下来。
强化学习基础概念
这章我会介绍强化学习的训练方式和一些基本术语,并且将这些术语对应到LLM后训练中
强化学习的训练流程
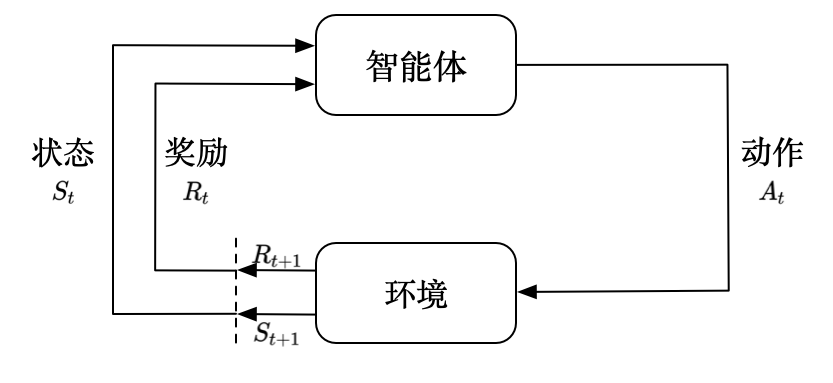
在深度学习学习中,我们会提前标注好数据,一般都是输入输出对儿,然后输入进模型,前向传播,模型输出一个,计算和的损失,用这个损失来对模型的参数求梯度,然后反向传播更新。而强化学习是不需要标注数据的,强化学习中讨论的问题是模型怎么在复杂、不确定的环境中最大化它能表现的更好,这个环境是时时刻刻在变化的,所以强化学习的方式是:每个时间步,模型都会执行一个动作(就是深度学习中的输入模型前向传播输出),然后这个和环境进行交互,环境会因此而改变,并且会通过奖励函数得到一个回报(reward),根据这个reward,我们用来更新模型。 所以强化学习中,用来监督模型的是reward,这个reward就是人为规定的了。而怎么更新模型,也是有各种各样的算法。
强化学习一些基本术语
下边介绍一些强化学习中的术语
State:,当前时间步环境的状态,对应到LLM中就是prompt + 已生成 token。 Action: 当前时间步模型采取的动作,对应到LLM中就是当前时间步模型打算生成的下一个token Reward 表示模型在时间步 处于状态 时,执行动作 后,奖励函数返回的即时奖励,用来衡量这一步行为的好坏。对应到 LLM 中具体如何构造 Reward,我们后面再展开。这里暂时只需要知道:LLM 每生成一个 token,都可以视为一个时间步,并为这个时间步定义相应的 Reward。这里也要注意和PPO中的Reward model要区分开来 Trajectory :一整段交互过程。在强化学习中有的算法是每个时间步都会对模型进行更新,而有的算法是生成了一个轨迹之后再对模型进行更新,我们学习的PPO就是后者。对应到LLM中就是模型生成的一整个response(因为LLM中环境和动作都是词,环境是已生成的seq,动作是下一词) Policy:策略描述模型在给定状态下如何选择动作。随机策略通常表示为 ,即在状态 下选择动作 的概率。简单任务中可以用表格直接存储策略,复杂任务中通常使用神经网络参数化为 。对于 LLM,当前上下文就是状态,下一个 token 就是动作,而模型输出的 next-token 概率分布就是它的策略。
ok,目前先了解以上即可,我们接下来直接看策略梯度算法
策略梯度算法
上边我们说到:强化学习有3个组成部分:模型、环境和奖励函数,这里我们把要优化的模型叫做:演员(actor)。actor不断执行动作,这个动作会改变环境,并且通过奖励函数生成reward,每个时间步都会产生reward。我们把环境输出的与演员输出的动作全部组合起来,就是一个轨迹:
给定演员的参数,我们可以计算某个轨迹发生的概率为
这里就是上边说到的policy,是actor模型的policy:,这里用来表示一个原因是好理解,就是概率的意思,不用在脑子中做一步这个符号到底代表什么的转化
代表当前状态下,执行动作的概率,这个概率是由actor模型决定的,所以带有下标,表示actor模型的内部参数。而的意思就是,处于的状态下,执行动作,状态会变成的概率,强化学习中叫做状态转移。
我们得到了:的表达式,代表这个轨迹的概率。在这个轨迹中,状态执行动作,都会得到一个reward,记作,而把这些reward加在一起,就得到了,这个轨迹的总回报:
但是轨迹有很多条,是随机性的,我们希望最终这些轨迹的平均总回报最大,也就是希望这些轨迹的期望最大。
我们希望优化actor模型的,使得最大。这就很熟悉了,这不就是我们深度学习中的梯度下降吗。只是这里想要他最大化,那就是给他加个负号然后做梯度下降就可以,这个算法在强化学习中叫做策略梯度上升。
不管是梯度下降还是上升,我们第一步就是求梯度。第一步都需要计算目标函数关于参数的梯度。因此,我们需要计算 关于 的导数,而这又涉及 关于 的导数。
但是根据式(2)来看,是一个连乘的式,连乘求导的话就太难求了,所以我们自然而然的想给他转成连加,连乘转连加?这时候需要登场了。
根据对数求导公式:
然后两边乘上 :
根据式(4)和式(5)(6),对的导数为:
对式(2)对两边取对数,将连乘转化为连加:
然后对参数 求导:
其中,初始状态 以及环境的状态转移概率
都由环境决定,与策略参数 无关,因此它们对 的导数均为 0:
因此式 (9) 可以化简为:
将代入式 (6),得到:
再将代回式(7),得到
这里观察一下,不就是对所有轨迹求期望吗!
即:
这个式子表示对求期望
得到最终的梯度:
可以看到这里推出的一个梯度是一个期望,实际上期望是无法直接计算的,在实际训练中,所以我们采样N个轨迹,然后计算每一个轨迹的梯度的值,然后将每个值加起来,就可以得到梯度,这里就是用N个轨迹近似代表期望的思想。
得到:
到这里我们求出了梯度,就可以后续利用优化器进行梯度更新了。
我们观察一下这个式子:
从直觉上来看,当 越大时,说明第 条轨迹最终获得的总回报越高。此时,策略梯度会倾向于认为这条轨迹中采样到的动作 是“值得鼓励”的,因此需要提高在状态 下选择该动作的概率:
反之,当 较小甚至为负时,则会降低对应动作的概率:
因此,策略梯度最核心的思想可以概括为:提高高回报轨迹中动作的出现概率,降低低回报轨迹中动作的出现概率。
策略梯度算法的优化
仔细观察式(15)
会发现,这里存在一个明显的问题:同一条轨迹中的所有动作,都使用同一个 作为权重。整条轨迹最终表现得很好,并不意味着其中的每一个动作都是好动作;反过来,轨迹最终表现很差,也不意味着其中的每一步都是错误的。
这实际上就是强化学习中的 credit assignment(信用分配)问题:一条轨迹最终获得了某个回报,我们该如何判断其中每一个动作到底应该分到多少“功劳”或“责任”?最原始的策略梯度直接使用整条轨迹的回报 作为每一个动作的权重,显然过于粗糙。后续的研究是不断寻找更合理的单步权重,来代替原始的。
这里可以看一下GAE论文原文(先不用管GAE是什么)
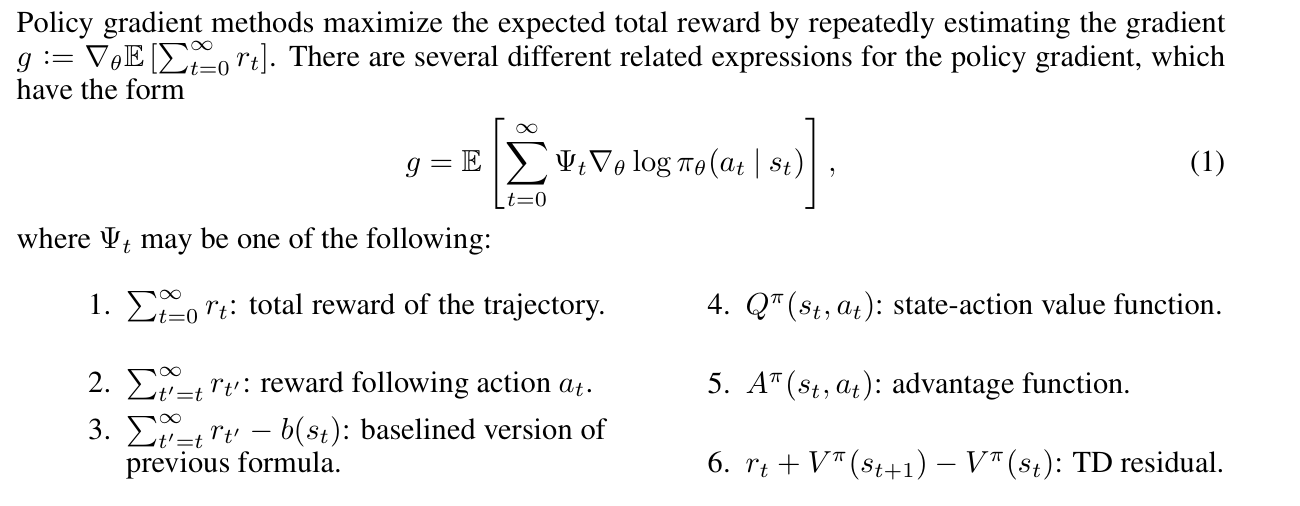
(这里注意,强化学习方法比较规范的写法是用来表示求梯度,为了直观,前文直接用了求微分的表达式。)
可以看到有5种方法来代替(第一种就是本身,就是整个轨迹的reward和)
我们接下来一一介绍
reward following action :只看t时刻后的奖励
该方法用代替,其中:
对于时间步 执行的动作 来说,在 执行之前获得的奖励显然不可能是 带来的。这个方法就是评价动作 时,只考虑执行 之后获得的奖励。
baselined version of previous formula——找一个参照物
上一节中,我们将整条轨迹的回报 替换成了从当前时间步开始的累计回报
前面我们说过,如果是一个很高的分数,那我们就会提高这个动作的概率,反之降低。但是,如果所有的都是正数,那我们要提高所有动作的概率吗?这显然不是很合理。这时候我们需要给找一个参照物。这个参照物代表了本组轨迹所有动作的平均水平,如果高于平均水平,那就提高这个动作的概率,反之就降低。
这个baseline可以取什么呢?他代表这个时刻的平均水平,可以每次采样N个轨迹,然后取这个时刻在N个轨迹的平均值作为baseline
、 以及 的关系
这三个我们可以一块讲
我们先看一下定义:
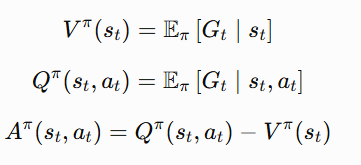
其中
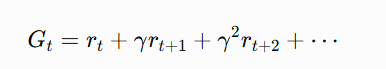
以上定义来源于EasyRL2.2.3
这里的代表折扣回报,代表折扣因子。,这里认为当前时刻对未来的影响应该是随着时间的推移逐渐减小的,也很符合我们直觉。
乍一看 和 很像,它们的区别其实只有一点:是否指定了当前动作 。
表示:当前处于状态 ,接下来所有动作都按照策略 正常选择,未来预计能够获得多少累计回报。这里并没有指定下一步必须执行哪个动作,而是按照策略的分布进行选择。 可以理解为:当前策略在状态 下的“平均发挥水平”。
而表示在状态 下,第一步先执行动作 ,之后再按照策略 正常行动,未来预计能够获得多少累计回报。可以理解成这个状态下指定动作之后平均能按多少分
和 只差一个在时刻,动作的指定与否。其他都不变。
在直观的多次采样视角下, 固定当前状态 ,但当前动作及后续动作都按照策略 采样,对由此产生的不同后续轨迹的累计回报 求期望;而 进一步固定了当前动作 ,只对执行该动作之后可能产生的不同后续轨迹的 求期望。因此:
也就是说, 就是当前策略下各个动作 值的加权平均。
现在我们知道了,表示指定执行动作 能拿多少分,而表示当前策略正常发挥能拿多少分。也就是倾向某一个动作和平均水平的差异,那么要判断动作 到底好不好,最自然的方式就是:
这就是 Advantage Function(优势函数)。
TD error
用 Advantage Function代替原本的也是一个非常不错的选择了。
但是新的问题又来了:和我们怎么得到?
理论上,我们当然可以在同一个状态 下重复采样很多次,通过大量轨迹去估计它们的期望。但实际训练中这样做显然成本太高。
因此,我们希望找到一种更加高效的方法来估计 Advantage。我们当然是否可以设计两个神经网络模型来估计和? 当然可以,但是这么做还是有一些浪费算力。
根据贝尔曼方程:推导见下图:选自EasyRL2.2.3
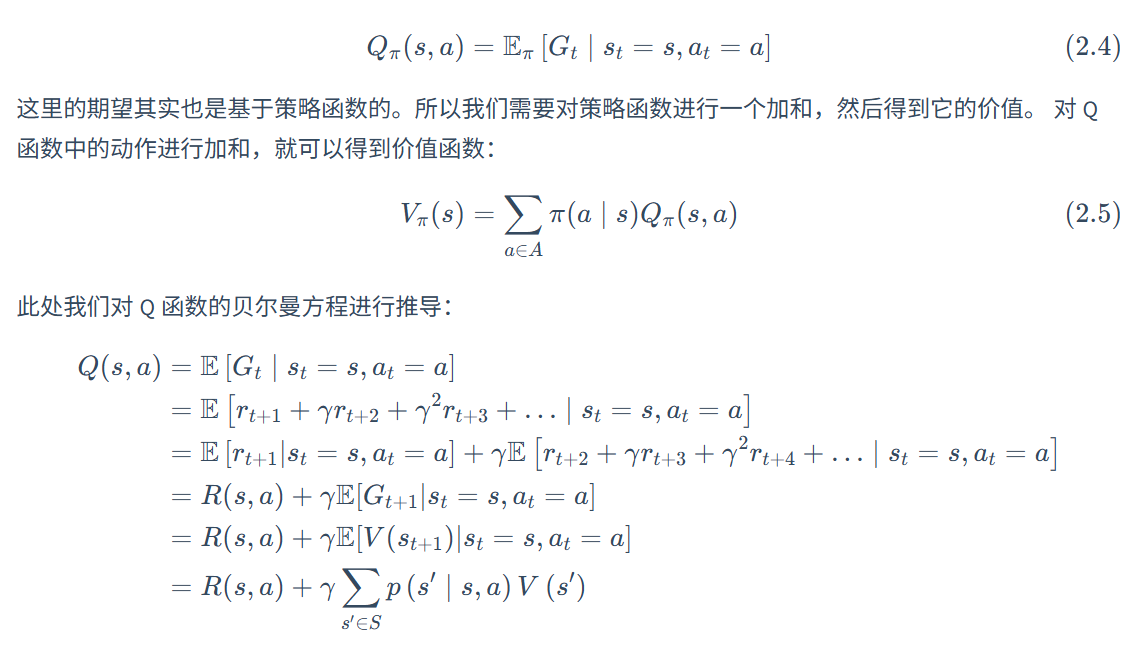
得到:
(这里直觉上来说,代表从下一时刻)开始执行到最后平均能得到的奖励,那么加上此刻的执行了动作单步回报reward,那么就可以近似估计成在时刻执行动作,之后正常执行策略平均能得到的奖励)
也就是说,只要我们能够估计:,那么在实际采样得到一次:
之后,就可以利用:作为 的一个采样估计。
所以:Advantage可以近似写成:
这个近似的Advantage就叫做TD_error,记作。因此我们通常只需要训练一个模型来估计 ,再利用当前奖励 和下一状态的 间接估计 ,最终得到 Advantage,而不需要额外再训练一个 网络。
Actor-Critic算法
前面我们提到,为了估计状态价值函数 ,可以训练一个神经网络专门完成这件事情,这个模型就称为 Critic(评论员)。
而真正负责与环境交互、选择动作,并且最终需要被优化的策略模型,则称为 Actor(演员)。
因此:
Actor:根据当前状态 输出策略 ,负责选择动作; Critic:输入当前状态 ,输出 ,负责评价当前状态的价值。
上面推导了这么多之后,我们也就不会觉得 Critic 是在 Actor-Critic 算法里“莫名其妙”冒出来的模型了。
它出现的根本原因是:我们需要估计 ,从而进一步估计每个动作的 Advantage,为 Actor 提供更加合理的训练信号。
Actor模型的优化目标
Actor 本质上仍然是在做前策略梯度算法进行的更新:
最开始,我们使用整条轨迹的回报 作为权重:
我们给它写规范一些:
经过前面的介绍,已经最终被替换成:
这里注意:Actor-Critic并不一定使用TD-error.这里以TD-error为例。
最终梯度为:
critic模型的优化目标
先直接给出损失:
可以看到,Critic 的损失就是时刻 的 Value 预测,与“当前时刻实际获得的 reward + 下一时刻预测的 Value”之间的均方误差。
根据贝尔曼公式:
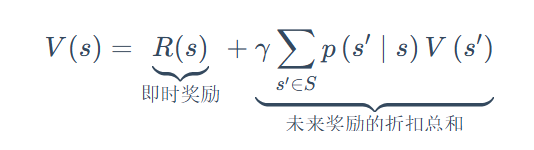
这里看到最右侧是一个期望。
但实际上,如果
如果估计的准的话,对于每一个时间步:以下等式是成立的:
所以我们希望
Critic能准确估计。那就应该满足上边这个式子,所以更新的原理就是,向等式成立的方向不断逼近。
而直觉上,它不断利用“走了一步之后得到的新信息”来修正自己之前对当前状态的判断。这里的这个新信息就是当前时刻的,这个是真实采样得到的reward。
训练流程
Actor-Critic 的训练过程可以分为以下阶段:
1. Actor 与环境交互
在状态 下,Actor 根据策略
采样动作 ,环境返回奖励 和下一个状态 :
2. Critic 估计 Value
Critic 分别预测:
并构造 TD Target:
然后通过:
不断修正自己的 Value 估计。
3. 计算 Advantage
TD Target 和当前 Value 的差:
就是 TD Error,它可以作为 Advantage 的一种估计:
如果 ,说明这个动作比预期更好;如果 ,说明这个动作比预期更差。
4. 更新 Actor
Actor 使用:
更新策略。
因此:
Actor 更新后,策略发生变化,Critic 所需要估计的 也会变化,因此两者会不断交替更新。
可以简单理解为:
Actor 负责做动作,Critic 负责评价动作,两者互相配合不断优化。actor动作越来越精确,critic的评价也越来越准
GAE:更好的 Advantage 估计
前面的 Actor-Critic 框架已经告诉我们:
但这里还有一个问题:
Advantage 到底应该怎么估计?
最简单的方法是使用一步 TD Error:
并令:
但这种方法只利用了一步未来信息,比较依赖 Critic 对
的估计。可能与真是样本的偏差会很大。
另一方面,如果我们直接使用完整的未来回报:
虽然利用了更多真实 reward,偏差会低一些,但通常方差又会比较大。
因此,我们希望在两者之间取得一个平衡。
这就引出了 GAE(Generalized Advantage Estimation)。
其中:
GAE 也可以写成递推形式:
控制我们要参考多远的未来信息。
当:时:
也就是退化成一步 TD Error。
而当 越接近 时,就会综合更多未来信息,更接近基于完整 Return 的 Advantage 估计。
因此,GAE 可以理解为:
在高偏差但低方差的一步 TD 估计和高方差但低偏差的长期 Return 之间做折中。
在 PPO 中,实践里通常使用 GAE 来得到每个时间步的 Advantage:
PPO全称:Proximal Policy Optimization。论文的摘要中写到:
Whereas standard policy gradient methods perform one gradient update per data sample, we propose a novel objective function that enables multiple epochs of minibatch updates.
标准 policy gradient 往往“一批数据做一次更新”,而 PPO 想设计一个新的 surrogate objective,使得同一批采样数据可以做多个 epoch 的 minibatch 更新,从而提高样本利用率
On-policy和 off-policy
强化学习中可以区分两个策略:
Behavior Policy:负责与环境交互、采样数据的策略模型; Target Policy:当前真正想优化的策略模型。
如果两者基本一致:就是 On-policy。如果采样策略和目标策略可以不同,就是 Off-policy。
On-policy 和 Off-policy 的优缺点都比较明显:
On-policy:使用当前策略自己采样的数据进行训练,数据分布和当前策略更一致,训练通常更稳定;但缺点是旧数据很快就不能继续使用,样本利用率较低,需要频繁与环境交互重新采样。
Off-policy:允许使用其他策略甚至历史策略采集的数据训练当前策略,因此可以重复利用旧数据,样本利用率更高;但由于采样策略和目标策略不同,会产生数据分布不一致的问题,训练也会更加复杂。
PPO摘要中的动机就是:标准 policy gradient 往往“一批数据做一次更新”,这样样本利用率没那么高,PPO 想做的事情有点介于on-policy和off-policy之间:它仍然使用当前策略采集一批新数据,但希望这批昂贵的采样数据能够被多利用几次,而不是只更新一次就丢掉。
然而,一旦使用同一批数据更新了一次策略:
此时数据来自旧策略,而我们正在优化的是新策略,于是就出现了分布不一致的问题。那么如何解决这个分布不一致的问题呢?
这就引出了 Importance Sampling(重要性采样)。
重要性采样
假设我们真正想计算:
但现在样本来自另一个分布 。
我们可以在式子中乘上一个恒等于 1 的项:
于是:
因此,即使数据是从 中采样得到的,只要乘上重要性权重
就可以用 下的样本来估计 下的期望。这个过程就叫重要性采样
也就是说,虽然样本来自 ,但只要给每个样本乘上一个权重:
就可以对两个分布之间的差异进行修正。
这个权重很好理解:
如果某个样本在 中出现的概率比在 中更大,那么 ,就应该提高这个样本的权重; 如果某个样本在 中出现的概率更小,那么 ,就应该降低它的权重。
actor的优化目标:重要性采样在ppo中的应用
回到 PPO。我们使用旧策略:
与环境交互并采集了一批数据。但是经过一次参数更新以后,当前真正想优化的策略已经变成:
但我们还想用这批数据更新几步当前的策略
也就是说:
数据来自旧策略 ; 现在想优化的是新策略 。
这和前面重要性采样的问题完全一致。
对应关系为:
因此重要性权重自然变成:
这里使用 而不是 ,是为了避免和 Reward 混淆。
很好理解:
:新旧策略对这个动作的概率相同; :新策略比旧策略更倾向选择这个动作; :新策略比旧策略更不倾向选择这个动作。
经过重要性采样修正后,策略梯度可以写成:
因为:
其中旧策略 在当前这轮 PPO 更新中保持不变,因此:
再利用:
得到:
因此:
在更新 Actor 时,我们把 看作常数,不对它进行反向传播,因此:
最终:
也就是说,原本策略梯度中的
被包含在了 的梯度中。
因此我们可以构造新的优化目标:
即:
PPO-Clip
有了重要性采样之后,我们已经可以使用旧策略 采样得到的数据,去更新当前策略 。
但是还有一个问题:
同一批数据如果被反复训练很多次,当前策略 会逐渐偏离采样时的旧策略 。
此时重要性采样比率
可能变得非常大或者非常小。
例如:表示当前策略选择动作 的概率已经变成旧策略的两倍。
而我们的优化目标:
仍然会继续推动策略沿着当前方向更新。
如果同一批旧数据被反复使用,就可能导致新策略距离旧策略越来越远,训练变得不稳定。
因此 PPO 提出了一个非常直接的想法:
允许策略更新,但不要让同一批数据把策略推得太远。
于是得到 PPO-Clip 的目标函数:
其中 是一个超参数,例如:
那么 Clip 的范围就是:
需要特别注意:
PPO 并不是强制要求 一定处于 中,而是在策略已经沿着正确方向更新得足够多之后,不再继续提供推动它走得更远的梯度。
当 时,说明动作 是一个好动作,我们希望提高:
也就是希望:
如果:
说明这个好动作的概率已经提高得足够多。
此时:
PPO 会选择:。这一项已经与参数 无关,因此:
于是这个样本不再继续推动该动作概率增大。
当 说明动作 是一个坏动作,我们希望降低:
也就是希望:
如果:
说明这个坏动作的概率已经降低得足够多。
此时:
PPO 会选择:
这一项同样不再依赖参数 ,因此这个样本也不会继续推动该动作概率降低。
所以 PPO-Clip 的核心思想可以概括为:
好的动作提高概率,坏的动作降低概率,但一旦已经沿正确方向调整得足够多,就停止继续推动。
也可以简单理解为:
重要性采样 解决“旧数据怎么用于新策略,Clip 解决“同一批旧数据不能把新策略推得太远。
PPO 中的 Critic 优化目标
PPO 中的 Critic 和 Actor-Critic 中的 Critic 本质上没有区别,都是用来估计:
即从当前状态 开始,按照当前策略继续行动,未来预期能够获得多少累计回报。
在最简单的 Actor-Critic 中,一批数据通常采样后就用于一次更新,因此我们经常直接写一步 TD Target:
并通过:
训练 Critic。
这里的 TD Target 是对真实 的一个估计。其中 是真实采样得到的奖励,而 仍然是 Critic 对未来价值的估计。
但是 PPO 有一个很重要的特点:
同一批 Rollout 数据会被重复训练多个 epoch。
假设开始采样时,Actor 和 Critic 分别是和
它们生成一批 Rollout 数据。
在采样过程中,我们会保存:以及
。这里的 表示:这批 Rollout 被采集时,Critic 对状态 的预测值。
为什么要保存一个 old Value?
因为接下来 PPO 会使用同一批数据训练多个 epoch。
第一轮更新之后,Critic 已经发生变化:
如果每训练一轮都重新使用当前 Critic 计算 GAE 和训练目标,那么 Critic 一边更新,训练目标本身也会不断变化。
因此,PPO 通常在 Rollout 结束后,先使用采样时保存下来的:
计算 TD Error:
再计算 GAE:
这些 Advantage 会在接下来多个 PPO epoch 中保持固定。
所以可以利用:
代替之前的
于是 Critic 的损失可以写成:
:Rollout 时保存的旧 Critic 预测; :根据这条 Rollout 得到的修正量; :当前正在被更新的 Critic。
因此可以直观理解为:我们希望新的value预测去逼近rollout时候旧的value预测+经历了这一波更新的修正量。当他们相等时,我们就认为每一个rollout得到的value估计都是准确的。
很多PPO实现里 Critic 也会做 clip,原因和 Actor 做 clip 的思路相似:不希望在同一批 Rollout 数据上进行多个 epoch 更新时,Critic 的 Value 预测相对 一次变化过大,从而导致 Value Function 剧烈震荡、训练不稳定。
所以:
这个式子会将限制在到之间,
最后用clip后的来代入到Critic 的损失函数之中计算损失,以此来限制critic更新的不要太猛。
小结
本文从策略梯度推导到PPO算法,理清了这些算法的来龙去脉。下一篇文章我们正式将PPO算法对应到LLM的RLHF中,研究一下具体实现