


前言
上一次了解了RL中的PPO算法,这次我们去debug一个LLM训练框架的PPO算法是如何实现的,我们以hugging face的trl库中的PPOTrainer为例。看一下具体的PPO算法是如何实现的。
强化学习和监督学习的training loop的不同
在正式看代码之前,我们需要明白强化学习的training loop到底是怎么样的,也就是明白强化学习的训练流程(这里值LLM后训练),搞明白这个训练流程,再看代码就很清晰了。
首先来看监督学习中的training loop:
for epoch in range(epochs):
    for batch in dataloader:
        output=model(**batch)
        loss=output.loss
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()
在监督学习中,训练通常以 epoch 为主要进度单位,即模型完整遍历一次固定训练集;而强化学习中却是有所不同,这里以PPO为例(各个变量对齐Trl库)
def repeat_generator():
    while True:
        yield from dataloaderiter_dataloader = iter(repeat_generator())
for update in range(num_updates):
    # 1. 使用当前 Policy 进行 rollout,生成训练数据
    prompts = next(iter_dataloader)#这里会直接依据dataloader定义的batch_size大小取一批batch数据。
    responses = policy.generate(prompts)# 模型采样,生成一批数据
    # 2. 计算 reward、value、advantage 等训练信号
    rewards = compute_rewards(prompts, responses)
    values = critic(prompts, responses)
    advantages, returns = compute_gae(rewards, values)
    # 3. 同一批 rollout 数据重复训练多个 PPO epoch
    for ppo_epoch in range(num_ppo_epochs):
        # 每个 epoch 将 rollout batch 打乱并切成 mini-batch
        for minibatch in rollout_batch:# 这里的rollout_batch就是这个rollout采的数据数量
            policy_loss = compute_policy_loss(minibatch)
            value_loss = compute_value_loss(minibatch)
            loss = policy_loss + value_loss#实际会给value_loss带一个权重
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()
而在 PPO 等强化学习算法中,更自然的外层单位是一次update(也就是一次rollout):代表当前 Policy 先采集一批新的交互数据,再基于这批数据进行一次update。但是一次rollout表示一次新的经验采集与学习周期,而不等价于只执行一次参数更新。在一次rollout之后,ppo算法会用这批数据多次更新自己,即一个ppo_epoch代表模型完整遍历一次这批采样数据。
从training loop上来说,强化学习很像在深度学习的基础上加了一个"造数据(模型采样)"的步骤,后边的ppo_epoch和深度学习的epoch也差不多,只是监督形式计算不一样。
换句话说:监督学习是提前造好的标准输入输出对,然后直接输入进模型,模型输出,和标准输出算loss来进行参数更新。而强化学习只有输入,先用这批输入送进模型采样一批输出,再通过 reward、value、advantage 等信号评价这些输出,并使用对应的强化学习目标函数来更新参数。
明白了整体 training loop 之后,接下来我们就把 RLHF-PPO 拆成三个阶段来看:先怎么采样 Rollout,再怎么构造 Reward、Value、Advantage 等监督信号,最后又是如何在多个 PPO Epoch 中完成参数更新的。
RLHF中需要的额外model
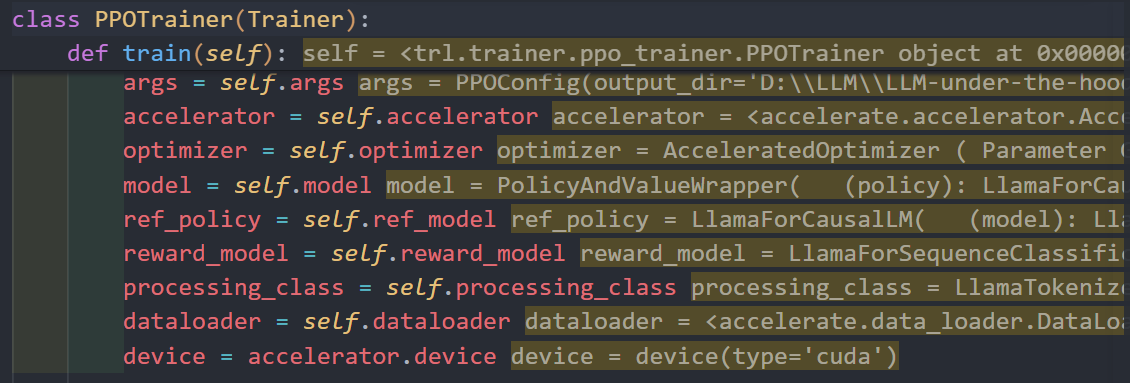
在进行训练前,这里出现了两个需要额外传入的新model,分别是ref_model,reward_model。
这里分别介绍一下他们是什么作用:
reference model:
reference model是我们要进行优化的模型的副本,他在训练中是冻结参数不进行更新的。他的作用是让更新的模型不要偏离原始模型太远,具体实现用kl散度实现。
注意:这个model和后边的ppo-epoch中的并不是一回事儿。Reward model:
对policy model生成的回答打分,他这个打分是针对整个seq的打分。这个reward model需要提前训练好,在训练policy model的时候是不更新的。
Rollout 阶段
Rollout 阶段的核心任务是:使用当前 Policy 根据一批 Prompt 生成 Response,并保存后续 PPO 训练所需要的轨迹信息。
self.state.episode += 1 * args.batch_size
data = next(iter_dataloader)
with torch.no_grad():
    queries = data["input_ids"].to(device)
    with unwrap_model_for_generation(model, self.accelerator) as unwrapped_model:
        query_responses, logitss = batch_generation(
            unwrapped_model.policy,
            queries,
            args.local_rollout_forward_batch_size,
            processing_class.pad_token_id,
            generation_config,
                        )
首先是批量生成回答,这里需要注意下args.batch_size和args.local_rollout_forward_batch_size的区别,前者是这一次rollout要采样的数据量,后者是对这批数据,我们分批送进模型,分批生成,最后给他cat起来。
接下来就是对rollout数据的处理
# 按 rollout_forward_batch_size 分批处理,避免一次 forward 占用过多显存
for i in range(0, queries.shape[0], args.local_rollout_forward_batch_size):
    # 当前 rollout 小批次
    query = queries[i : i + args.local_rollout_forward_batch_size]
    query_response = query_responses[i : i + args.local_rollout_forward_batch_size]
    # 截取生成的 response 部分
    response = query_response[:, context_length:]
    # 取 rollout policy 生成时的 logits
    logits = logitss[i : i + args.local_rollout_forward_batch_size]
    # 计算整个词表的 log probability
    all_logprob = F.log_softmax(logits, dim=-1)
    # 只取实际生成 token 对应的 logprob,即 old logprob
    logprob = torch.gather(
        all_logprob, 2, response.unsqueeze(-1)
    ).squeeze(-1)    # Reference Model 对同一 query+response 做 forward
    ref_output = forward(
        ref_policy,
        query_response,
        processing_class.pad_token_id
    )#
    # 截取与 response token 对齐的 logits
    ref_logits = ref_output.logits[:, context_length - 1 : -1]
    # 与 rollout 时的 temperature 保持一致
    ref_logits /= args.temperature + 1e-7
    # 计算 Reference Model 的 log probability
    ref_all_logprob = F.log_softmax(ref_logits, dim=-1)
    # 取实际生成 token 在 Reference Model 下的 logprob
    ref_logprob = torch.gather(
        ref_all_logprob, 2, response.unsqueeze(-1)
    ).squeeze(-1)
这里注意:
    # 只取实际生成 token 对应的 logprob,即 old logprob
    logprob = torch.gather(
        all_logprob, 2, response.unsqueeze(-1)
    ).squeeze(-1)
这里按照公式来说,应该是要把整个词表的概率分布保存下来用作后续计算KL散度的,但是这里没有,只是将概率最大的词的对数概率取了出来,包括后边的ref_model也只是取了概率最大的那个词的对数概率。我们继续往下看,后便会解释原因。
构造监督信号
构造的监督信号主要包括:
Reward Model Score:Reward Model 对完整 Response 给出的整体评分; KL Reward:根据当前 Policy 与 Reference Model 的差异构造 KL 惩罚,限制模型偏离 Reference Model 过远; Value:Critic 对每个 Token 对应状态 的价值估计 ; Advantage:利用 Reward 和 Value,通过 GAE 计算每个 Token 的优势 ; Return:由 Advantage 和旧 Value 构造 Critic 的训练目标:
最终:
Actor 使用 和新旧 Policy 的概率比计算 PPO Loss; Critic 使用 return作为目标计算 Value Loss。
我们看看代码是怎么实现的:
Reward Model Score和Value的获取
# 将 Prompt 和截断后的 Response 拼接,作为 Reward Model 的输入
postprocessed_query_response = torch.cat(
    (query, postprocessed_response),
    dim=1,
)
# 找到每条 Response 最后一个有效 token 的位置
sequence_length = (
    first_true_indices(
        postprocessed_response == processing_class.pad_token_id
    )
    - 1)
# 从 PPO 包装模型中取出 Critic / Value Model
unwrapped_value_model = accelerator.unwrap_model(model).value_model
# Critic 对整条 query + response 计算每个位置的 Value
full_value, _, _ = get_reward(
    unwrapped_value_model,
    query_response,
    processing_class.pad_token_id,
    context_length,
)
# 只保留与 Response token 对齐的 Value
value = full_value[:, context_length - 1 : -1].squeeze(-1)
# Reward Model 对截断后的完整 Response 给出 sequence-level score
_, score, _ = get_reward(
    reward_model,
    postprocessed_query_response,
    processing_class.pad_token_id,
    context_length,
)
这里注意下unwrapped_value_model这个东西,源码里是:
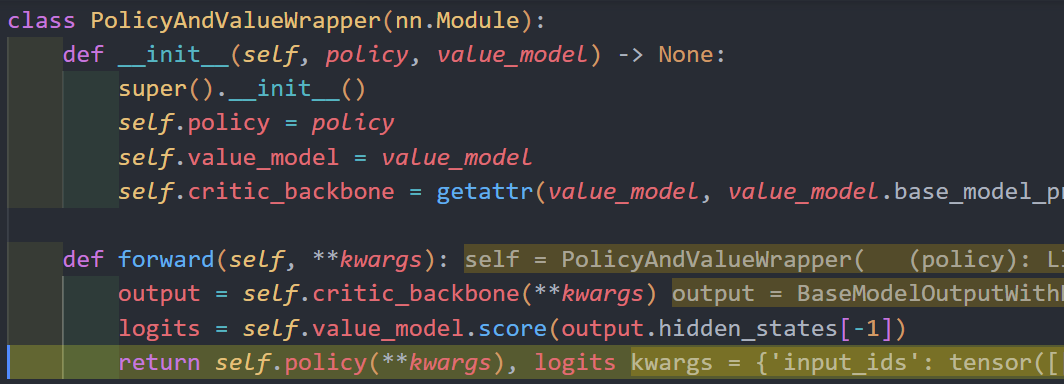
critic_model将policy_model的lm_head改成了一个score_head,也就是一个线性层,这里以我debug时使用的llama为例看一下critic_model的结构
LlamaForSequenceClassification(
  (model): LlamaModel(
    (embed_tokens): Embedding(32002, 32, padding_idx=32001)
    (layers): ModuleList(
      (0-1): 2 x LlamaDecoderLayer(
        (self_attn): LlamaAttention(
          (q_proj): Linear(in_features=32, out_features=32, bias=False)
          (k_proj): Linear(in_features=32, out_features=16, bias=False)
          (v_proj): Linear(in_features=32, out_features=16, bias=False)
          (o_proj): Linear(in_features=32, out_features=32, bias=False)
        )
        (mlp): LlamaMLP(
          (gate_proj): Linear(in_features=32, out_features=64, bias=False)
          (up_proj): Linear(in_features=32, out_features=64, bias=False)
          (down_proj): Linear(in_features=64, out_features=32, bias=False)
          (act_fn): SiLUActivation()
        )
        (input_layernorm): LlamaRMSNorm((32,), eps=1e-06)
        (post_attention_layernorm): LlamaRMSNorm((32,), eps=1e-06)
      )
    )
    (norm): LlamaRMSNorm((32,), eps=1e-06)
    (rotary_emb): LlamaRotaryEmbedding()
  )
  (score): Linear(in_features=32, out_features=1, bias=False)
)
可以发现之后最后的lm_head被改成了一个线性层,输出一个标量,代表着对该token位置的value值估计。
每个token的实际Reward计算
# 计算 rollout policy 与 reference model 在实际生成 token 上的 log-prob 差值
# 这是对 KL(pi || pi_ref) 的逐 token 采样估计
kl = logprobs - ref_logprobs
# 将 KL 转换成惩罚型 reward:离 reference model 越远,惩罚越大
non_score_reward = -args.kl_coef * kl
# 先将每个 token 的 KL reward 作为基础 reward
rewards = non_score_reward.clone()
# 构造 batch 下标:[0, 1, 2, ..., batch_size-1]
actual_start = torch.arange(
    rewards.size(0),
    device=rewards.device,
)
# 找到每条 Response 应该添加 Reward Model score 的终止位置
# 如果 sequence_length + 1 没有越界,就使用该位置;否则退回最后一个有效位置
actual_end = torch.where(
    sequence_lengths_p1 < rewards.size(1),
    sequence_lengths_p1,
    sequence_lengths,
)
# 将 Reward Model 对整条 Response 的 score 只加一次,
# 加到每条轨迹的终止位置上
rewards[actual_start, actual_end] += scores
我们知道,在强化学习中,每个时刻都会给出reward,对应到LLM中,就是每个token都会有一个奖励值,但是上边说的Reward_model只会对整个seq给出一个标量的奖励值,所以在RLHF的ppo中,这个奖励值只会加到整个seq的最后一个token上边,除此之外,为了防止 Policy 在强化学习过程中偏离原始的Reference Model太远还会在每个 token位置计算Policy与Reference Model的KL散度,并将其作为惩罚注入到每个token的reward 中。
因此,对于第 个token其最终reward 可以写成:
当 token 不是最后一个有效 token 时:
也就是说,中间 token 只有 KL 惩罚。而当token是 最后一个有效 token,即 时:
也就是说,最后一个 token 除了 KL reward 之外,还会额外加上 Reward Model 对整条 Response 给出的分数。
但实际代码实现KL散度的时候
kl = logprobs - ref_logprobs
logprobs 和 ref_logprobs 并没有保留整个词表上的概率分布,而只是取出了当前时刻实际生成 token对应的 log probability:
和
所以
严格意义上并不是完整的 KL 散度。
真正的 KL 散度应该对整个词表上的所有 action 求期望:
写成期望形式:
在 Rollout 阶段,我们已经从 Policy 中实际采样得到了当前选取的token
因此,可以直接使用这个实际采样到的 token:
作为 KL 散度的 Monte Carlo 采样估计。随着数据更新,这个采样也会越来越逼近真实的KL散度
计算advantage和return
# 保存“下一个时间步”的 GAE,终止位置之后没有未来 Advantage,因此初始化为 0
lastgaelam = 0
# 因为 GAE 需要从后往前递推,所以先用列表倒序保存
advantages_reversed = []
# Response 在 batch tensor 中统一后的生成长度
gen_length = responses.shape[1]
# 从最后一个 token 开始,反向计算每个时间步的 GAE
for t in reversed(range(gen_length)):
    # 取下一时刻的 Value:
    # 如果已经是最后一个位置,则认为终止状态之后的 Value 为 0
    nextvalues = (
        values[:, t + 1]
        if t < gen_length - 1
        else 0.0
    )
    # 计算一步 TD Error
    # δ_t = r_t + γV(s_{t+1}) - V(s_t)
    delta = (
        rewards[:, t]
        + args.gamma * nextvalues
        - values[:, t]
    )
    # GAE 递推:
    # A_t = δ_t + γλA_{t+1}
    lastgaelam = (
        delta
        + args.gamma * args.lam * lastgaelam
    )
    # 当前得到的是倒序的 Advantage
    advantages_reversed.append(lastgaelam)
# 将 [A_T, A_{T-1}, ..., A_0]
# 恢复为 [A_0, A_1, ..., A_T],
# 并沿时间维 stack 成 [batch_size, gen_length]
advantages = torch.stack(
    advantages_reversed[::-1],
    dim=1,
)
# 构造 Critic 的训练目标:
# returns = old_values + advantages
returns = advantages + values
# 对有效 token 的 Advantage 做 whitening,
# 让 Advantage 的尺度更稳定
advantages = masked_whiten(
    advantages,
    ~padding_mask,
)
PPO中用的advantage用的是GAE,这个我们很熟悉了,对应公式:
其中:
因为我们已经将一个轨迹都采样出来了,所以代码的实现就是从最后一个时刻递推回去
而其中的
advantages = masked_whiten(
    advantages,
    ~padding_mask,
)
这一步是对对有效 token 的 Advantage 计算均值和方差,然后做标准化。这个小技巧在学理论时是没有的,算是是工程上的优化
PPO Epoch
上边都是一次rollout之后计算的变量,计算完之后就存起来,用于在ppo epoch中进行模型的更新。
我们直接看代码:
# 同一批 rollout 数据重复训练多个 PPO epoch
for ppo_epoch_idx in range(args.num_ppo_epochs):
    # 每个 PPO epoch 重新打乱 rollout batch
    b_inds = np.random.permutation(args.local_batch_size)
    minibatch_idx = 0
    # 将 rollout batch 切成多个 mini-batch 这里就很像监督学习的循环排列了
    for mini_batch_start in range(0, args.local_batch_size, args.local_mini_batch_size):
        mini_batch_end = mini_batch_start + args.local_mini_batch_size
        mini_batch_inds = b_inds[mini_batch_start:mini_batch_end]
        gradient_accumulation_idx = 0
        # 将 mini-batch 再切成 micro-batch 做梯度累积
        for micro_batch_start in range(0, args.local_mini_batch_size, args.per_device_train_batch_size):
            with accelerator.accumulate(model):
                micro_batch_end = micro_batch_start + args.per_device_train_batch_size
                micro_batch_inds = mini_batch_inds[micro_batch_start:micro_batch_end]                # 取出当前 micro-batch 的 rollout 数据
                mb_advantage = advantages[micro_batch_inds]
                mb_responses = responses[micro_batch_inds]
                mb_query_responses = query_responses[micro_batch_inds]
                mb_logprobs = logprobs[micro_batch_inds]   # old logprob
                mb_return = returns[micro_batch_inds]     # Critic 训练目标
                mb_values = values[micro_batch_inds]      # old value                # 当前 Actor + Critic forward
                output, vpred_temp = forward(model, mb_query_responses, processing_class.pad_token_id)                # 当前 Policy 对 response token 的 logprob
                logits = output.logits[:, context_length - 1 : -1]
                logits /= args.temperature + 1e-7
                new_all_logprobs = F.log_softmax(logits, dim=-1)
                new_logprobs = torch.gather(new_all_logprobs, 2, mb_responses.unsqueeze(-1)).squeeze(-1)
                new_logprobs = torch.masked_fill(new_logprobs, padding_mask[micro_batch_inds], INVALID_LOGPROB)                # 当前 Critic 的 Value 预测
                vpred = vpred_temp[:, context_length - 1 : -1].squeeze(-1)
                vpred = torch.masked_fill(vpred, padding_mask_p1[micro_batch_inds], 0)                # ---------------- Critic Loss ----------------
                # 限制当前 Value 相比 old value 变化过大
                vpredclipped = torch.clamp(
                    vpred,
                    mb_values - args.cliprange_value,
                    mb_values + args.cliprange_value,
                )                vf_losses1 = torch.square(vpred - mb_return)
                vf_losses2 = torch.square(vpredclipped - mb_return)
                vf_loss_max = torch.max(vf_losses1, vf_losses2)
                vf_loss = 0.5 * masked_mean(vf_loss_max, ~padding_mask_p1[micro_batch_inds])                # Value Clip 的统计指标
                vf_clipfrac = masked_mean(
                    (vf_losses2 > vf_losses1).float(),
                    ~padding_mask_p1[micro_batch_inds],
                )                # ---------------- Actor Loss ----------------
                # ratio = pi_new(a|s) / pi_old(a|s)
                logprobs_diff = new_logprobs - mb_logprobs
                ratio = torch.exp(logprobs_diff)                # PPO-Clip
                pg_losses = -mb_advantage * ratio
                pg_losses2 = -mb_advantage * torch.clamp(
                    ratio,
                    1.0 - args.cliprange,
                    1.0 + args.cliprange,
                )
                pg_loss_max = torch.max(pg_losses, pg_losses2)
                pg_loss = masked_mean(pg_loss_max, ~padding_mask[micro_batch_inds])                # Actor Loss + Critic Loss
                loss = pg_loss + args.vf_coef * vf_loss                # 反向传播;Accelerate 会自动处理梯度累积
                accelerator.backward(loss)
                optimizer.step()
                optimizer.zero_grad()
主要流程就是,将数据送进模型前向传播,然后利用前面算出的监督信号和前向传播得到的计算loss。
重点看两个loss的计算
critic loss
vpredclipped = torch.clamp(
                    vpred,
                    mb_values - args.cliprange_value,
                    mb_values + args.cliprange_value,)
vf_losses1 = torch.square(vpred - mb_return)
vf_losses2 = torch.square(vpredclipped - mb_return)
vf_loss_max = torch.max(vf_losses1, vf_losses2)
vf_loss = 0.5 * masked_mean(vf_loss_max, ~padding_mask_p1[micro_batch_inds])
vf_losses1对应公式:
mb_return就是将return加了mask,把无关的token给mask掉,而return=advantages + values也都能对应这个公式
而vf_losses2使用clip掉的new_value去减去return。和上一篇我们讲的一样对应公式
而最终
vf_loss_max = torch.max(vf_losses1, vf_losses2)
之所以取较大的 Loss,是因为 PPO 并不希望 Critic 通过一次非常激进的 Value 更新,直接获得一个很小的训练误差。核心思想也是:允许模型朝更好的方向更新,但不鼓励一次更新得过于激进。
policy model loss
logprobs_diff = new_logprobs - mb_logprobs
ratio = torch.exp(logprobs_diff)
pg_losses = -mb_advantage * ratio
pg_losses2 = -mb_advantage * torch.clamp(ratio, 1.0 - args.cliprange, 1.0 + args.cliprange)
pg_loss_max = torch.max(pg_losses, pg_losses2)
对照着公式来看:
pg_losses为:
pg_losses2 为clip之后,
最终也是取大的那个,加一个负号就是取小的那个,最终对应公式:
最终的loss
最终这两个loss并不是1比1的,而是:
loss = pg_loss + args.vf_coef * vf_loss
value loss并不是和policy loss相同权重
其他部分就和监督学习中的epoch差不多了。
总结
搞清楚PPO的原理,那么接下来的DPO GRPO,DAPO也都是逐步优化了~。接下来开始逐步学习。