惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

J
Java Code Geeks
博客园 - 聂微东
人人都是产品经理
人人都是产品经理
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
博客园_首页
量子位
阮一峰的网络日志
阮一峰的网络日志
酷 壳 – CoolShell
酷 壳 – CoolShell
H
Hackread – Cybersecurity News, Data Breaches, AI and More
云风的 BLOG
云风的 BLOG
D
DataBreaches.Net
B
Blog
L
LangChain Blog
Apple Machine Learning Research
Vercel News
Vercel News
博客园 - 三生石上(FineUI控件)
爱范儿
爱范儿
Microsoft Azure Blog
IT之家
IT之家
aimingoo的专栏
aimingoo的专栏
B
Blog RSS Feed
H
Help Net Security
The Cloudflare Blog
U
Unit 42

阿尔的代码屋 | 全栈技术笔记

YuE2 全曲音乐生成模型本地部署与乐谱白盒实操 | 阿尔的代码屋 MiniMax-H3 NF4 视音频联合生成模型本地部署与调试 | 阿尔的代码屋 ShareX 联动 Antigravity 自动化记录与跨环境管道构建 | 阿尔的代码屋 国内搜索引擎收录实战:百度与头条搜索接入、无备案验证绕行与自动化推送 - 独立博客 SEO 与 GEO 03 | 阿尔的代码屋 技术博客工程化治理与 WebP 自动化质量门禁 - Hexo 博客建站与优化实战 05 | 阿尔的代码屋 Hexo NexT 静态资源本地自托管、KaTeX 公式渲染与移动端适配 - Hexo 博客建站与优化实战 04 | 排坑笔记 | 阿尔的代码屋 把 VS Code 打造成 Git 终极编辑器、Diff 与 Merge 利器 - Git 避坑与工作流 04 | 排坑笔记 | 阿尔的代码屋 告别架构图看不清:Hexo NexT 8.x 本地化集成 Fancybox 5 高清灯箱实战 | 开发日志 | 阿尔的代码屋 Hexo new 日期无法自动生成且出现 object Object 报错根治 | 排坑笔记 | 阿尔的代码屋 IndexNow 毫秒级主动推送与全站语义拓扑网格 - 独立博客 SEO 与 GEO 02 | 架构实战 | 阿尔的代码屋 从拦截 AI 爬虫到成为大模型答案源 - 独立博客 SEO 与 GEO 01 | 架构实战 | 阿尔的代码屋 Chrome 扩展开发与上架全流程实战避坑 - 开发技巧 | 阿尔的代码屋 VS Code 终端日志被截断?两项配置彻底解锁完整输出与会话持久化 | 排坑笔记 | 阿尔的代码屋 在 WSL2 环境下部署 Pixal3D 的从零实战与全流程排雷日志 | 阿尔的代码屋 在 Android Termux 环境下安装 Hermes Agent 的踩坑与完美解决实践 开发日志| 阿尔的代码屋 VS Code 连接 WSL 精确每 10 分钟掉线 排坑笔记 | 阿尔的代码屋 Android 模拟器代理联网与 No Internet WiFi 锁死排坑笔记 | 阿尔的代码屋 [object Object] Flutter 本地通知实现排坑实录 - Android inexactAllowWhileIdle 调度策略与测试方案全解析 | 阿尔的代码屋 typing_extensions 有用(四):使用 TypeIs 替代危险的 cast,做最严谨的类型收窄 | 阿尔的代码屋 GoRouter 结合 Isar 运行 Widget 测试并发/粘性线程死锁卡死排坑笔记 | 阿尔的代码屋 typing_extensions 有用(三):使用 Unpack 结合 TypedDict 给 **kwargs 装上透视眼 | 阿尔的代码屋 typing_extensions 有用(二):使用 @override 打造重构代码时的“防呆神器” | 阿尔的代码屋 Flutter 并发测试踩坑实录 - IsarCore 动态库下载冲突与 Widget 测试 HTTP 拦截全链路解决 | 阿尔的代码屋 typing_extensions 有用(一):使用 Self 终结继承时的类型推断灾难 | 阿尔的代码屋 基于 Cloudflare Pages 的纯前端 WebAssembly 应用自动化部署实践 | 开发日志 | 阿尔的代码屋 基于 VS Code 远程开发的 GPU Docker 容器自动清理方案实践 开发日志| 阿尔的代码屋 Patrol iOS 集成测试排坑实录 - xcodebuild exit code 70 全链路解决 | 阿尔的代码屋 Flutter E2E 测试从 integration_test 迁移到 Patrol - 实践笔记 | 阿尔的代码屋 Linux/macOS 下 micromamba 报错 Shard Index not available 与极度卡顿 排坑笔记 | 阿尔的代码屋
VoxCPM2 多语言语音合成与声音克隆本地部署 | 阿尔的代码屋
Algieba · 2026-09-13 · via 阿尔的代码屋 | 全栈技术笔记

1. 目标效果与前置准备

本文指导在本地 Linux 与 WSL2 环境下,利用 uv 与 ModelScope 完成开源语音大模型 VoxCPM2 的部署与声音克隆。

1.1 本文最终交付成果

学完本篇教程后,你将能够:

  1. 掌握基于 Tokenizer-Free 连续表征架构的语音合成运行机制;
  2. 在本地 Linux 与 WSL2 环境中搭建具备 48kHz 高保真输出的 VoxCPM2 语音生成服务;
  3. 获得现成的 ModelScope 高速拉取脚本与完全解耦系统级 FFmpeg 的纯 Python 音频处理工程方案;
  4. 跑通包括声音设计、可控克隆与基于文本引导的极致克隆在内的全流程交互验证。

1.2 前置环境与基础要求

  • 前置认知:具备基础的 Linux Shell 命令行操作经验,了解 Python 虚拟环境与 PyTorch 基础概念;
  • 软硬件环境
    • 操作系统:Ubuntu 22.04 LTS(WSL2 或独立 Linux 系统均可)
    • 计算卡与驱动:NVIDIA GeForce RTX 4090(显存 24GB,驱动版本 591+,CUDA 12.0+)
    • 解释器与工具链:Python 3.11、uv 包管理器(版本 0.11+)
    • 宿主机浏览器:Microsoft Edge 或 Google Chrome

2. 核心概念极速通识(3分钟精要)

VoxCPM2 舍弃离散音频分词器,采用连续扩散自回归架构,配合 AudioVAE V2 编码器实现 48kHz 超采样输出。

在正式动手部署前,厘清 3 个核心专业名词:

  • 概念 A:Tokenizer-Free 连续语音表征:传统语音大模型多依赖离散化的音频 Tokenizer(例如 EnCodec、SoundStream),将声音量化为整数序列,容易在重构阶段带来金属电音与细节丢失。VoxCPM2 采用连续表征架构,直接在连续特征空间进行扩散建模,保留了气音、唇齿音与细微呼吸动态。
  • 概念 B:AudioVAE V2 非对称架构:模型内置两套声学编解码通道,支持输入 16kHz 的参考音频,经由潜在特征重建后,直接在输出端超采样合成 48kHz 广播级高质量音频,省去了外置后处理超分模型的繁琐流程。
  • 概念 C:可控克隆 vs 极致克隆:可控克隆允许在保留目标人物音色的基础上,通过自然语言指令(Control Instruction)调节其说话语气、语速与情绪状态;极致克隆则是音频续写模式,强制对齐参考文本,100% 还原原始音频中的停顿、语调起伏与环境质感。

为了直观对比两代语音生成架构的工程差异,核心特性对照如下表:

评估维度传统离散 Tokenizer 方案 (EnCodec / SoundStream)VoxCPM2 连续扩散表征方案
特征表征空间矢量量化离散整数索引序列 (Vector Quantization)连续潜变量特征空间 (Continuous Latent Space)
高保真重构细节量化损失明显,易产生机械电音与杂音端到端扩散建模,完整保留气音、唇齿音与呼吸动态
声学生成规格多为 16kHz/24kHz,需外挂超分模型后处理内置 AudioVAE V2 非对称通道,直出 48kHz 广播级音频
音色克隆控制泛化音色单一,风格与提示词难以深度解耦原生支持「可控克隆(指令调节语气)」与「极致克隆(100%对齐)」

3. 手把手实战步骤(Step-by-Step)

通过环境初始化、魔搭极速下载、纯 Python 依赖补齐与 WebUI 启动,依次实现端到端推理与麦克风克隆验证。

步骤一:创建隔离虚拟环境与依赖同步

首先克隆官方代码仓库 OpenBMB/VoxCPM 并进入工程根目录:

1
2
git clone https://github.com/OpenBMB/VoxCPM.git
cd VoxCPM

VoxCPM2 推荐运行在 Python 3.10 或 3.11 环境下。我们使用现代化工具 uv 创建专用的 Python 3.11 虚拟环境,并执行依赖同步:

1
2
3
4
5

uv venv .venv --python 3.11


uv sync

同步完成后,环境内已就绪 PyTorch 2.10(CUDA 12.9)、torchaudio、Gradio 6、funasr 以及 ModelScope SDK。

步骤二:通过 ModelScope 国内镜像高速拉取 4.7GB 权重

VoxCPM2 权重包含 4.27GB 的主模型 model.safetensors 与 359MB 的 audiovae.pth。直接从海外 Hugging Face 下载容易遭遇连接重置或限速。官方已将完整权重同步至国内 ModelScope 社区 OpenBMB/VoxCPM2 平台,可利用阿里云高速 CDN 进行百兆跑满下载:

1
2
3
4
5
6
.venv/bin/python -c "
from modelscope import snapshot_download
print('开始从 ModelScope 拉取 VoxCPM2 完整权重...')
snapshot_download('OpenBMB/VoxCPM2', local_dir='./pretrained_models/VoxCPM2')
print('权重下载完成!')
"

在实测带宽下,平均下载速率达到 48MB/s,仅用时 1 分 40 秒即完成了全部文件的完整校验与落盘。

检查落盘目录结构:

1
2
3
4
5
6
ls -lh ./pretrained_models/VoxCPM2


步骤三:启动交互式 WebUI 服务

执行以下命令,在本地指定端口启动 WebUI 服务:

1
PATH="$(pwd)/.venv/bin:$PATH" .venv/bin/python app.py --model-id ./pretrained_models/VoxCPM2 --port 8808 --host 0.0.0.0

启动日志提示如下内容时,说明后台服务已正常就绪:

1
2
3
Loaded VoxCPM2Model
Warm up VoxCPMModel... 100%|██████████| 10/10
* Running on local URL: http://0.0.0.0:8808

在宿主机浏览器中打开 http://localhost:8808,即可看到全功能的交互界面:
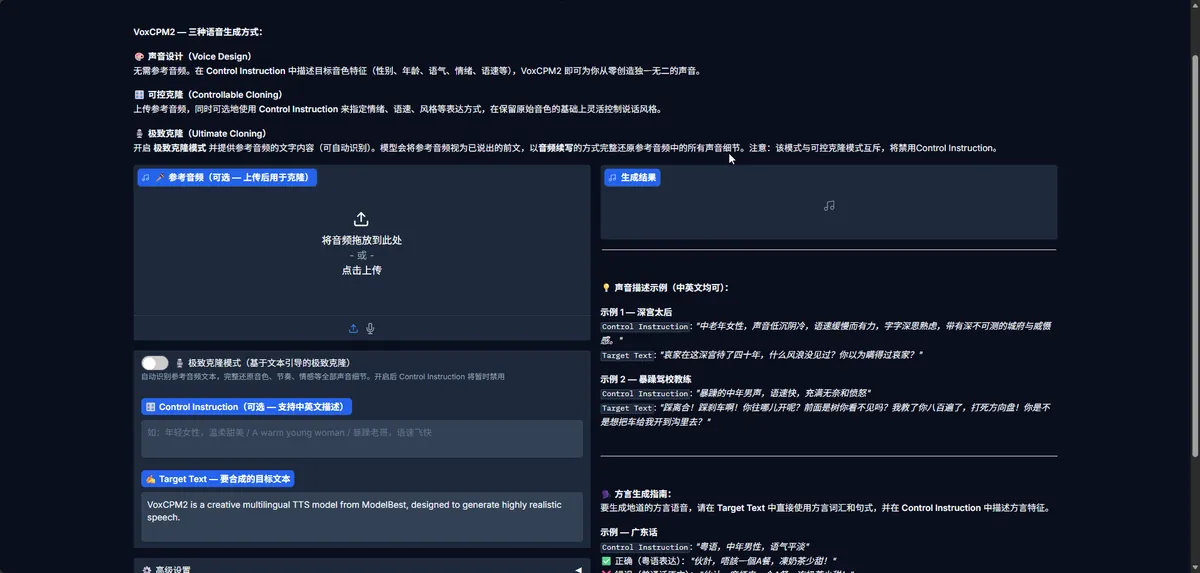
VoxCPM2 交互式 WebUI 仪表盘概览

步骤四:配置宿主机浏览器安全上下文并唤醒麦克风

在首次尝试通过浏览器录制参考音频时,Web 界面弹出了“找不到麦克风”的异常提示:
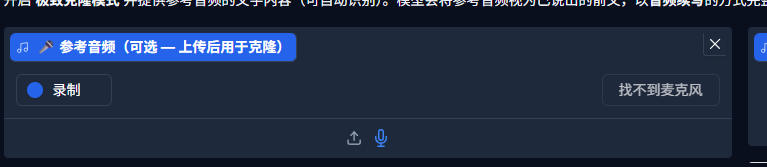
参考音频组件报找不到麦克风错误

这一现象并非 WSL2 内部缺失声卡驱动,而是由于现代 Chromium 内核对 HTTP 明文地址限制了 getUserMedia 硬件调用权限。通过以下步骤即可根治:

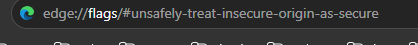
  1. 在 Edge 或 Chrome 浏览器中访问不安全源白名单配置页:
1
edge://flags/#unsafely-treat-insecure-origin-as-secure

在 Edge 地址栏打开安全上下文豁免配置页

  1. http://localhost:8808, http://127.0.0.1:8808 填入白名单输入框,并将状态切换为 Enabled(已启用),随后点击右下角按钮重启浏览器:
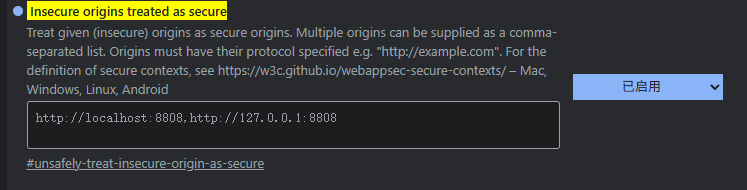
启用本地端口不安全源安全上下文豁免

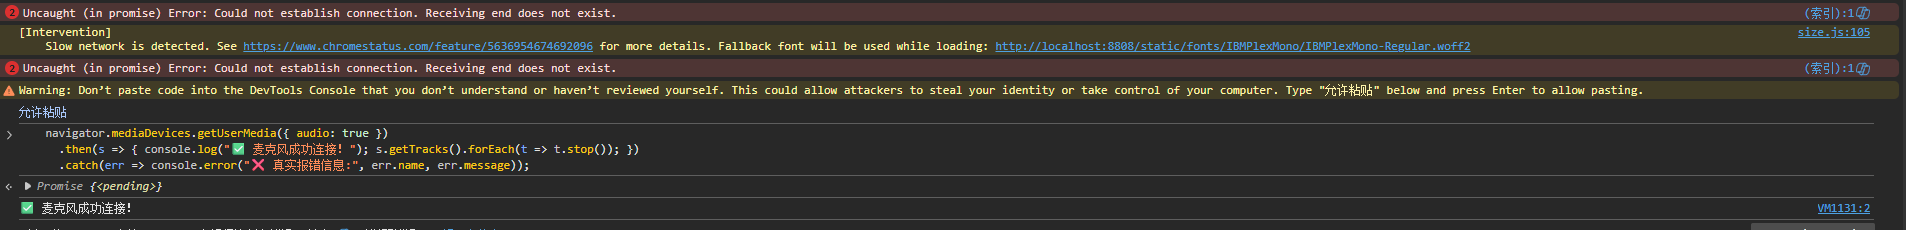
  1. 在 WebUI 页面按下 F12 打开开发者工具,在 Console 控制台中执行以下探测语句以完成物理硬件与权限握手:
1
2
3
navigator.mediaDevices.getUserMedia({ audio: true })
.then(s => { console.log("麦克风成功连接!"); s.getTracks().forEach(t => t.stop()); })
.catch(err => console.error("报错详情:", err.name, err.message));

控制台成功打印连接状态:

浏览器开发者工具控制台执行 getUserMedia 成功连接麦克风

刷新页面后,点击录音按钮,成功录制了 15 秒清晰的真人音频样本并渲染出完整的声波波形:
使用麦克风成功录制参考音频并生成波形图

步骤五:执行极致克隆与端到端高保真语音生成

在获得参考音频后,进入核心克隆流程:

  1. 打开“极致克隆模式”开关,系统自动禁用自由风格提示词,转入音频续写分支:

在界面中开启基于文本引导的极致克隆模式

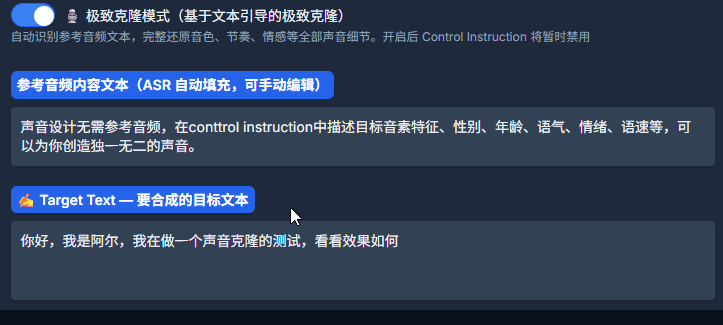
  1. 内置的 FunASR 模块自动将录制的参考音频识别为文本,作为先验上下文;在下方输入框填入待生成的目标文本:

FunASR 自动识别参考音频文本与目标文本输入框

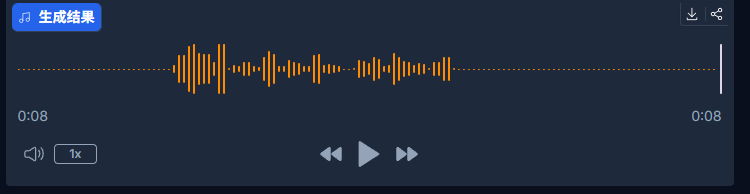
  1. 点击生成按钮。RTX 4090 显卡在 bfloat16 精度下全速推理,生成出 8 秒长度的高保真克隆音频,完美复刻了说话人的原声音色与发音质感:

成功生成八秒声音克隆高保真音频结果


4. 高频踩坑与常见问题答疑(FAQ)

针对 WSL2 浏览器找不到麦克风、PyTorch 动态库缺失报错以及海外镜像源拉取超时等现场高频问题提供根治方案。

Q1: 勾选“参考音频降噪增强”时提示 Could not load libtorchcodeclibavutil.so 缺失怎么办?

解答:这是 PyTorch 2.10 与 TorchAudio 强行引入 torchcodec 引起的经典底层依赖冲突。
torchcodec 底层需要动态链接操作系统的 C 共享库 libavutil.so.56/58。若尝试使用 sudo apt install ffmpeg,又容易因 Ubuntu 默认官方源未更换国内源而出现 Unable to connect to archive.ubuntu.com 的网络超时。

工程级有效解法:直接在 Python 业务层将音频读写逻辑与 torchaudio.load() 解耦,换用纯 Python 的 soundfile 回退机制。
src/voxcpm/zipenhancer.pysrc/voxcpm/model/voxcpm.py 中,将音频读取修改为如下安全模式:

1
2
3
4
5
6
7
8
try:
audio, sr = torchaudio.load(wav_path)
except Exception:
import soundfile as sf
import torch
data, sr = sf.read(wav_path, dtype="float32")
audio = torch.from_numpy(data)
audio = audio.unsqueeze(0) if audio.ndim == 1 else audio.t()

响度归一化保存同样采用 sf.write() 替代。该改造彻底移除了对外部 C 动态库的硬性要求,100% 在 uv 虚拟环境内部完成闭环。

Q2: 宿主机访问 WSL2 服务时提示找不到麦克风且没有任何授权弹窗怎么排查?

解答:这属于浏览器安全策略拦截。

  1. 确认访问地址使用 http://localhost:8808http://127.0.0.1:8808,避免使用 WSL2 内部虚拟 IP;
  2. 在浏览器 chrome://flagsedge://flags 中将该来源加入 Insecure origins treated as secure 白名单;
  3. 在页面按下 F12,通过控制台执行一次 navigator.mediaDevices.getUserMedia({ audio: true }) 手动唤醒浏览器的声卡驱动枚举接口。

Q3: 首次执行推理时出现数十秒停顿与警告是否正常?

解答:完全正常。首次调用时 PyTorch 会进行动态编译(compile_fx)并执行 10 步 Warmup 预热,以构建 GPU 算子图缓存。预热完成后,在 RTX 4090 上的单步生成速度可稳定在 21 it/s 以上,实时率(RTF)低至 0.3。


5. 总结与进阶拓展

通过轻量环境隔离与国内镜像源加速,完成 VoxCPM2 部署闭环,未来可结合 Nano-vLLM 进一步优化流式推理。

  • 核心要点回顾:环境初始化(uv sync) -> 权重镜像拉取(ModelScope SDK) -> 浏览器安全策略配置(Insecure Origin 豁免) -> 纯 Python 解耦改造(SoundFile 替代 TorchCodec);
  • 进阶探索方向
    1. 吞吐与延迟优化:在生产级服务部署场景下,建议引入社区提供的 Nano-vLLM 或官方 vLLM-Omni 推理后端,配合 PagedAttention 显存优化技术,可将实时率进一步压降至 0.13,满足超低延迟全双工语音交互需求;
    2. 多模态音画联合生成链路:若需将高保真克隆音频与视频大模型联合驱动,可参考前序实战 MiniMax-H3 NF4 视音频联合生成模型本地部署与调试,构建「文本输入 -> 声音克隆 (VoxCPM2) -> 动态画面驱动 (DiffSynth)」的多模态工程拓扑;
    3. 模型微调扩展:对于特定垂直领域样本的深度固化,可参考站内 Unsloth QLoRA 显存优化微调实战 的微调范式进行低秩适配。