作为一名后端研发,排查线上问题是我们日常工作中不可或缺,也最具挑战性的一部分。如果你仔细观察周围同事排查问题的过程,你就会发现一个现象:即便是在同一团队、负责同一模块的两个人,面对同一个线上问题,其定位问题的效率也可能天差地别。大部分人都认为是“工作经验”导致的差异,但实际上工作经验相仿的两个人,在排查同一个问题的过程中也会展现出差异。其实这背后隐藏的,是思维模式与方法的根本不同。
接下来我们将一起深入探讨造成这种效率差异的两个核心因素,最后提出一个系统性的框架,帮助我们从依赖直觉的“经验主义”,进化为一名数据驱动、逻辑严谨的“贝叶斯侦探”。
起点:万物皆有迹——程序的线性本质
要理解如何排查问题,我们首先要回归本源:程序是如何运行的?
本质上,无论我们的业务逻辑多么盘根错节,架构多么复杂,对于任何一个代码逻辑而言,其路径都是线性的,这本质上就是图灵机的运行模型。在图灵机模型中,我们可以把程序看作是一个读取输入、改变状态并产生输出的有限状态机。无论多复杂的程序,在任意时刻,它都只能处于一个确定的状态,并按照预设的规则转移到下一个状态。这意味着,即使是最复杂的系统故障,也有其发生的确定路径和原因。而我们排查问题的过程,其实就是一个逆向工程:根据问题发生后留下的“表象”(如错误日志、异常监控),反向追溯并重建出那条独一无二的、导致了错误的线性执行路径。
理论上,如果我们能拥有这条路径上每一行代码执行时的完整上下文信息,那么绝对能快速定位到问题根因。但这只是理论情况,在实际中在面对同一个问题的时候,每个人对系统的感知程度是不一样的,所以这里就引入了第一个差异点。
差异点一:信息获取的广度与深度
获取信息的多少,是决定排查效率的基石。我们可以用一个极限思维实验来理解这一点:假设你拥有“上帝视角”,能够看到故障发生时,每一行代码执行前后的变量状态、内存快照和线程上下文。在这种情况下,任何问题都将无所遁形。
但在真实的线上环境中,我们显然无法拥有这样的“上帝视角”。我们不能像在本地开发环境那样,随意暂停整个线上服务,进行单步Debug。线上的高并发、分布式特性,使得任何试图暂停系统的行为都可能引发灾难性的后果。
所以我们只能依赖一系列工具来逼近这个理想状态,构建我们对系统状态的认知:
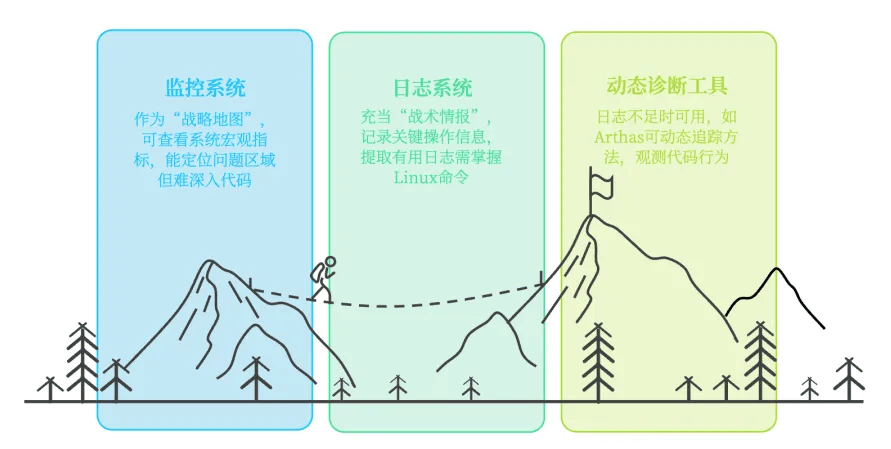
- 监控系统(Monitoring):这是我们的“战略地图”。通过各种监控工具,我们能看到系统级的宏观指标,如CPU、内存、网络IO、QPS、RT(响应时间)、错误率等。它能迅速告诉我们“哪个区域(服务/实例)可能出问题了”,但通常无法深入到代码细节。
- 日志系统(Logging):这是我们的“战术情报”。通过日志平台,我们可以看到由代码打印出的、更细粒度的信息。一条高质量的日志,记录了关键操作的输入、输出和重要状态变更,是我们还原执行路径最直接、最有力的证据。当然这里的前提是你核心日志需要打印得足够清晰,覆盖了关键信息。另外,从浩如烟海的日志中捞出自己想要的信息也是一个挑战,这里我非常建议大家熟练掌握各种linux命令。
- 动态诊断工具(Tracing/Profiling):当然在日志信息不足的情况下,我们依然可以借助Arthas这类可以动态注入字节码的工具。它们可以在不重启服务的情况下,动态追踪方法调用、观察入参和返回值、甚至修改内存中的对象状态。比如在Arthas的帮助下,我们可以观测到方法级粒度的代码行为,这个粒度仅次于单行Debug。
然而,悖论出现了。既然大家都在同一个公司,也都能使用相同的工具集,为什么排查问题的效率依然天差地别?这其实说明,拥有工具和善用工具是两码事。更重要的是,当信息不完整时,如何利用有限的信息进行高效推理。这就引出了问题的核心——第二个差异点。
差异点二:“经验”的科学解读
我们常常用“经验丰富”来形容一位排查问题高效的工程师。但“经验”到底是什么?它是一个难以量化、近乎“玄学”的概念。A同学比B同学经验丰富,到底“丰富”在哪里?
为了将这个模糊的概念变得具体、可学习,我们可以借助贝叶斯理论的框架来解构它。所谓的“经验”,本质上是一个内化于大脑的、关于系统故障的概率模型。 它主要由两部分构成:先验概率(Prior Probability) 和 似然度(Likelihood)。
这里我们先简单回顾下贝叶斯理论在贝叶斯理论中,我们通过先验概率和条件概率来推导后验概率。具体公式为:
P(H|E) = P(E|H) × P(H) / P(E)
其中,P(H|E)是后验概率,表示在观察到证据E后,假设H成立的概率;P(E|H)是似然度,表示假设H成立时观察到证据E的概率;P(H)是先验概率,表示在任何证据出现前,假设H成立的概率;P(E)是边际概率,表示证据E出现的总体概率。
提示:以下是用贝叶斯理论分析问题的具体示例,可能有些枯燥难懂。如果你想直接了解核心观点,可以略过这部分内容。
我们举个例子来说明:假设一个系统由模块A、模块B、模块C、模块D四个部分组成。现在,系统出现了一个异常,你需要确定是哪个模块出了问题。虽然大家可能没有明确意识到,但实际上你排查问题的过程就是一个贝叶斯推理过程。
先验概率 P(H)
这是在看到任何具体证据之前,我们对"根因"(Hypothesis, H)可能性的初步判断。这个判断基于历史数据、系统认知和过往经验。
- 模块A逻辑很简单,基本不会出错。P(A是根因) = 0.1。
- 模块B新代码,最近频繁变更,不太稳定。P(B是根因) = 0.3。
- 模块C是稳定的第三方服务,极少出问题。P(C是根因) = 0.1。
- 模块D是祖传屎山代码,逻辑复杂,历史上出过50%的故障。那么 P(D是根因) = 0.5。
这就是我们的先验概率。一个经验丰富的工程师,脑中已经有这样一张概率地图。他清楚地知道哪些模块是"事故多发地带",这种对系统现状的深入了解就是"经验"的核心部分。这里需要特别强调,人类与机器不同,我们往往会产生一些非理性思维。例如,在问题排查过程中,如果某个系统模块最近出过问题,我们容易高估该模块再次出问题的先验概率,这就是心理学上的"近因效应",这里需要尽可能克制下,因为我之前真遇到因某模块刚出过问题,就把当前所有故障都归因于它,结果排查方向错误浪费了大量时间。
似然度 P(E|H)
有了先验概率,我们只能推断出模块D更有可能是问题根因,但真的是这样吗?接下来,我们需要搜集更多证据来进一步明确问题的根源。以上面的例子来说,我们已经通过先验概率确定模块D的可能性最高,但这还不足以确定它就是根源。在贝叶斯思维中,每一个新的证据都是对我们概率判断的更新和修正。这就是"似然度"的实际应用。它表示"假设某个模块是故障原因时,我们观察到当前证据的概率"。简单来说,就是将假设与现有证据联系起来的桥梁。
例如,我们从日志系统中发现了一条重要线索:"数据库连接超时"。接下来,我们需要分析每个模块与这个证据之间的关联程度:假设我们通过日志系统,观察到了一个具体的证据E:"数据库连接超时"。现在我们需要评估各个模块与这个证据的关联强度:
- 模块A有少量数据库查询,但压力不大。P(观察到超时 | A是根因) = 0.1。
- 模块B也与数据库强相关,且最近有慢查询记录。P(观察到超时 | B是根因) = 0.8。
- 模块C主要与外部HTTP接口交互,很少直接导致数据库超时。P(观察到超时 | C是根因) = 0.05。
- 模块D业务复杂,数据库交互多。如果它出问题,很可能会有数据库超时报错。我们估计 P(观察到超时 | D是根因) = 0.6。
后验概率 P(H|E)
这才是我们决策的关键。它代表"在观察到证据E之后,某个根因H成立的概率"。根据贝叶斯公式,它正相关于 先验概率 × 似然度。(∝ 表示正相关于)
- P(A是根因 | 观察到超时) ∝ P(A是根因) × P(观察到超时 | A是根因) = 0.1 × 0.1 = 0.01
- P(B是根因 | 观察到超时) ∝ P(B是根因) × P(观察到超时 | B是根因) = 0.3 × 0.8 = 0.24
- P(C是根因 | 观察到超时) ∝ P(C是根因) × P(观察到超时 | C是根因) = 0.1 × 0.05 = 0.005
- P(D是根因 | 观察到超时) ∝ P(D是根因) × P(观察到超时 | D是根因) = 0.5 × 0.6 = 0.30
通过计算,我们会发现模块D是概率最高的"嫌疑人",其次是模块B。模块A和C的嫌疑较低,我们可以优先排查模块D和B,而不是按照模块A、B、C、D的顺序依次排查。当然实际情况下, 仅一个数据库超时还是无法精确定位到问题的根因,所以我们要继续发掘一些新的证据,来更新我们的后验概率,更准确地推断问题所在。
处理新证据:贝叶斯更新
如果我们收集到一个新的证据F,贝叶斯理论允许我们持续更新我们的概率估计。这时我们可以将上一步得到的后验概率作为新的先验概率,再次应用贝叶斯公式:
P(H|E,F) = P(F|H,E) × P(H|E) / P(F|E)
其中:
- P(H|E,F)是在观察到证据E和F后,假设H成立的概率;
- P(F|H,E)是在假设H成立且已知证据E的情况下,观察到证据F的概率;
- P(H|E)是我们之前计算的后验概率,即在只观察到证据E时,假设H成立的概率;
- P(F|E)是在已知证据E的情况下,观察到证据F的边际概率。
继续我们之前的例子,假设我们发现一个新的证据F:"模块B的CPU使用率异常飙高"。此时,我们需要评估在各个模块可能是根因的情况下,观察到这一现象的概率:
- P(观察到CPU飙高 | A是根因,已知数据库超时) = 0.1
- P(观察到CPU飙高 | B是根因,已知数据库超时) = 0.9
- P(观察到CPU飙高 | C是根因,已知数据库超时) = 0.2
- P(观察到CPU飙高 | D是根因,已知数据库超时) = 0.3
现在,我们可以更新我们的概率判断:
- P(A是根因 | 超时,CPU飙高) ∝ P(A是根因 | 超时) × P(CPU飙高 | A是根因,超时) = 0.01 × 0.1 = 0.001
- P(B是根因 | 超时,CPU飙高) ∝ P(B是根因 | 超时) × P(CPU飙高 | B是根因,超时) = 0.24 × 0.9 = 0.216
- P(C是根因 | 超时,CPU飙高) ∝ P(C是根因 | 超时) × P(CPU飙高 | C是根因,超时) = 0.005 × 0.2 = 0.001
- P(D是根因 | 超时,CPU飙高) ∝ P(D是根因 | 超时) × P(CPU飙高 | D是根因,超时) = 0.30 × 0.3 = 0.09
最后我们发现模块B的概率大幅提升,成为最可能的问题根源。 简而言之,我们排查问题的过程就是在不断的积累新的证据,然后借助贝叶斯理论来调整我们的判断,最终收敛到最可能的答案。
从上述例子与分析中,我们可以看到贝叶斯理论如何系统化地指导我们排查问题。通过贝叶斯框架,我们能更清晰地认识到问题排查中常见的思维误区。这并非否定经验本身的价值,而是提醒我们要警惕那些忽视当前证据、过度依赖固有认知的思维定势。
- 新手:通常缺乏系统性认知,没有明确的先验概率,只能逐个模块随机排查。
- 固有思维者:可能因为上周刚处理了模块A的问题,形成了"模块A容易出问题"的强烈认知。即使看到"数据库超时"这个明显指向其他模块的证据,也会优先排查模块A,浪费宝贵时间。
- "贝叶斯侦探":能够结合先验知识(如模块A的历史问题)和新收集到的证据("数据库超时"更指向模块B),动态更新自己的判断,计算各种可能性的后验概率,然后按照概率从高到低高效排查。
这,就是效率差异的根源。高效的排查者,是一位直觉敏锐的“贝叶斯侦探”。
如何提升效率:成为一名“贝叶斯侦探”
理论已经讲完,现在让我们探讨如何提升排查问题的能力。我直接说几个可以通过刻意练习来提高排查效率的具体方法:
- 构建并维护你的“先验知识库”
- 熟悉系统架构:深入理解服务的依赖关系、数据流向和关键链路。
- 梳理历史故障:分析历史上哪些模块频繁出现故障,这些故障有什么共同模式,从而建立系统故障的先验概率分布。
- 理解代码与业务:熟悉你负责模块的核心逻辑、边界条件和潜在风险点。
- 精通信息搜集,提升“似然判断”的准确性
- 工具熟练度:不仅要会用监控、日志、Arthas等工具,更要理解它们各自的适用场景和局限性。
- 学会提问:排查问题时,要不断地向自己和系统提问:问题影响范围多大?是所有用户还是部分用户?最近有什么变更?(发布、配置修改、流量变化),这些问题的答案都是帮你修正似然度的关键证据。
-
形成假设、验证、迭代的闭环
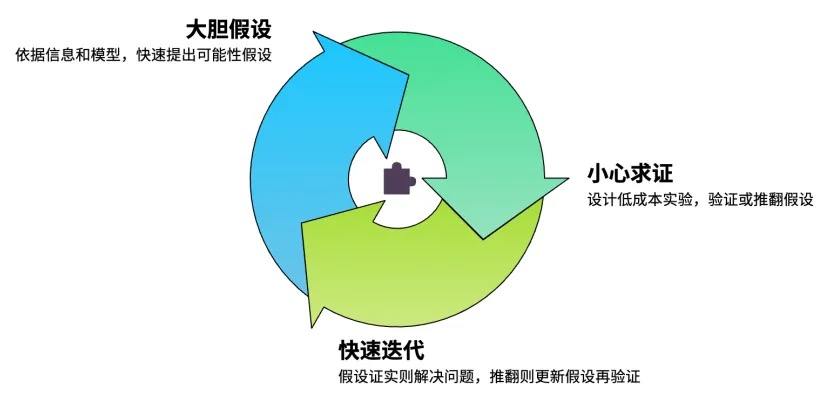
- 大胆假设:基于初步信息和你的概率模型,快速形成一个可能性最高的假设(“我认为是模块B的数据库连接池满了”)。
- 小心求证:设计一个成本最低、速度最快的实验来验证或推翻你的假设(“去监控看板看模块B的连接池使用率,或者用Arthas查看连接池对象的状态”)。
- 快速迭代:如果假设被证实,问题解决。如果被推翻,不要恋战。刚刚的求证过程本身又为你提供了新的证据,用它来更新你的概率模型,形成下一个最可能的假设,然后继续验证。
结语
线上问题的排查,不全是纯靠经验,而是一门融合了系统知识、工具运用和科学思维的艺术。其效率的高低,取决于我们能否超越零散的个人经验,建立起一个结构化的、基于概率的思维框架。通过有意识地构建我们的“先验知识”,磨练信息获取和分析的能力,并遵循“假设-验证”的迭代循环,我们每个人都能从一名凭直觉摸索的“工兵”,成长为一名运筹帷幄、直击要害的“贝叶斯侦探”。
最后我还想说的是当我们把视角放得更广时,就会发现贝叶斯方法的应用远不止于线上问题排查。实际上,在各种需要决策的场景中,贝叶斯思维都能帮助我们避免仅凭直觉做决策的陷阱。无论是产品规划、投资决策还是人生选择,其实我们都是不不断地结合先验概率与实时证据,推断出最合理的解决方案,进而做出最优决策。这种思维方式不仅适用于技术问题排查,更是一种能够应用于生活各个方面的科学决策框架。
声明:本文含AI辅助创作