







你有没有想过,一张静态的照片,配上一段音频,就能变成一段“对嘴”的视频?不是简单的口型同步,而是让图片中的人物“活过来”,仿佛真的在说话、唱歌、甚至表演。
这听起来像是科幻电影里的场景,但其实,这样的技术已经在我们身边悄然实现了。
之前已经介绍过一些类似项目的搭建:
今天要介绍的这个开源项目 —— fantasy-talking,就是这样一个神奇的存在。它能让你上传一张图片和一段音频,自动生成一段“对嘴”的视频,效果之逼真,令人惊叹。
这篇文章,我们就来一起看看这个项目的魅力所在,以及它是如何做到“让图片开口说话”的。
fantasy-talking 是一个基于深度学习的开源项目,旨在实现将静态图片与语音音频结合,生成一段看起来像是人物在“说话”的视频。项目代码托管在 GitHub 上,目前已有不少开发者关注和贡献。
它的核心思想是通过语音驱动模型,生成与语音内容匹配的面部动作(尤其是嘴巴动作),再结合原始图片中的人物面部结构,生成一帧帧动态画面,最终合成一段视频。
简单来说,只要你有一张正面清晰的人脸照片,和一段你想让他“说”的语音,这个项目就能帮你生成一段“他”在说话的视频。
如果你对这个项目感兴趣,不妨亲自搭建一下试试看。以下是大致的搭建流程:
克隆仓库
git clone https://github.com/Fantasy-AMAP/fantasy-talking.git
虚拟环境搭建
我的环境是window中的Anaconda
生成虚拟环境:(第一次)conda create -n fantasy-talkings python=3.10
生成虚拟环境:(第一次)
conda create -n fantasy-talkings python=3.10
激活:
conda activate fantasy-talkings
#安装依赖:
pip install -r requirements.txt
#下面这个是gpu加速的,我在window没有安装成功
#pip install flash_attn

如果直接使用pip install flash_attn安装失败,可以试试下面的方法:

1:下载whl文件:https://huggingface.co/lldacing/flash-attention-windows-wheel/tree/main

2:找到跟你pip show torch 和 python版本对应的whl下载

3:安装:
pip  install  flash_attn-.....whl
模型下载
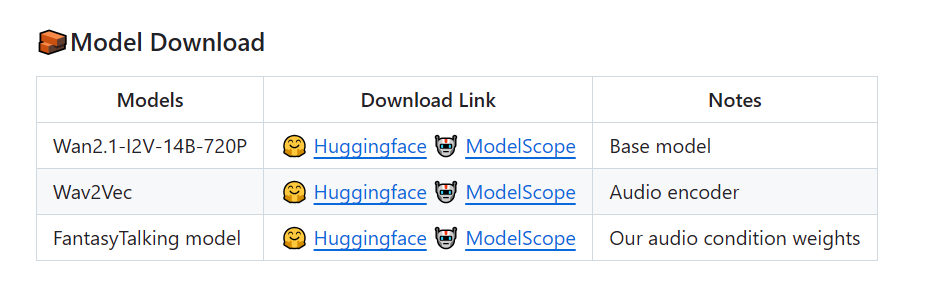
特别是第一个模型,非常的大。下载后存放到相应位置:
 ./models/Wan2.1-I2V-14B-720P。

 ./models/wav2vec2-base-960h。

 ./models
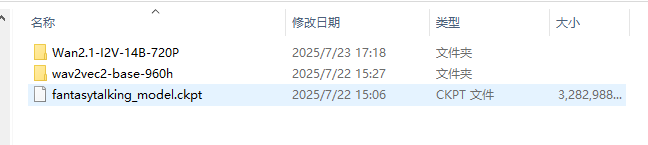
可以手动下载,也可以cli下载:
   pip install "huggingface_hub[cli]"
   huggingface-cli download Wan-AI/Wan2.1-I2V-14B-720P --local-dir ./models/Wan2.1-I2V-14B-720P
   huggingface-cli download facebook/wav2vec2-base-960h --local-dir ./models/wav2vec2-base-960h
   huggingface-cli download acvlab/FantasyTalking fantasytalking_model.ckpt --local-dir ./models
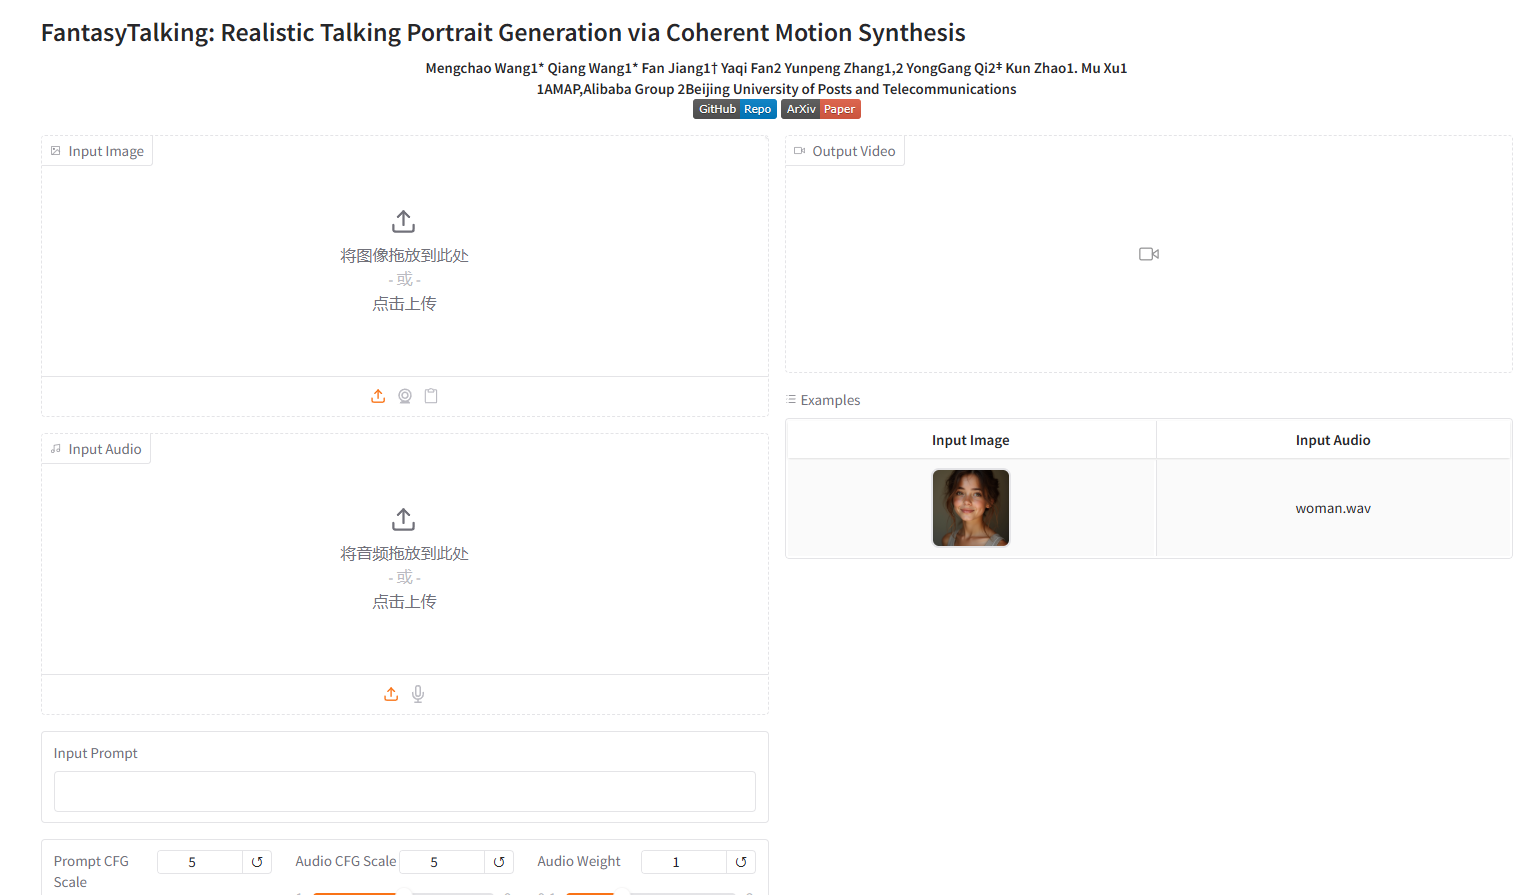
运行项目
pip install gradio spaces
python app.py
查看结果
上传你的图片和音频,等待一段时间后,查看生成的视频。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。