惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Blog — PlanetScale
Blog — PlanetScale
Vercel News
Vercel News
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
量子位
Y
Y Combinator Blog
IT之家
IT之家
博客园 - 聂微东
L
LangChain Blog
爱范儿
爱范儿
H
Help Net Security
GbyAI
GbyAI
F
Fortinet All Blogs
B
Blog
Microsoft Security Blog
罗磊的独立博客
C
Check Point Blog
博客园 - 三生石上(FineUI控件)
小众软件
小众软件
D
DataBreaches.Net
Last Week in AI
Last Week in AI
WordPress大学
WordPress大学
B
Blog RSS Feed
酷 壳 – CoolShell
酷 壳 – CoolShell
宝玉的分享
宝玉的分享

博客园 - Joy_CShow

搭建OpenClaw实现钉钉 AI 员工自动化 (二) 搭建OpenClaw实现钉钉 AI 员工自动化 (一) fantasy-talking:实现图片加音频生成对嘴数字人 window中搭建wsl环境 图片对嘴生成视频:HunyuanVideo-Avatar 音频克隆:对话文本到口语对话生成MOSS-TTSD 图片生成对嘴视频FLOAT 开源AI工具-文字生成图片Fooocus 文生图:介绍一个文字生成图片的开源工具 音频克隆阿里版-CosyVoice 音频克隆-Index-TTS进阶版(ComfyUI_IndexTTS)可以实现多人对话 文字生成视频开源AI大模型项目 音频克隆-Index-TTS 视频音频对嘴--Wav2Lip 音频克隆-GPT-SoVITS 自己写了一个视频拆分工具 本地搭建一个对嘴AI工具 搭建一个图片变视频的AI(二):开始搭建 搭建一个图片变视频的AI(一):模型介绍
本地搭建一个图片对嘴转视频工具-进阶版
Joy_CShow · 2025-07-02 · via 博客园 - Joy_CShow

上一章介绍了通过ComfyUI_Sonic模型实现图片+音频导出视频的图片对嘴的模型搭建,今天介绍一个进阶版(带表情的)。

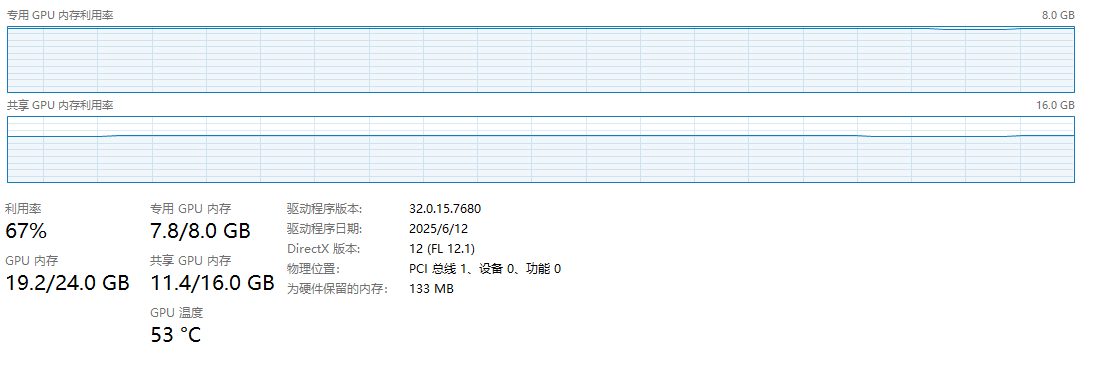
1:官方要求的是GPU:20GB或更多 VRAM 的 GPU ,我的是8G的GPU,能运行起来,就是生成速度慢些。

2:代码下载。

下载地址:https://github.com/toto222/DICE-Talk

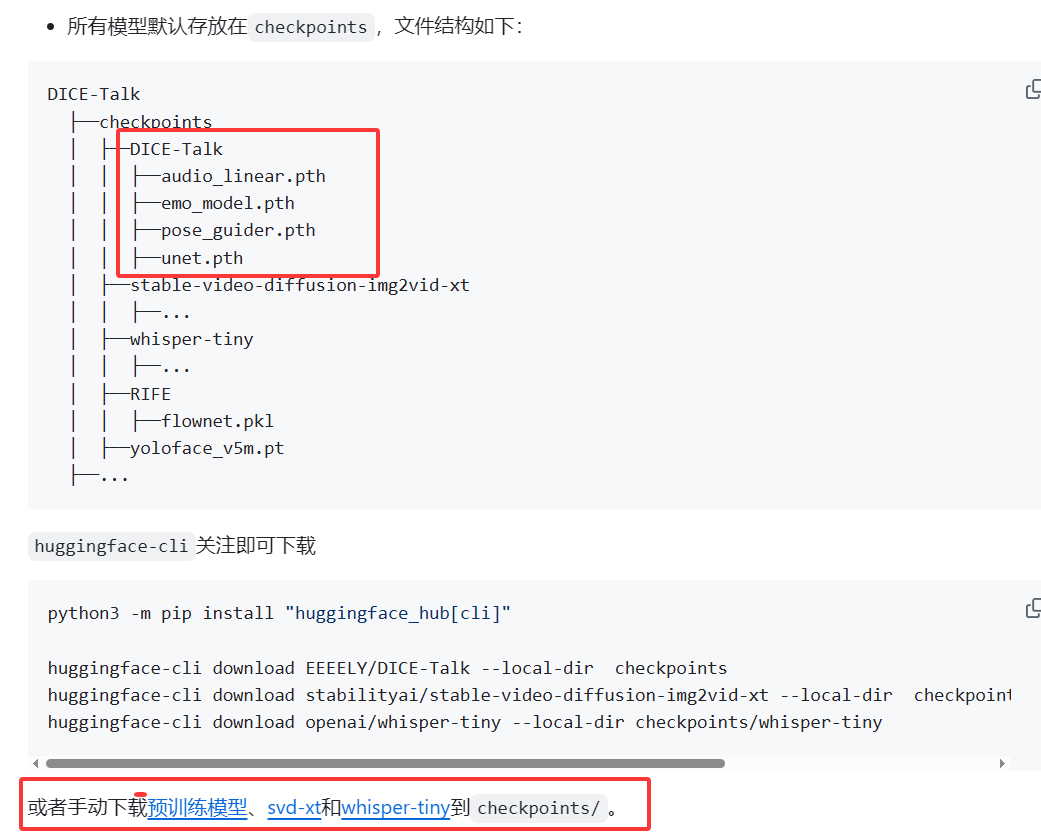
 下载解压后,去下载模型,跟前一章的ComfyUI_Sonic模型只有一个不一样,其他的可以直接复制过来就行。

模型下载: pretrain modelsvd-xt and whisper-tiny  

3:安装,先直接运行就行

 python .\gradio_app.py 

如果报错,借助AI,差什么包,就安装什么包就行。

4: 使用

启动成功后,浏览器访问:http://127.0.0.1:8081/
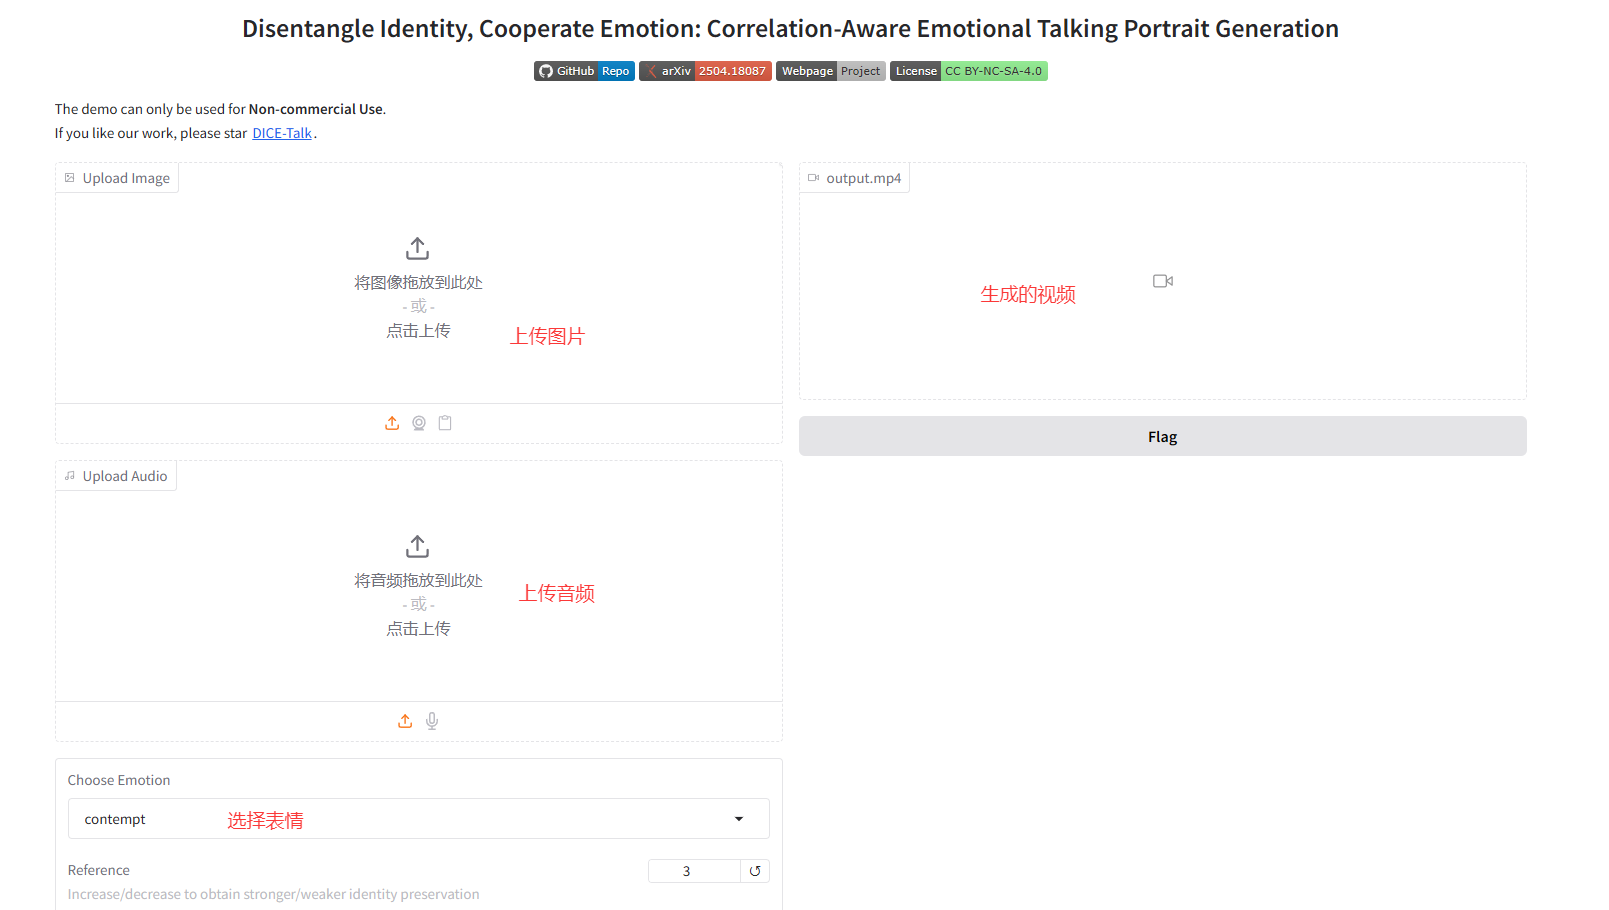
下面是官方提供的一些表情例子:
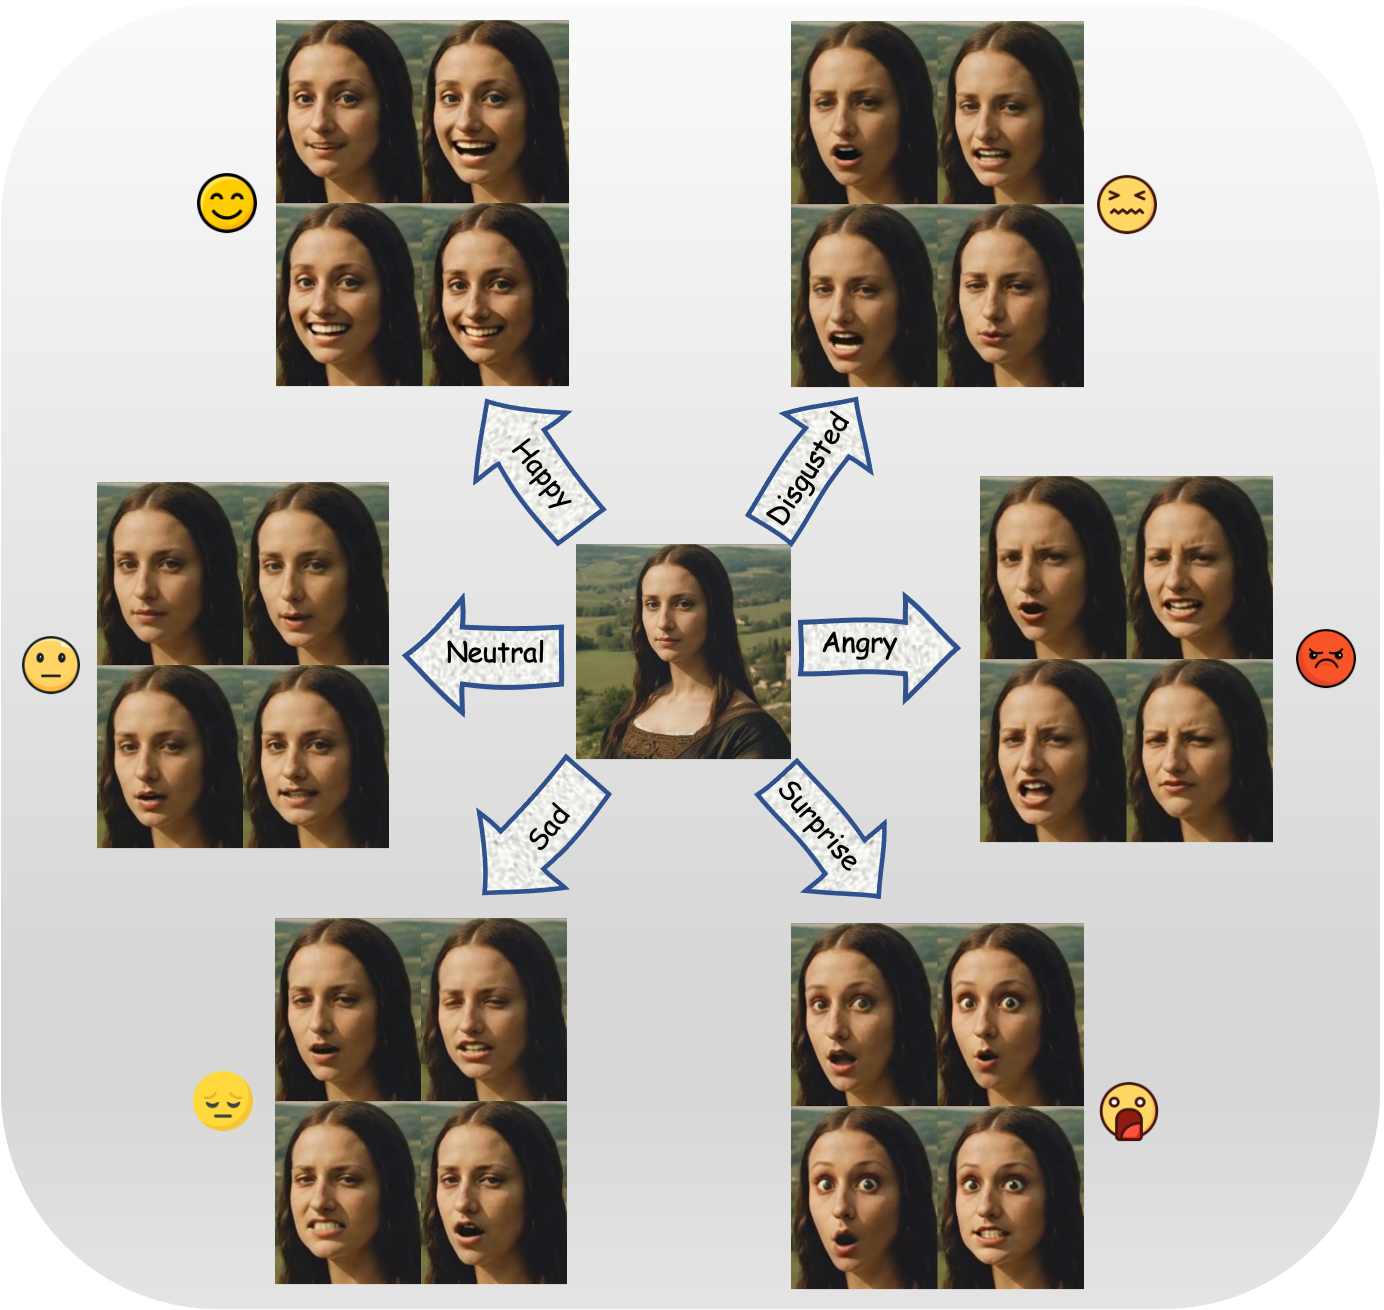
5:生成

如果你的电脑GPU比较大,那生成的速度应该是比较快的,等待视频生成后。

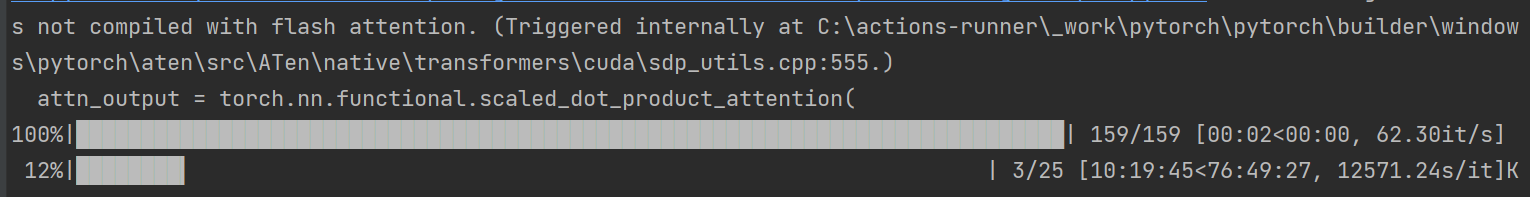
 我的8G的GPU根本不够用,13秒音频一晚上都没生成完。噗~。
介绍一个音频克隆:https://github.com/RVC-Boss/GPT-SoVITS