








之前几章有相应的介绍,一张图片和一个音频,生成一段对嘴视频。
本章在介绍一个类似的可以项目,我的8GPU电脑没有跑起来~。
这是一个非常先进的 “单样本说话人视频生成” (One-shot Talking Avatar) 项目,在数字人生成领域引起了广泛关注。
GitHub 地址: https://github.com/Tencent-Hunyuan/HunyuanVideo-Avatar
简单来说,HunyuanVideo-Avatar 的核心功能是:仅需一张包含人物全身或半身的照片和一段音频,就能生成一个高质量、动作自然、口型同步的说话视频。
这里的关键词是 "One-shot" (单样本),意味着你不需要为特定人物录制几分钟甚至几小时的视频来进行模型训练,大大降低了生成数字人视频的门槛。它生成的不再是简单的“大头贴”式说话视频,而是包含自然头部姿态和身体动作的 全身 (full-body) 视频。
该项目的技术基于一篇名为 《HunyuanVideo-Avatar: One-shot Talking Avatar with Attentive Cross-modal Diffusion》 的学术论文,代表了腾讯在视频生成和数字人领域的前沿研究成果。
高质量与高分辨率:
单样本驱动 (One-shot):
全身视频生成 (Full-body Generation):
精准的音唇同步 (Accurate Lip-sync):
自然的动作与表情 (Natural Motion & Expression):
代码和模型开源 (Open Source):
HunyuanVideo-Avatar 的技术框架非常精巧,主要采用了一个 两阶段(Two-stage) 的生成流程:
对于开发者来说,在本地运行该项目的大致步骤如下:
git clone https://github.com/Tencent-Hunyuan/HunyuanVideo-Avatar.gitrequirements.txt 文件安装所有依赖库。# 1. Create conda environment conda create -n HunyuanVideo-Avatar python==3.10 # 2. Activate the environment conda activate HunyuanVideo-Avatar # 3. Install PyTorch and other dependencies using conda # For CUDA 12.4 conda install pytorch==2.4.0 torchvision==0.19.0 torchaudio==2.4.0 pytorch-cuda=12.4 -c pytorch -c nvidia # 4. Install pip dependencies python -m pip install -r requirements.txt # 5. Install flash attention v2 for acceleration (requires CUDA 11.8 or above) python -m pip install ninja python -m pip install git+https://github.com/Dao-AILab/flash-attention.git@v2.6.3
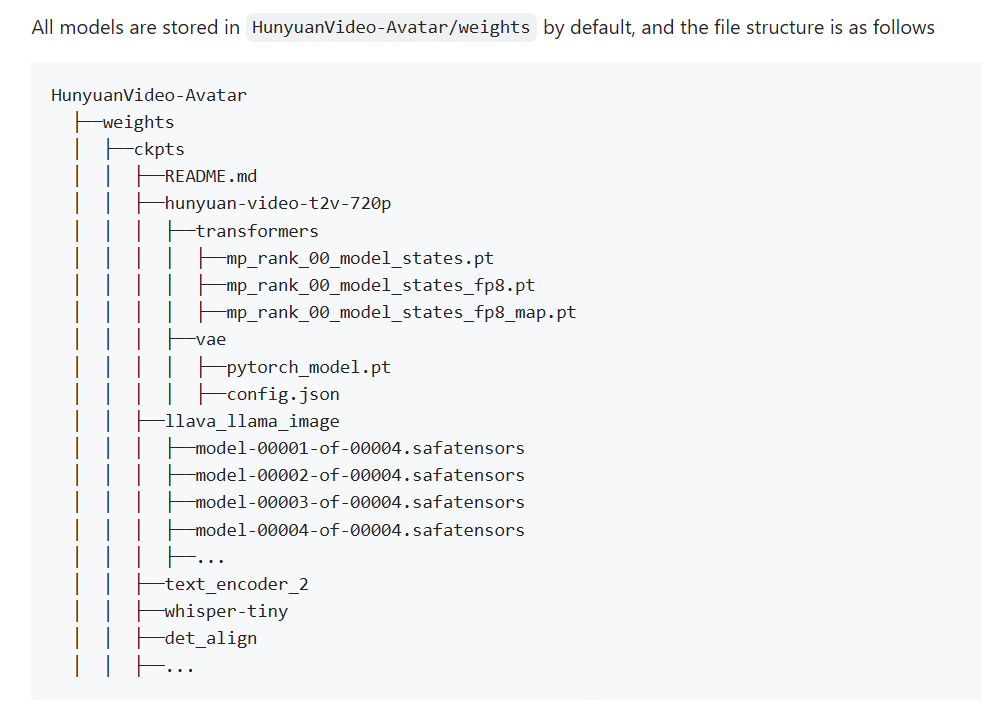
模型下载后放到 HunyuanVideo-Avatar/weights/文件夹下
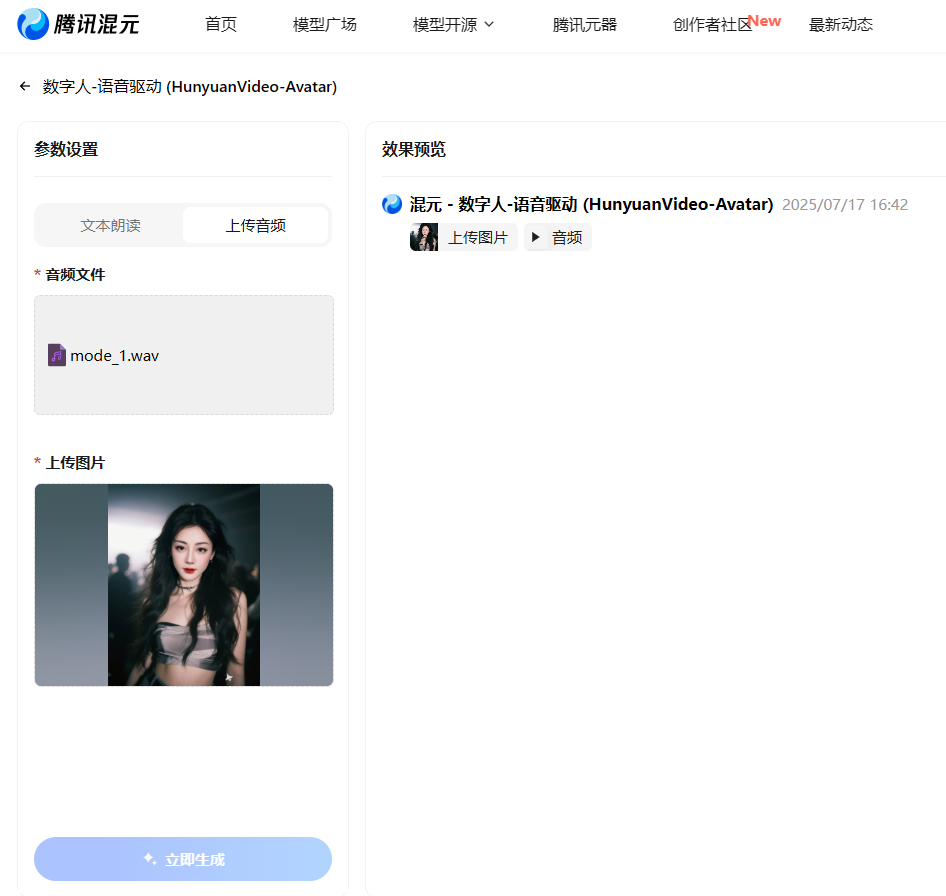
.wav 或 .mp3)。 运行: cd HunyuanVideo-Avatar bash ./scripts/run_gradio.sh
我的电脑8GPU,跑不起来,这里使用的是官方的UI截图。
这项技术有着广阔的应用前景:
HunyuanVideo-Avatar 是一个里程碑式的开源项目,它将高质量、全身、单样本的说话人视频生成技术带给了更广泛的开发者社区。它不仅展示了腾讯在 AI 生成内容(AIGC)领域的强大实力,也为数字人技术的普及和应用铺平了道路。如果你对 AI 视频生成、数字人技术感兴趣,这个项目绝对是值得学习和研究的典范。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。