







TL;DR:LittleLearner 实验把“模型是真会还是背过”变成了可控问题:研究者把预训练语料限制在小学(K–5)概念范围,再观察能否悟出范围之外的高阶知识。2026 年 8 月 13 日提交的论文显示,扩大模型、强化学习和上下文示范都能把能力推向边界之外,但结论限于最高 5B 参数模型与数学、事实问答,不能外推为所有模型的普遍定律。
大型语言模型读过的网页太多,我们很难判断一项能力究竟是后来学会的,还是预训练时已经见过,只是直到某个提示或任务出现才被调用出来。
LittleLearner 试图把这个问题变成可控实验。研究者先限制预训练语料中的概念范围,再观察扩大模型、强化学习和上下文示范能否把能力推到训练范围之外。
视频版(B站) | 音频版(6 分 50 秒)| Spotify 订阅 | 偏好阅读?文字版就在下方
LittleLearner 不是让模型扮演十一岁儿童。研究者从 FineWeb-Edu 中构造了一个 88B-token 语料库 LittleCurriculum,用美国幼儿园到五年级课程标准作为概念、词汇和推理要求的代理边界。
他们从头训练了 0.6B、1.3B 和 5B 三种规模的 LittleLearner,并为每种规模准备匹配的 Unfiltered 对照。两组模型使用相同架构、token 数和训练方法,主要区别是预训练语料有没有经过 K–5 过滤。
项目页面把它称为“只知道五年级学生知道的内容”,但论文里的严谨含义是“预训练暴露经过课程范围过滤”。网页文本、模型学习方式和真实儿童教育都远比这句宣传语复杂。
过滤过程分为多个阶段:
这类过滤不可能直接证明“零泄漏”。作者做了两项独立检查:在 WeeBit 外部年级语料中,过滤器保留了 6,000 篇高年级文本的 2.48%;人工复查后,只有 3 篇明确包含越界概念,相当于 0.05%。研究者还扫描了 126 个来自课程标准的高阶 n-gram,在保留语料中的匹配率为 0.09%。
这些结果支持“泄漏被限制得较低”,不能解释成所有高级概念都已被彻底清除。公开数据集仍然来自网页语料,存在抓取噪声、普通叙事和难以按年级归类的内容。
真实儿童会通过视觉、动作、社交、提问和长期记忆不断获得新信息。LittleLearner 则在 88B token 文本上训练,采用与现代语言模型类似的架构和优化方式。
“K–5”在这里是一把控制预训练暴露的实验尺子,不是对儿童发展顺序的复制。模型可能会做好某些表面上更难的计算,却不会真实孩子熟悉的生活技能;遇到不知道的问题时,它也不一定会像孩子那样承认不知道。
项目页面还明确说明,这是学术研究产物,没有为儿童使用做安全对齐。它不应被当作儿童教育助手。
LittleLearner 在范围外问题上并不总是输出随机乱码。论文展示了一个典型例子:面对“薛定谔的猫”,受限模型把它解释成一只“有两张脸的猫”。
论文作者认为,模型会把陌生概念投射到预训练中熟悉的模式,生成结构完整但事实错误的说明。它知道怎样组织一段像答案的文字,却缺少回答所需的概念背景。
这项观察提醒我们,流畅度不能证明知识真实存在。模型在知识边界外仍可能自信回答,因此“不知道何时不知道”也是需要单独评估的能力。
研究者比较了 0.6B、1.3B 和 5B 三种规模。模型变大后,K–5 范围内表现明显提高;在与小学算术结构仍有重叠的六、七年级问题上,也出现有限迁移。
到了八年级数学,三个规模的 LittleLearner 都接近性能地板。作者据此认为,在这组模型和任务中,扩大参数主要提高了训练暴露范围内的能力,没有显著扩展到更远的范围外内容。
这不等于“模型规模永远无法产生新能力”。作者在结论中提醒,5B 为了学术可行性而设,远小于前沿模型;某些上下文学习或涌现行为可能在这个规模上并不明显。
论文采用两阶段后训练:先做监督微调,再使用 GRPO 强化学习。LittleLearner 分别尝试 K–5 数据和不受年级限制的数据,Unfiltered 对照组也使用匹配训练。
在论文测试的预算中,后训练明显增强了 K–5 能力,范围外表现只得到有限改善。即使 LittleLearner 在 GRPO 阶段接触更高年级问题,仍没有追上拥有开放预训练语料的对照模型;两种 LittleLearner 后训练数据之间也没有观察到明显差异。
作者的结论是,跨过这道差距需要比当前 GRPO 设置更基础的变化。这里的限定词很重要:它只描述论文测试的算法、数据、任务和训练预算,不证明所有强化学习方法都无法引入新能力。
研究者还给 5B LittleLearner 提供人工编写的自然语言解题示范。K–5 准确率从 34.0% 增加到 36.8%,Beyond-K–5 则从 6.0% 变为 5.9%。
示范会改变输出长度、格式和表达方式,却没有提升范围外推理。论文把这种现象解释为 elicitation:提示把已有能力更好地调用出来,并没有在测试过程中补上预训练时缺失的知识。
上下文学习的结论同样有边界。它只适用于论文测试的 few-shot 和 explanation 提示、5B 模型及 MathCAMPS 任务。
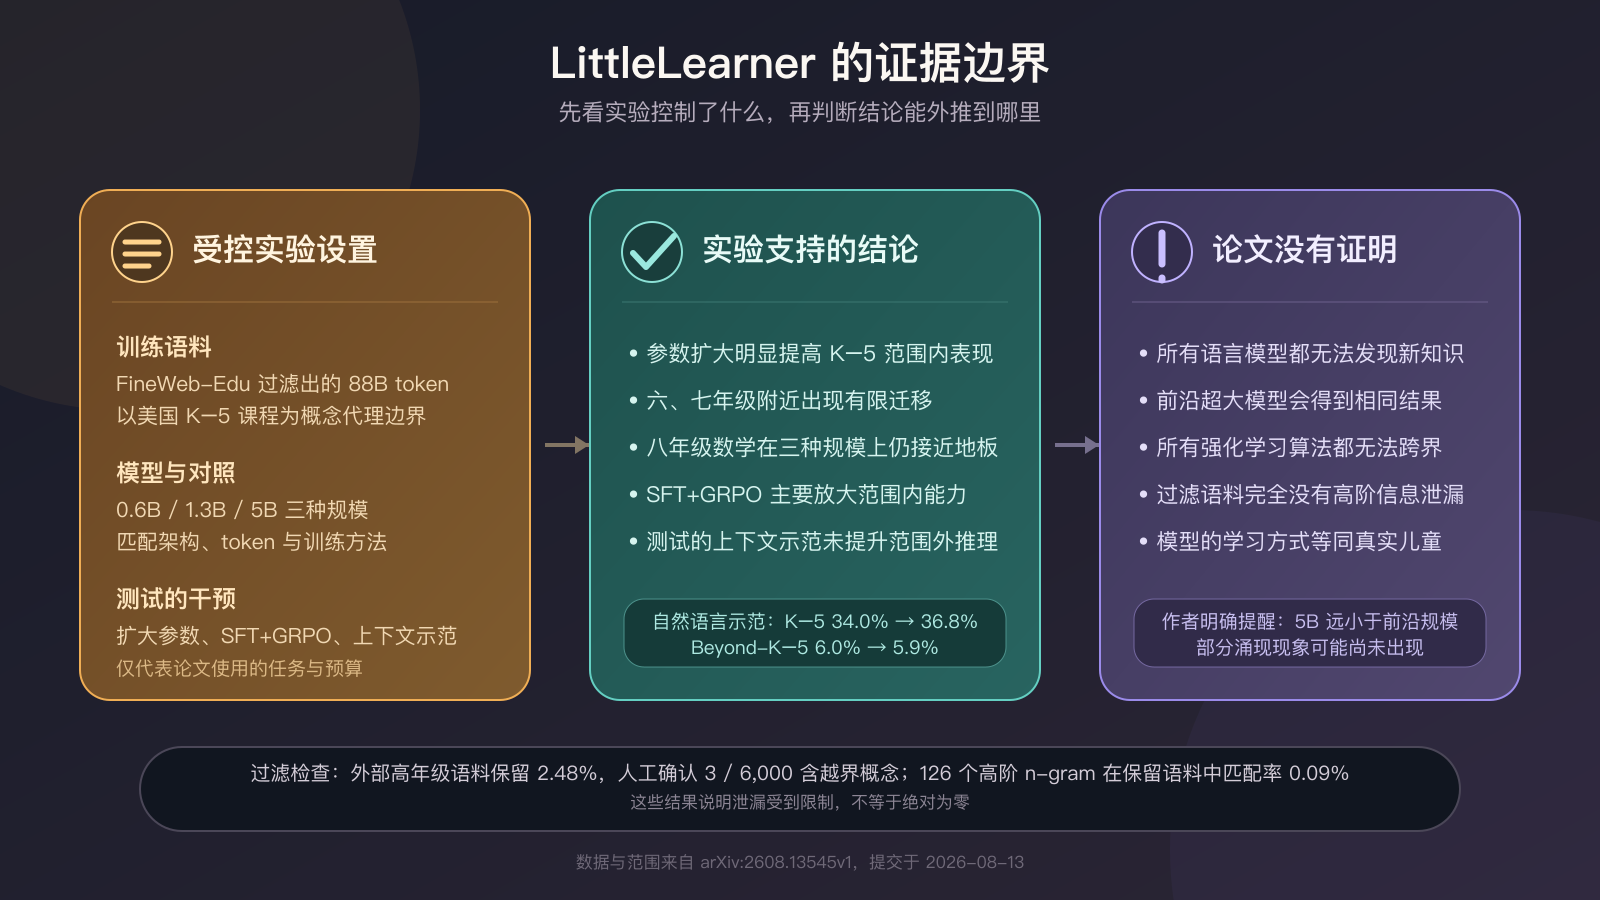
图中数值来自论文 v1。支持结论仅适用于论文测试的模型、数据、任务与训练预算。
论文支持的核心判断是:在这组受控实验里,参数扩展、SFT+GRPO 和上下文示范主要放大了预训练已经支持的能力,范围外迁移有限。
论文没有证明语言模型只能复述训练数据,也没有证明前沿模型、其他任务或未来学习算法会得到相同结果。过滤检查说明越界暴露较少,但不能排除所有泄漏。
Hacker News 上关于“模型为什么偶尔说出高阶术语”“它不像真实五年级儿童”的质疑,适合用来检查实验边界。单次在线对话不能推翻完整对照实验,也不能代替对数据集泄漏和任务设计的系统审计。
LittleLearner 提供了一个预训练暴露相对可追踪的实验环境。研究目标并不是让模型永远停在小学范围。
研究者可以逐步加入负数、代数或新的事实,观察模型学习速度、遗忘和干扰;也可以测试检索、外部记忆、自我探索、多 Agent 协作和新的奖励机制,区分新信息来自哪里。
普通网页规模模型的训练语料难以完整知道。当模型解出一道新题时,我们很难判断它是在组合旧知识、调用隐含记忆,还是获得了真正新的能力。受控语料不能直接回答这个大问题,却让研究者能够设计更清楚的实验。
本文由《听懂 AI》第 009 期整理而成。节目主要来源是 Fanfei Li、Jana Zeller、Manuel Prada-Corral 等作者于 2026 年 8 月 13 日提交的论文《LittleLearner: Language Models Under Pedagogically Controlled Knowledge Exposure》及项目页面。论文当前为 arXiv v1,研究的是最高 5B 参数模型、特定 K–5 过滤语料、数学与事实问答,以及有限的后训练和提示设置;本文不会把结果外推为所有语言模型的普遍定律。
资料说明:本文讨论的是控制预训练暴露的研究方法,不提供教育、儿童发展或模型安全建议。LittleLearner 是研究产物,不是儿童心智模拟,也没有面向儿童使用做安全对齐。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。