








TL;DR:ARC Prize 于 2026 年 9 月 3 日公布,GPT-6 Astra 在 ARC-AGI-3 Semi-Private 的标准框架中以
max推理强度取得 62.7%、成本 26,098 美元;在保留不透明推理状态并使用上下文压缩的 Provider Adapter 中,high强度取得 99.9%、成本 18,817 美元。两项结果都是真实榜单成绩,但测试框架和推理强度都不同,不能把 99.9% 当作无条件的“AGI 百分比”。ARC Prize 明确表示,跑满这一封闭、确定、目标有限的测试不等于证明实现 AGI。
一个接近满分的数字,为什么反而需要读更多脚注?因为智能体评测不只测模型,还测它怎样保存状态、使用工具、消耗 token,以及测试框架替它做了哪些工作。
029 期讨论的重点不是给“AGI 是否到来”投票,而是理解两套成绩各自回答什么问题。发布文章时,我们又核对了 ARC Prize 原文和官方 OpenAI 文档,补上当前产品信息与推出范围。
视频版(B站) | 音频版(6 分)| Spotify 订阅 | 偏好阅读?文字版就在下方
标准框架给所有供应商相同的最小接口。模型可以选择把可见笔记带到后续请求,但状态保存主要由模型自己负责。ARC Prize 认为,这种方式适合做跨供应商比较。
Provider Adapter 则允许调用模型供应商提供的上下文管理能力。Astra 的适配器会在请求之间保留测试方不可见的推理状态,并通过 compaction 管理较长对话。因此,这套结果更接近“模型加上供应商运行系统”的表现。
两个问题都有价值:标准框架问共同接口下的能力有多强;适配框架问整套产品系统最多能做到什么。用后一项成绩回答前一个问题,才会产生误导。ARC Prize 原文
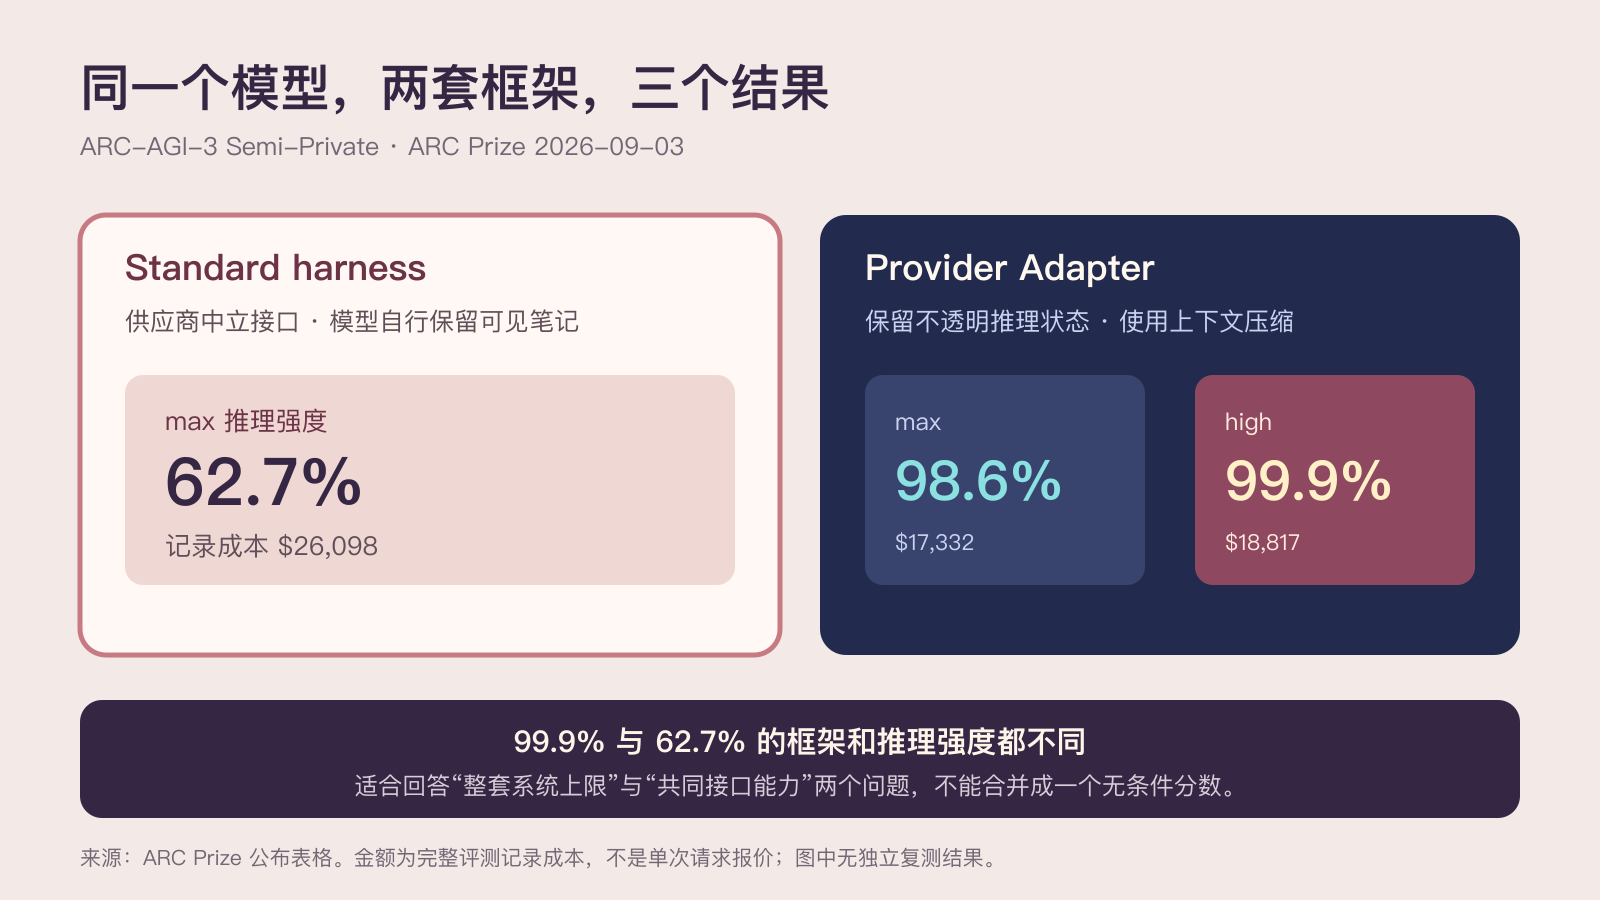
图:ARC-AGI-3 Semi-Private 公布结果。99.9% 使用 high,62.7% 使用 max;两者不是相同推理强度的直接对照。
ARC Prize 给出了不同推理强度下的完整表格。三行最能说明问题:
| 运行方式 | 推理强度 | 分数 | 记录成本 |
|---|---|---|---|
| Standard | max | 62.7% | 26,098 美元 |
| Provider Adapter | max | 98.6% | 17,332 美元 |
| Provider Adapter | high | 99.9% | 18,817 美元 |
所以,99.9% 不是“max 模式的最佳结果”,最低成本也不在最高分那一行。ARC 的解释是,更高推理强度有时会用更少动作解决游戏,从而减少模型调用和 token;但这只是该评测里的成本关系,不保证真实业务也同样变化。
评测支出也不是购买一次 API 请求的价格,而是整批关卡运行的记录成本。对自己的应用,更应计算一次通过验收的任务成本,把重试、工具调用和人工检查都算进去。
ARC Prize 用约 500 名普通参与者建立人类基线,并以完成某一关的人类动作数中位数作为比较。Provider Adapter 下,Astra max 在其完成关卡的 96% 中使用更少动作,平均少 51.7%。
这说明一旦形成有效世界模型,Astra 在这些抽象环境中往往能高效执行。但人类参与者能够解决全部环境,而 96% 的分母是 Astra 已完成的关卡。它证明的是特定测试中的动作效率,不是“96% 的现实任务超过人类”。
ARC 还观察到 Astra 会把陌生环境整理成紧凑符号、规则和行动计划。这里的“临时语言”是测试回放中可见的速记,不是已经确认的机器意识或秘密通信协议。
一次请求结束后,下一次请求知道多少前情,会直接影响长任务。可见笔记便于检查,但模型要自己决定写什么;供应商保存的不透明推理状态可能保留更多连续性,外部评测者却更难知道具体保留了什么。
ARC 报告还称,在两套框架共同解决的 167 组“游戏—推理强度”结果上,Provider Adapter 聚合记录时间约快 3.66 倍,总 token 少 49%。这是交集上的系统对比,不是所有关卡的通用加速比。
因此,部署长任务时应把记忆与压缩策略列入评测配置。否则,同一个模型名称在不同会话管理方式下得出的成绩,很难互相解释。
LessWrong 作者 Rauno Arike 根据媒体报道分析,Astra 可能使用沿网络深度重复计算的 looped transformer。他也强调,关键问题是实际串行深度、循环次数是否容易扩大,以及更多隐藏计算会不会削弱推理监控。LessWrong 分析
截至 2026 年 9 月 5 日,本文查到的官方 OpenAI 模型页和使用指南没有披露 Astra 的具体网络架构、循环次数或“神经语”。因此,文章只把循环架构写成第三方报道与讨论,不能据此断言内部推理已经无法监控。
ARC 中的“不透明推理状态”描述的是 Provider Adapter 在请求之间保留什么,也不能单独证明模型内部采用何种网络架构。运行时状态与模型结构是两个问题。
ARC-AGI-3 让智能体在陌生、抽象、回合制环境里探索、推断目标、建立世界模型并执行计划。它比静态问答更接近“学习怎样做事”。
但这些环境仍然封闭、确定且目标有限。现实工作包含模糊需求、变化中的组织、不可逆操作、他人利益和无法完整观察的后果。一个系统能高效解开陌生游戏,不代表它能自动承担现实世界的全部判断责任。
ARC Prize 自己也明确表示,Astra 是通用化能力的重要进步,但没有宣称它就是 AGI。这是阅读 99.9% 时最重要的边界。
节目封面。独立头图为两套评测框架的概念插画,不是模型内部结构图。
OpenAI 官方模型页当前列出 gpt-6-astra:上下文窗口 1,050,000 token,最大输出 128,000 token,普通输入、缓存输入和输出每百万 token 分别为 10、1 和 50 美元;超过 272K 输入的请求采用更高费率。官方 OpenAI 模型页
使用指南称 Astra 正从 Trusted Access Program 企业开始推出,API 及 Plus、Pro、Business、Enterprise 方案将在随后开放。这里的“随后开放”不等于任意账号此刻已经获得权限,也不应凭文档推测具体到账时间。官方 OpenAI 使用指南
官方文档还列出了 persisted reasoning、compaction、computer use 和 misalignment monitoring 等能力。这些产品特性可以解释系统为何适合长任务,但不能替 ARC 的标准框架分数加分,也不能证明模型在开放现实环境中可靠。
CNBC 报道称,OpenAI 将 Astra 视为首个达到其内部“Critical”网络安全能力门槛的模型,并在此前安全事件后增加防护。这个等级和事件关系属于媒体对公司发布会的转述,不是本文独立评估。CNBC 报道
当前官方 OpenAI 模型目录把 Astra 列为旗舰通用模型,同时把 Daybreak Red 列为需单独批准的高级网络安全模型别名。两者不能因为都涉及安全能力就视为同一个产品。官方模型目录
对使用者来说,模型在安全基准上更强,不会扩大目标授权。漏洞分析、验证修复、生成利用程序和访问生产系统必须分别管理权限。测试模型防护的同时,还要限制网络、凭据、文件范围和不可逆操作。
内部评测至少应保存模型版本、推理强度、上下文管理、工具、最大步数、超时、重试策略和每次任务成本。若用了供应商特有的持久状态或压缩,还应单独报告共同接口下的结果。
这样可以同时回答两个问题:如果未来更换模型,公共框架里的任务还能完成多少;如果继续使用当前供应商,完整系统能达到什么效果。
GPT-6 Astra 的 ARC-AGI-3 表现值得重视,因为它展示了陌生环境中的快速建模和高效行动。但离“AGI 已经得到证明”仍差着评测范围、现实开放性和责任边界。数字越接近满分,测试条件越不能省略。
本文由《听懂 AI》第 029 期访谈整理而成,核对日期为 2026 年 9 月 5 日。ARC 分数、成本、动作效率和测试条件来自 ARC Prize;OpenAI 产品规格及推出范围使用官方 OpenAI 文档。网络安全发布由 CNBC 转述,循环架构来自媒体消息与 LessWrong 分析,均不写成官方已披露架构。Simon Willison 与 Hacker News 只作为外部解读和社区观察。本文未复跑 ARC-AGI-3,也不把封闭环境成绩外推为 AGI 证明。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。