








TL;DR:2025 年 6 月的 Bartz v. Anthropic 法院命令确认,Anthropic 买入数百万本纸书,拆除装订、裁页扫描,并在生成内部数字副本时丢弃纸本;法院把这批一对一格式转换判为合理使用。2026 年 7 月最终获批的 15 亿美元和解覆盖 482,460 部从 LibGen、PiLiMi 等盗版数字库获取的作品,并不是对纸书销毁本身的赔偿。Anna's Archive 所称“多家 AI 公司正在销毁稀有书、可能毁掉最后一本”仍缺少公开的库存与馆藏证据。
“AI 公司在毁书”既不是纯粹谣言,也不是目前能无限外推的行业事实。公开法院记录清楚证明了 Anthropic 的破坏性扫描流程;但从“一家公司销毁所购纸本”跳到“多家公司正让稀有知识永久消失”,中间还缺书目、版本、其他馆藏和数字副本访问情况。
这场争议其实包含三个不同问题:文字内容有没有被保存,纸质版本有没有被保存,数字副本能不能由公众访问。把三者混成“书还在不在”,很容易让事实和价值判断一起失焦。
视频版(B站) | 音频版(7 分 09 秒)| Spotify 订阅 | 偏好阅读?文字版就在下方
2025 年 6 月 23 日,Bartz v. Anthropic 的简易判决命令描述了 Anthropic 建立中央研究库的过程。Anthropic 买入数百万本纸书,由公司或供应商拆除装订、把书页裁成适合机器处理的尺寸,再扫描成数字文件;每生成一份数字副本,就丢弃对应纸本。
法院材料把这项工作与内部的 Project Panama 联系起来。项目在 2024 年启动,由曾参与 Google Books 合作业务的 Tom Turvey 负责采购和物流,目标是快速建立高质量书籍语料库。
法院记录还指出,这些扫描件留在 Anthropic 的研究库或通用数据区,没有证据显示公司把由所购纸书转换来的数字副本提供给外部。
法院面对的是版权复制问题,不是文化遗产评估。法官认为,Anthropic 合法购买每一本纸书,再用一份内部数字副本替代它;纸本被丢弃后,没有额外增加可流通副本数量。法院把这种一对一格式转换视为合理使用。
这不等于美国法律要求扫描后必须销毁纸书,也不等于任何批量扫描都自动合法。裁决依赖本案事实:纸书已购买、数字副本替代实体副本、扫描件没有对外展示或销售,最终用途还包括训练模型。
法院同时把“训练模型使用书籍”和“建立永久中央数字库”分开分析。训练用途被认为具有高度转换性;购买纸书后的格式转换也获支持。另一条盗版数字书获取路径则没有得到同样处理。
《听懂 AI》第 015 期节目封面。节目提出保存风险,本文进一步区分法院事实与 Anna's Archive 的单方判断。
Anthropic 还从 LibGen、PiLiMi 等影子图书馆获取了数百万本盗版数字书。2025 年的命令认为,单纯为了建立可长期保留的中央库而取得盗版副本,不属于合理使用;这部分原本将继续审理。
双方随后达成 15 亿美元集体诉讼和解。2026 年 7 月 20 日,法院给予最终批准。最终命令记录,作品清单包含 482,460 部作品,截至 2026 年 4 月 16 日已有 440,490 部被申领;每部约 3,000 美元是扣除费用前的估算。
和解处理的是清单作品的历史盗版下载与复制主张。它还要求销毁相应的盗版数据集副本,但不覆盖未来行为或 AI 输出主张。把这笔和解称为“Anthropic 因毁掉纸书支付 15 亿美元”是不准确的。
装订书页在高速进纸扫描器中难以保持平整。切除书脊后,散页可以连续送入机器,速度快、人工少,也更容易获得统一图像。对于大批普通二手书,这是成熟的工业数字化方法。
无损扫描需要书托、压平玻璃、翻页机构或更多人工,尤其是脆弱装订和特藏版本。它通常更慢、更贵,但具体差距取决于纸张、装订、成像标准、OCR、元数据和处理规模。
Anna's Archive 客座文章和 HN 评论中出现了“无损扫描贵十倍”的说法,公开材料没有提供一组可审计的统一报价。这个数字可以解释行业直觉,不能作为所有项目的固定成本倍率。
Anna's Archive 文章认为,企业销毁纸书可以避免竞争对手扫描同一批资料,也可以减少法律风险,并把高质量的 2022 年前文本锁进私有服务器。这些是文章作者给出的动机解释。
法院命令证明了采购、拆书、扫描、丢弃和内部保存,没有认定 Anthropic 销毁纸书是为了阻止竞争对手。裁决对一对一格式转换的分析,确实让丢弃实体副本具有版权法上的意义;但这仍不同于“企业故意消灭公开知识”的事实认定。
同样,文章声称多家 AI 公司都在这样做,却没有公开逐家公司、逐项目的合同或库存。现有可靠材料足以讨论 Anthropic,不足以把流程归于整个 AI 行业。
如果一本畅销书有大量副本,销毁其中一本不会让文字内容消失。二手书商、出版社和图书馆本来也会因仓储成本、破损和缺乏需求而处理大量普通书籍。
如果是小印量、绝版、地方出版物、技术手册或带批注的特殊版本,实体副本可能承载数字文本之外的信息。纸张、装订、版次、插图质量、藏书章和读者批注,都可能具有研究价值。
目前公开材料没有给出 Project Panama 的完整书目,也没有证明它销毁了某本书的最后已知副本。HN 上对 1930 年至 2000 年间未数字化小众书籍的担心值得图书馆关注,但仍是保存风险假设,不是已经确认的损失清单。
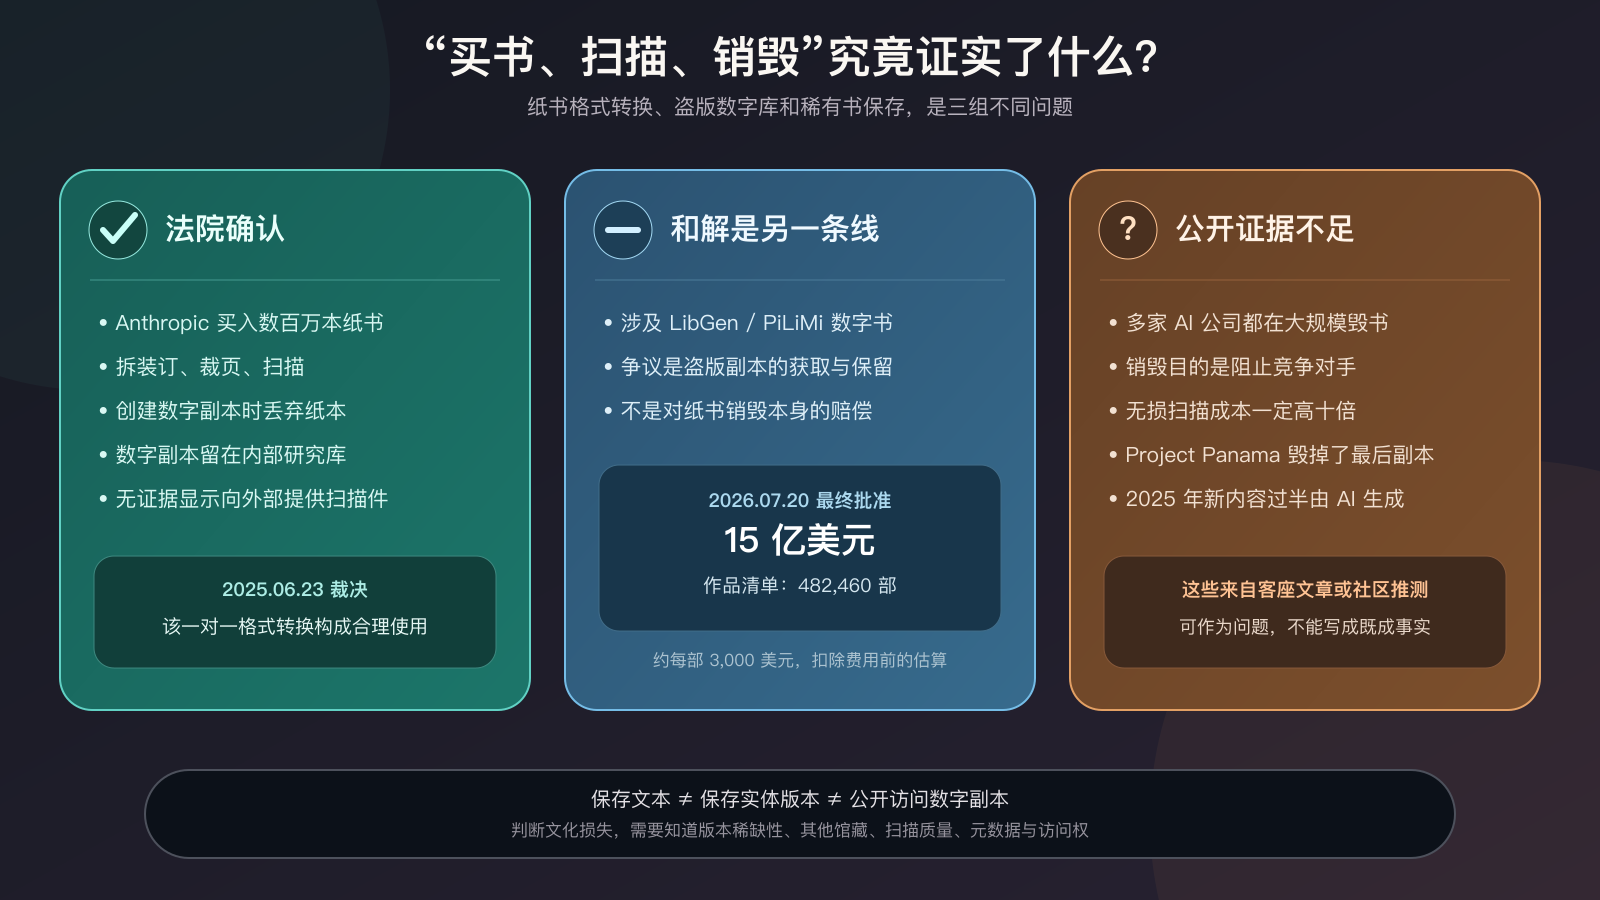
图中依据 2025 年法院命令、2026 年最终和解命令及 Anna's Archive 客座文章整理。
第一层是法院确认的事实:Anthropic 买书、拆书、裁页、扫描、丢弃纸本,数字副本留在内部。
第二层是独立的盗版数字库争议:15 亿美元和解已获最终批准,覆盖明确的作品清单,不是对纸书销毁定价。
第三层是仍待证实的广泛判断:多家公司是否普遍执行破坏性扫描,是否为了排除竞争,是否毁掉最后副本,以及 2025 年后网络新内容是否过半由 AI 生成。引用这些说法时必须保留来源属性。
Anthropic 的数字副本意味着文字可能仍存在于内部系统,但公众未必能检索或阅读。实体书被丢弃后,物理版本及其附带信息也无法从私有文本文件中完全恢复。
反过来,把扫描件公开上传到影子图书馆,可能保存访问,却会带来版权侵权问题。Anna's Archive 在文章结尾号召一千万名志愿者扫描上传,并提供会员或费用支持;它本身是利益相关方,这个号召不能被包装成无争议的公益方案。
更稳妥的公共保存路径包括:与图书馆或档案馆合作,优先数字化公共领域和获得许可的作品;对稀有版本采用无损扫描;记录版本、来源与实物去向;建立可检索的馆藏登记,让企业在采购前检查稀缺性;为仍受版权保护但已经绝版的作品设计集体许可和受控访问。
企业不必公开训练语料全文,也能提高可问责性:
争议最值得留下的,不是“AI 吃掉了所有书”这个画面,而是一套可以验证的问题:买了哪些版本,毁了哪些实体,其他地方还有没有,数字副本由谁控制,公众何时能够访问。
本文由《听懂 AI》第 015 期整理而成。Anna's Archive 原文是志愿者署名、由中文翻译的客座文章,作者与平台都支持影子图书馆,并在文末招募扫描上传者;其跨公司动机、成本倍率、稀有书损失和网络 AI 内容占比均作为单方说法处理。本文补充 2025 年 Bartz v. Anthropic 法院命令和 2026 年最终和解命令,状态更新至 2026 年 9 月 3 日。
资料说明:本文不建议上传或传播仍受版权保护的扫描件,也不构成法律意见。原 Anna's Archive 页面在本次整理时从当前网络环境无法直连,标题与正文通过搜索索引和公开镜像交叉核对。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。