





前言
DPO的形式很简单,最终是在一个偏好对数据上进行直接训练
不再显式训练 Reward Model,也不需要 PPO 的强化学习过程,而是直接利用偏好数据优化语言模型。最终的优化目标为:
但这个式子怎么来的呢?实际上是从PPO中推导过来的
PPO 在 RLHF 中的优化目标的推导
RLHF-PPO中,最终的优化目标为:
其中:
:当前训练策略 :reference model :reward :KL 惩罚系数
PPO 本质上是在优化这个目标。
接下来我们一步步推导
代入:
转换成最小化:
因为:
所以
因此:
可以写成:
这里这个形式是不是很像一个KL散度?,如果是KL散度,我们不就找到了新的优化目标?但:
并不是合法概率分布。
因为:
所以需要归一化。这个就是一个对原始概率分布分配了权重的权重系数。所以归一化只需要将分配了权重系数的概率都加起来作为分母就可以了。
所以令分母为
其中:
表示遍历所有可能回答 。于是:
其中是一个概率分布。
代入后:
由于:与当前 policy 无关,是常数。所以可以不管
最终优化目标变成了:
当KL最小时:
因为
这个策略是由决定的。也就是说:如果我知道 reward,那么理论上的最优 policy 应该长什么样。但是我不想训练 Reward Model,我就没有一个现成的 可以用。
但是也是通过数据训练得来的,我们能不能通过推导,把reward消掉,让我们要优化的策略和原始的数据直接建模产生联系?从而避免了训练reward model这个过程。
并且
而在大语言模型里, 表示的是完整回答序列。可能的 数量极其庞大,实际上几乎不可能把所有回答都枚举出来,因此 很难直接计算。所以这里有两个需要解决的问题。我们继续往下:
所以
左右取 log,并移项,得到
说明 reward 可以由 policy 与 reference policy 的概率比表示。
Reward model是怎么训练的?
Reward model的目标是找到符合人类偏好的句子,所以他的数据是成对的偏好数据对,instruct GPT原文用的是对K个回答排序,和成对数据有所不同,但目的一样,目的都是训练模型对于两个或者多个prompt能够知道人类更喜欢哪些。
这里以偏好数据对为例
数据格式为:
偏好数
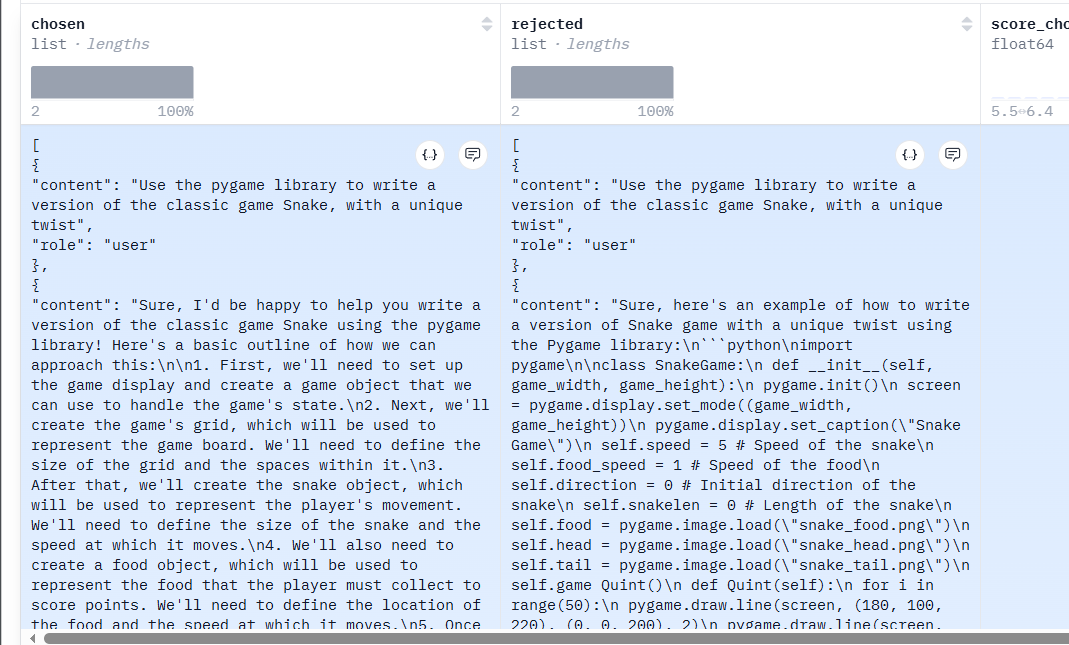
可以看到一个chosen 另一个rejected。
也就是说:
其中:
:chosen response :rejected response
而reward model的优化建模为Bradley-Terry 模型:
Bradley-Terry 模型假设一个回答被偏好的相对强度与其 reward 的指 成正比,因此对两个回答的强度归一化后,就得到 softmax 形式的偏好概率。
上下同除,得到:
可以看到这就是一个二分类模型,
将 上边的
代入
可以看到被消掉了
而且还正好是reward_model的优化目标,reward 本身也被 policy 与 reference policy 的 log-ratio 完全表示。
上边的问题就解决了
注:这里的 并不是实际训练过程中已经得到的模型,也不是通过
直接计算出来的。
只是前面从 KL-Regularized RLHF 目标中推导出的理论最优策略,用来描述“最优 policy 应该满足什么关系”。
实际训练时,我们使用参数化策略 去逼近这个未知的最优策略:
然后直接利用偏好数据优化 。
因此将 参数化为 后:
接下来只需要最大化偏好数据的 likelihood,即可得到最终的 DPO Loss。
总览
流程:
Preference Data
        |
        v
 Direct Preference Optimization
        |
        v
 Updated Policy
特点:
不需要 Reward Model 不需要 rollout 不需要 value model
DPO将RLHF转化成了类似SFT的offline偏好优化过程,所以他的训练方式也很简单,只要准备好数据,改一下损失函数,就可以用类似SFT的方式训练,并且ref_model的数据都可以提前准备好,之后训练时直接读取 reference log-prob
TRL库的DPOTrainer
DPOTrainer这个类都没有train()这个方法,他走的是原始Trainer的train()方法:
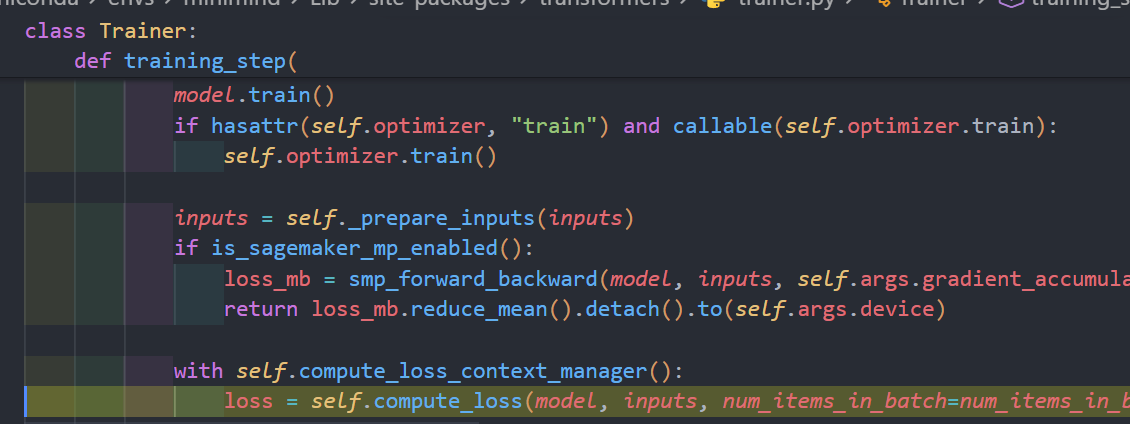
只是在计算损失的时候会跳到DPOTrainer.compute loss:
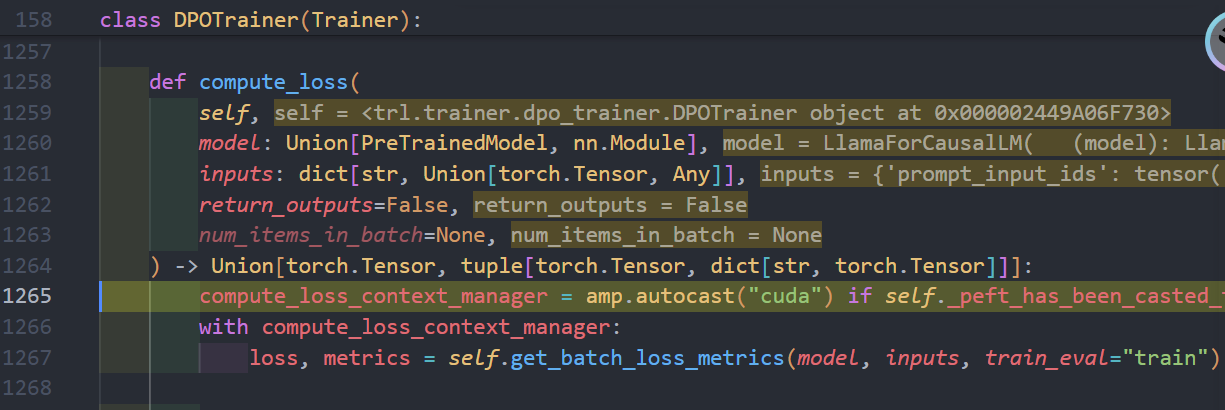
所以 DPO 训练起来确实比较友好,整体范式和 SFT 非常相似,都是基于固定数据集进行 epoch 式训练:forward、计算 loss、backward、更新参数。
但它又不是普通的监督学习,因为它保留了 RLHF 里的核心思想:通过 reference policy 约束策略不要偏移过远,同时利用人类偏好信号推动 policy 朝更优方向移动。