

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

雷峰网
雷峰网
aimingoo的专栏
aimingoo的专栏
云风的 BLOG
云风的 BLOG
Microsoft Security Blog
Vercel News
Vercel News
The GitHub Blog
The GitHub Blog
T
The Blog of Author Tim Ferriss
Microsoft Azure Blog
U
Unit 42
IT之家
IT之家
D
DataBreaches.Net
Y
Y Combinator Blog
B
Blog RSS Feed
F
Fortinet All Blogs
GbyAI
GbyAI
V
Visual Studio Blog
博客园 - 叶小钗
Google DeepMind News
美团技术团队
L
LangChain Blog
N
Netflix TechBlog - Medium
G
Google Developers Blog
Recent Announcements
T
Tailwind CSS Blog

博客园 - lmqljt

推荐系统公开课 王树森 讲解工业界真实的推荐系统 LangChain教程,langchain快速入门, Agent智能体rag项目实战 火山图 差异分析等 箱线图 拓展(缺口箱线图)等 时序分析通用基础模型:TimesNet 预测/插补/分类/异常检测 PatchTST:通道独立的时序Transformer 扩散模型Difussion 随笔 大论文题目类参考 注意力机制创新思维分析 热力图 以分类为例 02 国际象棋入门快易精 初级下法 棋子杀王 SCI拒稿重投 torch.manual_seed(seed)用法及注意事项 make_classification函数 杂志审稿人打分表参考 python+matplotlib绘图线条类型和颜色选择 Sobol全局灵敏性分析 np.transpose(),torch.permute(),tensor.permute() DTW(动态时间规整)算法原理与应用 第2期 分布迁移下的深度学习时间序列异常检测方法探究 2021-09-22
多尺度时序间相关性:MSGNet
lmqljt · 2025-07-08 · via 博客园 - lmqljt

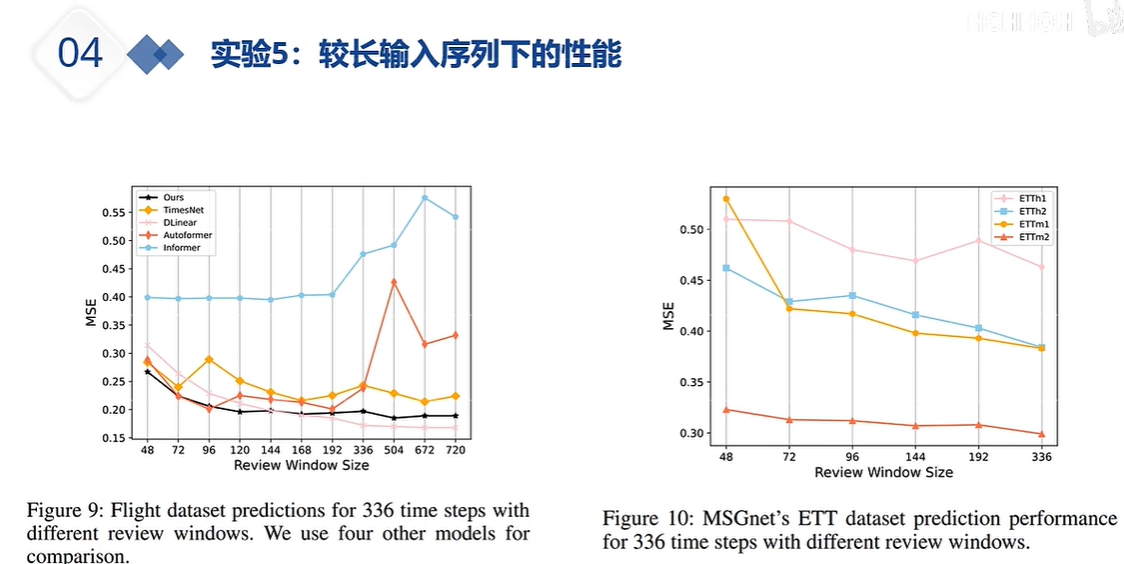
DLinear的出现就是为了质疑注意力机制系列的能力,注意力机制系列在预测时,如果输入的嗯史数据过长,那么其预测未来的性能会变差。

上图可以看出,随着历史数据窗口的增加,基于注意力机制的那些former系列模型,会随着输入历史数据的长度,效果逐渐变差,而黑色线段代表的作者的模型及Dlinear模型,都是逐渐变得效果更好。

上图中右图 则说在不同的数据集上,作者的模型随着历史数据的长度增加,预测效果变得更好。