


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

aimingoo的专栏
aimingoo的专栏
宝玉的分享
宝玉的分享
博客园 - 【当耐特】
博客园 - 司徒正美
L
LangChain Blog
有赞技术团队
有赞技术团队
大猫的无限游戏
大猫的无限游戏
Stack Overflow Blog
Stack Overflow Blog
Engineering at Meta
Engineering at Meta
U
Unit 42
Microsoft Azure Blog
I
InfoQ
博客园 - 叶小钗
H
Hackread – Cybersecurity News, Data Breaches, AI and More
J
Java Code Geeks
月光博客
月光博客
量子位
让小产品的独立变现更简单 - ezindie.com
博客园_首页
Last Week in AI
Last Week in AI
人人都是产品经理
人人都是产品经理
Google DeepMind News
云风的 BLOG
云风的 BLOG
D
DataBreaches.Net

博客园 - 12不懂3

IOC容器 分布式锁 分布式事务 Myql索引篇+c#性能优化篇 jwt验证机制 HttpHelper .net7.0 .net升级7.0报错1. MySqlConnection is already in use. See https://fl.vu/mysql-conn-reuse 2.SqlSugar.SqlSugarException: Cannot Open when State is Connecting. 3.The current TransactScope is already complete Windos Elastocsearch安装部署汉化 Mysql C# Common中心目录 ABP.VNET 原书籍《Effective C#:改善C#代码的50个有效方法》 精炼18点 ABP IO读写+Epoll多路复用,计算机底层解析 c# 技术点总结 kuberspere管理工具+k8s安装 K8s核心组件理解 数据库事务和锁
ElasticSearch
12不懂3 · 2022-11-15 · via 博客园 - 12不懂3

视频学习地址:https://www.bilibili.com/video/BV1LF411j7rm/?p=8&spm_id_from=pageDriver&vd_source=12d06e602c3462c026d1a4781241f2d4

 倒排表:有存储 就会有数据量大的问题,怎么去解决数据量大的问题:1.压缩大数据变成小数据(压缩算法) 2.如何存数据让查询更快(数据结构)

如图 posting LIst 匹配到了100w条的数据

倒排表算法_Frame Of Referenct压缩算法 :适用稠密数组

倒排表存储结构为有序数组 所以现在有了100w的int, 1个int类型占用4个字节 100W就是3.8MB的数据 这还只是匹配一个 如果100w的原始文本 每个文本差不多相同 所以拆分出来的词项匹配都相同 

每一个原始数据都会被拆分成词项  如果原始数据为100Wt条 因为拆分里面的词 可能会导致 倒排表的数据比原始表还多
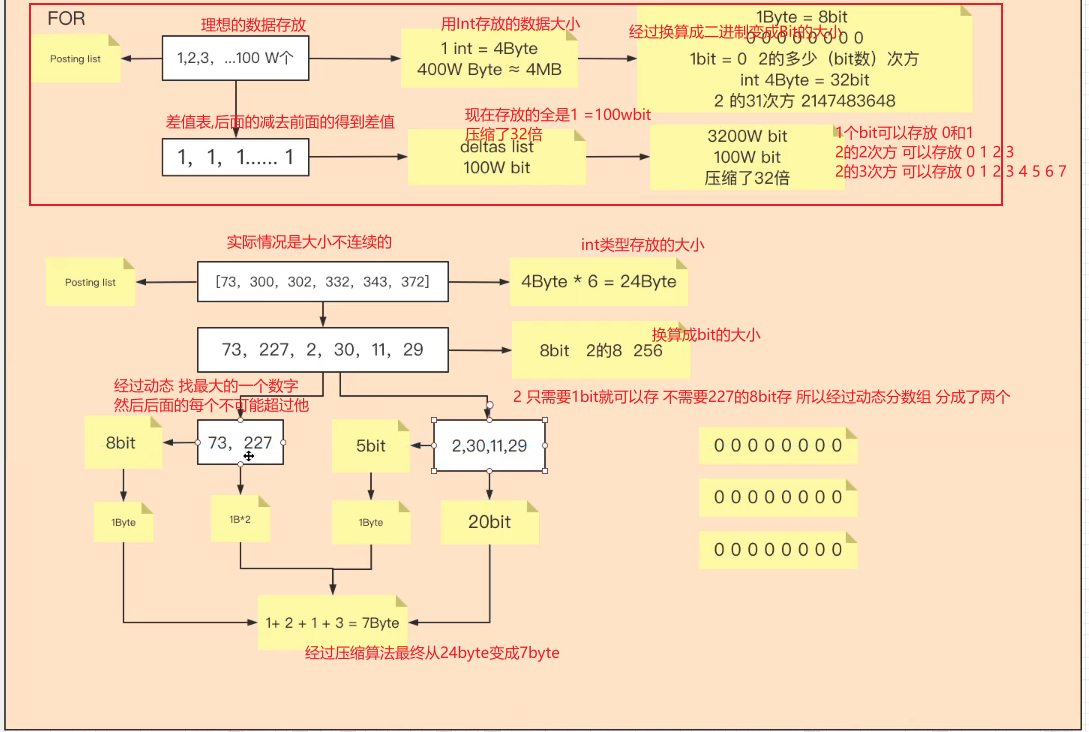
倒排表算法_RoaringBitmap压缩算法:适用稀疏数组 数组的差值比较大

 如图得到的倒排表 词典数组是这样的 就用RBM算法

一个int类型 32位整形 32bit =2的16次方*2的16次方相乘 int的最大值 不会超过2的32次方   

FST的构建过程:https://www.bilibili.com/video/BV1LF411j7rm?p=11&spm_id_from=pageDriver&vd_source=12d06e602c3462c026d1a4781241f2d4

理解数据结构:前缀树和 FST有限状态转换机

 Lucene字典原理:FST在Lucene的构建原理,:https://www.cnblogs.com/LBSer/p/4119841.html