




给定一个字符串 \(S_{0 \sim n-1}\),如果不断把它的最后一个字符放到开头,最终会得到 \(n\) 个字符串,称这 \(n\) 个字符串是循环同构的。这些字符串中字典序最小的一个,称为字符串 \(S\) 的最小表示。
例如 \(S\) 为 "abca",那么它的 4 个循环同构字符串为 "abca", "aabc", "caab", "bcaa",\(S\) 的最小表示为 "aabc"。与 \(S\) 循环同构的字符串可以用该字符串在 \(S\) 中的起始下标表示,用 \(B_i\) 来表示从 \(i\) 开始的循环同构字符串,即 \(S_{i \sim n-1} + S_{0 \sim i-1}\)。
如何求出一个字符串的最小表示?最朴素的方法是:按照定义,依次比较这 \(n\) 个循环同构的字符串,找到其中字典序最小的一个。比较两个循环同构字符串 \(B_i\) 与 \(B_j\) 时,也采用直接向后扫描的方式,依次取 \(k=0,1,2,\dots\),比较 \(B_{i+k}\) 与 \(B_{j+k}\) 是否相等,直至找到一个不相等的位置,从而确定 \(B_i\) 与 \(B_j\) 的大小关系。
实际上,一个字符串的最小表示可以在 \(O(n)\) 的线性时间内求出。
对于任意的 \(i,j\),仔细观察 \(B_i\) 与 \(B_j\) 的比较过程:
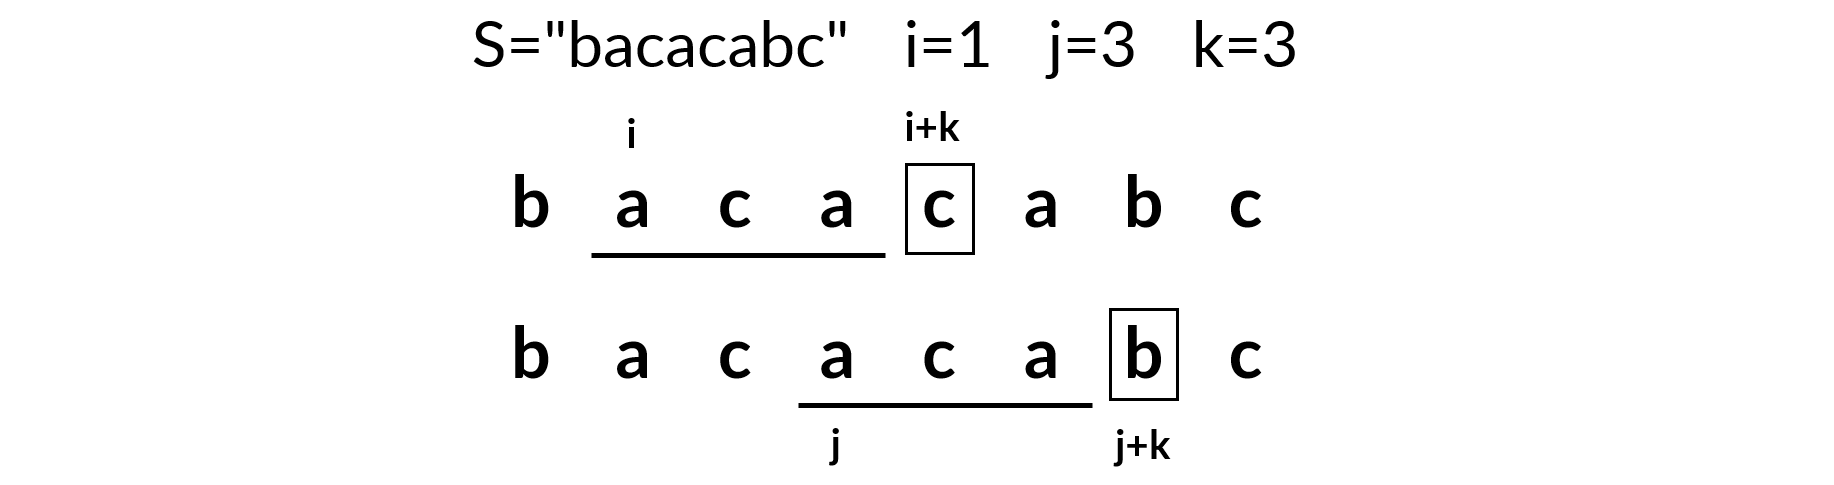
如果在 \(i+k\) 与 \(j+k\) 处发现不相等,假设 \(S_{i+k} \gt S_{j+k}\)(这里下标实际上要对 \(n\) 取模),那么当然可以得知 \(B_i\) 不是 \(S\) 的最小表示(因为存在一个更小的循环同构串 \(B_j\))。除此之外,还可以得知 \(B_{i+1}, B_{i+2}, \dots, B_{i+k}\) 也都不是 \(S\) 的最小表示。这是因为对于 \(1 \le p \le k\),存在一个比 \(B_{i+p}\) 更小的循环同构串 \(B_{j+p}\)(从 \(i+p\) 到 \(j+p\) 开始向后扫描,同样会在 \(p=k\) 时发现不相等,并且 \(S_{i+k} \gt S_{j+k}\))。
同理,如图 \(S_{i+k} \lt S_{j+k}\),那么 \(B_j, B_{j+1}, \dots, B_{j+k}\) 都不是 \(S\) 的最小表示,直接跳过这些位置,一定不会遗漏最小表示。
初始化 \(i=0, \ j = 1\)。
通过直接向后扫描的方法,比较 \(B_i\) 与 \(B_j\) 两个循环同构串。
catcat 有循环元 cat),并且该循环元已经扫描完成,\(B_{\min(i,j)}\) 即为最小表示。若 \(i\) 和 \(j\) 都小于 \(n\),则重复上面的过程,否则 \(B_{\min(i,j)}\) 为最小表示。
该算法通过两个指针不断向后移动的形式,尝试比较每两个循环同构串的大小。利用前面分析的性质,及时排除掉不可能的那个选项。当其中一个移动到结尾时,就考虑过了所有可能的二元组 \((B_i,B_j)\),从而得到了最小表示。
如果每次比较向后扫描了 \(k\) 的长度,则 \(i\) 或 \(j\) 二者之一会向后移动 \(k\),而 \(i\) 和 \(j\) 合计一共最多向后移动了 \(2n\) 的长度,因此该算法的时间复杂度为 \(O(n)\)。
#include <cstdio>
#include <algorithm>
using namespace std;

const int N = 1e7 + 5;
char s[N];

int main()
{
    int n;
    // 读取字符串长度和字符串内容
    scanf("%d%s", &n, s);

    // i, j 是两个候选的起始位置指针,k 是当前匹配的长度偏移量
    int i = 0, j = 1, k = 0;

    // 最小表示法的双指针核心逻辑
    while (i < n && j < n && k < n) {
        // 比较从 i 和 j 开始,偏移量为 k 的字符(取模以处理循环同构)
        char a = s[(i + k) % n];
        char b = s[(j + k) % n];

        if (a == b) {
            // 如果对应字符相等,则增加偏移量继续向后比对
            k++;
        } else {
            // 如果不相等,则字典序较大的那个指针可以向后“跳跃”
            if (a > b) {
                // 以 i 开头的字符串字典序更大,且 i 到 i+k 之间的位置都不可能成为起点
                i = i + k + 1;
            } else {
                // 以 j 开头的字符串字典序更大
                j = j + k + 1;
            }
            // 确保两个指针不重合
            if (i == j) j++;
            // 重置偏移量,开始新一轮比对
            k = 0;
        }
    }

    // 最终最小表示的起始位置是 i 和 j 中的较小值
    int start = min(i, j);

    // 从找到的最小起点开始,循环输出 n 个字符
    for (int p = 0; p < n; p++) {
        printf("%c", s[(start + p) % n]);
    }
    printf("\n");

    return 0;
}
将最左边的方块放到最右边实际上就是循环移位操作,所以原问题就是求最小表示。
#include <cstdio>
#include <algorithm>
using namespace std;

const int N = 3e5 + 5;
int a[N];

int main()
{
    int n;
    scanf("%d", &n);
    // 读取每个方块的瑕疵度
    for (int i = 0; i < n; i++) scanf("%d", &a[i]);

    // i, j 分别为两个候选的起始位置指针,k 为当前匹配的长度偏移量
    int i = 0, j = 1, k = 0;

    // 最小表示法的双指针核心逻辑:在 O(n) 时间内找到字典序最小的循环同构起始点
    while (i < n && j < n && k < n) {
        // 比较从 i 和 j 开始,偏移量为 k 的元素(取模以处理循环移动)
        int vi = a[(i + k) % n];
        int vj = a[(j + k) % n];

        if (vi == vj) {
            // 如果对应元素相等,则增加偏移量继续向后比对
            k++;
        } else {
            // 如果不相等,则字典序较大的那个指针可以向后“跳跃”
            if (vi > vj) {
                // 以 i 开头的序列字典序更大,跳过不可能作为起点的区间
                i = i + k + 1;
            } else {
                // 以 j 开头的序列字典序更大
                j = j + k + 1;
            }

            // 确保两个候选起始指针不重合
            if (i == j) j++;
            // 重置偏移量,重新开始新一轮比对
            k = 0;
        }
    }

    // 最终最小表示的起始位置是 i 和 j 中的较小值
    int start = min(i, j);

    // 从找到的最小起点开始,循环输出 n 个整数
    for (int p = 0; p < n; p++) {
        printf("%d%c", a[(start + p) % n], (p == n - 1 ? '\n' : ' '));
    }

    return 0;
}
项链可以从任意位置开始读取,因此一个长度为 \(n\) 的字符串有 \(n\) 种可能的表现形式。只要两个字符串属于同一组循环同构,它们就代表同一个项链。
为了判断两个字符串是否循环同构,最直观的方法是将它们都转换为各自的“最小表示”。如果两个字符串的最小表示完全相同,则它们同构。
#include <cstdio>
#include <cstring>
#include <algorithm>
using namespace std;

const int N = 1000005;
int n;
char a[N], b[N];

// 最小表示法函数:寻找字符串 s 的最小循环同构起始下标
int get(char s[]) {
    int i = 0, j = 1, k = 0; // i, j 是候选起点,k 是匹配偏移量
    while (i < n && j < n && k < n) {
        // 比较以 i 和 j 为起点的循环后缀字符
        char vi = s[(i + k) % n];
        char vj = s[(j + k) % n];

        if (vi == vj) {
            k++; // 字符相同,继续比对下一位
        } else {
            // 发现不同字符,根据字典序大小跳过不可能的起点
            if (vi > vj) {
                // 以 i 为起点的字符串字典序更大,i 及其之前的 k 个位置都不可能成为起点
                i += (k + 1);
            } else {
                // 以 j 为起点的字符串字典序更大
                j += (k + 1);
            }

            // 确保两个候选指针不重合
            if (i == j) j++;
            // 重置匹配步长
            k = 0;
        }
    }
    // 返回 i 和 j 中更小的有效下标
    return min(i, j);
}

int main()
{
    // 读取两条项链的描述字符串
    scanf("%s%s", a, b);
    n = strlen(a);

    // 获取两条项链各自的最小表示起始位置
    int sa = get(a), sb = get(b);

    // 比较两者的最小表示是否完全相同
    bool equal = true;
    for (int i = 0; i < n; i++) {
        if (a[(sa + i) % n] != b[(sb + i) % n]) {
            equal = false;
            break;
        }
    }

    // 根据比较结果输出
    if (equal) {
        printf("Yes\n");
        // 如果同构,输出其字典序最小的表示
        for (int i = 0; i < n; i++) printf("%c", a[(sa + i) % n]);
        printf("\n");
    } else {
        printf("No\n");
    }

    return 0;
}
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。