








https://github.com/fanqingsong/YOLOv8_Traffic_Density_Estimation
https://docs.ultralytics.com/models/yolov8
A YOLOv8-based project for real-time traffic density estimation. It employs fine-tuned vehicle detection models to analyze and count vehicles per frame, aiding urban traffic management and planning. The repository includes model training, traffic intensity analysis, and deployment strategies.
这是一个基于 YOLOv8 的实时交通密度估算项目,旨在通过视频帧中的车辆检测与计数,辅助城市交通管理与规划。
该项目利用 YOLOv8 的实时检测能力,专注于交通密度估算。核心目标是准确统计视频帧中指定区域的车辆数量,以评估交通流量。这些数据有助于识别交通高峰期、瓶颈路段,并为城市规划提供支持。
项目不仅包含模型训练,还提供了完整的 Docker Compose 工作流,用于自动化下载数据集、准备数据、模型微调以及无头(headless)推理。
项目实现了以下关键里程碑:
项目使用了一个名为“Top-View Vehicle Detection Image Dataset for YOLOv8”的数据集,该数据集从俯视角度提供车辆行为和交通模式信息。
项目采用模块化设计,主要技术栈和文件包括:
scripts/): 包含用于 Kaggle 数据下载、数据集准备、模型训练、模型量化(OpenVINO INT8)和交通分析的独立 Python 模块。Dockerfile: 用于 CPU 推理。Dockerfile.train: 用于 GPU 训练。Dockerfile.quantize: 用于 CPU 上的 OpenVINO/NNCF 量化。compose.yaml: 定义了下载、准备、训练、量化和推理等独立服务。docs/adr/ 目录和标准库单元测试 tests/。项目推荐使用 Docker Compose 运行,每个阶段都是一个独立的一次性服务。
.env.example 为 .env 并设置 KAGGLE_USERNAME 和 KAGGLE_KEY。docker compose run --rm download-datadocker compose run --rm prepare-datadocker compose -f compose.yaml -f compose.gpu.yaml run --rm train
models/best.pt 和 models/best.onnx。在训练和数据准备完成后,运行以下命令进行量化和性能对比: docker compose run --rm --build quantize-model 该命令会导出 FP32 和 INT8 两种精度的 OpenVINO 模型,并生成包含 mAP、推理延迟、模型大小等指标的对比报告。
models/best.pt 和 sample_video.mp4 放置在项目根目录。docker compose run --rm --build traffic-analysisoutput/processed_sample_video.avi。你也可以在本地环境中运行推理部分:
pip install -r requirements.txtpython -m scripts.traffic_analysis
q 键退出)。DISPLAY_VIDEO=false python -m scripts.traffic_analysishttps://github.com/fanqingsong/PPE-Detection-YOLOv8
Overall (val split): mAP50 = 0.566 | mAP50-95 = 0.283 | Precision = 0.621 | Recall = 0.509
| Class | mAP50 | Instances (val) |
|---|---|---|
| Person | 0.901 | 239 |
| vest | 0.847 | 171 |
| boots | 0.847 | 151 |
| helmet | 0.844 | 201 |
| gloves | 0.789 | 136 |
| goggles | 0.790 | 47 |
| no_helmet | 0.426 | 45 |
| none | 0.502 | 81 |
| no_gloves | 0.172 | 56 |
| no_goggle | 0.084 | 41 |
| no_boots | 0.018 | 4 |
The pattern is consistent across every metric I looked at: classes with more training instances perform well (0.79–0.90 mAP50), classes with few instances perform poorly (no_boots had only 4 validation instances and 0.018 mAP50). This isn't a bug — it's the expected effect of class imbalance in the source dataset, and it's the single biggest lever for improving this model further (see Limitations).
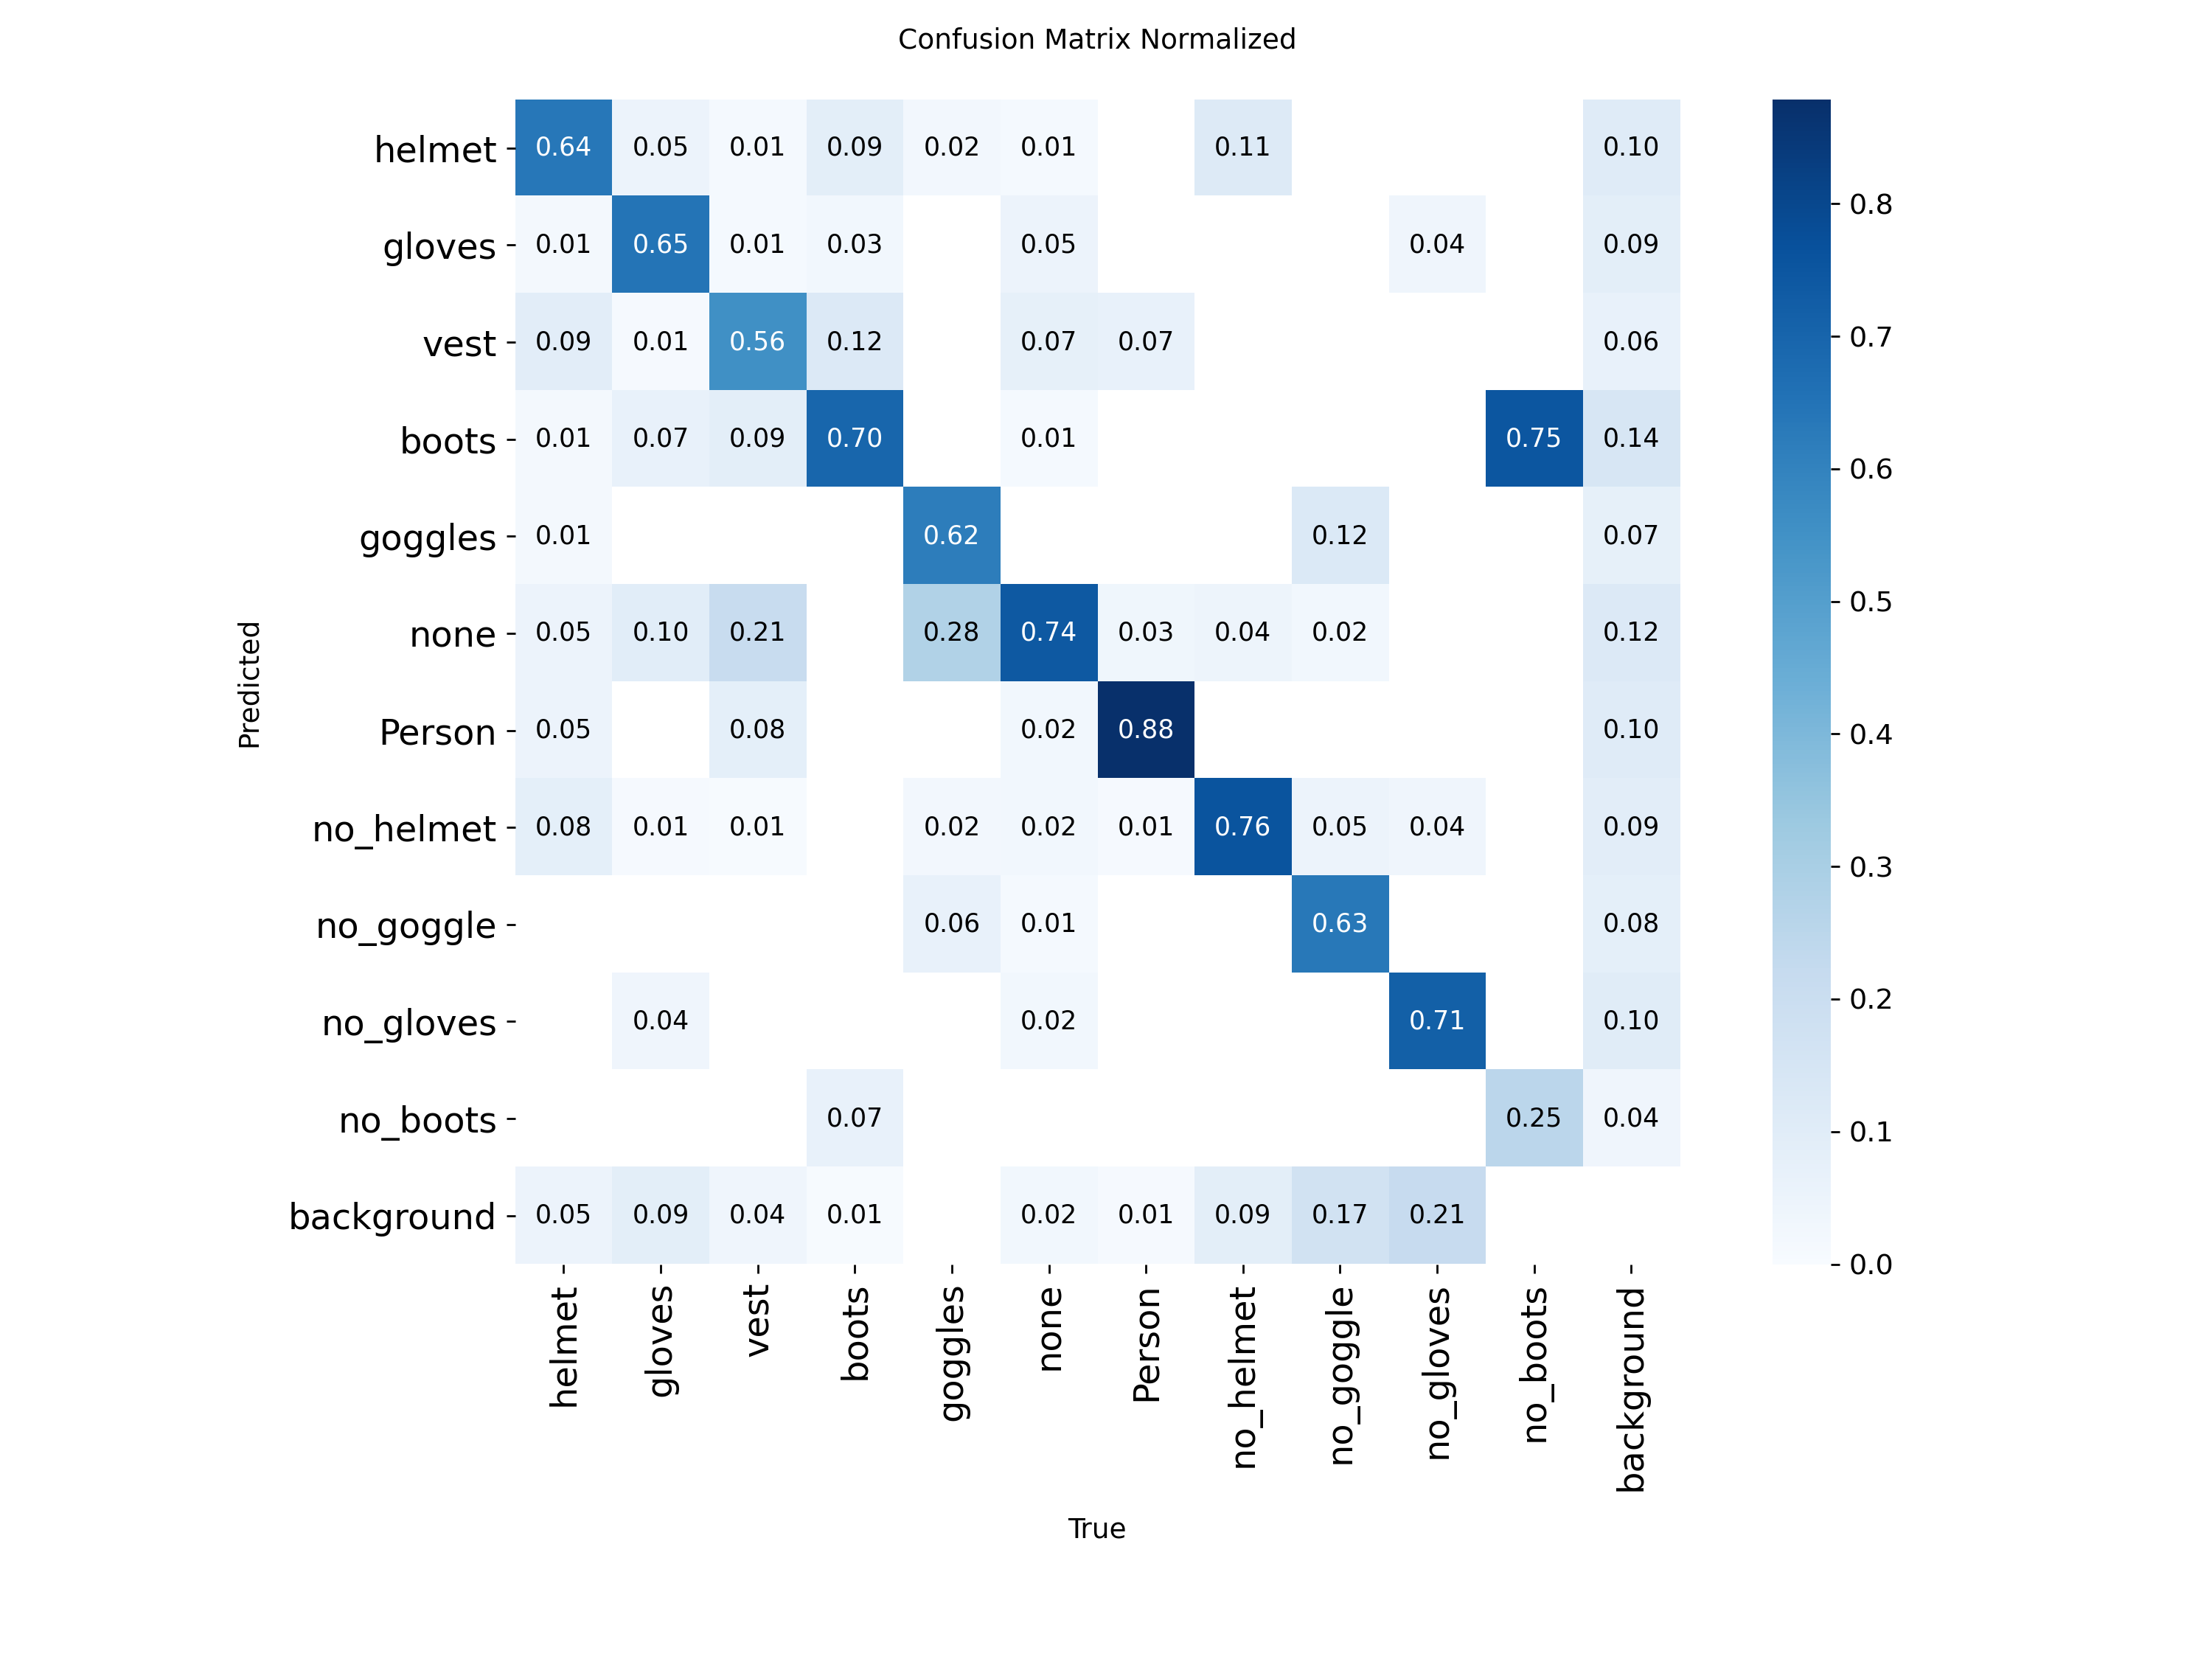
A few things worth calling out:
Person 0.88, no_helmet 0.76, boots 0.70, no_gloves 0.71) sit cleanly on the diagonalnone (no PPE at all) is frequently confused with vest (0.21) and goggles (0.28) — plausible, since it's essentially a catch-all/ambiguous classno_goggle (0.17) and no_gloves (0.21) predictions land in background — meaning the model often misses these rare violation classes entirely, rather than confusing them with something else. That's a recall problem tied directly to how few training examples those classes have.混淆矩阵是评估分类模型(比如你提供的网页中提到的YOLOv8目标检测模型)性能的核心工具。简单来说,它通过一个表格,直观地展示了模型的预测结果与真实情况的对比,从而揭示出模型“对在哪里”以及“错在哪里”。
混淆矩阵的主要作用是帮助你深入分析模型的预测表现,而不仅仅是看一个笼统的准确率。它能帮你回答以下关键问题:
混淆矩阵是一个二维表格:
矩阵中的每一个单元格 (i, j) 的数值,表示 真实类别为 i 的样本中,被模型预测为类别 j 的数量或比例。
在你提供的关于PPE(个人防护装备)检测的网页中,作者就使用了混淆矩阵来深入分析其YOLOv8模型的性能,并得出了非常具体的结论:
识别模型的优势:
Person (人)、no_helmet (无头盔)、boots (靴子) 这些类别的预测结果清晰地聚集在对角线上(例如 Person 的对角线值为0.88,no_helmet 为0.76)。发现模型的弱点:
no_goggle (无护目镜) 和 no_gloves (无手套) 这两个类别的预测结果有相当一部分落在了 background (背景) 这一列(分别为0.17和0.21)。分析类别间的混淆:
none (无任何PPE) 类别经常被混淆为 vest (反光背心) 和 goggles (护目镜)。总而言之,混淆矩阵就像一个“诊断报告”,它不仅能告诉你模型的整体健康状况(准确率),还能精准定位到具体是哪个“器官”(类别)出了问题,以及问题的具体表现(是误诊还是漏诊),为后续的模型优化提供了明确的方向。
https://github.com/fanqingsong/Applied-AI-YOLO-Walkthrough
Step-by-step walkthrough for fine-tuning a YOLO11 object detector on a custom webcam dataset. Capture, label in Label Studio, visualize augmentations, train, and run live inference with object counts and on-screen time tracking.
这是一个关于如何微调 YOLO11 目标检测模型的 GitHub 项目指南。该项目提供了一个完整的端到端流程,用于训练一个能够识别自定义物体的模型,并通过网络摄像头进行实时推理。
以下是该指南的核心内容总结:
该项目旨在指导用户完成从数据收集到模型部署的全过程,最终实现一个网络摄像头应用,该应用能够:
ultralytics (YOLO库)、opencv-python 和 matplotlib。整个流程分为六个主要步骤:
采集训练图像 (Capture)
scripts/capture.py 脚本,通过摄像头拍摄至少 30 张包含目标物体的照片。标注图像 (Label)
准备数据集 (Prepare)
scripts/prepare_dataset.py 脚本,将标注好的数据自动划分为训练集(80%)和验证集(20%),并生成 YOLO 所需的 dataset.yaml 配置文件。可视化数据增强 (Visualize Augmentations)
scripts/visualize_augmentations.py 脚本,生成一个 PDF 文件,直观展示 YOLO 在训练时会使用的各种数据增强技术(如旋转、翻转、色彩调整等)对图像的影响。训练模型 (Train)
scripts/train.py 脚本开始训练。默认使用 YOLO11n(nano)模型,训练 50 个周期(epochs)。runs/detect/run1/weights/best.pt。实时推理 (Live Inference)
scripts/live_inference.py 脚本,加载训练好的模型,开启摄像头进行实时物体检测,并在画面上显示计数和追踪时间。项目结构清晰,主要脚本位于 scripts/ 目录下,数据、模型和运行结果会分别生成在 data/ 和 runs/ 目录中。
出处:http://www.cnblogs.com/lightsong/ 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。