惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

P
Proofpoint News Feed
Martin Fowler
Martin Fowler
The GitHub Blog
The GitHub Blog
B
Blog RSS Feed
U
Unit 42
阮一峰的网络日志
阮一峰的网络日志
量子位
GbyAI
GbyAI
Cyber Security Advisories - MS-ISAC
云风的 BLOG
云风的 BLOG
小众软件
小众软件
博客园 - 三生石上(FineUI控件)
L
LangChain Blog
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
博客园_首页
IT之家
IT之家
V
Visual Studio Blog
Y
Y Combinator Blog
Blog — PlanetScale
Blog — PlanetScale
宝玉的分享
宝玉的分享
Apple Machine Learning Research
I
InfoQ
D
Docker
V
V2EX

博客园 - xiezhengcai

日志分层设计 Ai阅读代码的局限性 业务系统缓存加速的五种缓存设计 The CustomResourceDefinition "applications.apps.abc.com" is invalid: metadata.annotations: Too long: must have at most 262144 bytes vscode ssh开发无法读取go env配置 deepspeed ray + nccl + 张量并行 训练 ray集群 ray 分布式, 工作节点、reylet、 主节点、GCS ray分布式 nccl & mpi 跨节点通信 cudaMemsetParams 参数详细 cuda 中的内存拷贝 cuda 编程 vllm 参数分类 张量计算流程图标注方法 为什么nn.Linear 的weight 是 (out_features, in_features) torch.view、unsqueeze、reshape、transpose 和 permute PyTorch交叉熵损失函数详解
cuda
xiezhengcai · 2025-04-22 · via 博客园 - xiezhengcai

通讯模式:多个线程合作解决一个问题,常见的合作模式称为Communication Patterns
  • 映射:map
  • 聚合:gather
  • 分散:scatter
  • 模板:stencil
  • 转换:transpose
  • 压缩:reduce
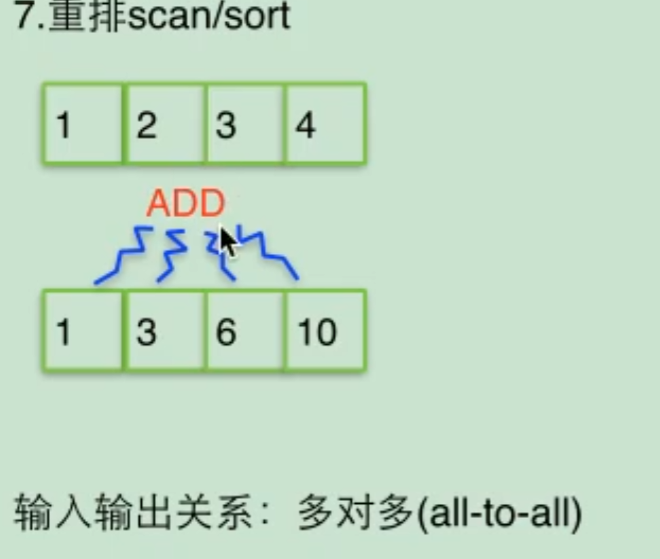
  • 重排:scan/sort

cuda编程的特点:
对线程块在何处、何时运行不做保证

  • 对于哪个块在哪个SM上运行无法做出任何假设,
  • 无法获取块之间的明确通讯

共享内存是在SM(Streaming Multiprocessor)内部的,一个线程块(block)在启动时,申请的共享内存不能超过 SM 上剩余的共享内存。通常CUDA编译器默认给一个block最多分配48KB,超过就launch失败!如果想要大共享内存,通常要指定 extern shared 的方式动态申请,并且调整launch参数。
获取每个SM和线程块最大共享内存大小

#include <stdio.h>
int main(int argc, char** argv) {
    cudaDeviceProp prop;
    cudaGetDeviceProperties(&prop, 0);
    printf("Shared memory per block: %d bytes\n", prop.sharedMemPerBlock);
    printf("Shared memory per SM: %d bytes\n", prop.sharedMemPerMultiprocessor);

}

Shared memory per block: 49152 bytes
Shared memory per SM: 102400 bytes

每个block申请多少共享内存 | 一个SM最多能并行多少block?
48KB | 大概2个block(因为48KB×2=96KB,还剩一点点)
24KB | 大概4个block
8KB | 大概12个block