






所属分类:文本/NLP
产品案例页:https://engineering.gugudata.com/products/text/multilingual-corpus-annotation/
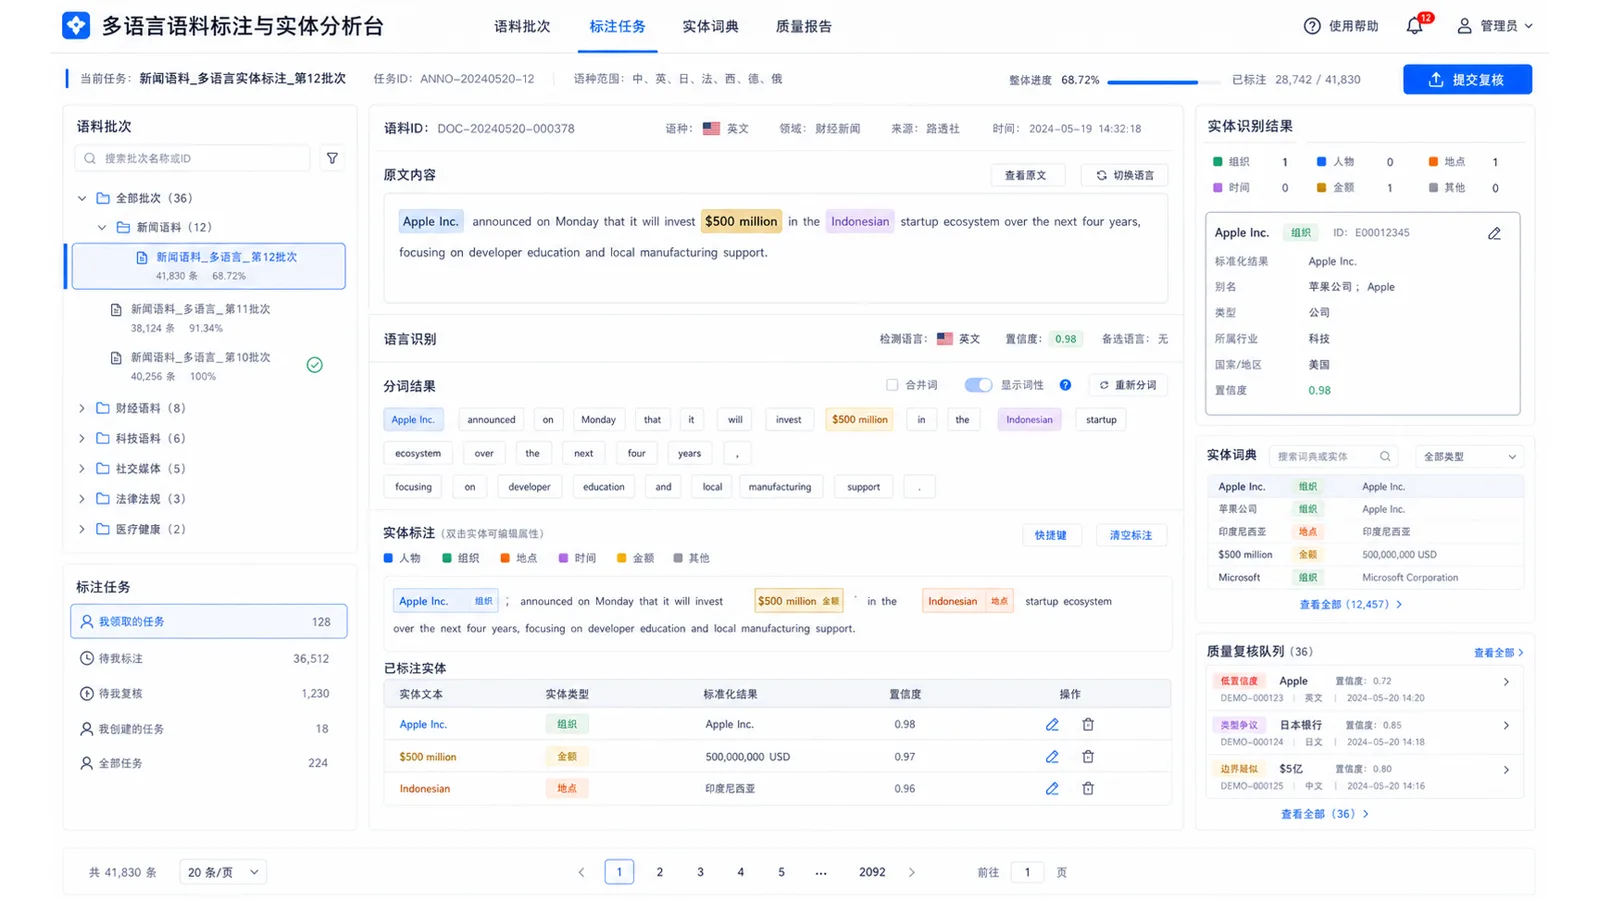
不同语种和混合文本的标注口径不一致,实体结果难以汇总。目标是统一语种识别、分词、实体抽取和质量复核。
多语言语料、模型评测、搜索和国际化内容团队。
输入侧需要清楚展示必填信息、可选条件和当前批次。语料文件、预期语言、实体类型和批次标注规则。页面不展示真实密钥,接口授权由调用方在自己的安全环境中管理。
输出侧以业务人员能够判断和继续操作为准。语言标签、分词单元、实体清单、一致率和异常样本。结果需要展示成功、处理中、待复核、失败或未采样等真实状态,不使用空白或数字零代替未知结果。
本案例的接口数据链以“多语言语料标注与实体分析台”的操作流程为顺序:上一步返回的业务标识、规范化结果或状态进入下一步,页面同时保留来源与处理状态。接口信息按当前公开接口契约展示,文章只维护业务步骤之间的流转关系。
| 业务步骤 | 接口文档 | 数据流转 |
|---|---|---|
| 识别语种 | 自然语言处理语言检测 | 语种结果决定分词和标注规则。 |
| 执行分词 | 自然语言处理分词 | 分词结果形成可复核的标注单元。 |
| 抽取实体 | 自然语言处理实体识别 | 实体结果进入结构化语料库。 |
未知语种、混合语种和低一致率样本必须进入人工复核,不自动归入确定标签。
通过复核的语料可进入检索索引、模型训练或评测集。如需评估自己的数据、页面和业务流程,可以从当前案例的接口蓝图核对输入输出,再联系 GuGuData Engineering 讨论实现范围与验收方式。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。