






Apache Avro 是一种 开源的、语言无关的、基于行的(row-based)数据序列化格式,由 Hadoop 项目开发,广泛用于大数据生态系统(如 Kafka、Spark、Flink、Hive 等)中,用于高效存储和传输结构化数据。
user.avsc
{
  "namespace": "com.example.avro",
  "type": "record",
  "name": "User",
  "fields": [
    {"name": "name", "type": "string"},
    {"name": "favorite_number", "type": ["int", "null"]},
    {"name": "favorite_color", "type": ["string", "null"]}
  ]
}
定义pom.xml
plugins 定义如下
<plugins>
            <plugin>
                <groupId>org.apache.avro</groupId>
                <artifactId>avro-maven-plugin</artifactId>
                <version>1.12.0</version>
                <executions>
                    <execution>
                        <phase>generate-sources</phase>
                        <goals>
                            <goal>schema</goal>
                        </goals>
                        <configuration>
                            <sourceDirectory>${project.basedir}/src/main/resources/avro/</sourceDirectory>
                            <outputDirectory>${project.basedir}/src/main/java/</outputDirectory>
                        </configuration>
                    </execution>
                </executions>
            </plugin>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <configuration>
                    <source>21</source>
                    <target>21</target>
                </configuration>
            </plugin>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
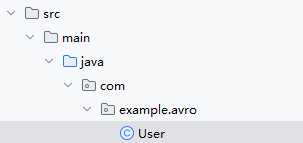
schema 文件 放到 /src/main/resources/avro/ 目录下
点击 install 后生成文件如下:
User user1 = new User("Alice", 256, null);
User user2 = User.newBuilder()
                .setName("Bob")
                .setFavoriteNumber(7)
                .setFavoriteColor("red")
                .build();

        // 序列化到文件
        DatumWriter<User> userDatumWriter = new SpecificDatumWriter<>(User.class);
        DataFileWriter<User> dataFileWriter = new DataFileWriter<>(userDatumWriter);
        dataFileWriter.create(user1.getSchema(), new File("users.avro"));
        dataFileWriter.append(user1);
        dataFileWriter.append(user2);
        dataFileWriter.close();

//         从文件反序列化
        DatumReader<User> userDatumReader = new SpecificDatumReader<>(User.class);
        DataFileReader<User> dataFileReader = new DataFileReader<>(new File("users.avro"), userDatumReader);
        User user = null;
        while (dataFileReader.hasNext()) {
            user = dataFileReader.next(user);
            System.out.println(user);
        }
每次生成对象的方式不够灵活,使用 GenericRecord 不用创建类,也可以实现AVRO数据的序列化。
Schema schema = new Schema.Parser().parse(new File("D:\\work\\research\\avrodata\\src\\main\\resources\\user.avsc"));
        GenericRecord user1 = new GenericData.Record(schema);
        user1.put("name", "Charlie");
        user1.put("favorite_number", 128);
        user1.put("favorite_color", "blue");


        DatumWriter<GenericRecord> datumWriter = new SpecificDatumWriter<>(schema);
        ByteArrayOutputStream out = new ByteArrayOutputStream();
        BinaryEncoder encoder = EncoderFactory.get().binaryEncoder(out, null);
        datumWriter.write(user1, encoder);
        encoder.flush();
        byte[] serializedBytes = out.toByteArray();

        // 从字节数组反序列化
        DatumReader<GenericRecord> datumReader = new SpecificDatumReader<>(schema);
        BinaryDecoder decoder = DecoderFactory.get().binaryDecoder(serializedBytes, null);
        GenericRecord deserializedUser = datumReader.read(null, decoder);

        System.err.println(deserializedUser);
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。