


前言
最近想着把工作中常用到的技术点与工具做一些整理总结,一方面梳理一下这些知识点,加深使用记忆,也可以作为之后使用的查阅。
目前主要计划了数据库相关、CI/CD 相关(GitHub Actions + GitLab CI)、容器相关(Docker + k8s)、运维相关(Ansible 等)这几个核心介绍,以及一些像是语言特性、Git 实用技巧、Shell 脚本等技巧总结。因为有很多内容工作中只是接触到,自己做了一些拓展学习,所以不一定完全符合企业具体实践(大多为自己的经验与理解),希望能有所帮助。
本篇是数据库系列的 PostgreSQL 部分,关于 MySQL 之前已经梳理过,可以进行查阅 —— 『MySQL 基础与实践』。
数据与数据库概述
数据
首先,数据其实本质上是一种事实或者观察到的结果,是对客观事务的逻辑上的归纳总结,是信息的一种表现形式和载体。人们从很早的时候就开始管理数据(即使还没有这个概念),最初是由人工管理,而后来渐渐有了文件系统(就像图书馆一样,分门别类地管理不同信息),而随着计算机技术的发展,最后形成了用数据库进行管理的这种较为便捷高效的模式。
数据库
数据库是按照一定的数据结构来组织、存储和管理数据的一个仓库,主要特征为
- 结构化
- 可共享
- 冗余度小
- 独立性高
- 易于拓展
很好理解的是,按照不同关系/结构组织起来的数据具备不同的特征,同时也适用于不同的应用场景,目前主要分为层次数据库、网状数据库和关系数据库三种,而我们要着重介绍的 Postgres 就是关系数据库。
数据库管理系统(DBMS)
数据库管理系统(DBMS)是对数据库进行各种操作的一个系统,一具有建立和维护数据库、对数据的存储进行组织管理、对数据库进行控制、定义数据、操纵数据以及管理数据之间的通信等核心功能,不同的数据库管理系统对数据库和数据的处理方式不同,数据呈现方式也不同,也往往需要根据数据规模、业务需求等场景选择合适的数据库管理系统,如在海量数据和高并发数据读写的情况下,关系性数据库的性能会下降得很厉害。
关系性数据库(RDBMS)
主要特征
关系性数据库主要以数据表的形式呈现,每一行为一条记录,每一列则为记录名称所对应的数据域(Field)。许多行列组成一张单表,而若干单表则组成数据库。用户/系统通过 SQL(结构化查询语言对数据库进行查询。
有些关系型数据库的操作具有事务性,即 ACID 规则
- 原子性(Atomicity)
- 一致性(Consistency)
- 隔离性(Isolation)
- 持久性(Durability)
原子性是指一系列事务操作要么都完成,要么都失败,不存在完成了一部分这样的情况,例如银行转账这样的场景里,转账行为发生后,发送方余额减少,而如果数据库出现了操作错误,接收方余额未增加,则会造成严重的问题。
一致性是指在事务执行完成后,整个数据库的数据是一致的,不应存在数据库内同一数据不同步的情况。
隔离性则是指不同的事务之间应该独立进行运行、互不干扰的,当然,这样会牺牲一定的效率,但对数据的准确性等提供了较好保障。
持久性则是指当一个事务执行完成后,它对数据库进行的更改、对系统产生的影响是永久的。
数据完整性
数据完整性是数据库很重要的一个要求和属性,是指存储在数据库中的数据应该保持一致性和可靠性,主要分为以下四种
- 实体完整性
- 域完整性
- 参照完整性
- 用户定义完整性
实体完整性要求每张数据表都有一个唯一的标识符,每张表中的主键字段不能为空且不能重复,这主要是指表中的数据都可以被唯一区分。
域完整性则是通过对表中列做一些额外限制,如限制数据类型、检查约束、设置默认值、是否允许空值以及值域范围等。
--- 在创建表时对字段进行唯一性的约束
CREATE TABLE person (
    id INT NOT NULL auto_increment PRIMARY KEY,
    name VARCHAR(30),
    id_number VARCHAR(18) UNIQUE
);
参照完整性是指数据库不允许引用不存在的实体,数据库的表与其他表之间往往存在一些关联,可以通过外键约束来保障其完整性。
而用户自定义完整性则是根据具体应用场景和涉及到数据来对数据进行一些语义方面的限制,如余额不能为负数等,一般用设定规则、存储过程和触发器等来进行约束和限制。
主流 RDBMS
目前主流的关系型数据库有以下几种
- SQL Server
- Sybase
- DB2
- Oracle
- MySQL
- PostgreSQL
企业和个人用得比较多的是 Oracle、MySQL、PostgreSQL 几种,接下来也会以 PostgreSQL 为例进行详细的操作讲解。
PostgreSQL
安装与配置
PostgreSQL 是一种现代化的开源对象关系性数据库管理系统。
作为个人用户学习使用,可以直接下载软件安装包使用本地搭建环境,可以根据不同的系统选择不同的版本,也具备较便捷的图形界面供大家进行服务的开启、关闭、重启以及进行相关的配置等。本文以 macOS 系统下的 PostgreSQL 14 为例,在官网安装及进行基本设置后,就可以对本机 PostgreSQL 服务进行管理,版本可能会略有差别,但核心功能差别不大。
图形界面
打开 PostgreSQL.app 应用,可以看到如下界面:
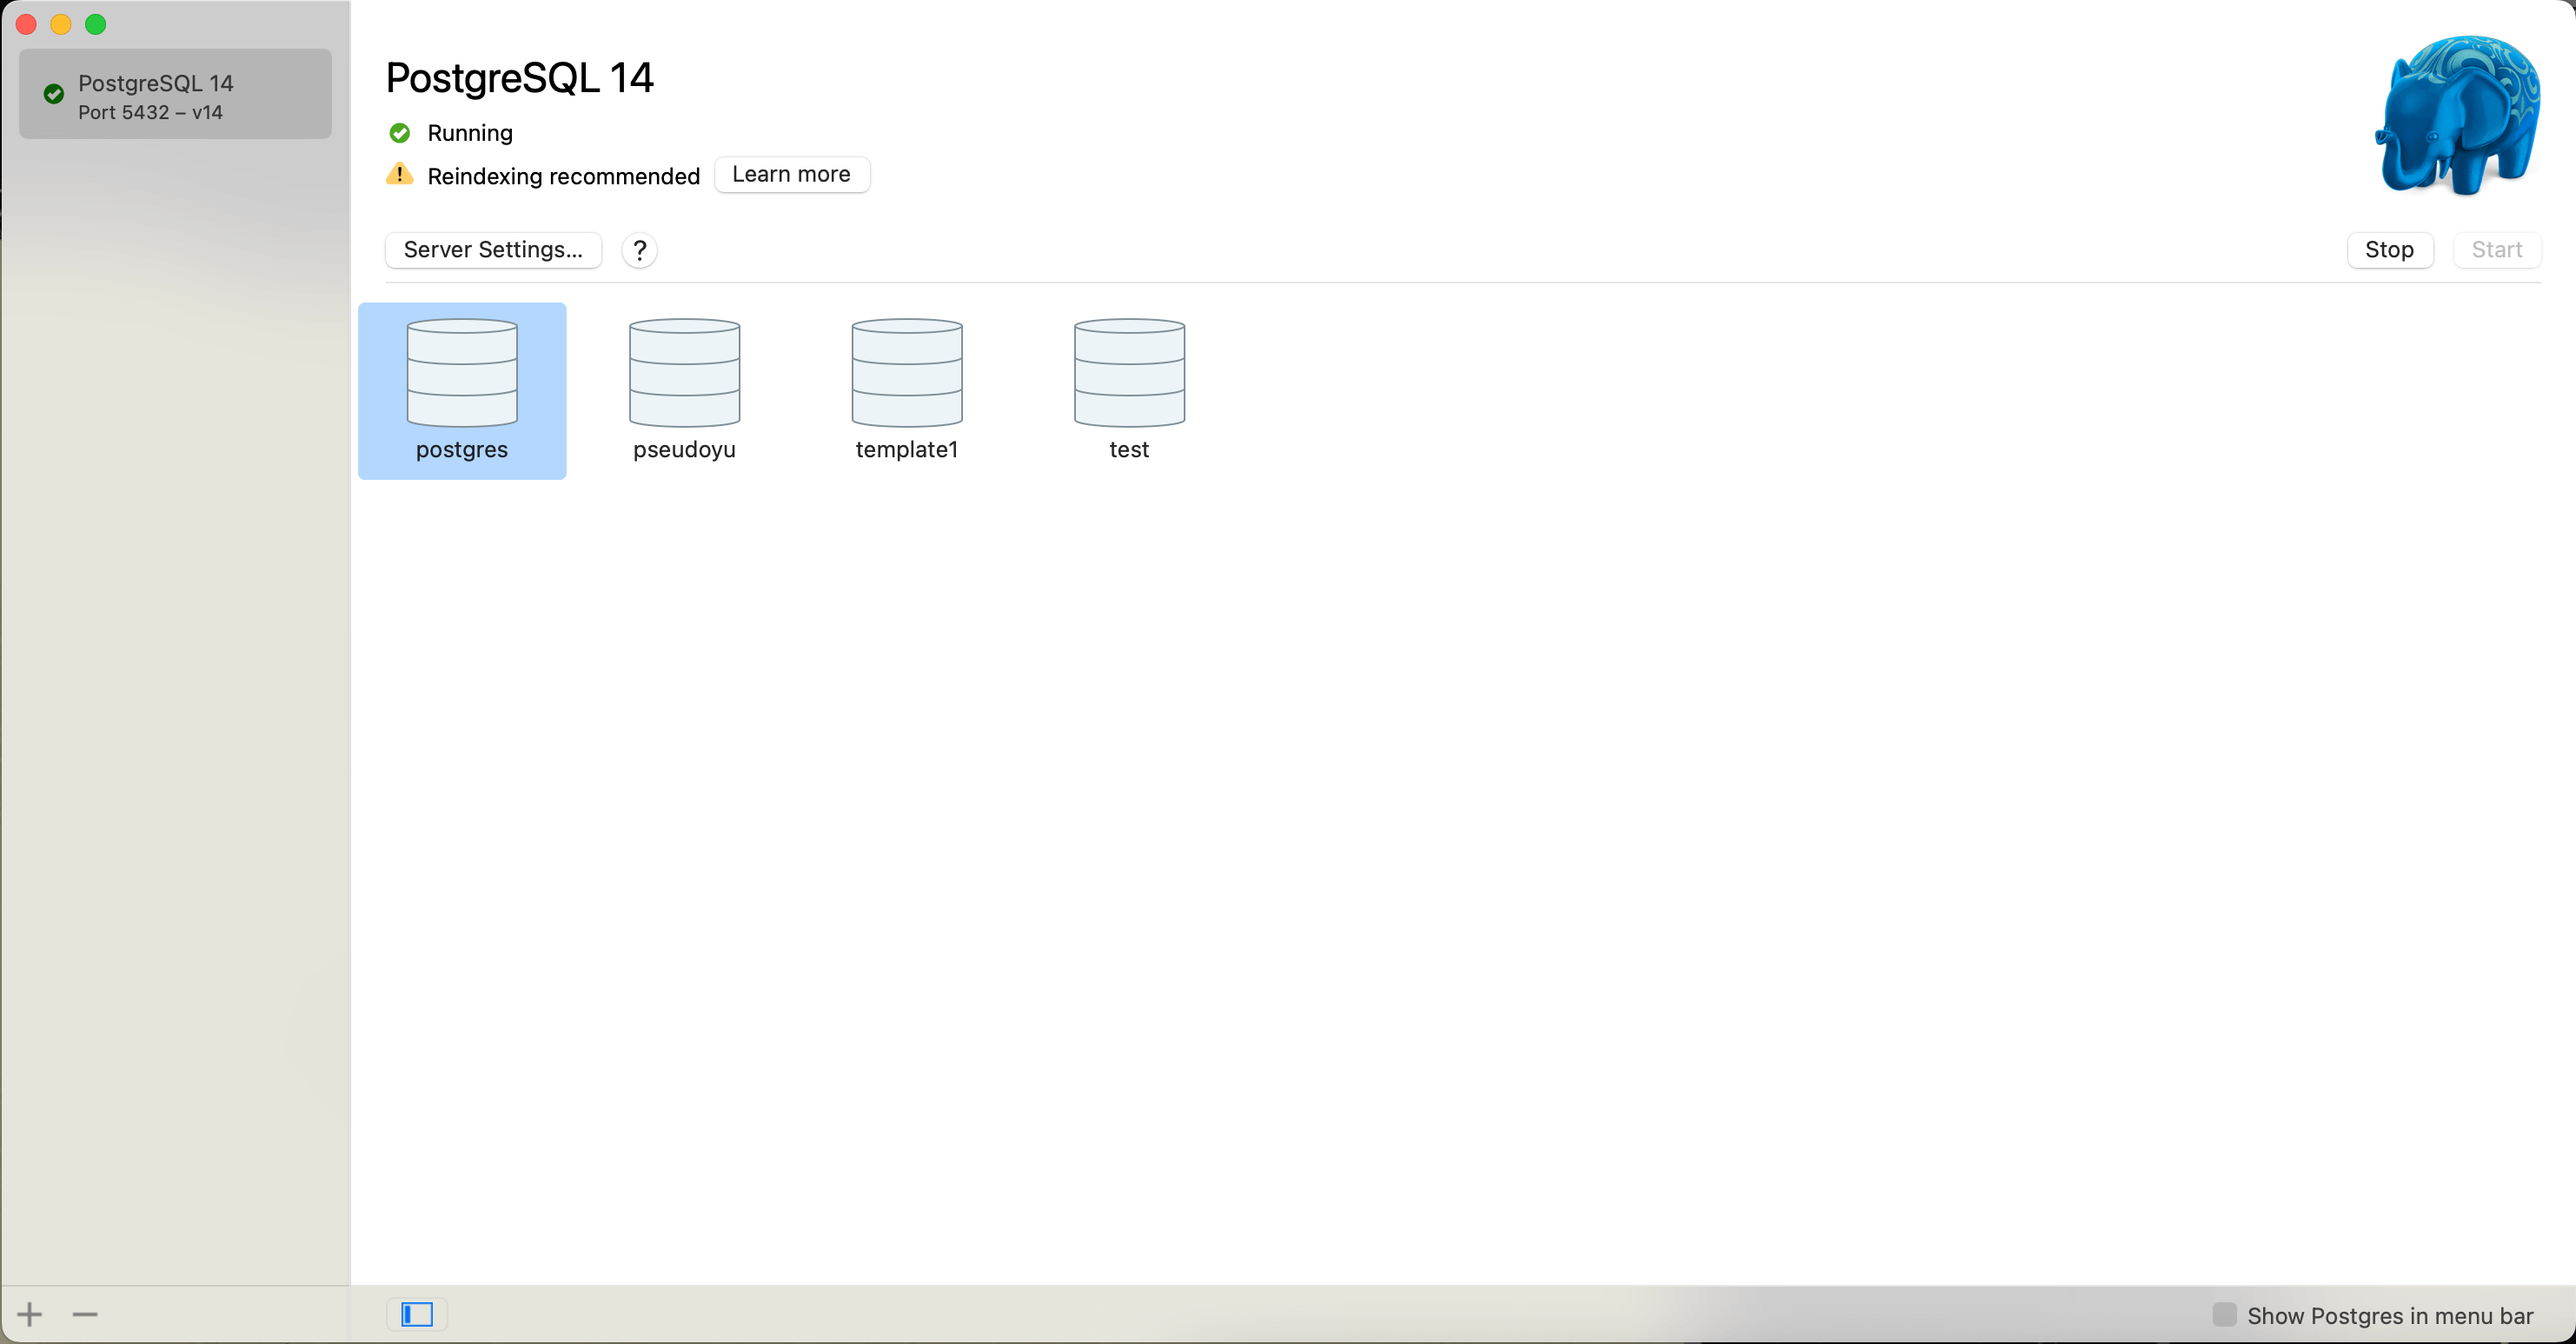
在这个管理界面可以很方便地进行 PostgreSQL 服务的开启与关闭,点击对应的数据库也可以进入命令行操作界面。
命令行界面
首先我们讲 psql 的路径加入环境变量以便后续使用,我使用的是 zsh,所以在 ~/.zshrc 文件中添加如下内容:
# postgres
export PATH=${PATH}:/Applications/Postgres.app/Contents/Versions/14/bin
之后在终端中输入 psql,就可以访问 PostgreSQL 的命令行界面了。可以使用如下命令查看 psql 的命令列表:
psql --help连接 PostgreSQL
我们可以通过以下命令连接数据库:
# 连接数据库
psql -h <host> -p <port> -U <username> <database-name>
当然,我们也可以通过一些第三方工具来更方便地连接数据库使用,我当前使用的 TablePlus 就支持 PostgreSQL 数据库,推荐。
命令行交互
PostgreSQL 提供了强大的命令行交互功能,我们可以使用 \ + 关键词来进行操作。我们可以通过查阅文档或 \? 与 help 命令来查看命令详情与帮助信息。其他常用命令如下:
# 查看帮助
help

# 查看 psql 命令详情
\?

# 查看数据库(全部)
\l

# 查看数据库(指定)
\l <database-name>

# 连接数据库
\c <database-name>

# 查看方法
\df

# 查看表(全部)
\d

# 查看表(只看表)
\dt

# 查看表(指定)
\d <table-name>

# 执行 sql 命令
\i <filepath>/<filename>

# 打开拓展视图
\x

# 导出至 CSV
\copy (SELECT * FROM person LEFT JOIN car ON person.car_id = car.id) TO 'path/to/output.csv' DELIMITER ',' CSV HEADER;

# 退出
\q
核心语法
经过了本地 PostgreSQL 配置与连接后,我们就可以对数据库进行一些操作了,SQL 语言主要分为以下四类
- DDL 数据定义语言(Data Definition Language)
- DML 数据操纵语言(Data Manipulation Language)
- DQL 数据查询语言(Data Query Language)
- DCL 数据控制语言(Data Control Language)
DDL 操作
--- 创建数据库
CREATE DATABASE <database-name>;

--- 删除数据库
DROP DATABASE <database-name>;
# 进入某个数据库
\c <database-name>;--- 创建表(添加约束)
CREATE TABLE person (
id BIGSERIAL NOT NULL PRIMARY KEY,
first_name VARCHAR(50) NOT NULL,
last_name VARCHAR(50) NOT NULL,
gender VARCHAR(10) NOT NULL,
date_of_birth DATE NOT NULL,
country_of_birth VARCHAR(50),
email VARCHAR(150)
);
--- 修改表
ALTER TABLE person ADD PRIMARY KEY(id);
--- 删除字段
ALTER TABLE person DROP column email;
--- 删除全表
DROP TABLE person;DML 操作
--- 插入数据
INSERT INTO person (
    first_name,
    last_name,
    gender,
    date_of_birth
) VALUES ('Yu', 'ZHANG', 'MALE', DATE '1997-06-06');

--- 修改数据内容
UPDATE person SET email = '[email protected]' WHERE id = 20;

--- 删除数据内容
DELETE FROM person WHERE id = 1;
可以使用 ON CONFLICT 关键字来处理冲突:
--- 当发生冲突时不进行操作
INSERT INTO person (
    first_name,
    last_name,
    gender,
    date_of_birth
) VALUES ('Yu', 'ZHANG', 'MALE', DATE '1997-06-06') ON CONFLICT (id) DO NOTHING;

--- 当发生冲突时更新指定字段
INSERT INTO person (
    first_name,
    last_name,
    gender,
    date_of_birth
) VALUES ('Yu', 'ZHANG', 'MALE', DATE '1997-06-06') ON CONFLICT (id) DO UPDATE SET email = EXCLUDED.email;
DQL 操作
可以通过 SELECT 命令来对表进行查询,最常用的查看全表命令为
--- 查看表的全部数据
SELECT * FROM person;

--- 查询数据(特定字段)
SELECT first_name, last_name FROM person;
可以通过 WHERE 关键字来进行条件查询、以及多个条件的组合查询:
--- 查询数据(条件筛查,WHERE | AND | OR | 比较 > | >= | < | <= | = | <>)
SELECT * FROM person WHERE gender = 'MALE' AND (country_of_birth = 'Poland' OR country_of_birth = 'China');IN、BETWEEN、LIKE 和 ILIKE 也是一些可以很灵活用于查询的关键字。
IN 可以帮助我们过滤某个字段的多个值。
--- 查询数据(使用 IN 关键词查询)
SELECT * FROM person WHERE country_of_birth IN ('China', 'Brazil', 'France');
BETWEEN 可以帮助我们过滤某个字段的一个范围。
--- 查询数据(使用 BETWEEN 关键词查询)
SELECT * FROM person WHERE date_of_birth BETWEEN DATE '2021-10-10' AND '2022-08-31';
LIKE 可以帮助我们进行一些包含关系的模糊搜索,% 可以匹配任一个字符,_ 可以匹配单个字符。而 ILIKE 则是不区分大小写的 LIKE。
--- 查询数据(使用 LIKE/ILIKE 关键词查询,_ | %)
SELECT * FROM person WHERE email LIKE '%@bloomberg.%';
SELECT * FROM person WHERE email LIKE '________@google.%';
SELECT * FROM person WHERE country_of_birth ILIKE 'p%';
实际应用中,往往数据表的数据量非常庞大,会对数据根据相应条件进行分组,这就要用到 GROUP BY 关键字,以及 HAVING 用于进一步筛选条件。GROUP BY 需要配合聚合函数进行使用。
--- 查询数据(使用 GROUP BY 关键词分组查询,使用 HAVING 关键词添加条件,使用 AS 对结果别名)
SELECT country_of_birth, COUNT(*) AS Amount FROM person GROUP BY country_of_birth HAVING Amount > 5 ORDER BY country_of_birth;
有时候我们只需要返回唯一值,而需要去掉重复数据,则可以使用 DISTINCT 关键字
--- 查询数据(去重)
SELECT DISTINCT country_of_birth FROM person;
在实际应用中,还很有可能会需要对某些商品交易量进行排名、对一些数值进行排列或博客文章中按照时间线后进行顺序显示等,这就需要用到 ORDER BY 这一关键字,它默认为 ASC 升序排列,可以通过手动设置 DESC 来实现降序。
--- 查询数据(排序 ASC | DESC)
SELECT * FROM person ORDER BY id, country_of_birth;
同时,有的数据库数据量非常大,一次返回所有的数据比较消耗资源,因此也可以使用 LIMIT 关键字来约束返回的记录数,同时可以使用 OFFSET 指定偏移量。
--- 查询数据(指定数量与偏移量)
SELECT * FROM person OFFSET 5 LIMIT 10;
SELECT * FROM person OFFSET 5 FETCH FIRST 5 ROW ONLY;
核心概念
PRIMARY KEY 主键
主键在数据表中的唯一身份记录,用以下命令创建与修改:
--- 添加主键
CREATE TABLE person (
    id BIGSERIAL NOT NULL PRIMARY KEY
);

--- 修改主键
ALTER TABLE person ADD PRIMARY KEY(id);
其中主键通常会使用 SERIAL/BIGSERIAL 递增 INT 值,也可以使用 UUID 作为主键。
CREATE TABLE person (
    id UUID NOT NULL PRIMARY KEY
);
FOREIGN KEY 外键
外键是一种特殊的主键,它是另一个表的主键,用以下命令创建与修改:
--- 添加外键
CREATE TABLE person (
    id BIGSERIAL NOT NULL PRIMARY KEY,
    car_id BIGINT REFERENCES car (id),
    UNIQUE(car_id)
);

--- 修改外键
CREATE TABLE car (
    id BIGSERIAL NOT NULL PRIMARY KEY
)
JOIN 联表查询
联表查询是指在查询时,将多个表中的数据进行连接,以便查询出更多的信息。在 SQL 中,我们可以使用 JOIN 关键字来实现联表查询,使用 LEFT JOIN 关键字来实现左联表查询,使用 RIGHT JOIN 关键字来实现右联表查询。
--- JOIN 联表查询
SELECT * FROM person
JOIN car ON person.car_id = car.id

--- LEFT JOIN 左联表查询
SELECT * FROM person
LEFT JOIN car ON person.car_id = car.id
可以通过 USING 关键字来简化 ON 关键字的使用。
SELECT * FROM person
LEFT JOIN car USING (car_id);
约束
CONSTRAINT 约束是用来限制数据表中的数据的,我们可以通过以下命令来添加约束:
ALTER TABLE person ADD CONSTRAINT gender_constraint CHECK (gender = 'Female' OR gender = 'Male');例如通过添加 UNIQUE 来显示唯一:
CREATE TABLE person (
    id BIGSERIAL NOT NULL PRIMARY KEY,
    email VARCHAR(150) UNIQUE
);

ALTER TABLE person ADD CONTRAINT unique_email_address UNIQUE (email);
常用技巧
聚合函数
内置了很多聚合函数,例如 COUNT、SUM、AVG、MIN、MAX 等,用于对数据进行聚合计算。
COALESCE
在查询数据时我们可以使用 COALESCE 填充默认值:
--- 使用 COALESCE 填充默认值
SELECT COALESCE(email, 'Email Not Provided') FROM person;
NULLIF
使用 NULLIF 关键字,当第二个参数与第一个相同时返回 NULL,否则返回第一个参数,用于防止一些被除数为 0 的报错等。
SELECT COALESCE(10 / NULLIF(0, 0), 0);时间
时间的显示格式如下:
SELECT NOW();
SELECT NOW()::DATE;
SELECT NOW()::TIME;
我们可以对时间进行运算:
SELECT NOW() - INTERVAL '1 YEAR';
SELECT NOW() + INTERVAL '10 MONTHS';
SELECT (NOW() - INTERVAL '3 DAYS')::DATE;
可以通过 EXTRACT 来获取时间的某个部分:
SELECT EXTRACT(YEAR FROM NOW());
SELECT EXTRACT(MONTH FROM NOW());
SELECT EXTRACT(DAY FROM NOW());
SELECT EXTRACT(DOW FROM NOW());
SELECT EXTRACT(CENTURY FROM NOW());
可以通过 AGE 关键字来计算年龄差值:
SELECT first_name, last_name, AGE(NOW(), date_of_birth) AS age FROM person;拓展支持
PostgreSQL 提供了许多拓展,以实现更丰富的功能。
安装拓展
CREATE EXTENSION IF NOT EXISTS "uuid-ossp";查看拓展方法
df使用拓展方法
SELECT uuid_generate_v4();总结
以上就是我对 PostgreSQL 的基础知识与实用操作的讲解,希望对你有所帮助。