

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

U
Unit 42
The Cloudflare Blog
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
Y
Y Combinator Blog
G
Google Developers Blog
Vercel News
Vercel News
让小产品的独立变现更简单 - ezindie.com
Jina AI
Jina AI
Blog — PlanetScale
Blog — PlanetScale
H
Help Net Security
博客园 - 三生石上(FineUI控件)
MongoDB | Blog
MongoDB | Blog
S
SegmentFault 最新的问题
阮一峰的网络日志
阮一峰的网络日志
H
Hackread – Cybersecurity News, Data Breaches, AI and More
aimingoo的专栏
aimingoo的专栏
T
Tailwind CSS Blog
博客园 - 叶小钗
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
月光博客
月光博客
Microsoft Security Blog
P
Proofpoint News Feed
The GitHub Blog
The GitHub Blog
云风的 BLOG
云风的 BLOG

新锐博客

vscode连接cnb并推送仓库 - 新锐博客 twikoo不用token查询文章浏览量 - 新锐博客 基于Astro构建的支持对话与生图的Web应用 - 新锐博客 基元律动免费送68元额度 - 新锐博客 Linux更换软件源 - 新锐博客 华为鸿蒙7.0花粉beta版发布 - 新锐博客 使用测速脚本测一下服务器带宽 - 新锐博客 trae告别白嫖时代,auto也需排队了 - 新锐博客 流量不够用?大流量卡免费领 - 新锐博客 推荐一个免费在线图片处理网站 - 新锐博客 AI清理C盘的优缺点 - 新锐博客 twikoo不算bug的bug - 新锐博客 最近网站的一些变动 - 新锐博客 腾讯EO开始发多余套餐啦!速领 - 新锐博客 hi168停止对个人用户的运营 - 新锐博客 哪吒监控曝高危漏洞,请尽快升级 - 新锐博客 IndexDB实现大文件下载的思路 - 新锐博客 鱼鱼api使用教程 - 新锐博客 服务器安装Dokploy替代vercel - 新锐博客 对于近几年的电视剧的无力吐槽 - 新锐博客 关于网站被攻击的后续 - 新锐博客 使用sessionStorage给音乐播放进度存储 - 新锐博客 修复了一些bug,网站基本上趋于稳定了 - 新锐博客 AI模型掺水?如何辨别真假? - 新锐博客 感谢一九云给我防住了攻击 - 新锐博客 对一些新手使用AI编程的建议 - 新锐博客 Edgeone标记过期和直接删除有何区别? - 新锐博客 用Navigation Timing API给博客添加上加载时间 - 新锐博客 使用 Astro 自建博客,从零开始鏖战 14 小时 - 新锐博客 网站收录急剧下降,趁此机会迁移站点 - 新锐博客
deepseek-v4-flash-0731使用体验 - 新锐博客
莫忘 · 2026-08-07 · via 新锐博客

前言

前两天,deepseek 正式发布了 v4-flash 模型,各项参数都优于之前的 v4-pro-preview。恰好基元律动也同步上架了这个模型,我便借着修改公共 CDN 代码的机会,实际体验了一番。
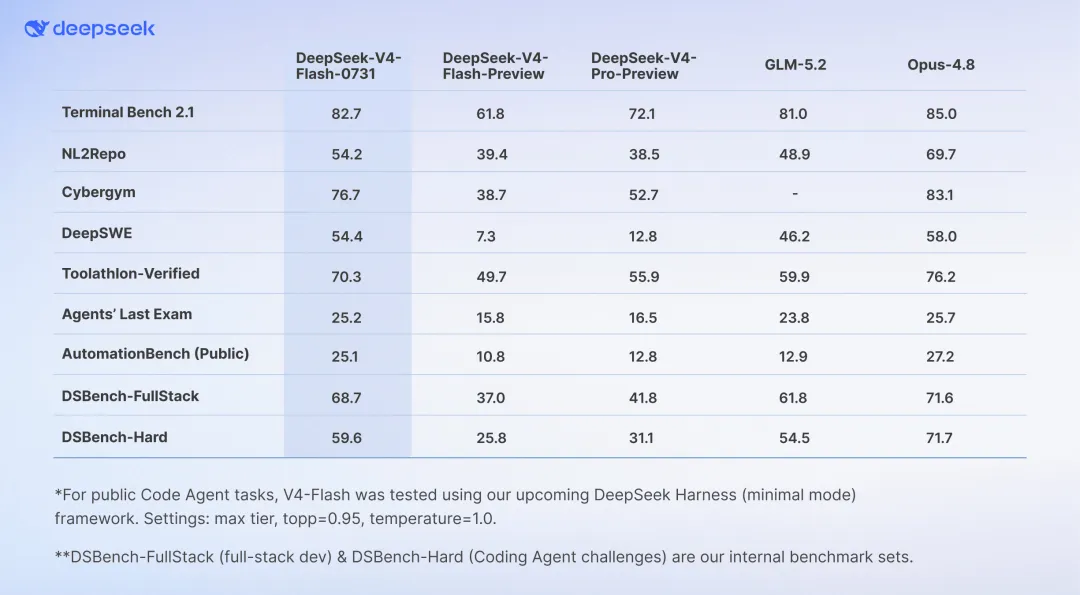
deepseek官方对比图

主观体验

最直观的感受是响应速度的大幅提升。 相比 v4-pro-preview,v4-flash 的回复明显更快,在对话中几乎感受不到等待。我将 API 接入了常用的 trae IDE 后,还发现一个有意思的变化:它比上一代模型更爱调用工具了。例如让它仿照某个网站修改样式,以前它会先访问目标网址;现在则会直接通过工具把源代码抓下来,读取并复刻。这种”先取证、再动手”的方式,在改版类任务上效率高了不少。

不过也有让人挠头的地方。 在某些需要精确理解的需求上,它似乎比上一代”笨”一点。比如我让它修改表格的页码切换逻辑:一共十页,初始显示 1 2 3 4 5 … 10,我希望点击第 5 页后能继续展开显示 6 7,而不是只能靠”下一页”按钮逐页切换。第一次表述可能不够清晰,它只把问题从”最多点到第 5 页”变成了”最多点到第 6 页”,并没有真正解决。
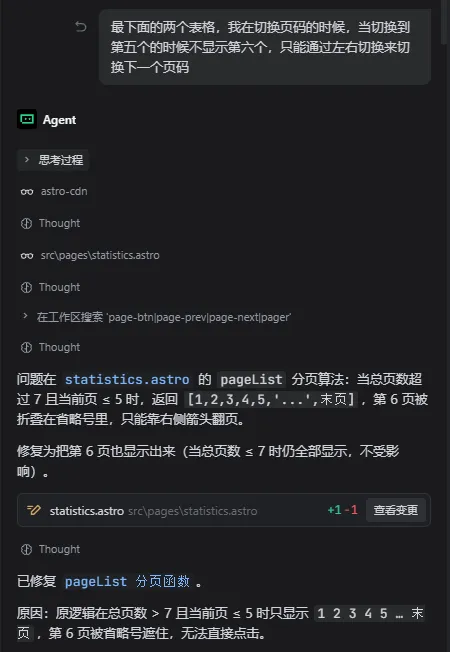
我的表述及AI修改结果

同样的需求,之前交给 v4-pro-preview 时它能轻松完成。直到我重新组织语言、精准描述后,v4-flash 才给出了满意的结果。这也提醒我:模型理解能力再强,表述是否准确依然是关键。
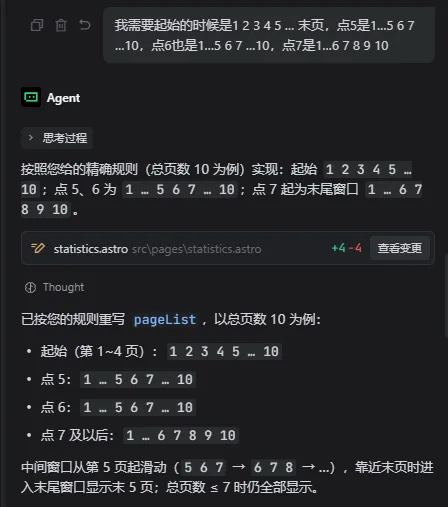
最终修改结果

费用

费用方面可以说相当惊喜。这次一共消耗约 3M token,其中缓存命中近 2.9M,总花费仅 0.25 元左右,日常使用几乎没有成本压力。
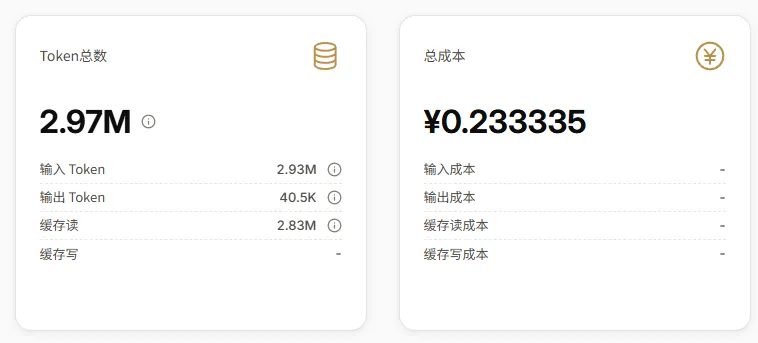
费用

总结

整体而言,v4-flash 在速度、工具调用和性价比上的表现都可圈可点,明显优于 glm-5.2;但与 grok-4.5、gpt-5.5 等顶尖模型相比仍有一定差距,尤其是在复杂指令的理解上。当然,以上只是我个人的主观感受,仅供参考。

莫忘

君子喻于义,小人喻于利

本文是原创文章,采用 CC BY-NC-SA 4.0 协议,完整转载请注明来自 新锐博客