








十几年来,我的硬盘里攒了大量电子书——EXE、CHM、PDF、TXT、EPUB……光是 E 书格式的就存了几百本。可当我把它们从旧电脑拷到新电脑上时,问题接二连三地冒了出来:
归根结底一句话:那些曾经能读的书,现在读不了了。
我需要一种任何设备、任何系统、任何浏览器都能打开的格式。翻了一圈,只有 HTML 满足条件。
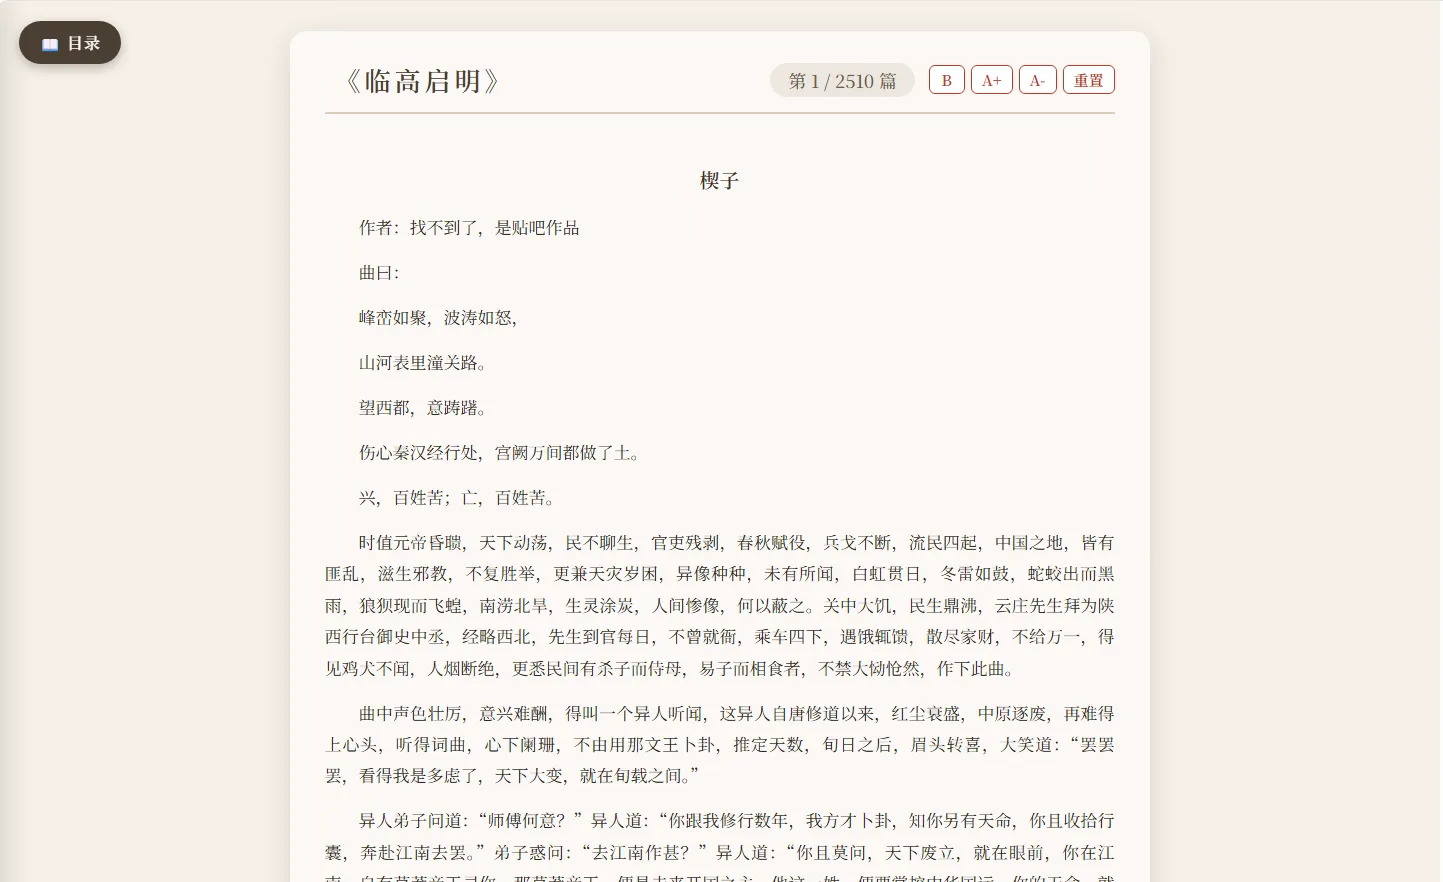
这个方向很明确,但另一个问题随之而来——当时市面上没有现成的、能撑起一本大书的 HTML 模板。
我决定用 DeepSeek 来开发一套属于自己的阅读器模板。需求很简单:
"帮我写一个阅读器的 HTML,能加载 JSON 格式的电子书数据,有目录、翻页、字体调整,还能自动记住阅读进度。"
DeepSeek 很快生成了初版代码。我复制、保存、打开测试——能跑,但一加载《临高启明》的 JSON 数据(2500 多章、近 30MB)浏览器就卡死了。
于是我又向 DeepSeek 描述问题,它给出了优化方案:
"用 IndexedDB 做持久化缓存 + 流式加载 + 分页渲染目录。"
改完代码再试,流畅了。就这样,我与 DeepSeek 合作,边测边改,边改边测,前前后后迭代了十几次,逐步打磨出了一套能扛住千万字级别的阅读器模板。
以下是 DeepSeek 帮我解决的主要难题:
fetch + ReadableStream 流式读取 + 实时进度条,边下载边解析。localStorage 保存每篇的滚动位置,超出 200 条自动清理旧记录。因为自己本身有一个小小的网站,就想把书籍都搬到网上,一方面方便自己随时随地阅读,另一方面也想把整理好的电子书分享给更多人。
目前已上线的书籍:
分享的理由很简单:这些书大多是公版古籍或公开的网络文学,版权上没有问题。好东西应该被阅读、被传播,而不是锁在硬盘里。
| 功能 | 说明 |
|---|---|
| 加载机制 | IndexedDB 缓存 + 流式加载 + 实时进度条 |
| 目录系统 | 按卷分组 + 分页渲染(50 条/批) |
| 阅读交互 | 键盘翻页 + 触屏滑动 + 字体调节 |
| 进度保存 | 页码 + 滚动位置 + 阅读进度百分比 |
| 安全防护 | 前端防盗链 + XSS 净化 |
模板完全基于原生 HTML + CSS + JS,不依赖任何框架,一个 HTML 文件就是完整的阅读器。
回顾整个过程,有几个真实感受:
AI 是强大的助手,但不是全自动工具。 它帮我写代码、优化性能、修 Bug,但需要我不断测试、反馈、验证。它替我完成了"从需求到代码"的转换,而我要做的是清晰描述问题、判断方案是否合适、确认最终效果。这是一种协作式开发,而不是一键生成。
原生技术依然有它的价值。 这套模板没有任何 npm 依赖,纯粹的 HTML + CSS + JS。脱离框架后,这个文件具备了极好的"长寿性"——十年后,只要浏览器还支持 ES6,它依然能跑。
工具的意义在于解决问题。 这套模板对我来说,是为了让那些躺在硬盘里的电子书"活过来"。对别人而言,它让几百本书重新变得可读、可分享、可传承。
https://ziyege.com/book/欢迎使用,也欢迎提出改进建议。
📧 联系:如有问题或想法,欢迎交流。
最后更新:2026 年 7 月
THE END
©版权申明
- 版权属于 @郭大路,作品采用


 CC BY-NC-SA 4.0
进行许可
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。