再次总结经典算法题目。
一个程序的运行时间主要和两个因素有关:
1.执行每条语句的耗时。2.执行每条语句的频率。前者取决于硬件,后者取决于算法本身和程序的输入。在相同的硬件环境下,不同算法的执行时间只取决于语句的执行频率,因此可以将对执行时间的关注进一步简化为对执行频率的关注。
定义 :$T(n) = O(f(n))$ 表示当 $n$ 趋于无穷大时,$T(n)$ 的增长率不超过 $f(n)$。
复杂度 名称 形象描述 典型案例 $O(1)$ 常数阶 无论数据多少,一瞬间完成 数组下标取值、哈希表单次查询 $O(\log n)$ 对数阶 每走一步,范围缩小一半 二分查找(Binary Search) $O(n)$ 线性阶 每一个都要过一遍 简单遍历、求最大值 $O(n \log n)$ 线性对数阶 比较高效的排序 快速排序、归并排序、堆排序 $O(n^2)$ 平方阶 每个人都要跟所有人打个招呼 冒泡排序、插入排序、嵌套循环 $O(2^n)$ 指数阶 噩梦,数据多一点点就炸了 暴力解斐波那契、汉诺塔 $O(n!)$ 阶乘阶 宇宙爆炸级别 全排列问题(旅行商问题暴力解)
总时间 = 递归调用的总次数 $\times$ 每次调用产生的额外工作量
当你看不清逻辑时,就把递归画成一棵树。每一层代表递归的一级,每个节点代表一次函数调用。
例子:斐波那契数列(暴力递归)
1 fib (n) fib (n-1 ) + fib (n-2 )
树的深度 :$n$。每一层的节点数 :每个节点分出 2 个子节点,第 $k$ 层就有 $2^k$ 个节点。总节点数 :$1 + 2 + 4 + … + 2^{n-1} \approx 2^n$。结论 :复杂度是 $O(2^n)$。这是指数级的,数据稍微大一点(比如 $n=50$)电脑就跑不动了。例子:归并排序 (Merge Sort)
把数组对半切开:$2 \times T(n/2)$ 合并两个有序数组:$O(n)$ 树的深度 :$\log n$(因为每次都砍一半,砍 $\log n$ 次就剩 1 个了)。每一层的工作量 :每一层的所有节点合并起来的总长度永远是 $n$,所以每一层的工作量都是 $O(n)$。结论 :$O(n \times \log n)$。如果你面对的是类似“分治法”的递归(规模按比例缩小),可以直接套用主定理 。它的标准形式是:
$a$:产生的子问题个数。 $n/b$:每个子问题的规模(把原问题缩小的倍数)。 $f(n)$:递归之外要做的工作(比如合并结果的花费)。 快速判断口诀:
如果 $f(n)$ 很大 (合并比递归慢):复杂度就是 $O(f(n))$。如果 $a$ 很大 (分裂出的子问题太多):复杂度就是 $O(n^{\log_b a})$。如果两边差不多 (比如归并排序):复杂度就是 $O(f(n) \cdot \log n)$。递归不仅耗时间,还非常耗内存 。递归的空间复杂度 = 递归调用的最大深度 $\times$ 每次调用产生的辅助空间 即使你的递归里没开数组,每次函数调用都会在 系统栈(Stack) 里压入一个“栈帧”(保存局部变量、返回地址等)。
最大公因数gcd
1
2
3
4
5
6
7
8
9
10
11
12
13
14
int gcd (int a,int b) return b==0 ?a:gcd (b,a%b); } int gcd (int a,int b) while (b!=0 ) { int tmp = a; a = b; b = tmp%b; } return a; } int lcm (int a, int b) return a * b / gcd (a, b); }
利用辗转相除法,可以很方便地求得两个数的最大公因数(greatest common divisor,GCD);将两个数相乘再除以最大公因数即可得到最小公倍数(least common multiple, LCM)。
也可以通过扩展欧几里得算法(extended gcd)在求得 a 和 b 最大公因数的同时,也得到它们的系数 x 和 y,从而使 ax + by = gcd(a, b)
普通欧几里得算法只能帮你算出 $a$ 和 $b$ 的最大公约数(GCD) ,而扩展欧几里得算法不仅能算出 GCD,还能帮你找到一对整数 $x, y$,使得它们满足贝祖等式(Bézout’s identity) :
普通 GCD 的递归项是 $\text{gcd}(a, b) = \text{gcd}(b, a \pmod b)$。
假设我们已经通过递归,找到了下一层状态 $b$ 和 $a \pmod b$ 的解 $x’$ 和 $y’$,即:
因为 $a \pmod b = a - \lfloor a/b \rfloor \cdot b$,代入上式:
整理一下,把含有 $a$ 和 $b$ 的项分开:
对比最原始的等式 $ax + by = \text{gcd}(a, b)$,我们可以直接得出 $x$ 和 $y$ 的变换规律:
$x = y’$ $y = x’ - \lfloor a/b \rfloor \cdot y’$ 1 2 3 4 5 6 7 8 9 10 long long exgcd (long long a, long long b, long long &x, long long &y) if (b == 0 ) { x = 1 ; y = 0 ; return a; } long long d = exgcd (b, a % b, y, x); y -= (a / b) * x; return d; }
EXGCD 并不是为了算 GCD 凑热闹的,它的主要应用在以下三个领域:
A. 求解模反元素(Modular Inverse)
如果你需要计算 $(a / b) \pmod m$,由于取模运算不支持直接除法,你需要找到 $b$ 的逆元 $x$,满足 $bx \equiv 1 \pmod m$。
这等价于解方程:$bx + my = 1$。
只有当 $\text{gcd}(b, m) = 1$ 时,逆元才存在。
B. 求解线性同余方程
求解 $ax \equiv c \pmod m$。
这可以转化为 $ax + my = c$。只要 $c$ 是 $\text{gcd}(a, m)$ 的倍数,方程就有解。
C. 中国剩余定理 (CRT)
在处理多个同余方程组时,EXGCD 是合并方程的核心工具。
求模和取余在有负数时表现不同,对于a%b和a mod b
% (取余 - Remainder)左边 是老板。结果的符号跟被除数(左边的 $a$)一致。
mod (取模 - Modulo)右边 是老板。结果的符号跟除数(右边的 $b$)一致。
数学本质:向 0 靠拢 vs 向负无穷靠拢
之所以符号不同,是因为它们在处理 $a / b$ 的商(quotient)时,取整的方向不同。取余 (%) :使用 截断取整(Truncate) 。往 $0$ 的方向靠。取模 (mod) :使用 地板取整(Floor) 。往负无穷的方向靠(向下取整)。
质数又称素数,指的是指在大于 1 的自然数中,除了 1 和它本身以外不再有其他因数的自然数。值得注意的是,每一个数都可以分解成质数的乘积 。
基础方案:平方根试除法 ($O(\sqrt{n})$) 这是最直观的方法。核心逻辑是:如果 $n$ 有一个大于 $\sqrt{n}$ 的因数,那么它必然有一个对应的因数小于 $\sqrt{n}$。
逻辑 :从 $2$ 遍历到 $\sqrt{n}$,只要能整除就不是质数。注意 :$1$ 不是质数,$2$ 是最小的质数。1 2 3 4 5 6 7 8 bool isPrime (int n) for (int i =2 ;i*i<=n;i++) { if (n%i == 0 ) { return false ; } } return true ; }
进阶优化:$6k \pm 1$ 法(面试推荐) 这是一个非常聪明的优化。除了 $2$ 和 $3$ 之外,所有的质数都可以表示为 $6k-1$ 或 $6k+1$ 的形式。
为什么?
我们将所有整数按 $6$ 的余数分类:
$6k, 6k+2, 6k+3, 6k+4$ 分别能被 $6, 2, 3, 2$ 整除,显然不是质数(除非是 $2$ 和 $3$ 本身)。 剩下的只有 $6k+1$ 和 $6k+5$(即 $6k-1$)。 1 2 3 4 5 6 7 8 9 10 11 12 bool isPrime (int n) if (n <= 3 ) return n > 1 ; if (n % 2 == 0 || n % 3 == 0 ) return false ; for (int i = 5 ; i * i <= n; i += 6 ) { if (n % i == 0 || n % (i + 2 ) == 0 ) return false ; } return true ; }
方法 复杂度 优点 缺点 暴力试除 $O(n)$ 简单到不需要脑子 $n > 10^7$ 基本就废了 平方根优化 $O(\sqrt{n})$ 逻辑清晰,最常用 处理 $10^{14}$ 以上的数开始吃力 $6k \pm 1$ 优化 $O(\frac{\sqrt{n}}{3})$ 常数极小,比普通试除快 3 倍 需要记住 6 的倍数特性 Miller-Rabin $O(k \log^3 n)$ 解决天文数字级别的判定 实现复杂,需要大数处理
根据 $n$ 的范围不同,我们有三种主流的解决方法:
埃氏筛法
埃氏筛的核心思想非常朴素:质数的倍数一定不是质数。
流程 :创建一个长度为 $n+1$ 的布尔数组,初始全部设为“是质数”。 从 $2$ 开始往后扫描。 如果当前数 $i$ 是质数,就把它所有的倍数($2i, 3i, \dots$)全部标记为“不是质数”。 为了优化,可以从 $i \times i$ 开始标记,因为更小的倍数(如 $2i$)在扫描到前面的数字时已经被标记过了。 复杂度 :时间 $O(n \log \log n)$,空间 $O(n)$。评价 :在 $n < 10^7$ 时表现非常出色,代码实现极其简单。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 vector<int > sieve (int n) { vector<bool > isPrime (n + 1 , true ) ; isPrime[0 ] = isPrime[1 ] = false ; for (int i = 2 ; i * i <= n; i++) { if (isPrime[i]) { for (int j = i * i; j <= n; j += i) { isPrime[j] = false ; } } } vector<int > result; for (int i = 2 ; i <= n; i++) { if (isPrime[i]) result.push_back (i); } return result; }
线性筛法
埃氏筛有一个小缺点:一个合数可能被多次重复标记(比如 $6$ 既会被 $2$ 筛掉,也会被 $3$ 筛掉)。线性筛通过让每个合数只被它的最小质因子筛掉 ,实现了严格的 $O(n)$ 复杂度。
通过核心逻辑 if (i % p == 0) break;,保证每个合数只被它的最小质因子筛掉一次 。
1 2 3 4 5 6 7 8 9 10 11 12 13 int countPrimes (int n) vector<int > primes; vector<bool > isPrime (n, true ) ; for (int i = 2 ; i < n; ++i) { if (isPrime[i]) primes.push_back (i); for (int p : primes) { if (i * p >= n) break ; isPrime[i * p] = false ; if (i % p == 0 ) break ; } } return primes.size (); }
分块筛或 Meissel-Lehmer 算法
如果遇到的 $n$ 达到了 $10^{10}$ 甚至更高,内存开不下 $O(n)$ 的数组,线性筛就失效了。
分块筛 :将 $1$ 到 $n$ 分成若干个小块,每块大小约 $\sqrt{n}$,逐块统计,空间复杂度降至 $O(\sqrt{n})$。
Meissel-Lehmer 算法 :这是一种基于数论组合公式的方法,不需要遍历所有数,就能直接计算出质数个数,复杂度约为 $O(n^{2/3})$。
1175.请你帮忙给从 1 到 n 的数设计排列方案,使得所有的「质数」都应该被放在「质数索引」(索引从 1 开始)上;你需要返回可能的方案总数。
让我们一起来回顾一下「质数」:质数一定是大于 1 的,并且不能用两个小于它的正整数的乘积来表示。
由于答案可能会很大,所以请你返回答案 模 mod 10^9 + 7 之后的结果即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 class Solution {public : long long factorial (int n) if (n==0 ){ return 1 ; } if (n == 1 ) { return 1 ; } return (n * factorial (n - 1 )) % (MOD); } const int MOD = 1e9 + 7 ; int calcPrimesCount (int n) vector<bool > isPrimes (1 + n, true ) ; int cnt = n - 1 ; for (int i = 2 ; i <= n; i++) { if (isPrimes[i]) { for (int j = i * i; j <= n; j += i) { if (isPrimes[j]) { isPrimes[j] = false ; cnt--; } } } } return cnt; } int LinearcalcPrimesCount (int n) vector<bool > isPrimes (1 + n, true ) ; vector<int > primes; for (int i = 2 ; i <= n; i++) { if (isPrimes[i]) { primes.push_back (i); } for (int & t : primes) { int num = t * i; if (num > n) { break ; } isPrimes[num] = false ; if (i % t == 0 ) { break ; } } } return primes.size (); } int numPrimeArrangements (int n) int m = calcPrimesCount (n); return (int ) (factorial (m) * factorial (n - m) % MOD); } };
模运算有一个非常重要的性质:
这意味着,如果你要计算一连串数字的乘积并取模,你可以在中间任何一步 取模,结果都不会改变。
运算类型 规则 是否等价 加法 $(a + b) \% m = (a\%m + b\%m) \% m$ 是 减法 $(a - b) \% m = (a\%m - b\%m + m) \% m$ 是 (需加 $m$ 防止负数)乘法 $(a \times b) \% m = (a\%m \times b\%m) \% m$ 是 除法 $(a / b) \% m$ 否! (需使用逆元 )
如果需要永远返回正数 的取模结果(例如在处理循环数组下标时),可以使用这个通用的“数学模”技巧:
求解一个数的所有因数
如果 $n \pmod i == 0$,那么 $i$ 就是 $n$ 的因数。 核心思路: 利用对称性。如果 $i$ 是 $n$ 的因数,那么 $n/i$ 必然也是 $n$ 的因数。因此,我们只需要遍历到 $\sqrt{n}$ 即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 vector<int > getDivisors (int n) { vector<int > res; for (int i = 1 ; i * i <= n; i++) { if (n % i == 0 ) { res.push_back (i); if (i * i != n) { res.push_back (n / i); } } } sort (res.begin (), res.end ()); return res; }
求解一个数的质因数分解
将一个合数表示成若干个质数相乘的形式。 核心思路: 试除法。从最小的质数 $2$ 开始尝试,只要能整除,就一直除下去,直到除不动为止,然后再试下一个数。
1 2 3 4 5 6 7 8 9 10 11 vector<int > getPrimeFactors (int n) { vector<int > res; for (int i = 2 ; i * i <= n; i++) { while (n % i == 0 ) { res.push_back (i); n /= i; } } if (n > 1 ) res.push_back (n); return res; }
不同的质因数分解
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 vector<int > getDistinctPrimeFactors (long long n) { vector<int > res; for (long long i = 2 ; i * i <= n; i++) { if (n % i == 0 ) { res.push_back (i); while (n % i == 0 ) { n /= i; } } } if (n > 1 ) { res.push_back (n); } return res; }
2521给你一个正整数数组 nums ,对 nums 所有元素求积之后,找出并返回乘积中 不同质因数 的数目。
注意:
质数 是指大于 1 且仅能被 1 及自身整除的数字。如果 val2 / val1 是一个整数,则整数 val1 是另一个整数 val2 的一个因数。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution {public : int distinctPrimeFactors (vector<int >& nums) unordered_set<int > uset; for (auto n : nums) { for (int i = 2 ; i * i <= n; i++) { if (n % i == 0 ) { uset.insert (i); while (n % i == 0 ) { n /= i; } } } if (n > 1 ) { uset.insert (n); } } return uset.size (); } };
所有数 的质因数利用线性筛(欧拉筛)进行预处理,通过维护一个最小质因子数组 (Minimum Prime Factor, MPF) ,将每个数的分解过程优化到极速。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 const int MAXN = 1000005 ;int min_prime[MAXN]; vector<int > primes; void sieve (int n) for (int i = 2 ; i <= n; i++) { if (min_prime[i] == 0 ) { min_prime[i] = i; primes.push_back (i); } for (int p : primes) { if (p > min_prime[i] || i * p > n) break ; min_prime[i * p] = p; if (i % p == 0 ) break ; } } } vector<int > factorize (int x) { vector<int > factors; while (x > 1 ) { factors.push_back (min_prime[x]); x /= min_prime[x]; } return factors; }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 const int MAXN = 1e6 + 5 ;int min_p[MAXN]; int f[MAXN]; vector<int > primes; void linear_sieve (int n) f[1 ] = 0 ; for (int i = 2 ; i <= n; i++) { if (min_p[i] == 0 ) { min_p[i] = i; primes.push_back (i); f[i] = 1 ; } for (int p : primes) { if (p > min_p[i] || i * p > n) break ; int target = i * p; min_p[target] = p; if (i % p == 0 ) { f[target] = f[i] + 1 ; break ; } else { f[target] = f[i] + 1 ; } } } }
所有数 的不同的质因数个数如果只需要知道每个数有多少个不同 的质因子,线性筛还可以在筛的过程中递推:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 int distinct_count[MAXN];void count_sieve (int n) for (int i = 2 ; i <= n; i++) { if (min_prime[i] == 0 ) { min_prime[i] = i; distinct_count[i] = 1 ; primes.push_back (i); } for (int p : primes) { if (i * p > n) break ; min_prime[i * p] = p; if (i % p == 0 ) { distinct_count[i * p] = distinct_count[i]; break ; } else { distinct_count[i * p] = distinct_count[i] + 1 ; } } } }
最容易理解和编写的方法。我们不关注某个数有哪些因数,而是关注每个数作为因数贡献了多少次 。
逻辑:
准备一个数组 count[n+1],全部初始化为 0。 遍历 $i$ 从 $1$ 到 $n$(作为可能的因数)。 对于每个 $i$,找到它在 $n$ 范围内的所有倍数 $j = i, 2i, 3i, \dots$,并将 count[j] 加 1。 1 2 3 4 5 6 7 8 9 vector<int > countAllDivisors (int n) { vector<int > count (n + 1 , 0 ) ; for (int i = 1 ; i <= n; i++) { for (int j = i; j <= n; j += i) { count[j]++; } } return count; }
如果追求极致的 $O(n)$ 性能,可以利用约数个数定理 和线性筛。
如何利用质因数分解的结果,一秒求出某个数的所有因数个数
约数个数定理:
如果 $i$ 的质因数分解为 $p_1^{a_1} \cdot p_2^{a_2} \cdots p_k^{a_k}$,那么其因数个数为:
假设一个数 $n$ 的质因数分解结果为:
(其中 $p$ 是质因数,$a$ 是该质因数的指数)
那么 $n$ 的所有正因数个数为:
如果你需要批量处理,可以利用之前提到的 min_prime(最小质因子)数组,配合递推公式在 $O(N)$ 时间内完成。
算法逻辑:
我们维护两个数组:
d[i]:数字 $i$ 的因数个数。num[i]:数字 $i$ 的最小质因子的幂次(即上面的 $a_1$)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 const int MAXN = 1000005 ;int d[MAXN], num[MAXN], primes[MAXN], cnt;bool is_prime[MAXN];void get_divisors (int n) d[1 ] = 1 ; for (int i = 2 ; i <= n; i++) { if (!is_prime[i]) { primes[++cnt] = i; d[i] = 2 ; num[i] = 1 ; } for (int j = 1 ; j <= cnt && i * primes[j] <= n; j++) { is_prime[i * primes[j]] = true ; if (i % primes[j] == 0 ) { num[i * primes[j]] = num[i] + 1 ; d[i * primes[j]] = d[i] / (num[i] + 1 ) * (num[i * primes[j]] + 1 ); break ; } else { num[i * primes[j]] = 1 ; d[i * primes[j]] = d[i] * 2 ; } } } }
核心:
1 2 3 4 5 6 7 8 9 10 11 if (i % p == 0 ) { e[i * p] = e[i] + 1 ; d[i * p] = d[i] / (e[i] + 1 ) * (e[i * p] + 1 ); break ; } else { e[i * p] = 1 ; d[i * p] = d[i] * 2 ; }
假设一个数 $n$ 的质因数分解结果为:
那么 $n$ 的所有正约数之和为:
要在 $O(N)$ 时间内递推,逻辑和之前求个数的方法(维护最小质因子指数)极其相似,但这次我们需要维护:
sigma[i]:$i$ 的约数之和。g[i]:$i$ 的最小质因子贡献的那一部分和 (即公式中第一个括号的值:$1 + p_1 + \dots + p_1^{a_1}$)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 const int MAXN = 1000005 ;long long sigma[MAXN], g[MAXN]; int primes[MAXN], cnt;bool not_prime[MAXN];void get_sigma (int n) sigma[1 ] = 1 ; for (int i = 2 ; i <= n; i++) { if (!not_prime[i]) { primes[++cnt] = i; sigma[i] = i + 1 ; g[i] = i + 1 ; } for (int j = 1 ; j <= cnt && i * primes[j] <= n; j++) { not_prime[i * primes[j]] = true ; if (i % primes[j] == 0 ) { g[i * primes[j]] = g[i] * primes[j] + 1 ; sigma[i * primes[j]] = sigma[i] / g[i] * g[i * primes[j]]; break ; } else { g[i * primes[j]] = primes[j] + 1 ; sigma[i * primes[j]] = sigma[i] * (primes[j] + 1 ); } } } }
属性 约数个数 d(n) 约数之和 σ(n) 基础单位 指数 $(a_i + 1)$ 等比数列和 $(1 + p_i + \dots + p_i^{a_i})$ 质数 $p$ 的值 $2$ $p + 1$ 递推核心 维护最小质因子的指数 维护最小质因子的等比数列和
利用上面的模板,你可以在 $O(N)$ 内一次性求出以下所有属性:
A. 质因子总数(包含重复)
含义 :$12 = 2 \times 2 \times 3 \to f(12) = 3$。递推 :$f(i \cdot p) = f(i) + 1$。B. 不同质因子的个数
含义 :$12 = 2^2 \times 3 \to f(12) = 2$。递推 :如果 i % p == 0:$f(i \cdot p) = f(i)$($p$ 已经出现过了)。 如果 i % p != 0:$f(i \cdot p) = f(i) + 1$($p$ 是新面孔)。 C. 最小质因子的幂次(指数)
含义 :$12 = 2^2 \times 3 \to f(12) = 2$。递推 :如果 i % p == 0:$f(i \cdot p) = f(i) + 1$。 如果 i % p != 0:$f(i \cdot p) = 1$。 四因数
给你一个整数数组 nums,请你返回该数组中恰有四个因数的这些整数的各因数之和。如果数组中不存在满足题意的整数,则返回 0
暴力法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : int sumFourDivisors (vector<int >& nums) int totalSum = 0 ; for (int n : nums) { int count = 0 ; int currentSum = 0 ; for (int i = 1 ; i * i <= n; ++i) { if (n % i == 0 ) { count++; currentSum += i; if (i * i != n) { count++; currentSum += n / i; } } if (count > 4 ) break ; } if (count == 4 ) { totalSum += currentSum; } } return totalSum; } };
欧拉筛
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 class Solution {public : int sumFourDivisors (vector<int >& nums) const int N = 100000 ; vector<int > primes; vector<bool > isNotPrime (N + 1 , false ) ; vector<int > d (N + 1 , 0 ) ; vector<long long > sigma (N + 1 , 0 ) ; vector<int > a (N + 1 , 0 ) ; vector<long long > g (N + 1 , 0 ) ; d[1 ] = 1 ; sigma[1 ] = 1 ; for (int i = 2 ; i <= N; ++i) { if (!isNotPrime[i]) { primes.push_back (i); d[i] = 2 ; sigma[i] = i + 1 ; a[i] = 1 ; g[i] = i + 1 ; } for (int p : primes) { if (i * p > N) break ; isNotPrime[i * p] = true ; if (i % p == 0 ) { a[i * p] = a[i] + 1 ; d[i * p] = d[i] / (a[i] + 1 ) * (a[i * p] + 1 ); g[i * p] = g[i] * p + 1 ; sigma[i * p] = sigma[i] / g[i] * g[i * p]; break ; } else { a[i * p] = 1 ; d[i * p] = d[i] * 2 ; g[i * p] = p + 1 ; sigma[i * p] = sigma[i] * (p + 1 ); } } } int ans = 0 ; for (int n : nums) { if (d[n] == 4 ) ans += sigma[n]; } return ans; } };
给定一个整数 num,将其转化为 7 进制 ,并以字符串形式输出。
进制转换类型的题,通常是利用除法和取模(mod)来进行计算,同时也要注意一些细节,如负数和零。如果输出是数字类型而非字符串,则也需要考虑是否会超出整数上下界。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 string convertToBase7 (int num) { if (num == 0 ) { return "0" ; } string base7; bool is_negative = num < 0 ; num = abs (num); while (num) { int quotient = num / 7 , remainder = num % 7 ; base7 = to_string (remainder) + base7; num = quotient; } return is_negative ? "-" + base7 : base7; }
给定一个非负整数,判断它的阶乘结果的结尾有几个 0。
每个尾部的 0 由 2 × 5 =10 而来,因此我们可以把阶乘的每一个元素拆成质数相乘,统计有多少个 2 和 5。明显的,质因子 2 的数量远多于质因子 5 的数量,因此我们可以只统计阶乘结果里有多少个质因子 5。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : int trailingZeroes (int n) int cnt{}; for (int i = 5 ; i <= n; i++) { int tmp = i; while (tmp % 5 == 0 ) { cnt++; tmp /= 5 ; } } return cnt; } };
字符串相加。给定两个字符串形式的非负整数 num1 和num2 ,计算它们的和并同样以字符串形式返回。
你不能使用任何內建的用于处理大整数的库(比如 BigInteger), 也不能直接将输入的字符串转换为整数形式
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : string addStrings (string num1, string num2) { string res; int sz1 = num1. size (); int sz2 = num2. size (); int i = sz1 - 1 , j = sz2 - 1 ; int car{}; while (i >= 0 || j >= 0 ) { int r = car; r += (i >= 0 ) ? (num1[i--] - '0' ) : 0 ; r += (j >= 0 ) ? (num2[j--] - '0' ) : 0 ; res = to_string (r % 10 ) + res; car = r / 10 ; } if (car > 0 ) { res = "1" + res; } return res; } };
实现 pow(x , n ) ,即计算 x 的整数 n 次幂函数(即,xn )。
利用递归,可以较为轻松地解决本题。注意边界条件的处理。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 double myPow (double x, int n) if (n == 0 ) { return 1 ; } if (x == 0 ) { return 0 ; } if (n == numeric_limits<int >::min ()) { return 1 / (x * myPow (x, numeric_limits<int >::max ())); } if (n < 0 ) { return 1 / myPow (x, -n); } if (n % 2 != 0 ) { return x * myPow (x, n - 1 ); } double myPowSqrt = myPow (x, n >> 1 ); return myPowSqrt * myPowSqrt; }
给定一个数组,要求实现两个指令函数。第一个函数“shuffle”可以随机打乱这个数组,第二个函数“reset”可以恢复原来的顺序。
采用经典的 Fisher-Yates 洗牌算法,原理是通过随机交换位置来实现随机打乱,有正向和反向两种写法,且实现非常方便。注意这里“reset”函数以及 Solution 类的构造函数的实现细节。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : vector<int > nums; vector<int > onums; Solution (vector<int >& nums) :nums (nums), onums (nums) {} vector<int > reset () { return onums; } vector<int > shuffle () { for (int i = nums.size () - 1 ; i >= 0 ; i--) { swap (nums[i], nums[rand () % (i + 1 )]); } return nums; } };
洗牌算法 :
对于数组nums,其长度为n。我们调用shuffle()方法返回的数组,应该有n !种可能,我们就可以说shuffle()方法返回的数组是随机的。
那最简单直白的做法就是,将数组nums的n !种排列组合都提前生成出来,每调用一次shuffle(),就取一种nums的排列组合出来返回。
这时候就轮到我们的洗牌算法 出场了。不需要提前把n !种排列组合都生成好。
洗牌算法的思路很简单。我们有个长度为n 的数组nums,对于每个nums[i]来说,都生成一个[i ,n −1]范围的随机数,作为random_idx,然后交换nums[i]和nums[random_idx。
为什么说洗牌算法 实现的shuffle()返回的数组会有n !种可能呢?
对于nums[0],它可能会和[0,n −1]范围内的任何一个数交换,有n 种可能。 对于nums[1],它可能会和[1,n −1]范围内的任何一个数交换,有n −1种可能。 … 对于nums[n-1],它只能和nums[n-1]自己交换,只有1种可能。 所以总的可能性是: n +(n −1)+(n −2)+…+1=n !
按权重随机选择
给你一个 下标从 0 开始 的正整数数组 w ,其中 w[i] 代表第 i 个下标的权重。
请你实现一个函数 pickIndex ,它可以 随机地 从范围 [0, w.length - 1] 内(含 0 和 w.length - 1)选出并返回一个下标。选取下标 i 的 概率 为 w[i] / sum(w) 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 class Solution {public : vector<int >& w; vector<int > prefix_sum; Solution (vector<int >& w) : w (w), prefix_sum (w.size ()) { prefix_sum[0 ] = w[0 ]; for (int i = 1 ; i < prefix_sum.size (); i++) { prefix_sum[i] = prefix_sum[i - 1 ] + w[i]; } } int lower_bound (vector<int >& nums, int val) int left = 0 , right = nums.size () - 1 ; int res{}; while (left <= right) { int mid = (right - left) / 2 + left; if (nums[mid] >= val) { res = mid; right = mid - 1 ; } else { left = mid + 1 ; } } return res; } int pickIndex () int randomVal = (rand () % (prefix_sum.back ())) + 1 ; int res_idx = lower_bound (prefix_sum, randomVal); return res_idx; } };
不用加号的加法
设计一个函数把两个数字相加。不得使用 + 或者其他算术运算符。
考虑两个二进制位相加的四种情况如下:
0 + 0 = 0
在不考虑进位的情况下,其无进位加法结果为 a⊕b。
而所有需要进位的位为 a & b,进位后的进位结果为 (a & b) << 1。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : int add (int a, int b) while (b != 0 ) { unsigned int car = (a & b) << 1 ; a = a ^ b; b = car; } return a; } };
两数相除
给你两个整数,被除数 dividend 和除数 divisor。将两数相除,要求 不使用 乘法、除法和取余运算。
整数除法应该向零截断,也就是截去(truncate)其小数部分。例如,8.345 将被截断为 8 ,-2.7335 将被截断至 -2 。
返回被除数 dividend 除以除数 divisor 得到的 商 。
注意: 假设我们的环境只能存储 32 位 有符号整数,其数值范围是 [−231, 231 − 1] 。本题中,如果商 严格大于 231 − 1 ,则返回 231 − 1 ;如果商 严格小于 -231 ,则返回 -231 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int divide (int dividend, int divisor) if (dividend == INT_MIN && divisor == -1 ) return INT_MAX; if (dividend == INT_MIN && divisor == 1 ) return INT_MIN; bool negative = (dividend > 0 ) ^ (divisor > 0 ); int a = dividend > 0 ? -dividend : dividend; int b = divisor > 0 ? -divisor : divisor; int res = 0 ; while (a <= b) { int value = b; int k = 1 ; while (value >= (INT_MIN >> 1 ) && a <= (value << 1 )) { value <<= 1 ; k <<= 1 ; } a -= value; res += k; } return negative ? -res : res; } };
1 while (value >= (INT_MIN >> 1 ) && a <= (value << 1 ))
这行代码有两个判断条件:
value >= (INT_MIN >> 1)这是安全检查 。 因为接下来我们要执行 value << 1(即乘以 $2$)。如果 value 已经比 INT_MIN 的一半还要小了,再乘 $2$ 就会溢出。 a <= (value << 1)这是空间检查 。 翻译成白话:“如果我把现在除数再翻一倍,被除数 $a$ 还够不够减?” 如果够减,就执行 value <<= 1(价值翻倍)和 k <<= 1(数量翻倍)。 字符串相乘
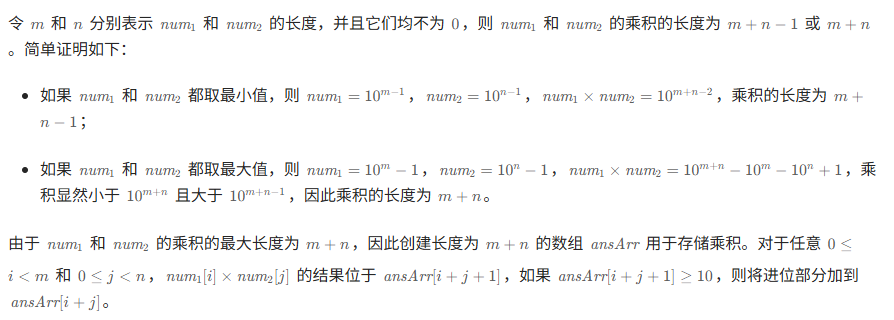
给定两个以字符串形式表示的非负整数 num1 和 num2,返回 num1 和 num2 的乘积,它们的乘积也表示为字符串形式。
注意: 不能使用任何内置的 BigInteger 库或直接将输入转换为整数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : string multiply (string num1, string num2) { if (num1 == "0" || num2 == "0" ) { return "0" ; } int n1 = num1. size (); int n2 = num2. size (); vector<int > ans (n1 + n2) ; for (int i = n1 - 1 ; i >= 0 ; i--) { for (int j = n2 - 1 ; j >= 0 ; j--) { int mul = (num1[i] - '0' ) * (num2[j] - '0' ) + ans[i + j + 1 ]; ans[i + j + 1 ] = mul % 10 ; ans[i + j] += mul / 10 ; } } string res; for (int i = 0 ; i < ans.size (); i++) { if (res.empty () && ans[i] == 0 ) { continue ; } res += to_string (ans[i]); } return res; } };
1 2 3 int sum = mul + res[i + j + 1 ]; res[i + j + 1 ] = sum % 10 ; res[i + j] += sum / 10 ;
这种写法的精妙之处在于:它把复杂的进位处理变成了“原地滚雪球”。 你不需要写 while 循环去处理连续进位(比如 $999 + 1$),因为外层的 i, j 循环在向左移动时,会自动处理掉之前留在 res[i+j] 里的进位。
x的平方根
给你一个非负整数 x ,计算并返回 x 的 算术平方根 。
由于返回类型是整数,结果只保留 整数部分 ,小数部分将被 舍去 。
注意: 不允许使用任何内置指数函数和算符,例如 pow(x, 0.5) 或者 x ** 0.5
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : int mySqrt (int x) int left = 1 , right = x; int ans{}; while (left <= right) { int mid = (right - left) / 2 + left; if (mid <= x/mid) { ans = mid; left = mid + 1 ; } else { right = mid - 1 ; } } return ans; } };
此外也可以用牛顿迭代法
计数质数
给定整数 n ,返回 所有小于非负整数 n 的质数的数量 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : int countPrimes (int n) if (n <= 1 ) { return 0 ; } int cnt = n - 2 ; vector<bool > isPrime (n, true ) ; for (int i = 2 ; i < n; i++) { if (isPrime[i]) { for (long long j = (long long )i * i; j < n; j += i) { if (isPrime[j]) { cnt--; isPrime[j] = false ; } } } } return cnt; } };
丑数
丑数 就是只包含质因数 2、3 和 5 的 正 整数。
给你一个整数 n ,请你判断 n 是否为 丑数 。如果是,返回 true ;否则,返回 false
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : bool isUgly (int n) if (n <= 0 ) { return false ; } vector<int > factor = {2 ,3 ,5 }; for (auto & f:factor) { while (n%f == 0 ) { n/=f; } } return n==1 ; } };
质数:质数概念,质数筛选法 实现加减乘除、平方、次方以及开根号。 矩阵运算,矩阵基本性质,矩阵旋转。 最大公约数。 排列组合。 位运算是算法题里比较特殊的一种类型,它们利用二进制位运算的特性进行一些奇妙的优化和计算。常用的位运算符号包括:
∧:按位异或&:按位与|:按位或~:取反<<:算术左移>>:算术右移以下是一些常见的位运算特性,其中 0s 和 1s 分别表示只由 0 或 1 构成的二进制数字。
1 2 3 x ^ 0s = x x & 0s = 0 x | 0s = x x ^ 1s = ~x x & 1s = x x | 1s = 1s x ^ x = 0 x & x = x x | x = x
除此之外,n & (n - 1) 可以去除 n 的位级表示中最低的那一位,例如对于二进制表示 11110100,减去 1 得到 11110011,这两个数按位与得到 11110000。n & (-n) 可以得到 n 的位级表示中最低的那一位 ,例如对于二进制表示 11110100,取负得到 00001100,这两个数按位与得到 00000100。x - x&(-x) = x&(x-1)
给定多个字母串,求其中任意两个字母串的长度乘积的最大值,且这两个字母串不能含有相同字母。
怎样快速判断两个字母串是否含有重复数字呢?可以为每个字母串建立一个长度为 26 的二进制数字,每个位置表示是否存在该字母。如果两个字母串含有重复数字,那它们的二进制表示的按位与不为 0。同时,我们可以建立一个哈希表来存储二进制数字到最长子母串长度的映射关系
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 int maxProduct (vector<string>& words) unordered_map<int , int > cache; int max_prod = 0 ; for (const string& word : words) { int mask = 0 , w_len = word.length (); for (char c : word) { mask |= 1 << (c - ’a’); } cache[mask] = max (cache[mask], w_len); for (auto [h_mask, h_len] : cache) { if ((mask & h_mask) == 0 ) { max_prod = max (max_prod, w_len * h_len); } } } return max_prod; }
给定一个非负整数 n,求从 0 到 n 的所有数字的二进制表达中,分别有多少个 1。
可以利用动态规划和位运算进行快速的求解。定义一个数组 dp,其中 dp[i] 表示数字 i 的二进制含有 1 的个数。对于第 i 个数字,如果它二进制的最后一位为 1,那么它含有 1 的个数则为 dp[i-1] + 1;如果它二进制的最后一位为 0,那么它含有 1 的个数和其算术右移结果相同,即 dp[i>>1]。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : vector<int > countBits (int n) { vector<int > res (n + 1 ) ; for (int i = 1 ; i <= n; i++) { if (i & 1 ) { res[i] = res[i - 1 ] + 1 ; } else { res[i] = res[i / 2 ]; } } return res; } };
给你一个字符串 s,最多 可以从中删除一个字符。
请你判断 s 是否能成为回文字符串:如果能,返回 true ;否则,返回 false
考虑“最多删除一个字符,然后判断其能否成为回文字符串”。对上述回文字符串算法稍加改造,然后加上一些额外的逻辑来解决本题。我们仍然采用头/尾双指针的方法,并且更新指针的逻辑和上面也是一样的,不同之处如下。1.如果头/尾指针对应的字符相同,那么没有必要删除任何字符。2.如果头/尾指针对应的字符不同,那么必须删除一个字符才可能使之回文,并且由于只能删除一次,接下来只需要判断剩下的字符串是否能够构成回文即可。具体算法如下。
1.建立头/尾双指针l和r,分别指向字符串的第一个元素和最后一个元素。
2.如果l和r没有交会,则比较两个指针对应的字符。● 如果两个字符相同,则更新双指针,即l+=1,r-=1,重复执行步骤。● 如果两个字符不同,考虑删除左指针对应的字符或删除右指针对应的字符,并观察删除之后是否可以构成回文字符串。如果可以,则直接返回True;如果不可以,则直接返回False。
3.表示该字符串不需要删除字符就已经是回文字符串,直接返回True。
判断回文链表
判断回文数
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 class Solution {public : bool isPalindrome (int x) if (x < 0 || (x != 0 && x % 10 == 0 )) { return false ; } int reverse_num{}; while (x > reverse_num) { reverse_num = reverse_num * 10 + x % 10 ; x /= 10 ; } return reverse_num == x || x == reverse_num / 10 ; } };
最长回文串
给你一个字符串 s,找到 s 中最长的 回文 子串。
动态规划或中心扩展
最长回文子序列
动态规划
用 dp [i ][j ] 表示字符串 s 的下标范围 [i ,j ] 内的最长回文子序列的长度
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 class Solution {public : int longestPalindromeSubseq (string s) int sz = s.size (); vector<vector<int >> dp ( sz, vector <int >(sz)); for (int i = sz - 1 ; i >= 0 ; i--) { for (int j = i; j < sz; j++) { if (i == j) { dp[i][j] = 1 ; } else { if (s[i] == s[j]) { dp[i][j] = dp[i + 1 ][j - 1 ] + 2 ; } else { dp[i][j] = max (dp[i + 1 ][j], dp[i][j - 1 ]); } } } } return dp[0 ][sz - 1 ]; } };
滚动数组优化,由于dp[i][j]仅依赖于dp[i+1][j]和dp[i][j-1],使用滚动数组优化
核心逻辑是:既然计算当前状态只依赖于前一个(或前几个)状态,那我们就没必要把整张 DP 大表都存在内存里。
在标准的 DP 中,我们通常会开一个很大的数组(比如 dp[n][m])来记录每一个子问题的解。但很多时候,你在计算第 $i$ 行时,只会用到第 $i-1$ 行的数据,而第 $i-2, i-3$ 行的数据就变成了“过时信息”
两种常见的演进方式
第一种:模运算切换(双行滚动)
这种方式最直观。如果你发现 $dp[i]$ 只依赖于 $dp[i-1]$,你可以只开两个数组:dp[0] 和 dp[1]。
第 0 次 :计算结果存入 dp[0]第 1 次 :根据 dp[0] 计算结果,存入 dp[1]第 2 次 :根据 dp[1] 计算结果,存入 dp[0](覆盖掉没用的旧数据)代码技巧:
使用 i % 2 或者 i & 1 来切换下标。
1 2 3 dp[i % 2 ] = dp[(i - 1 ) % 2 ] + dp[(i - 2 ) % 2 ];
第二种:单行覆盖(最极致的优化)
如果你能巧妙地安排计算顺序,甚至连两行都不需要,只需要一个一维数组 。
最经典的例子是 0-1 背包问题 :
原本 :dp[i][j] 表示前 $i$ 个物品在容量为 $j$ 时的最大价值。优化后 :dp[j]。关键点 :为了防止在计算当前行时使用了“已经被更新过的当前行数据”(即重复放入物品),我们需要倒序遍历 容量 $j$。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class Solution {public : int longestPalindromeSubseq (string s) int sz = s.size (); vector<int > dp (sz) ; vector<int > tmp (sz) ; for (int i = sz - 1 ; i >= 0 ; i--) { for (int j = i; j < sz; j++) { if (i == j) { dp[j] = 1 ; } else { if (s[i] == s[j]) { dp[j] = tmp[j - 1 ] + 2 ; } else { dp[j] = max (tmp[j], dp[j - 1 ]); } } } tmp = dp; } return dp[sz - 1 ]; } };
超级回文数
如果一个正整数自身是回文数,而且它也是一个回文数的平方,那么我们称这个数为 超级回文数 。
现在,给你两个以字符串形式表示的正整数 left 和 right ,统计并返回区间 [left, right] 中的 超级回文数 的数目。
直接在 $10^{18}$ 的区间里找回文数无异于大海捞针,但构造 $10^9$ 以内的回文数非常快。
一个回文数 $R$ 可以由它的“前半部分”决定:
如果 $R$ 的长度为 $L$,我们只需要枚举前 $\lceil L/2 \rceil$ 位数字。 例如,前缀 123 可以构造出:奇数长度回文:12321 偶数长度回文:123321 由于 $R \le 10^9$,它的前缀最大只需要到 $10^{4.5} \approx 31622$。实际上,我们只需要从 $1$ 枚举到 $10^5$ 左右,就能构造出所有的回文根 $R$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 class Solution {public : bool check (string& x, long long left, long long right) if (x.size () >= 10 ) { return false ; } long long num = stoll (x); long long r = num * num; if (r > right) { return false ; } string s = to_string (r); if (r >= left && validPalindrome (s)) { return true ; } return false ; } bool validPalindrome (string& s) int l = 0 , r = s.size () - 1 ; while (l < r) { if (s[l] != s[r]) { return false ; } l++; r--; } return true ; } int superpalindromesInRange (string left, string right) const int MAGIC = 1e5 ; int res{}; long long l = stoll (left); long long r = stoll (right); for (int i = 1 ; i < MAGIC; i++) { string s = to_string (i); string rs = s; for (int i = s.size () - 2 ; i >= 0 ; i--) { rs += s[i]; } if (check (rs, l, r)) { res++; } rs = s; for (int i = s.size () - 1 ; i >= 0 ; i--) { rs += s[i]; } if (check (rs, l, r)) { res++; } } return res; } };
给定一个长度为4的整数数组 cards 。你有 4 张卡片,每张卡片上都包含一个范围在 [1,9] 的数字。您应该使用运算符 ['+', '-', '*', '/'] 和括号 '(' 和 ')' 将这些卡片上的数字排列成数学表达式,以获得值24。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 class Solution {public : bool solve (vector<double >& nums) if (nums.size () == 1 ) { return abs (nums[0 ] - 24.0 ) < 1e-6 ; } for (int i = 0 ; i < nums.size (); i++) { for (int j = 0 ; j < nums.size (); j++) { if (i == j) { continue ; } vector<double > nextNums; for (int k = 0 ; k < nums.size (); k++) { if (k != i && k != j) { nextNums.push_back (nums[k]); } } double n = nums[i] + nums[j]; nextNums.push_back (n); if (solve (nextNums)) { return true ; } nextNums.pop_back (); n = nums[i] - nums[j]; nextNums.push_back (n); if (solve (nextNums)) { return true ; } nextNums.pop_back (); n = nums[i] * nums[j]; nextNums.push_back (n); if (solve (nextNums)) { return true ; } nextNums.pop_back (); if (abs (nums[j]) > 1e-6 ) { n = nums[i] / nums[j]; nextNums.push_back (n); if (solve (nextNums)) { return true ; } nextNums.pop_back (); } } } return false ; } bool judgePoint24 (vector<int >& cards) vector<double > nums; for (auto & n : cards) { nums.push_back (static_cast <double >(n)); } return solve (nums); } };
解数独
编写一个程序,通过填充空格来解决数独问题。
数独的解法需 遵循如下规则 :
数字 1-9 在每一行只能出现一次。 数字 1-9 在每一列只能出现一次。 数字 1-9 在每一个以粗实线分隔的 3x3 宫内只能出现一次。(请参考示例图) 数独部分空格内已填入了数字,空白格用 '.' 表示
据搜索方式的不同,搜索算法大致可以分为深度优先遍历(Depth First Search,DFS)和广度优先遍历(Breadth First Search,BFS)。
以树为例,DFS的思路是沿着子树尽可能深地搜索树的分支,到达叶子节点后通过回溯重复上述过程,直到所有的节点都被访问。BFS的思路则是一层一层地访问节点,直到完成遍历。由于DFS和BFS的这种差异,BFS一般用来求解最短问题(dijkstra算法的特例),而DFS书写起来比较简单,因此对于不是最短问题的情况,我们优先考虑使用DFS。然而事无绝对,DFS 也可以解决最短问题,但是要注意栈溢出的问题。在很多情况下,两者可以交替使用,比如本章要讲的岛屿问题。不管是DFS还是BFS,本质上都是搜索,而这样的搜索通常来说都是暴力搜索,因此当需要对问题的所有可能情况进行穷举时,我们就应该想到DFS和BFS。而第16章要讲解的回溯法,也是DFS的一种,即也是一种暴力搜索方法,只不过回溯法会涉及前进和回溯的过程。
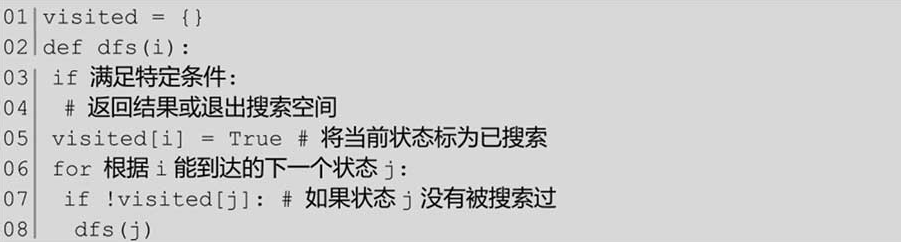
使用DFS进行解题的大概思路是定义起始节点和结束节点,从起点开始不断深入其他节点,在搜索的过程中判断是否满足特定条件
如果在树的题目中使用DFS,由于树是不存在环的,因此有关树的题目大多数不需要visited,但是如果对树的结构做了修改,使之出现了环,那就仍然需要visited
对于二叉树的题目,除了递归出口的条件,还会写一些其他的逻辑,这些逻辑由于位置的不同,产生的效果也截然不同。根据DFS逻辑位置的不同,我们将其分为三种类型,一种是自顶向下(前序遍历)的,一种是自底向上(后序遍历)的,最后一种是中序遍历。
大多数有关树的题目使用后序遍历会比较简单,并且大多需要依赖左/右子树的返回值。例如第1448题统计二叉树中好节点的数目。
● 也有一部分有关树的题目需要前序遍历,而前序遍历通常要结合参数扩展技巧。例如第1022题从根到叶的二进制数之和。
● 如果能使用参数和节点本身的值来决定应该传递给它的子节点的参数,那么就用前序遍历。
● 对于树中的任意一个节点,如果知道它子节点的答案,就能计算出当前节点的答案,那么就用后序遍历。● 如果遇到二叉搜索树,则考虑使用中序遍历。
相对于DFS来说,BFS的变种比较少,能解决的问题种类比较单一。BFS比较适合用来找最短距离,因此如果题目中提到了最短距离,首先应该想到使用BFS。使用BFS进行解题的思路同样是定义起始节点和结束节点,从起点开始不断深入其他节点,在搜索的过程中判断是否满足特定条件。BFS和DFS只是遍历的方向不同,即上面提到的DFS是尽可能深地搜索树的分支,而BFS则是一层一层地访问节点。队列可以帮我们实现“一层一层地访问节点”的效果。其本质就是不断访问邻居,把邻居逐个加入队列,根据队列先进先出的特点,把每一层节点访问完后,会继续访问下一层节点
路径之和
给你二叉树的根节点 root 和一个表示目标和的整数 targetSum 。判断该树中是否存在 根节点到叶子节点 的路径,这条路径上所有节点值相加等于目标和 targetSum 。如果存在,返回 true ;否则,返回 false 。
叶子节点 是指没有子节点的节点。
一种直观的思路是自顶向下,使用前序遍历+参数扩展,在向下递归的同时更新参数,当到达叶子节点或空节点时判断是否满足条件。在这里,我们可以将目标和sum通过参数扩展的形式向下传递,在叶子节点上判断当前节点的val是否等于传递下来的参数sum。这是一种非常常见的DFS解题思路,除了前序遍历,还有一种常见的二叉树的深度遍历法是后序遍历,即在递归函数返回时对问题进行求解,使用子树的返回值来计算当前节点的返回值。通常来讲,DFS有递归和迭代两种实现方式。因为树结构天然具有递归的特性(子树性质和整个树性质一致),使用递归可以很容易地将整个树问题转换成子树问题。当我们层层递归到最小的子树时,这个最小子树的解(也被称为递归出口)往往很容易就能够得到,再一步步回溯就能得到原问题的解。小提示:树的题目,优先考虑使用DFS递归解决。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : bool dfs (TreeNode* node, int targetSum) if (!node) { return false ; } if (node->left == nullptr && node->right == nullptr ) { if (node->val == targetSum) { return true ; } return false ; } bool leftIsValid = dfs (node->left, targetSum - node->val); bool rightIsValid = dfs (node->right, targetSum - node->val); if (leftIsValid || rightIsValid) { return true ; } return false ; } bool hasPathSum (TreeNode* root, int targetSum) if (!root) { return false ; } stack<pair<TreeNode*, int >> stk; stk.push ({root, targetSum}); while (!stk.empty ()) { auto [node, target] = stk.top (); stk.pop (); if (node->left == nullptr && node->right == nullptr ) { if (node->val == target) { return true ; } } if (node->left) { stk.push ({node->left, target - node->val}); } if (node->right) { stk.push ({node->right, target - node->val}); } } return false ; } };
二叉树中的最大路径和
二叉树中的 路径 被定义为一条节点序列,序列中每对相邻节点之间都存在一条边。同一个节点在一条路径序列中 至多出现一次 。该路径 至少包含一个 节点,且不一定经过根节点
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : int res{INT_MIN}; int dfs (TreeNode* node) if (!node) { return 0 ; } int lVal = max (0 , dfs (node->left)); int rVal = max (0 , dfs (node->right)); int nodeVal = max (lVal, rVal) + node->val; res = max (res, lVal + rVal + node->val); return nodeVal; } int maxPathSum (TreeNode* root) dfs (root); return res; } };
给你一个大小为 m x n 的二维二进制网格 grid 。网格表示一个地图,其中,0 表示水,1 表示陆地。最初,grid 中的所有单元格都是水单元格(即,所有单元格都是 0)。
可以通过执行 addLand 操作,将某个位置的水转换成陆地。给你一个数组 positions ,其中 positions[i] = [ri, ci] 是要执行第 i 次操作的位置 (ri, ci) 。
返回一个整数数组 answer ,其中 answer[i] 是将单元格 (ri, ci) 转换为陆地后,地图中岛屿的数量。
岛屿 的定义是被「水」包围的「陆地」,通过水平方向或者垂直方向上相邻的陆地连接而成。你可以假设地图网格的四边均被无边无际的「水」所包围。
需要动态地求出每次addLand操作之后的无向图中的连通分量。而求连通分量的数量的问题都可以通过DFS、BFS或并查集来解决。首先来看DFS和BFS,任何通过DFS和BFS来解决的图类问题都有一个前提:图是被预先处理好的。而本题中的图是动态变化的,因此这时用DFS或BFS来处理效率就不那么高了。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 class Solution {public : class UnionFind { private : vector<int > parent; int m; int cnt{}; public : UnionFind (int m, int n) : m (m) { int sz = m * n; parent.resize (sz); for (int i = 0 ; i < sz; i++) { parent[i] = -1 ; } } void addLand (int x, int y) int p = x * m + y; if (parent[p] != -1 ) { return ; } parent[p] = p; cnt++; } int find (int p) return parent[p] == p ? p : parent[p] = find (p); } int find (int pos_x, int pos_y) int p = pos_x * m + pos_y; return find (p); } bool isLand (int x, int y) int pos = x * m + y; return parent[pos] != -1 ; } int getCount () return cnt; } void join (int u, int v) int px = find (u); int py = find (v); if (px == py) { return ; } parent[py] = px; cnt--; } }; vector<pair<int , int >> dirs = {{0 , 1 }, {0 , -1 }, {1 , 0 }, {-1 , 0 }}; vector<int > numIslands2 (int m, int n, vector<vector<int >>& positions) { UnionFind uf (m, n) ; int sz = positions.size (); vector<int > res (sz) ; for (int i = 0 ; i < sz; i++) { int x = positions[i][0 ]; int y = positions[i][1 ]; if (uf.isLand (x, y)) { res[i] = res[i - 1 ]; } else { uf.addLand (x, y); for (auto & dir : dirs) { int nx = x + dir.first; int ny = y + dir.second; if (nx < 0 || nx >= m || ny < 0 || ny >= n) { continue ; } if (!uf.isLand (nx, ny)) { continue ; } int pos = x * m + y; uf.join (pos, nx * m + ny); } } res[i] = uf.getCount (); } return res; } };
DFS和BFS都属于树/图的搜索算法,两者在用于具体问题时各有优劣,具体如下。
● 求给定图中两点之间最短路径或检验图的二分性,使用BFS更优。
● 求无向图的连通分量数量,两者差不多。两者在实现过程中使用的基础数据结构也有区别。
在实际做题当中,一般使用栈来实现DFS,使用队列来实现BFS。另外,DFS和回溯算法之间的关系界线是模糊的,网上的说法也各不一样,在这里我们没必要过于纠结其精确的定义。对于DFS,另外一个知识点也是值得注意的。在二叉树中,DFS可以被分为前序遍历、中序遍历和后序遍历,并且引申出一系列相关题目。最后,本章的路径和问题、岛屿问题只详细讲述了两种算法的基本写法,而在实际的刷题过程中,我们可能会使用这两种基本写法的变种或延伸,比如运用双向搜索技巧、dijkstra 算法、A* 算法等
从前序和中序构建二叉树
给定两个整数数组 preorder 和 inorder ,其中 preorder 是二叉树的先序遍历 , inorder 是同一棵树的中序遍历 ,请构造二叉树并返回其根节点。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 class Solution {public : TreeNode* buildNode (vector<int >& preorder, vector<int >& inorder, unordered_map<int , int >& inOrderMap, int leftIdxPre, int rightIdxPre, int leftIdxIn, int rightIdxIn) if (leftIdxPre > rightIdxPre) { return nullptr ; } int nodeVal = preorder[leftIdxPre]; int idxInOrder = inOrderMap[nodeVal]; int leftNodeNum = idxInOrder - leftIdxIn; TreeNode* node = new TreeNode (nodeVal); node->left = buildNode (preorder, inorder, inOrderMap, leftIdxPre + 1 , leftIdxPre + leftNodeNum, leftIdxIn, idxInOrder - 1 ); node->right = buildNode (preorder, inorder, inOrderMap, leftIdxPre + leftNodeNum + 1 , rightIdxPre, idxInOrder + 1 , rightIdxIn); return node; } TreeNode* buildTree (vector<int >& preorder, vector<int >& inorder) { unordered_map<int , int > inOrderMap; int sz = inorder.size (); for (int i = 0 ; i < sz; i++) { inOrderMap[inorder[i]] = i; } auto node = buildNode (preorder, inorder, inOrderMap, 0 , sz - 1 , 0 , sz - 1 ); return node; } };
不同路径
一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : int uniquePaths (int m, int n) vector<vector<int >> dp (m,vector <int >(n)); for (int i = 0 ;i<n;i++) { dp[0 ][i] = 1 ; } for (int i = 0 ;i<m;i++) { dp[i][0 ] = 1 ; } for (int i = 1 ;i<m;i++) { for (int j = 1 ;j<n;j++) { dp[i][j] = dp[i-1 ][j] + dp[i][j-1 ]; } } return dp[m-1 ][n-1 ]; } };
不同路径I
给定一个 m x n 的整数数组 grid。一个机器人初始位于 左上角 (即 grid[0][0])。机器人尝试移动到 右下角 (即 grid[m - 1][n - 1])。机器人每次只能向下或者向右移动一步。
网格中的障碍物和空位置分别用 1 和 0 来表示。机器人的移动路径中不能包含 任何 有障碍物的方格。
返回机器人能够到达右下角的不同路径数量。
测试用例保证答案小于等于 2 * 109。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : int uniquePathsWithObstacles (vector<vector<int >>& obstacleGrid) int m = obstacleGrid.size (); int n = obstacleGrid[0 ].size (); vector<vector<int >> dp (m, vector <int >(n)); for (int j = 0 ; j < n; j++) { if (obstacleGrid[0 ][j] == 0 ) { dp[0 ][j] = 1 ; } else { break ; } } for (int i = 0 ; i < m; i++) { if (obstacleGrid[i][0 ] == 0 ) { dp[i][0 ] = 1 ; } else { break ; } } for (int i = 1 ; i < m; i++) { for (int j = 1 ; j < n; j++) { if (obstacleGrid[i][j] == 1 ) { continue ; } dp[i][j] = dp[i - 1 ][j] + dp[i][j - 1 ]; } } return dp[m - 1 ][n - 1 ]; } };
不同路径II
在二维网格 grid 上,有 4 种类型的方格:
1 表示起始方格。且只有一个起始方格。2 表示结束方格,且只有一个结束方格。0 表示我们可以走过的空方格。-1 表示我们无法跨越的障碍。返回在四个方向(上、下、左、右)上行走时,从起始方格到结束方格的不同路径的数目。
每一个无障碍方格都要通过一次,但是一条路径中不能重复通过同一个方格 。
虽然题目名字叫“不同路径”,但它和普通的动态规划路径题完全不同,因为它有一个硬性约束:必须经过每一个无障碍方格(0)恰好一次 。图论的角度来看,这实际上是在寻找网格图中的哈密顿路径(Hamiltonian Path) 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 class Solution {public : int res{}; vector<pair<int , int >> dirs = {{0 , 1 }, {0 , -1 }, {1 , 0 }, {-1 , 0 }}; void dfs (vector<vector<int >>& grid, int x, int y, int step, int targetStep) int m = grid.size (); int n = grid[0 ].size (); for (auto & dir : dirs) { int nx = x + dir.first; int ny = y + dir.second; if (nx < 0 || nx >= m || ny < 0 || ny >= n) { continue ; } if (grid[nx][ny] == -1 || grid[nx][ny] == 1 ) { continue ; } if (grid[nx][ny] == 2 ) { if (step == targetStep) { res++; } continue ; } grid[nx][ny] = -1 ; dfs (grid, nx, ny, step + 1 , targetStep); grid[nx][ny] = 0 ; } } int uniquePathsIII (vector<vector<int >>& grid) int m = grid.size (); int n = grid[0 ].size (); int cnt{}; int start_x{}, start_y{}; for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (grid[i][j] == 0 ) { cnt++; } if (grid[i][j] == 1 ) { start_x = i; start_y = j; } } } dfs (grid, start_x, start_y, 0 , cnt); return res; } };
DFS 回溯 (Backtracking):试错的探险家 回溯的核心是“尝试 -> 撤销” 。它不关心过去是否算过这个点,它关心的是当前的路径 。
核心逻辑 :走不通就退回来,把标记抹掉,换条路再试。状态依赖 :当前的状态通常依赖于路径历史 (比如你走过的路,别人就不能再走了)。空间复杂度 :通常较小,只取决于递归深度。时间复杂度 :通常是指数级的,比如 $O(2^n)$ 或 $O(n!)$。记忆化搜索 (Memoization):聪明的收纳狂 记忆化搜索本质上是“自顶向下的动态规划(DP)” 。它的核心是“查表 -> 存储” 。
核心逻辑 :如果这个子问题我以前算过,直接把结果扔给你,绝不浪费时间重算。状态依赖 :当前的状态只取决于当前的参数 ,与你是怎么走到这一步的(路径)无关。这就是所谓的“无后效性”。空间复杂度 :较大,需要额外的空间(哈希表或数组)来存储中间结果。时间复杂度 :通常能将指数级降低到多项式级,如 $O(n^2)$。如果在 DFS 递归函数的末尾看到了类似这样的代码:
1 2 grid[x][y] = 0 ; return res;
这通常是 回溯 。
如果你在递归函数的开头和结尾看到了这样的代码:
1 2 3 if (memo[state] != -1 ) return memo[state]; ... return memo[state] = res;
这一定是 记忆化搜索 。
特性 记忆化搜索 (Top-down) 动态规划 (Bottom-up) 实现方式 递归 + 缓存 (通常是哈希表或数组)迭代 + 递推表 (通常是数组)思维方向 自顶向下 :从大问题拆解成小问题自底向上 :从小问题推导出大问题计算顺序 依赖驱动:只计算到达目标所需的子状态 顺序驱动:按预定顺序计算所有可能状态 空间开销 缓存空间 + 递归调用栈 (容易溢出) 缓存空间 (通常可以通过滚动数组优化) 适用场景 状态空间稀疏、转移方程复杂 状态空间密集、需要极致性能优化
公式:$f(n) = f(n-1) + f(n-2)$
记忆化搜索版
1 2 3 4 5 6 int memo[1001 ]; int fib (int n) if (n <= 1 ) return n; if (memo[n] != -1 ) return memo[n]; return memo[n] = fib (n - 1 ) + fib (n - 2 ); }
动态规划版
1 2 3 4 5 6 7 8 9 int fib (int n) if (n <= 1 ) return n; vector<int > dp (n + 1 ) ; dp[0 ] = 0 ; dp[1 ] = 1 ; for (int i = 2 ; i <= n; i++) { dp[i] = dp[i - 1 ] + dp[i - 2 ]; } return dp[n]; }
统计二叉树中好节点数目
给你一棵根为 root 的二叉树,请你返回二叉树中好节点的数目。
「好节点」X 定义为:从根到该节点 X 所经过的节点中,没有任何节点的值大于 X 的值。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : int res{}; void dfs (TreeNode* node, int max_val) if (!node) { return ; } max_val = max (max_val, node->val); if (max_val <= node->val) { res++; } dfs (node->left, max_val); dfs (node->right, max_val); } int goodNodes (TreeNode* root) dfs (root, INT_MIN); return res; } };
矩阵中最长递增路径
定一个 m x n 整数矩阵 matrix ,找出其中 最长递增路径 的长度。
对于每个单元格,你可以往上,下,左,右四个方向移动。 你 不能 在 对角线 方向上移动或移动到 边界外 (即不允许环绕)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 class Solution {public : int ans{1 }; vector<pair<int , int >> dirs = {{0 , 1 }, {0 , -1 }, {1 , 0 }, {-1 , 0 }}; int dfs (vector<vector<int >>& matrix, int x, int y, vector<vector<int >>& memo) if (memo[x][y] != -1 ) { return memo[x][y]; } int m = matrix.size (); int n = matrix[0 ].size (); int val{1 }; for (auto & dir : dirs) { int nx = x + dir.first; int ny = y + dir.second; if (nx < 0 || nx >= m || ny < 0 || ny >= n) { continue ; } if (matrix[nx][ny] < matrix[x][y]) { val = max (val, 1 + dfs (matrix, nx, ny, memo)); } } memo[x][y] = val; ans = max (ans, val); return val; } int longestIncreasingPath (vector<vector<int >>& matrix) int m = matrix.size (); int n = matrix[0 ].size (); vector<vector<int >> memo (m, vector <int >(n, -1 )); for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { dfs (matrix, i, j, memo); } } return ans; } };
Nim游戏
你和你的朋友,两个人一起玩 Nim 游戏 :
桌子上有一堆石头。 你们轮流进行自己的回合, 你作为先手 。 每一回合,轮到的人拿掉 1 - 3 块石头。 拿掉最后一块石头的人就是获胜者。 假设你们每一步都是最优解。请编写一个函数,来判断你是否可以在给定石头数量为 n 的情况下赢得游戏。如果可以赢,返回 true;否则,返回 false 。
我能赢吗
在 “100 game” 这个游戏中,两名玩家轮流选择从 1 到 10 的任意整数,累计整数和,先使得累计整数和 达到或超过 100 的玩家,即为胜者。
如果我们将游戏规则改为 “玩家 不能 重复使用整数” 呢?
例如,两个玩家可以轮流从公共整数池中抽取从 1 到 15 的整数(不放回),直到累计整数和 >= 100。
给定两个整数 maxChoosableInteger (整数池中可选择的最大数)和 desiredTotal(累计和),若先出手的玩家能稳赢则返回 true ,否则返回 false 。假设两位玩家游戏时都表现 最佳 。
博弈类题目通常很难写出迭代式的 DP,但用记忆化搜索 配合状态压缩(Bitmask) 则非常直观。
考虑边界情况,当所有数字选完仍无法到达 desiredTotal 时,两人都无法获胜,返回 false。当所有数字的和大于等于 desiredTotal 时,其中一方能获得胜利,需要通过搜索来判断获胜方。
在游戏中途,假设已经被使用的数字的集合为 usedNumbers,这些数字的和为 currentTotal。当某方行动时,如果他能在未选择的数字中选出一个 i,使得 i+currentTotal≥desiredTotal,则他能获胜。否则,需要继续通过搜索来判断获胜方。在剩下的数字中,如果他能选择一个 i,使得对方在接下来的局面中无法获胜,则他会获胜。否则,他会失败。
根据这个思想设计搜索函数 dfs,其中 usedNumbers 可以用一个整数来表示,从低位到高位,第 i 位为 1 则表示数字 i 已经被使用,为 0 则表示数字 i 未被使用。如果当前玩家获胜,则返回 true,否则返回 false。为了避免重复计算,需要使用记忆化的操作来降低时间复杂度
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : int memo[1 << 21 ]; bool canIWin (int maxChoosableInteger, int desiredTotal) int sum = (1 + maxChoosableInteger) * maxChoosableInteger / 2 ; if (sum < desiredTotal) return false ; if (desiredTotal <= 0 ) return true ; return dfs (maxChoosableInteger, desiredTotal, 0 ); } bool dfs (int maxInt, int total, int mask) if (memo[mask] != 0 ) return memo[mask] == 1 ; for (int i = 1 ; i <= maxInt; i++) { int bit = 1 << i; if (!(mask & bit)) { if (total - i <= 0 || !dfs (maxInt, total - i, mask | bit)) { memo[mask] = 1 ; return true ; } } } memo[mask] = 2 ; return false ; } };
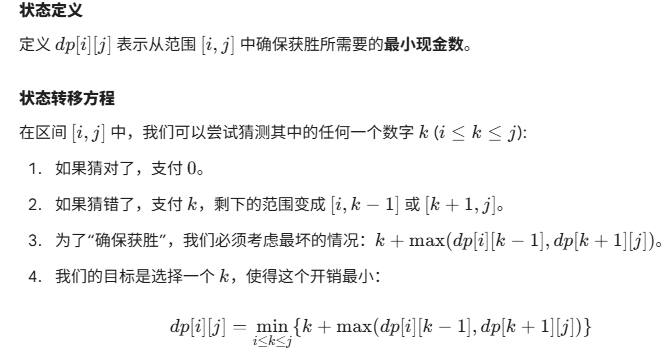
猜数字大小 II
我们正在玩一个猜数游戏,游戏规则如下:
我从 1 到 n 之间选择一个数字。 你来猜我选了哪个数字。 如果你猜到正确的数字,就会 赢得游戏 。 如果你猜错了,那么我会告诉你,我选的数字比你的 更大或者更小 ,并且你需要继续猜数。 每当你猜了数字 x 并且猜错了的时候,你需要支付金额为 x 的现金。如果你花光了钱,就会 输掉游戏 。 给你一个特定的数字 n ,返回能够 确保你获胜 的最小现金数,不管我选择那个数字
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : int getMoneyAmount (int n) vector<vector<int >> dp (n + 1 , vector <int >(n + 1 )); for (int i = n-1 ;i>=1 ;i--) { for (int j = i+1 ;j<=n;j++) { dp[i][j] = dp[i][j-1 ] + j; for (int k = i;k<j;k++) { dp[i][j] = min (dp[i][j],k+max (dp[i][k-1 ],dp[k+1 ][j])); } } } return dp[1 ][n]; } };
翻转游戏
你和朋友玩一个叫做「翻转游戏」的游戏。游戏规则如下:
给你一个字符串 currentState ,其中只含 '+' 和 '-' 。你和朋友轮流将 连续 的两个 "++" 反转成 "--" 。当一方无法进行有效的翻转时便意味着游戏结束,则另一方获胜。
计算并返回 一次有效操作 后,字符串 currentState 所有的可能状态,返回结果可以按 任意顺序 排列。如果不存在可能的有效操作,请返回一个空列表 [] 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : vector<string> generatePossibleNextMoves (string currentState) { vector<string> res; int start_idx{}; while (start_idx < currentState.size () - 1 ) { if (currentState[start_idx] == currentState[start_idx + 1 ]) { string s = currentState; if (currentState[start_idx] == '+' ) { s[start_idx] = '-' ; s[start_idx + 1 ] = '-' ; res.push_back (s); } } start_idx++; } return res; } };
翻转游戏II
你和朋友玩一个叫做「翻转游戏」的游戏。游戏规则如下:
给你一个字符串 currentState ,其中只含 ‘+’ 和 ‘-‘ 。你和朋友轮流将 连续 的两个 “++” 反转成 “—“ 。当一方无法进行有效的翻转时便意味着游戏结束,则另一方获胜。默认每个人都会采取最优策略。
请你写出一个函数来判定起始玩家 是否存在必胜的方案 :如果存在,返回 true ;否则,返回 false 。
在博弈问题中,我们通常使用递归 来模拟每一轮的操作。
必胜态 (Winning State) :从当前状态出发,存在至少一种移动方式,能够进入“必败态”。必败态 (Losing State) :从当前状态出发,无论做出什么移动,下个状态都是“必胜态”;或者根本无法移动。算法步骤:
遍历字符串 :寻找所有连续的 ++。模拟翻转 :将当前的 ++ 替换为 --,得到一个新的字符串。递归判断 :调用函数判断对手 在面对新字符串时是否会输掉。如果对手输了(返回 false),说明我们找到了一个必胜点,直接返回 true。记忆化 (Memoization) :为了避免重复计算(同一个字符串可能通过不同的翻转路径达到),我们使用哈希表记录已经计算过的状态。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Solution {public : bool dfs (string& currentState, unordered_map<string, bool >& memo) if (memo.count (currentState)) { return memo[currentState]; } for (int i = 0 ; i < currentState.size () - 1 ; i++) { if (currentState[i] == currentState[i + 1 ]) { if (currentState[i] == '+' ) { string nextState = currentState; nextState[i] = '-' ; nextState[i + 1 ] = '-' ; bool flag = dfs (nextState, memo); if (!flag) { memo[currentState] = true ; return true ; } } } } memo[currentState] = false ; return false ; } bool canWin (string currentState) unordered_map<string, bool > memo; return dfs (currentState, memo); } };
对于 这类博弈题,递归 + 记忆化 是通杀方案。只要记住“我的胜利建立在对手的绝望之上”这个博弈原则,逻辑就能顺理成章。
求出硬币游戏赢家
给你两个 正 整数 x 和 y ,分别表示价值为 75 和 10 的硬币的数目。
Alice 和 Bob 正在玩一个游戏。每一轮中,Alice 先进行操作,Bob 后操作。每次操作中,玩家需要拿走价值 总和 为 115 的硬币。如果一名玩家无法执行此操作,那么这名玩家 输掉 游戏。
两名玩家都采取 最优 策略,请你返回游戏的赢家。
1 2 3 4 5 6 7 8 9 class Solution {public : string winningPlayer (int x, int y) { int ops = min (x, y / 4 ); return ops % 2 ? "Alice" : "Bob" ; } };
预测赢家
给一个整数数组 nums 。玩家 1 和玩家 2 基于这个数组设计了一个游戏。
玩家 1 和玩家 2 轮流进行自己的回合,玩家 1 先手。开始时,两个玩家的初始分值都是 0 。每一回合,玩家从数组的任意一端取一个数字(即,nums[0] 或 nums[nums.length - 1]),取到的数字将会从数组中移除(数组长度减 1 )。玩家选中的数字将会加到他的得分上。当数组中没有剩余数字可取时,游戏结束。
如果玩家 1 能成为赢家,返回 true 。如果两个玩家得分相等,同样认为玩家 1 是游戏的赢家,也返回 true 。你可以假设每个玩家的玩法都会使他的分数最大化。
在处理这类“两个人都采取最优策略”的问题时,我们不要去管玩家 1 拿了多少分、玩家 2 拿了多少分。我们只关心一个值:当前玩家相对于对手的“净胜分” 。
定义函数 $f(i, j)$:表示在数组 nums 从索引 $i$ 到 $j$ 的这段区间内,当前走棋的人能拿到的最大净分数 (即:我的得分 - 对手的得分)。
如果你选左端点 nums[i] :你得到了 nums[i] 分,剩下的区间是 $[i+1, j]$。在剩下的区间里,对手会作为先手,他能拿到的最大净分值是 $f(i+1, j)$。所以你的净胜分就是 nums[i] - f(i+1, j)。如果你选右端点 nums[j] :同理,你的净胜分就是 nums[j] - f(i, j-1)。作为大师级玩家,你当然会在这两种选择中选那个更大的 。
递归逻辑与状态转移 基准情况 (Base Case) :
当 $i == j$ 时,只剩一个数字,当前玩家直接拿走,净胜分为 $f(i, i) = \text{nums}[i]$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int max_diff (vector<int >& nums, int i, int j) if (j == i) { return nums[i]; } int l = nums[i] - max_diff (nums, i + 1 , j); int r = nums[j] - max_diff (nums, i, j - 1 ); return max (l, r); } bool predictTheWinner (vector<int >& nums) return max_diff (nums, 0 , nums.size () - 1 ) >= 0 ; } }; class Solution {public : bool PredictTheWinner (vector<int >& nums) int length = nums.size (); auto dp = vector<vector<int >> (length, vector <int >(length)); for (int i = 0 ; i < length; i++) { dp[i][i] = nums[i]; } for (int i = length - 2 ; i >= 0 ; i--) { for (int j = i + 1 ; j < length; j++) { dp[i][j] = max (nums[i] - dp[i + 1 ][j], nums[j] - dp[i][j - 1 ]); } } return dp[0 ][length - 1 ] >= 0 ; } };
求出胜利玩家数目
给你一个整数 n ,表示在一个游戏中的玩家数目。同时给你一个二维整数数组 pick ,其中 pick[i] = [xi, yi] 表示玩家 xi 获得了一个颜色为 yi 的球。
如果玩家 i 获得的球中任何一种颜色球的数目 严格大于 i 个,那么我们说玩家 i 是胜利玩家。换句话说:
如果玩家 0 获得了任何的球,那么玩家 0 是胜利玩家。 如果玩家 1 获得了至少 2 个相同颜色的球,那么玩家 1 是胜利玩家。 … 如果玩家 i 获得了至少 i + 1 个相同颜色的球,那么玩家 i 是胜利玩家。 请你返回游戏中 胜利玩家 的数目。
注意 ,可能有多个玩家是胜利玩家。
石子游戏
Alice 和 Bob 用几堆石子在做游戏。一共有偶数堆石子,排成一行 ;每堆都有 正 整数颗石子,数目为 piles[i] 。
游戏以谁手中的石子最多来决出胜负。石子的 总数 是 奇数 ,所以没有平局。
Alice 和 Bob 轮流进行,Alice 先开始 。 每回合,玩家从行的 开始 或 结束 处取走整堆石头。 这种情况一直持续到没有更多的石子堆为止,此时手中 石子最多 的玩家 获胜 。
假设 Alice 和 Bob 都发挥出最佳水平,当 Alice 赢得比赛时返回 true ,当 Bob 赢得比赛时返回 false
永远为true
单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
注意: 不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : bool wordBreak (string s, vector<string>& wordDict) int sz = s.size (); unordered_set<string> wordSet (wordDict.begin(), wordDict.end()) ; vector<bool > dp (sz + 1 ) ; dp[0 ] = true ; for (int i = 1 ; i <= sz; i++) { for (int j = 0 ; j < i; j++) { string sstr = s.substr (j, i - j); if (wordSet.count (sstr) && dp[j]) { dp[i] = true ; } } } return dp[sz]; } }; class Solution {public : unordered_map<int , bool > memo; bool dfs (string& s, int start_idx, unordered_set<string> wordSet) if (memo.count (start_idx)) { return memo[start_idx]; } if (start_idx == s.size ()) { return true ; } for (int i = start_idx; i < s.size (); i++) { string tmp = s.substr (start_idx, i - start_idx + 1 ); if (wordSet.count (tmp) && dfs (s, i + 1 , wordSet)) { memo[start_idx] = true ; return true ; } } memo[start_idx] = false ; return false ; } bool wordBreak (string s, vector<string>& wordDict) unordered_set<string> wordSet (wordDict.begin(), wordDict.end()) ; return dfs (s, 0 , wordSet); } };
单词拆分II
给定一个字符串 s 和一个字符串字典 wordDict ,在字符串 s 中增加空格来构建一个句子,使得句子中所有的单词都在词典中。以任意顺序 返回所有这些可能的句子。
注意: 词典中的同一个单词可能在分段中被重复使用多次。
将大问题拆解为:“当前单词 + 剩余子串的所有拆分可能” 。
定义函数 dfs(start):返回字符串 s[start:] 能够组成的所有合法句子列表。递归过程 :从 start 开始,尝试所有可能的结尾 end。 如果 s[start:end] 是一个单词:递归调用 dfs(end) 获取后缀的所有组合。 将当前单词与后缀的每一个组合用空格连接。 记忆化 :使用字典 memo 记录 start 对应的所有结果。如果下次再遇到相同的 start,直接返回结果,不再重复搜索。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 class Solution {public : unordered_map<int , vector<string>> memo; vector<string> dfs (string& s, unordered_set<string>& uset, int start) { if (memo.count (start)) { return memo[start]; } if (start == s.size ()) { return {"" }; } vector<string> ans; for (int j = start; j < s.size (); j++) { string sstr = s.substr (start, j - start + 1 ); if (uset.count (sstr)) { auto res = dfs (s, uset, j + 1 ); for (auto & s : res) { if (s.empty ()) { ans.push_back (sstr); } else { ans.push_back (sstr + " " + s); } } } } memo[start] = ans; return ans; } vector<string> wordBreak (string s, vector<string>& wordDict) { unordered_set<string> uset (wordDict.begin(), wordDict.end()) ; return dfs (s, uset, 0 ); } };
划分为k个相等的子集
给定一个整数数组 nums 和一个正整数 k,找出是否有可能把这个数组分成 k 个非空子集,其总和都相等。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : unordered_map<int , bool > memo; bool dfs (vector<int >& nums, int usedNums, int curSum, int targetSum, int cnt, int k) if (memo.count (usedNums)) { return memo[usedNums]; } if (cnt == k) { memo[usedNums] = true ; return true ; } if (targetSum == curSum) { if (dfs (nums, usedNums, 0 , targetSum, cnt + 1 , k)) { memo[usedNums] = true ; return true ; } } for (int i = 0 ; i < nums.size (); i++) { if (usedNums & (1 << i)) { continue ; } if (nums[i] + curSum > targetSum) { continue ; } if (nums[i] + curSum <= targetSum) { if (dfs (nums, usedNums | (1 << i), nums[i] + curSum, targetSum, cnt, k)) { return true ; } } } memo[usedNums] = false ; return false ; } bool canPartitionKSubsets (vector<int >& nums, int k) int sum_val = accumulate (nums.begin (), nums.end (), 0 ); if (sum_val % k) { return false ; } int target = sum_val / k; return dfs (nums, 0 , 0 , target, 0 , k); } };
戳气球
有 n 个气球,编号为0 到 n - 1,每个气球上都标有一个数字,这些数字存在数组 nums 中。
现在要求你戳破所有的气球。戳破第 i 个气球,你可以获得 nums[i - 1] * nums[i] * nums[i + 1] 枚硬币。 这里的 i - 1 和 i + 1 代表和 i 相邻的两个气球的序号。如果 i - 1或 i + 1 超出了数组的边界,那么就当它是一个数字为 1 的气球。
求所能获得硬币的最大数量。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 class Solution {public : int maxCoins (vector<int >& nums) int n = nums.size (); vector<int > coins (n + 2 , 1 ) ; for (int i = 1 ; i <= n; i++) { coins[i] = nums[i - 1 ]; } vector<vector<int >> dp (n + 2 , vector <int >(n + 2 )); for (int i = n + 1 ; i >= 0 ; i--) { for (int j = i + 2 ; j <= n + 1 ; j++) { for (int k = i + 1 ; k < j; k++) { dp[i][j] = max (dp[i][k] + dp[k][j] + coins[i] * coins[j] * coins[k], dp[i][j]); } } } return dp[0 ][n + 1 ]; } }; class Solution {public : vector<vector<int >> rec; vector<int > val; public : int solve (int left, int right) if (left >= right - 1 ) { return 0 ; } if (rec[left][right] != -1 ) { return rec[left][right]; } for (int i = left + 1 ; i < right; i++) { int sum = val[left] * val[i] * val[right]; sum += solve (left, i) + solve (i, right); rec[left][right] = max (rec[left][right], sum); } return rec[left][right]; } int maxCoins (vector<int >& nums) int n = nums.size (); val.resize (n + 2 ); for (int i = 1 ; i <= n; i++) { val[i] = nums[i - 1 ]; } val[0 ] = val[n + 1 ] = 1 ; rec.resize (n + 2 , vector <int >(n + 2 , -1 )); return solve (0 , n + 1 ); } };
通配符匹配
给你一个输入字符串 (s) 和一个字符模式 (p) ,请你实现一个支持 '?' 和 '*' 匹配规则的通配符匹配:
'?' 可以匹配任何单个字符。'*' 可以匹配任意字符序列(包括空字符序列)。判定匹配成功的充要条件是:字符模式必须能够 完全匹配 输入字符串(而不是部分匹配
定义 $dp[i][j]$ 为 $s$ 的前 $i$ 个字符和 $p$ 的前 $j$ 个字符是否匹配。
情况 A:p[j-1] 是普通字符或 ?
如果 s[i-1] == p[j-1] 或者 p[j-1] == '?',匹配 1 对 1。
情况 B:p[j-1] 是 *
这时候 * 有两种选择:
当成空字符串(匹配 0 个) :直接看模式串前一个位置是否匹配当前字符串。
匹配 1 个或多个字符 :既然 * 能匹配任意序列,只要 $s$ 的前一个字符已经和当前 * 匹配上了,那么当前字符也能被这个 * 吸收。
综合逻辑 :$dp[i][j] = dp[i][j-1] \lor dp[i-1][j]$
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Solution {public : bool isMatch (string s, string p) int n1 = s.size (); int n2 = p.size (); vector<vector<bool >> dp (n1 + 1 , vector <bool >(n2 + 1 )); dp[0 ][0 ] = true ; for (int i = 1 ; i <= n2; i++) { if (p[i - 1 ] == '*' ) { dp[0 ][i] = dp[0 ][i - 1 ]; } else { dp[0 ][i] = false ; break ; } } for (int i = 1 ; i <= n1; i++) { for (int j = 1 ; j <= n2; j++) { if (p[j - 1 ] == '*' ) { dp[i][j] = dp[i][j - 1 ] || dp[i - 1 ][j]; } else if (p[j - 1 ] == '?' || p[j - 1 ] == s[i - 1 ]) { dp[i][j] = dp[i - 1 ][j - 1 ]; } } } return dp[n1][n2]; } };
正则表达式匹配
给你一个字符串 s 和一个字符规律 p,请你来实现一个支持 '.' 和 '*' 的正则表达式匹配。
'.' 匹配任意单个字符'*' 匹配零个或多个前面的那一个元素所谓匹配,是要涵盖 整个 字符串 s 的,而不是部分字符串。
难点在于 * 的处理:它不是独立存在的,而是必须和前一个字符 绑在一起看,表示“0 个或多个前面的那个元素”。这种“回头看”的逻辑让匹配变得非常复杂。
遍历 i(从 0 到 $m$)和 j(从 1 到 $n$),对于每个 dp[i][j]:
情况 A:p[j-1] 不是 *
如果当前字符匹配(s[i-1] == p[j-1] 或 p[j-1] == '.'),则:
情况 B:p[j-1] 是 *
此时模式串中 * 前面的字符是 p[j-2]。
匹配 0 次 :无论如何,我们可以选择忽略 x*。
匹配 1 次或多次 :如果 s[i-1] 能匹配 p[j-2],则我们可以“吃掉” s 的当前字符,并保持模式串位置不变。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 class Solution {public : bool isMatch (string s, string p) int sz1 = s.size (); int sz2 = p.size (); vector<vector<bool >> dp (sz1 + 1 , vector <bool >(sz2 + 1 )); dp[0 ][0 ] = true ; for (int j = 2 ; j <= sz2; j++) { if (p[j - 1 ] == '*' ) { dp[0 ][j] = dp[0 ][j - 2 ]; } } for (int i = 1 ; i <= sz1; i++) { for (int j = 1 ; j <= sz2; j++) { if (p[j - 1 ] == '*' ) { dp[i][j] = dp[i][j - 2 ]; bool is_match = ((s[i - 1 ] == p[j - 2 ]) || (p[j - 2 ] == '.' )); if (is_match) { dp[i][j] = (dp[i - 1 ][j] || dp[i][j]); } } else { if (s[i - 1 ] == p[j - 1 ] || p[j - 1 ] == '.' ) { dp[i][j] = dp[i - 1 ][j - 1 ]; } } } } return dp[sz1][sz2]; } };
记忆化搜索题目
矩阵与路径类(最直观的应用) 这类问题通常具有明确的方向性,递归路径清晰,但存在大量重复计算。
329. 矩阵中的最长递增路径 (Hard)核心点 :从任意点出发找最长路径。如果不用记忆化,DFS 会呈指数级增长。由于递增的限制,路径不会成环,非常适合递归缓存结果。62. 不同路径 (Medium)核心点 :虽然入门选手机通常用迭代 DP,但用递归+记忆化实现逻辑最自然。博弈论类(必须用记忆化) 正如你刚才问的“翻转游戏”,博弈题几乎是记忆化搜索的本命题。
464. 我能赢吗 (Medium)核心点 :状态压缩 + 记忆化。需要记录哪些数字被选过(用二进制位表示),并判断当前玩家是否必胜。486. 预测赢家 (Medium)核心点 :经典的从数组两端取数的博弈,递归逻辑是 max(左端取数 - 剩下的递归结果, 右端取数 - 剩下的递归结果)。877. 石子游戏 (Medium)核心点 :虽然数学推导必胜,但作为算法练习,它是典型的区间记忆化搜索。拆分与区间类(Range DP) 将一个大问题拆解成多个小区间,再合并结果。
312. 戳气球 (Hard)核心点 :区间 DP 的巅峰之作。自顶向下的记忆化搜索比自底向上的三层循环更容易理解:solve(left, right) 表示戳破 (left, right) 之间所有气球的最大收益。139. 单词拆分 (Medium)核心点 :判断字符串是否能由字典组成。递归判断 s[i:] 是否合法,并用 memo 记录。140. 单词拆分 II (Hard)核心点 :不仅要判断,还要返回所有路径。由于要构造大量字符串,记忆化搜索几乎是唯一解法。字符串匹配类 10. 正则表达式匹配 (Hard)核心点 :处理 * 和 . 的复杂逻辑。记忆化搜索可以让你专注处理当前的字符匹配,而不用纠结 DP 表的初始化。44. 通配符匹配 (Hard)核心点 :逻辑与 10 题类似,是练习递归思维的佳作。状态压缩类(进阶必备) 当状态无法简单用数组下标表示时,通常配合位运算。
当你发现题目有以下特征时,请优先考虑记忆化搜索:
状态转移方向“不规律”或“跳跃” :
比如在博弈类题目(如之前的“翻转游戏”)中,一个状态下一步可能跳到任何地方,你很难写出一个简单的 for 循环顺序。
状态空间很大,但实际访问的状态很少(稀疏性) :
如果你开了一个 $1000 \times 1000$ 的 DP 表,但题目实际上只需要计算其中的几十个格子,用循环(DP)会浪费大量时间去填那些没用的格子。
递归逻辑更符合直觉 :
比如“单词拆分”或者“组合总和”,这种“拆解大问题”的思维用递归写起来非常顺手。
什么时候选“动态规划”?(For Loop + DP Table)
当你发现题目有以下特征时,动态规划更香:
状态转移极其规律 :
比如“爬楼梯”、“路径和”、“打家劫舍”。可以清晰地看到第 i 步只依赖 i-1 和 i-2。
需要极致的空间优化 :
如果你发现 dp[i] 只依赖 dp[i-1],你可以用滚动数组 把 $O(n)$ 空间压缩到 $O(1)$。记忆化搜索(因为有递归栈)很难做这种优化。
避免递归深度限制 :
在某些语言(如 Python/C++)中,如果递归太深(比如几万层),会导致栈溢出(Stack Overflow)。这时必须用循环(DP)。
用rand7实现rand10
给定方法 rand7 可生成 [1,7] 范围内的均匀随机整数,试写一个方法 rand10 生成 [1,10] 范围内的均匀随机整数。
你只能调用 rand7() 且不能调用其他方法。请不要使用系统的 Math.random() 方法。
每个测试用例将有一个内部参数 n,即你实现的函数 rand10() 在测试时将被调用的次数。请注意,这不是传递给 rand10() 的参数。
二分法是一种常用的算法,主要包括原始二分查找及实现难度更大的二分变种。二分法是分治思想的体现,它与分治法的区别在于分治法是将一个复杂的问题不断分解成几个规模更小的子问题,直至子问题可以直接求解 ;而二分法则是不断地通过比较操作将问题规模缩小一半,直至找到目标元素
搜索旋转排序数组
整数数组 nums 按升序排列,数组中的值 互不相同 。
在传递给函数之前,nums 在预先未知的某个下标 k(0 <= k < nums.length)上进行了 向左旋转 ,使数组变为 [nums[k], nums[k+1], ..., nums[n-1], nums[0], nums[1], ..., nums[k-1]](下标 从 0 开始 计数)。例如, [0,1,2,4,5,6,7] 下标 3 上向左旋转后可能变为 [4,5,6,7,0,1,2] 。
给你 旋转后 的数组 nums 和一个整数 target ,如果 nums 中存在这个目标值 target ,则返回它的下标,否则返回 -1 。你必须设计一个时间复杂度为 O(log n) 的算法解决此问题。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : int search (vector<int >& nums, int target) int left = 0 , right = nums.size () - 1 ; while (left <= right) { int mid = (right - left) / 2 + left; if (target == nums[mid]) { return mid; } else if (nums[left] > nums[mid]) { if (target > nums[mid] && target <= nums[right]) { left = mid + 1 ; } else { right = mid - 1 ; } } else { if (target >= nums[left] && target < nums[mid]) { right = mid - 1 ; } else { left = mid + 1 ; } } } return -1 ; } };
寻找旋转排序数组中的最小值
已知一个长度为 n 的数组,预先按照升序排列,经由 1 到 n 次 旋转 后,得到输入数组。例如,原数组 nums = [0,1,2,4,5,6,7] 在变化后可能得到:
若旋转 4 次,则可以得到 [4,5,6,7,0,1,2] 若旋转 7 次,则可以得到 [0,1,2,4,5,6,7] 注意,数组 [a[0], a[1], a[2], ..., a[n-1]] 旋转一次 的结果为数组 [a[n-1], a[0], a[1], a[2], ..., a[n-2]] 。
给你一个元素值 互不相同 的数组 nums ,它原来是一个升序排列的数组,并按上述情形进行了多次旋转。请你找出并返回数组中的 最小元素 。
查询的中间元素变得不确定,以往能够通过直接比对判断某个元素是否符合题目要求,而现在缺少直接判断的条件(mid==target)。幸运的是,还是能够通过二分法不断地缩小最终答案可能存在的区间,当区间只剩下一个元素时(l==h),那么它就是最终答案。二分法中有一种类型是查找最左(最右)满足条件的值,这也运用了类似的思想,即在找到满足条件的一个候选答案时,不是直接返回,而是贪心地继续查看是否还有其他答案。例如要在一个数组[1,2,2,3,4]中找最左边的等于2的值,当我们找到索引值为2的项时,不能直接返回,而是继续贪心地搜索区间,将右边的区间舍弃并继续查看左侧是否还有另外一个2
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : int findMin (vector<int >& nums) int ans{}; int left = 0 , right = nums.size () - 1 ; while (left <= right) { if (left == right) { return nums[left]; } int mid = (right - left) / 2 + left; if (nums[mid] < nums[right]) { right = mid; } else { left = mid + 1 ; } } return -1 ; } }; class Solution {public : int findMin (vector<int >& nums) int low = 0 ; int high = nums.size () - 1 ; while (low < high) { int pivot = low + (high - low) / 2 ; if (nums[pivot] < nums[high]) { high = pivot; } else { low = pivot + 1 ; } } return nums[low]; } };
搜索旋转排序II
已知存在一个按非降序排列的整数数组 nums ,数组中的值不必互不相同。
在传递给函数之前,nums 在预先未知的某个下标 k(0 <= k < nums.length)上进行了 旋转 ,使数组变为 [nums[k], nums[k+1], ..., nums[n-1], nums[0], nums[1], ..., nums[k-1]](下标 从 0 开始 计数)。例如, [0,1,2,4,4,4,5,6,6,7] 在下标 5 处经旋转后可能变为 [4,5,6,6,7,0,1,2,4,4] 。
给你 旋转后 的数组 nums 和一个整数 target ,请你编写一个函数来判断给定的目标值是否存在于数组中。如果 nums 中存在这个目标值 target ,则返回 true ,否则返回 false 。
你必须尽可能减少整个操作步骤。
在上一题中,通过 nums[left] <= nums[mid] 就能确切地判断左半部分是否有序。但在有重复的情况下,如果 nums[left] == nums[mid]
为了解决这个问题,当我们遇到 nums[left] == nums[mid] 时,我们不能简单地排除一半区间,但我们可以确定:既然 nums[mid] 不是我们要找的 target,那么当前的 left 也是多余的。
对策: 执行 left++,缩小范围,然后进入下一次二分判定。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Solution {public : bool search (vector<int >& nums, int target) int left = 0 , right = nums.size () - 1 ; while (left <= right) { int mid = (right - left) / 2 + left; if (nums[mid] == target) { return true ; } if (nums[mid] == nums[left]) { left++; continue ; } if (nums[mid] < nums[left]) { if (target > nums[mid] && target <= nums[right]) { left = mid + 1 ; } else { right = mid - 1 ; } } else { if (target >= nums[left] && target < nums[mid]) { right = mid - 1 ; } else { left = mid + 1 ; } } } return false ; } };
爱吃香蕉的珂珂
珂珂喜欢吃香蕉。这里有 n 堆香蕉,第 i 堆中有 piles[i] 根香蕉。警卫已经离开了,将在 h 小时后回来。
珂珂可以决定她吃香蕉的速度 k (单位:根/小时)。每个小时,她将会选择一堆香蕉,从中吃掉 k 根。如果这堆香蕉少于 k 根,她将吃掉这堆的所有香蕉,然后这一小时内不会再吃更多的香蕉。
珂珂喜欢慢慢吃,但仍然想在警卫回来前吃掉所有的香蕉。
返回她可以在 h 小时内吃掉所有香蕉的最小速度 k(k 为整数)。
由于每小时最多只能吃一堆香蕉,速度最多达到最大堆的数量即可,因此,速度的范围为[1,max(piles)],也就是答案一定在这个范围内。
道题可以看作在[1,max(piles)]中查找一个元素k。因此一个简单的思路是枚举从1到max(piles)的所有速度,并判断是否可以吃完,返回最早能够吃完的速度即可。注意在从1到max(piles)进行枚举的过程中,速度是单调递增变化的,这很容易让我们联想到前面的题目。具体来说,当我们在[l,h]中判断中间的速度mid是否可行时,有如下可能。● mid不可行,则速度不够快,最小速度位于[mid+1,h]中,更新左边界l为mid+1。
● mid可行,则可能的最小速度小于或等于mid,最小速度位于[l,mid]中,mid可能是最终答案,但不能直接排除,更新右边界h为mid。
● l等于h,则查找区间只剩下一个l,最小速度等于l。因此这道题就是找到最小的可以吃完的速度,也就是上一节提到的最左满足条件的值的题目类型
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution {public : bool isValid (vector<int >& piles, int m, int h) long long cnt{}; for (auto & p : piles) { cnt += (p + m - 1 ) / m; } return cnt <= h; } int minEatingSpeed (vector<int >& piles, int h) int max_val = *max_element (piles.begin (), piles.end ()); int l = 1 , r = max_val; int res{}; while (l <= r) { int m = (r - l) / 2 + l; if (isValid (piles, m, h)) { res = m; r = m - 1 ; } else { l = m + 1 ; } } return res; } };
类似的题目
给你一个 下标从 0 开始 的整数数组 candies 。数组中的每个元素表示大小为 candies[i] 的一堆糖果。你可以将每堆糖果分成任意数量的 子堆 ,但 无法 再将两堆合并到一起。
另给你一个整数 k 。你需要将这些糖果分配给 k 个小孩,使每个小孩分到 相同 数量的糖果。每个小孩可以拿走 至多一堆 糖果,有些糖果可能会不被分配。
返回每个小孩可以拿走的 最大糖果数目 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : bool isValid (vector<int >& candies, int m, long long k) if (m == 0 ) { return true ; } long long cnt{}; for (auto & c : candies) { cnt += c / m; } return cnt >= k; } int maximumCandies (vector<int >& candies, long long k) int l = 0 , r = *max_element (candies.begin (), candies.end ()); int res{}; while (l <= r) { int m = (r - l) / 2 + l; if (isValid (candies, m, k)) { l = m + 1 ; res = m; } else { r = m - 1 ; } } return res; } };
给你一个整数 n ,表示有 n 间零售商店。总共有 m 种商品,每种商品的数目用一个下标从 0 开始的整数数组 quantities 表示,其中 quantities[i] 表示第 i 种商品的数目。
你需要将 所有商品 分配到零售商店,并遵守这些规则:
一间商店 至多 只能有 一种商品 ,但一间商店拥有的商品数目可以为 任意 件。 分配后,每间商店都会被分配一定数目的商品(可能为 0 件)。用 x 表示所有商店中分配商品数目的最大值,你希望 x 越小越好。也就是说,你想 最小化 分配给任意商店商品数目的 最大值 。 请你返回最小的可能的 x 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : bool isValid (vector<int >& quantities, int m, int n) int cnt{}; for (auto & q : quantities) { cnt += (q + m - 1 ) / m; } return cnt <= n; } int minimizedMaximum (int n, vector<int >& quantities) int l = 1 , r = *max_element (quantities.begin (), quantities.end ()); int ans{}; while (l <= r) { int mid = (r - l) / 2 + l; if (isValid (quantities, mid, n)) { r = mid - 1 ; ans = mid; } else { l = mid + 1 ; } } return ans; } };
给你一个整数数组 ranks ,表示一些机械工的 能力值 。ranksi 是第 i 位机械工的能力值。能力值为 r 的机械工可以在 r * n2 分钟内修好 n 辆车。
同时给你一个整数 cars ,表示总共需要修理的汽车数目。
请你返回修理所有汽车 最少 需要多少时间。
注意: 所有机械工可以同时修理汽车。
寻找峰值
峰值元素是指其值严格大于左右相邻值的元素。
给你一个整数数组 nums,找到峰值元素并返回其索引。数组可能包含多个峰值,在这种情况下,返回 任何一个峰值 所在位置即可。
你可以假设 nums[-1] = nums[n] = -∞ 。你必须实现时间复杂度为 O(log n) 的算法来解决此问题。
这道题的背景是在数组中查找目标值(峰值元素),虽然数组不是有序的,但峰值元素具备某种性质(大于左右相邻值的元素),可以尝试使用二分法。关注中间元素和左右相邻元素的关系,当右相邻元素大于中间元素时,意味着右相邻元素可能是峰值,其大于左边元素的条件已经满足,只要右相邻元素也大于它右边元素即可。顺着右边的方向继续扫描,存在以下两种情况。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 class Solution {public : int findPeakElement (vector<int >& nums) int sz = nums.size (); int l = 0 , r = sz - 1 ; while (l <= r) { int m = (r - l) / 2 + l; int n = nums[m]; if ((m + 1 < sz) && nums[m + 1 ] > n) { l = m + 1 ; } else if (m != 0 && nums[m - 1 ] > n) { r = m - 1 ; } else { return m; } } return -1 ; } }; class Solution { public int findPeakElement (int [] nums) int left = 0 , right = nums.length - 1 ; while (left < right) { int mid = left + (right - left) / 2 ; if (nums[mid] > nums[mid + 1 ]) { right = mid; } else { left = mid + 1 ; } } return left; } }
寻找峰值II
一个 2D 网格中的 峰值 是指那些 严格大于 其相邻格子(上、下、左、右)的元素。
给你一个 从 0 开始编号 的 m x n 矩阵 mat ,其中任意两个相邻格子的值都 不相同 。找出 任意一个 峰值 mat[i][j] 并 返回其位置 [i,j] 。
你可以假设整个矩阵周边环绕着一圈值为 -1 的格子。
要求必须写出时间复杂度为 O(m log(n)) 或 O(n log(m)) 的算法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution {public : vector<int > findPeakGrid (vector<vector<int >>& mat) { int m = mat.size (); int n = mat[0 ].size (); int l =0 , r = m - 1 ; while (l <= r) { int i = (r - l) / 2 + l; int j = max_element (mat[i].begin (), mat[i].end ()) - mat[i].begin (); if ((i >= 1 ) && mat[i][j] < mat[i - 1 ][j]) { r = i - 1 ; continue ; } if ((i < m - 1 ) && mat[i][j] < mat[i + 1 ][j]) { l = i + 1 ; continue ; } return {i, j}; } return {}; } };
分割数组的最大值
给定一个非负整数数组 nums 和一个整数 k ,你需要将这个数组分成 k 个非空的连续子数组,使得这 k 个子数组各自和的最大值 最小 。返回分割后最小的和的最大值。子数组 是数组中连续的部分。
假设这个和为 $X$:
如果我们可以把数组分成 $\le k$ 个子数组,且每个子数组的和都不超过 $X$,说明 $X$ 可能太大了 ,我们可以尝试更小的 $X$。 如果我们无论如何都要分成超过 $k$ 个子数组才能保证每组和 $\le X$,说明 $X$ 太小了 ,必须调大。 确定二分的边界:
左边界 (left) :数组中的最大值 。因为每个数都要属于一个子数组,最大值所在的组之和至少就是它自己。右边界 (right) :数组中所有元素之和 。对应 $k=1$ 的极端情况。对于给定的目标值 mid,我们如何判断 $k$ 个子数组是否够用? 使用贪心策略 :从左往右累加元素,只要当前和超过了 mid,就必须在这里“切一刀”,开启一个新的子数组。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : bool isValid (vector<int >& nums, int k, int m) int cnt{1 }; int acc{}; for (int i = 0 ; i < nums.size (); i++) { if (acc + nums[i] <= m) { acc += nums[i]; } else { acc = nums[i]; cnt++; } } return cnt <= k; } int splitArray (vector<int >& nums, int k) int l = *max_element (nums.begin (), nums.end ()); int r = accumulate (nums.begin (), nums.end (), 0 ); int ans{}; while (l <= r) { int m = (r - l) / 2 + l; if (isValid (nums, k, m)) { r = m - 1 ; ans = m; } else { l = m + 1 ; } } return ans; } };
简单的题目能够一眼看出“查找”任务,读者也就可以联想到使用二分法;中等级别或困难级别的题目往往背景复杂,无法马上看出是“查找”任务,需要读者进一步加工并对题目进行转换,利用题目中的已知信息,构建查找的目标,以及目标所在的范围。此外,当题目的数据规模超过1e7时,有较大的可能是二分法类型的题目,这也是一个识别二分法的小技巧。
关注查找范围内的中间元素,挖掘背后的规律,往往中间元素和题目的目标值、左右相邻元素及左右边界元素等存在一定的关联 ,根据这些关联可以将查找范围缩小一半。
具体的实现方法包括原始的二分查找及二分查找的变种,二者的实现难度不大,唯一需要注意的是二分查找的变种的边界问题,当更新左边界l=mid时,需要修改循环的退出条件为l+1==h or l==h。
两球之间的磁力
在代号为 C-137 的地球上,Rick 发现如果他将两个球放在他新发明的篮子里,它们之间会形成特殊形式的磁力。Rick 有 n 个空的篮子,第 i 个篮子的位置在 position[i] ,Morty 想把 m 个球放到这些篮子里,使得任意两球间 最小磁力 最大。
已知两个球如果分别位于 x 和 y ,那么它们之间的磁力为 |x - y| 。
给你一个整数数组 position 和一个整数 m ,请你返回最大化的最小磁力。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : bool isValid (vector<int >& pos, int r, int m) int res{1 }; int prevpose = pos[0 ]; for (int i = 1 ; i < pos.size (); i++) { int p = pos[i]; if (p - prevpose >= r) { res++; prevpose = p; } } return res >= m; } int maxDistance (vector<int >& position, int m) sort (position.begin (), position.end ()); int l = 1 , r = position.back () - position.front (); int ans{}; while (l <= r) { int mid = (r - l) / 2 + l; if (isValid (position, mid, m)) { ans = mid; l = mid + 1 ; } else { r = mid - 1 ; } } return ans; } };
最长递增子序列
给你一个整数数组 nums ,找到其中最长严格递增子序列的长度。
子序列 是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7] 是数组 [0,3,1,6,2,2,7] 的子序列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 #include <vector> #include <algorithm> using namespace std;class Solution {public : int lengthOfLIS (vector<int >& nums) if (nums.empty ()) return 0 ; vector<int > tails; for (int x : nums) { auto it = lower_bound (tails.begin (), tails.end (), x); if (it == tails.end ()) { tails.push_back (x); } else { *it = x; } } return tails.size (); } };
计算机中的数据都是以二进制的形式存储的,二进制的运算都是按位来进行的。以整数为例,位运算就是直接对整数在内存中的二进制位进行操作,效率比算术运算要高。
例如,求一个数的2倍的值,使用位运算比算术运算要快很多,因为算术运算的乘法指令所用的指令周期(指令周期是指CPU从内存取出一条指令并执行这条指令的时间总和)比位运算的移位指令所用的指令周期长
位运算包括取反、按位或、按位异或、按位与、移位等操作。常见的位运算符如下。
取反(~):按位取反,1变0,0变1。 按位或(|):操作位中只要有1,则结果为1;否则结果为0。 按位异或(^):操作位中只要有两位相反(一个为1,一个为0),则结果为1;否则结果为0。 按位与(&):操作位中只要有两位全部为1,则结果为1;否则结果为0。 移位(<<或>>):移位分为算术移位和逻辑移位;根据移位方向又分为左移运算和右移运算。 给定一个正整数 n,编写一个函数,获取一个正整数的二进制形式并返回其二进制表达式中 设置位 的个数(也被称为汉明重量 )。
不去检测整数的每一位,而是依次将最低位且值为1的比特位翻转为0,并增加计数器。当执行结果使整数为0时,该整数不再包含任何为1的比特,返回计数器的值。此时的关键问题是如何执行“翻转最低有效比特为1的比特为0”,此处可以使用n &(n-1)的操作。
1 2 3 4 5 6 7 8 9 10 11 class Solution {public : int hammingWeight (int n) int res{}; while (n > 0 ) { n = n & (n - 1 ); res++; } return res; } };
两整数之和
给你两个整数 a 和 b ,不使用 运算符 + 和 - ,计算并返回两整数之和。
有符号整数通常用补码来表示和存储,补码具有如下特征:
正整数的补码与原码相同;负整数的补码为其原码除符号位外的所有位取反后加 1。可以将减法运算转化为补码的加法运算来实现。符号位与数值位可以一起参与运算.
逻辑右移 (Logical Right Shift)
规则 :不管三七二十一,左边统一补 0 。适用 :无符号数(unsigned)。后果 :如果你把一个负数进行逻辑右移,符号位的 1 会被移走,左边补 0,这个数会瞬间从负数变成一个巨大的正数。算术右移 (Arithmetic Right Shift)
规则 :左边补符号位 (原来是 0 就补 0,原来是 1 就补 1)。适用 :有符号数(int)。意义 :为了维持数学上的“除以 2” 。如果一个负数除以 2 之后变成了正数,那数学逻辑就崩了,所以必须补 1 来保持它的负号。术左移和逻辑左移是同一条指令。
在 C++20 之前,int 的右移行为是由“编译器实现决定”的(Implementation-defined),虽然几乎所有现代编译器都默认使用算术右移,但理论上存在不确定性。C++20 正式将其统一为算术右移。
在 Java 语言中,为了避免 C++ 这种“隐式”的规则,专门设计了两个操作符:
>>>>>1 2 3 4 5 6 7 8 9 10 11 class Solution {public : int getSum (int a, int b) while (b != 0 ) { unsigned int carry = (unsigned int )(a & b) << 1 ; a = a ^ b; b = carry; } return a; } };
整数替换
给定一个正整数 n ,你可以做如下操作:
如果 n 是偶数,则用 n / 2替换 n 。 如果 n 是奇数,则可以用 n + 1或n - 1替换 n 。 返回 n 变为 1 所需的 最小替换次数 。
当 n 为奇数时,我们可以选择将 n 增加 1 或减少 1。由于这两种方法都会将 n 变为偶数,那么下一步一定是除以 2,因此这里我们可以看成使用两次操作,将 n 变为 (n+1)/2和(n-1)/2.
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class Solution {public : int search (unordered_map<int , int >& memo, int n) if (memo.count (n)) { return memo[n]; } if (n & 1 ) { int l1 = search (memo, n / 2 ); int l2 = search (memo, n / 2 + 1 ); memo[n] = min (l1, l2) + 2 ; } else { int l = search (memo, n / 2 ); memo[n] = l + 1 ; } return memo[n]; } int integerReplacement (int n) unordered_map<int , int > memo; memo[1 ] = 0 ; return search (memo, n); } };
利用二进制特性的最优解。核心思想是:奇数时,通过 $+1$ 或 $-1$ 尽可能让低位产生更多的 $0$。
算法逻辑:
若 $n$ 是偶数 :直接右移($n = n >> 1$)。若 $n$ 是奇数 :观察最后两位:如果是 ...01:减 1 效果更好(变为 ...00)。 如果是 ...11:加 1 效果更好(进位变为 ...00)。 特例处理 :当 $n = 3$ 时,二进制虽是 11,但 $3 \to 2 \to 1$(2步)优于 $3 \to 4 \to 2 \to 1$(3步),所以 $3$ 选择减 1。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : int integerReplacement (int n) int res{}; while (n != 1 ) { if (n & 1 ) { if (n == 3 ) { res += 2 ; n = 1 ; } else if ((n & 3 ) == 3 ) { res += 2 ; n = n / 2 + 1 ; } else if ((n & 3 ) == 1 ) { res += 2 ; n /= 2 ; } } else { n /= 2 ; res++; } } return res; } };
只出现一次的数字
给你一个 非空 整数数组 nums ,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
1 2 3 4 5 6 7 8 9 10 class Solution {public : int singleNumber (vector<int >& nums) int res{}; for (auto & n:nums) { res ^= n; } return res; } };
只出现一次的数字II
给你一个整数数组 nums ,除某个元素仅出现 一次 外,其余每个元素都恰出现 三次 。 请你找出并返回那个只出现了一次的元素。你必须设计并实现线性时间复杂度的算法且使用常数级空间来解决此问题。
简单异或法无法筛选出唯一的单一元素,因为异或法无法将3个元素消除,但考虑到在元素的二进制形式中,对于出现3次的元素,它的二进制形式中的每一位都是3的倍数,统计所有数字的二进制形式中1出现的次数,并对3求余,如果结果不为0,则说明出现1次的数字在该二进制位上为1
逐位计数法(通用且稳健),这种方法遍历 32 个比特位,统计每一位上 $1$ 出现的次数。如果某一位的计数不能被 3 整除,那么目标数字在该位就是 $1$。如果改为出现 $k$ 次,只需将 % 3 改为 % k
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : int singleNumber (vector<int >& nums) int res{}; for (int i = 0 ; i < 32 ; i++) { int r{}; for (auto & n : nums) { r += ((n>>i)&1 ); } if (r % 3 == 1 ) { res |= (1 << i); } } return res; } };
另外还可以利用真值表推导转换为规则并行处理二进制
只出现一次的数字 II
给你一个整数数组 nums,其中恰好有两个元素只出现一次,其余所有元素均出现两次。 找出只出现一次的那两个元素。你可以按 任意顺序 返回答案。你必须设计并实现线性时间复杂度的算法且仅使用常量额外空间来解决此问题。
假设这两个只出现一次的数字是 $x$ 和 $y$。
全局异或 :对数组所有元素进行异或。因为出现两次的数字都会抵消($a \oplus a = 0$),最终结果 xorSum = x ^ y。寻找差异位 :由于 $x \neq y$,xorSum 必然不为 0。这意味着 $x$ 和 $y$ 的二进制表示中至少有一位是不同的(一个是 0,一个是 1)。我们取出 xorSum 中最低位的 1(称为 lowbit)。分组异或 :根据 lowbit 这一位是否为 1,将原数组中的所有数字分成两组:第一组:该位为 1 的所有数字。 第二组:该位为 0 的所有数字 结果产出 :相同的数字必然会被分到同一组并相互抵消。 $x$ 和 $y$ 必然会被分到不同的组。 对两组分别异或,剩下的两个数就是 $x$ 和 $y$。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #include <vector> using namespace std;class Solution {public : vector<int > singleNumber (vector<int >& nums) { long xorSum = 0 ; for (int num : nums) { xorSum ^= num; } int lowbit = xorSum & -xorSum; int x = 0 , y = 0 ; for (int num : nums) { if (num & lowbit) { x ^= num; } else { y ^= num; } } return {x, y}; } };
在面试过程中,如果题目中出现二进制、与2的倍数相关的问题、不能使用算术运算符等情况时,都可以考虑是否可以使用位运算解题。当然,在做题的过程中,也要善于总结规律,这样在真正的笔试、面试过程中,才能够迅速写出简洁、高效的代码。另外还有一种常见的位运算使用场景是状态压缩
这类题更加强调对数据结构的设计,以达到高效实现某些操作的目的。这种题目需要我们对各种基础数据结构的特性及基本操作有着非常好的理解。
最小栈
设计一个支持 push ,pop ,top 操作,并能在常数时间内检索到最小元素的栈。
实现 MinStack 类:
MinStack() 初始化堆栈对象。void push(int val) 将元素val推入堆栈。void pop() 删除堆栈顶部的元素。int top() 获取堆栈顶部的元素。int getMin() 获取堆栈中的最小元素。对于栈来说,如果一个元素 a 在入栈时,栈里有其它的元素 b, c, d,那么只要 a 在栈中,b, c, d 就一定在栈中。
那么在任何时候只要栈a在栈中,栈中元素一定是a,b,c,d.那么可以在每个元素 a 入栈时把当前栈的最小值 m 存储起来。在这之后无论何时,如果栈顶元素是 a,就可以直接返回存储的最小值 m。
只需要设计一个数据结构,使得每个元素 a 与其相应的最小值 m 时刻保持一一对应。因此可以使用一个辅助栈,与元素栈同步插入与删除
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class MinStack {public : stack<int > stk; stack<int > mstack; MinStack () { mstack.push (INT_MAX); } void push (int val) stk.push (val); mstack.push (min (mstack.top (),val)); } void pop () stk.pop (); mstack.pop (); } int top () int val = stk.top (); return val; } int getMin () return mstack.top (); } };
实现前缀树
前缀树 是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。这一数据结构有相当多的应用情景,例如自动补全和拼写检查。
一棵有根树,其每个节点包含以下字段:
指向子节点的指针数组 children 。对于本题而言,数组长度为 26,即小写英文字母的数量。此时 children[0] 对应小写字母 a,children[1] 对应小写字母 b,…,children[25] 对应小写字母 z。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 class Trie {public : class Node { public : vector<Node*> children{26 }; bool isEnd{false }; }; Node* root{}; Trie () { root = new Node (); } void insert (string word) Node* cur = root; for (auto & ch : word) { int idx = ch - 'a' ; Node* node = cur->children[idx]; if (node == nullptr ) { node = new Node; cur->children[idx] = node; } cur = node; } cur->isEnd = true ; } bool search (string word) Node* cur = root; for (auto & ch : word) { int idx = ch - 'a' ; Node* node = cur->children[idx]; if (node == nullptr ) { return false ; } cur = node; } if (cur->isEnd == false ) { return false ; } return true ; } bool startsWith (string prefix) Node* cur = root; for (auto & ch : prefix) { int idx = ch - 'a' ; Node* node = cur->children[idx]; if (node == nullptr ) { return false ; } cur = node; } return true ; } };
LRU缓存
请你设计并实现一个满足 LRU (最近最少使用) 缓存 约束的数据结构。
实现 LRUCache 类:
LRUCache(int capacity) 以 正整数 作为容量 capacity 初始化 LRU 缓存int get(int key) 如果关键字 key 存在于缓存中,则返回关键字的值,否则返回 -1 。void put(int key, int value) 如果关键字 key 已经存在,则变更其数据值 value ;如果不存在,则向缓存中插入该组 key-value 。如果插入操作导致关键字数量超过 capacity ,则应该 逐出 最久未使用的关键字。函数 get 和 put 必须以 O(1) 的平均时间复杂度运行。
LRU 缓存机制可以通过哈希表辅以双向链表实现,我们用一个哈希表和一个双向链表维护所有在缓存中的键值对。
双向链表按照被使用的顺序存储了这些键值对,靠近头部的键值对是最近使用的,而靠近尾部的键值对是最久未使用的。
哈希表即为普通的哈希映射(HashMap),通过缓存数据的键映射到其在双向链表中的位置。
在双向链表的实现中,使用一个伪头部(dummy head)和伪尾部(dummy tail)标记界限,这样在添加节点和删除节点的时候就不需要检查相邻的节点是否存在。
为什么使用双向链表而不是单向链表?其原因在于,如果想在常数时间内将链表中间的节点移动到尾部,需要能够在O(1)时间内获得当前节点的前驱节点。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 class LRUCache {public : unordered_map<int , list<pair<int , int >>::iterator> umap; list<pair<int , int >> vals; int _capacity{}; int cnt{}; LRUCache (int capacity) : _capacity(capacity) {} int get (int key) if (umap.count (key)) { auto it = umap[key]; int val = it->second; umap.erase (key); vals.erase (it); vals.push_front ({key, val}); umap[key] = vals.begin (); return val; } return -1 ; } void put (int key, int value) if (umap.count (key)) { auto it = umap[key]; vals.erase (it); vals.push_front ({key, value}); umap.erase (key); umap[key] = vals.begin (); } else { vals.push_front ({key, value}); umap[key] = vals.begin (); cnt++; if (cnt > _capacity) { auto it = vals.rbegin (); umap.erase (it->first); vals.pop_back (); } } } };
实际的算法历史上,出现了很多性能更加优秀的变种,比如下面这两种。● LRU-K算法,用于删除第k个最近使用的数据。● ARC算法,维护了最近被删除数据的历史,特别适合用于需要连续扫描的情况。而在著名的Redis中同样实现了两个LRU算法的变种。
● volatile-LRU:从已设置过期时间的数据集中挑选最近最少使用的数据来淘汰。
● allkeys-LRU:从所有数据集中挑选最近最少使用的数据来淘汰。在Redis中LRU变种的具体实现细节
LFU缓存
请你为 最不经常使用(LFU) 缓存算法设计并实现数据结构。
实现 LFUCache 类:
LFUCache(int capacity) - 用数据结构的容量 capacity 初始化对象int get(int key) - 如果键 key 存在于缓存中,则获取键的值,否则返回 -1 。void put(int key, int value) - 如果键 key 已存在,则变更其值;如果键不存在,请插入键值对。当缓存达到其容量 capacity 时,则应该在插入新项之前,移除最不经常使用的项。在此问题中,当存在平局(即两个或更多个键具有相同使用频率)时,应该去除 最久未使用 的键。为了确定最不常使用的键,可以为缓存中的每个键维护一个 使用计数器 。使用计数最小的键是最久未使用的键。
当一个键首次插入到缓存中时,它的使用计数器被设置为 1 (由于 put 操作)。对缓存中的键执行 get 或 put 操作,使用计数器的值将会递增。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 class LFUCache {public : class Node { public : int key{}; int val{}; int freq{}; public : Node () { }; Node (int k, int v, int f) : key (k), val (v), freq (f) {} }; unordered_map<int , list<Node>::iterator> nodeMap; unordered_map<int , list<Node>> freqMap; int min_freq{INT_MAX}; int _capacity{}; int cnt{}; LFUCache (int capacity) : _capacity(capacity) {} int get (int key) if (!nodeMap.count (key)) { return -1 ; } int val = touch (key); return val; } int touch (int key) auto it = nodeMap[key]; int val = it->val; int freq = it->freq; freqMap[freq].erase (it); if (freqMap[freq].empty ()) { freqMap.erase (freq); if (freq == min_freq) { min_freq++; } } ++freq; freqMap[freq].push_front ({key, val, freq}); nodeMap[key] = freqMap[freq].begin (); return val; } void put (int key, int value) if (nodeMap.count (key)) { auto it = nodeMap[key]; it->val = value; touch (key); return ; } if (cnt == _capacity) { auto & nodes = freqMap[min_freq]; auto it = nodes.rbegin (); nodeMap.erase (it->key); nodes.pop_back (); if (nodes.empty ()) { freqMap.erase (min_freq); } cnt--; } freqMap[1 ].push_front ({key, value, 1 }); nodeMap[key] = freqMap[1 ].begin (); min_freq = 1 ; cnt++; } };
设计跳表
跳表 是在 O(log(n)) 时间内完成增加、删除、搜索操作的数据结构。跳表相比于树堆与红黑树,其功能与性能相当,并且跳表的代码长度相较下更短,其设计思想与链表相似。
跳表是一种随机化的数据结构,可以被看做二叉树的一个变种,它在性能上和红黑树、AVL 树不相上下,但是跳表的原理非常简单,目前在 Redis 和 LevelDB 中都有用到。跳表的期望空间复杂度为 O(n),跳表的查询,插入和删除操作的期望时间复杂度均为 O(logn)。
跳表实际为一种多层的有序链表,跳表的每一层都为一个有序链表,且满足每个位于第 i 层的节点有 p 的概率出现在第 i+1 层,其中 p 为常数。
查找时,从当前最高层开始开始,如果当前层水平地逐个比较直至当前节点的下一个节点大于等于目标节点,然后移动至下一层进行查找,重复这个过程直至到达第一层。此时,若下一个节点是目标节点,则成功查找;反之,则元素不存在。由于从高层往低层开始查找,由于低层出现的元素可能不会出现在高层,因此跳表在进行查找的过程中会跳过一些元素,相比于有序链表的查询,跳表的查询速度会更快。
添加时,从跳表的当前的最大层数 level 层开始查找,在当前层水平地逐个比较直至当前节点的下一个节点大于等于目标节点,然后移动至下一层进行查找,重复这个过程直至到达第 1 层。设新加入的节点为 newNode,我们需要计算出此次节点插入的层数 lv,如果 level 小于 lv,则同时需要更新 level。用数组 update 保存每一层查找的最后一个节点,第 i 层最后的节点为 update[i]。我们将 newNode 的后续节点指向 update[i] 的下一个节点,同时更新 update[i] 的后续节点为 newNode。 lv随机生成,从第一层开始,如果概率小于某个值,则再加一层。
删除时,首先我们需要查找当前元素是否存在跳表中。从跳表的当前的最大层数 level 层开始查找,在当前层水平地逐个比较直至当前节点的下一个节点大于等于目标节点,然后移动至下一层进行查找,重复这个过程直至到达第 1 层。如果第 1 层的下一个节点不等于 num 时,则表示当前元素不存在直接返回。我们用数组 update 保存每一层查找的最后一个节点,第 i 层最后的节点为 update[i]。此时第 i 层的下一个节点的值为 num,则我们需要将其从跳表中将其删除。由于第 i 层的以 p 的概率出现在第 i+1 层,因此我们应当从第 1 层开始往上进行更新,将 num 从 update[i] 的下一跳中删除,同时更新 update[i] 的后续节点,直到当前层的链表中没有出现 num 的节点为止。最后我们还需要更新跳表中当前的最大层数 level。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 class Skiplist {public : const static int MAX_LEVEL = 32 ; const static int factor = .25 ; class SkipListNode { public : int val{}; vector<SkipListNode*> next; SkipListNode (int t_val, int max_level = MAX_LEVEL) : val (t_val), next (max_level, nullptr ) {} }; SkipListNode* skipNode; int level{}; Skiplist () { skipNode = new SkipListNode (-1 ); } bool search (int target) SkipListNode* cur = skipNode; for (int i = level - 1 ; i >= 0 ; i--) { while (cur->next[i] && cur->next[i]->val < target) { cur = cur->next[i]; } } cur = cur->next[0 ]; if (cur && cur->val == target) { return true ; } return false ; } int randomLevel () int lv{1 }; while (rand () < factor && lv < MAX_LEVEL) { lv++; } return lv; } void add (int num) vector<SkipListNode*> update (MAX_LEVEL, skipNode) ; SkipListNode* cur = skipNode; for (int i = level - 1 ; i >= 0 ; i--) { while (cur->next[i] && cur->next[i]->val < num) { cur = cur->next[i]; } update[i] = cur; } int lv = randomLevel (); level = max (lv, MAX_LEVEL); SkipListNode* newNode = new SkipListNode (num, lv); for (int i = 0 ; i < lv; i++) { newNode->next[i] = update[i]->next[i]; update[i]->next[i] = newNode; } } bool erase (int num) vector<SkipListNode*> update (MAX_LEVEL, nullptr ) ; SkipListNode* cur = skipNode; for (int i = level - 1 ; i >= 0 ; i--) { while (cur->next[i] && cur->next[i]->val < num) { cur = cur->next[i]; } update[i] = cur; } cur = cur->next[0 ]; if (!cur || cur->val != num) { return false ; } for (int i = 0 ; i < level; i++) { if (update[i]->next[i] != cur) { break ; } update[i]->next[i] = cur->next[i]; } delete cur; while (level > 1 && skipNode->next[level - 1 ] == nullptr ) { level--; } return true ; } };
添加与搜索单词
字典树(前缀树)是一种树形数据结构,用于高效地存储和检索字符串数据集中的键。前缀树可以用 O(∣S∣) 的时间复杂度完成如下操作,其中 ∣S∣ 是插入字符串或查询前缀的长度:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 class WordDictionary {public : struct Node { char ch{}; vector<Node*> next{26 , nullptr }; bool isEnd{}; }; Node* root{}; WordDictionary () { root = new Node; } void addWord (string word) Node* cur = root; for (auto & ch : word) { Node* node = cur->next[ch - 'a' ]; if (node == nullptr ) { node = new Node; node->ch = ch; cur->next[ch - 'a' ] = node; } cur = node; } cur->isEnd = true ; } bool dfs (string& word, int idx, Node* cur) if (idx == word.size ()) { if (cur->isEnd == true ) { return true ; } return false ; } char ch = word[idx]; if (ch == '.' ) { for (int i = 0 ; i < 26 ; i++) { if (cur->next[i]) { if (dfs (word, idx + 1 , cur->next[i])) { return true ; } } } } else { int index = ch - 'a' ; if (cur->next[index]) { return dfs (word, idx + 1 , cur->next[index]); } } return false ; } bool search (string word) Node* cur = root; return dfs (word, 0 , cur); } };
二叉树的序列化与反序列化
序列化是将一个数据结构或者对象转换为连续的比特位的操作,进而可以将转换后的数据存储在一个文件或者内存中,同时也可以通过网络传输到另一个计算机环境,采取相反方式重构得到原数据。
请设计一个算法来实现二叉树的序列化与反序列化。这里不限定你的序列 / 反序列化算法执行逻辑,你只需要保证一个二叉树可以被序列化为一个字符串并且将这个字符串反序列化为原始的树结构。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 class Codec {public : void serializeTree (TreeNode* node, string& str) if (!node) { str += "None," ; return ; } str += to_string (node->val) + "," ; serializeTree (node->left, str); serializeTree (node->right, str); } string serialize (TreeNode* root) { string res; serializeTree (root, res); return res; } TreeNode* rserialize (list<string>& dataArray) { if (dataArray.front () == "None" ) { dataArray.erase (dataArray.begin ()); return nullptr ; } TreeNode* node = new TreeNode (stoi (dataArray.front ())); dataArray.erase (dataArray.begin ()); node->left = rserialize (dataArray); node->right = rserialize (dataArray); return node; } TreeNode* deserialize (string data) { list<string> dataArray; string str; for (char & ch : data) { if (ch == ',' ) { dataArray.push_back (str); str.clear (); } else { str.push_back (ch); } } if (!str.empty ()) { dataArray.push_back (str); str.clear (); } return rserialize (dataArray); } };
可以先序遍历这颗二叉树,遇到空子树的时候序列化成 None,否则继续递归序列化。那么我们如何反序列化呢?首先我们需要根据 , 把原先的序列分割开来得到先序遍历的元素列表,然后从左向右遍历这个序列:
如果当前的元素为 None,则当前为空树.否则先解析这棵树的左子树,再解析它的右子树
字符的编码与解码
请你设计一个算法,可以将一个 字符串列表 编码成为一个 字符串 。这个编码后的字符串是可以通过网络进行高效传送的,并且可以在接收端被解码回原来的字符串列表。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Codec {public : string strLen (string& str) { int sz = str.size (); return to_string (sz) + "#" + str; } string encode (vector<string>& strs) { string res; for (auto & str : strs) { res += strLen (str); } return res; } vector<string> decode (string s) { vector<string> res; for (int i = 0 ; i < s.size (); i++) { int num{}; while (i < s.size () && isdigit (s[i])) { num = num * 10 + (s[i] - '0' ); i++; } i++; res.push_back (s.substr (i, num)); i = i+num-1 ; } return res; } };
循环双端队列
以通过一个数组进行模拟,通过操作数组的索引构建一个虚拟的首尾相连的环。在循环队列结构中,设置一个队尾 rear 与队首 front ,且大小固定
在循环队列中,当队列为空,可知 front=rear;而当所有队列空间全占满时,也有 front=rear。为了区别这两种情况,假设队列使用的数组有 capacity 个存储空间,则此时规定循环队列最多只能有capacity−1 个队列元素,当循环队列中只剩下一个空存储单元时,则表示队列已满。根据以上可知,队列判空的条件是 front=rear,而队列判满的条件是 front=(rear+1)modcapacity。
elements:一个固定大小的数组,用于保存循环队列的元素。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 class MyCircularDeque {public : int _cap{}; int * arr; int start{}; int end{}; MyCircularDeque (int k) { _cap = k + 1 ; arr = new int [_cap]; } bool insertFront (int value) if (isFull ()) { return false ; } arr[(start - 1 + _cap) % _cap] = value; start = (start - 1 + _cap) % _cap; return true ; } bool insertLast (int value) if (isFull ()) { return false ; } arr[end] = value; end = (end + 1 ) % _cap; return true ; } bool deleteFront () if (isEmpty ()) return false ; start = (start + 1 ) % _cap; return true ; } bool deleteLast () if (isEmpty ()) return false ; end = (end - 1 + _cap) % _cap; return true ; } int getFront () if (isEmpty ()) return -1 ; return arr[start]; } int getRear () if (isEmpty ()) return -1 ; return arr[(end - 1 + _cap) % _cap]; } bool isEmpty () return start == end; } bool isFull () return ((end + 1 ) % _cap) == start; } };
双指针是一个很宽泛的概念,就像数组、链表一样,其类型有很多。比如二分法经常用到左/右端点双指针,滑动窗口会用到快/慢指针和固定间距指针,因此双指针其实是一种综合性很强的类型,类似于数组、栈等,但是这里所讲述的双指针,往往指的是某几种类型的双指针,而不是只要有两个指针就是双指针
头/尾指针是指游标同时指向数组、字符串的第一个元素和最后一个元素,典型应用是求数组元素或子串是否满足特定条件。快/慢指针是指两个指针的移动速度不同(比如有的移动步长为2,有的移动步长为1),典型的应用是判断链表是否有环。
盛最多水的容器
给定一个长度为 n 的整数数组 height 。有 n 条垂线,第 i 条线的两个端点是 (i, 0) 和 (i, height[i]) 。找出其中的两条线,使得它们与 x 轴共同构成的容器可以容纳最多的水。返回容器可以储存的最大水量
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : int maxArea (vector<int >& height) int ans{}; int l = 0 , r = height.size () - 1 ; while (l < r) { int h = min (height[l], height[r]); ans = max (ans, (r-l) * h); if (height[l] < height[r]) { l++; } else { r--; } } return ans; } };
环形链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution {public : bool hasCycle (ListNode *head) ListNode* slow = head,*fast = head; while (fast && fast->next) { slow = slow->next; fast = fast->next->next; if (slow == fast) { return true ; } } return false ; } };
无重复字符的最长字串
给定一个字符串 s ,请你找出其中不含有重复字符的 最长 子串 的长度
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 class Solution {public : int lengthOfLongestSubstring (string s) vector<bool > chs (128 ) ; int left{}; int ans{}; for (int i = 0 ; i < s.size (); i++) { while (left<i && chs[s[i]]) { chs[s[left]] = false ; left++; } chs[s[i]] = true ; ans = max (ans, i - left + 1 ); } return ans; } };
双指针一般解决的是与字符串、数组、链表相关的问题,当题目中出现需要字符串的子串、数组的几个子元素、链表的多个节点时,都可以考虑一下能否用双指针的方法来解决。一旦确定可以使用双指针来解答问题,要注意是否可以通过边界条件提前退出检测、是否可以利用其他结构体(比如字典等)来优化解法
双指针问题首先要考虑使用的双指针类型是选择从两边开始的头/尾指针,还是选择从一边开始的快/慢指针。针对快/慢指针,在用于滑动窗口问题时,还可以考虑通过指针控制窗口的大小来优化算法
动态规划和其他算法思想如递归、回溯、分治和贪心等方法都有一定的联系。其背后的基本思想是枚举,虽然看起来简单,但如何涵盖所有的可能,并尽量减少重叠子问题的计算是一个难点。
解动态规划类问题,分析过程是有章可循的,通过对阶段、子问题和状态的拆解基本可以得到解决问题的框架 。具体的求解过程一般可以通过推导状态转移方程或填状态转移表这两种方法 来实现。
解决动态规划问题的核心在于找到状态转移方程和处理边界条件。这两者中更为困难的当然是状态转移方程了,看出了状态转移方程,解题就是水到渠成的事情了。对于某一道动态规划题目来说,状态转移方程可能不止一种,不同的状态转移方程对应不同的解法,而不同的转移方程的性能差别可能是巨大的
鸡蛋掉落问题
给你 k 枚相同的鸡蛋,并可以使用一栋从第 1 层到第 n 层共有 n 层楼的建筑。
已知存在楼层 f ,满足 0 <= f <= n ,任何从 高于 f 的楼层落下的鸡蛋都会碎,从 f 楼层或比它低的楼层落下的鸡蛋都不会破。每次操作,你可以取一枚没有碎的鸡蛋并把它从任一楼层 x 扔下(满足 1 <= x <= n)。如果鸡蛋碎了,你就不能再次使用它。如果某枚鸡蛋扔下后没有摔碎,则可以在之后的操作中 重复使用 这枚鸡蛋。请你计算并返回要确定 f 确切的值 的 最小操作次数 是多少?
可以转换思路 ,换一个视角来看:如果我们有 $k$ 个鸡蛋,允许扔 $m$ 次,我们最高能测出多少层楼?
设 $dp[m][k]$ 为:当有 $k$ 个鸡蛋 ,可以扔 $m$ 次 时,能确定的最大楼层数 。
当我们从某一层扔下一枚鸡蛋时,只有两种结果:
鸡蛋碎了 :我们损失了一个鸡蛋(剩下 $k-1$ 个)。 我们损失了一次机会(剩下 $m-1$ 次)。 我们能向下确定的楼层数是 $dp[m-1][k-1]$。 鸡蛋没碎 :鸡蛋数量不变(剩下 $k$ 个)。 我们损失了一次机会(剩下 $m-1$ 次)。 我们能向上确定的楼层数是 $dp[m-1][k]$。 再加上当前扔鸡蛋的那一层 (1 层),总共能确定的楼层数为:
初始化一个二维数组(或者优化为一维)。 不断增加投掷次数 $m$,直到 $dp[m][k] \ge n$。 此时的 $m$ 就是我们要找的最小操作次数 。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 class Solution {public : int superEggDrop (int k, int n) if (n == 1 ) { return 1 ; } vector<vector<int >> dp (n + 1 , vector <int >(k + 1 )); for (int i = 1 ; i <= k; i++) { dp[1 ][i] = 1 ; } int ans{}; for (int i = 2 ; i <= n; i++) { for (int j = 1 ; j <= k; j++) { dp[i][j] = dp[i - 1 ][j] + dp[i - 1 ][j - 1 ] + 1 ; } if (dp[i][k] >= n) { ans = i; break ; } } return ans; } };
打家劫舍系列
如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警 。给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。
如果房屋数量大于两间,应该如何计算能够偷窃到的最高总金额呢?对于第 k (k>2) 间房屋,有两个选项:
偷窃第 k 间房屋,那么就不能偷窃第 k−1 间房屋,偷窃总金额为前 k−2 间房屋的最高总金额与第 k 间房屋的金额之和。
不偷窃第 k 间房屋,偷窃总金额为前 k−1 间房屋的最高总金额。
在两个选项中选择偷窃总金额较大的选项,该选项对应的偷窃总金额即为前 k 间房屋能偷窃到的最高总金额。
从状态转移方程可以知道状态f(n)只依赖状态f(n-1)和状态f(n-2),因此,额外的n大小的辅助空间是不需要的,只需要两个额外的变量来表示两个依赖状态即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int rob (vector<int >& nums) int sz = nums.size (); if (sz == 1 ) { return nums[0 ]; } vector<int > dp (sz) ; dp[0 ] = nums[0 ]; dp[1 ] = max (nums[0 ],nums[1 ]); for (int i = 2 ;i<sz;i++) { dp[i] = max (dp[i-2 ]+nums[i],dp[i-1 ]); } return dp[sz-1 ]; } }; class Solution {public : int rob (vector<int >& nums) int sz = nums.size (); if (sz == 1 ) { return nums[0 ]; } int prev = 0 , cur = 0 ; for (int i = 0 ; i < sz; i++) { int tmp = cur; cur = max (cur, nums[i] + prev); prev = tmp; } return cur; } };
这个地方所有的房屋都 围成一圈 ,这意味着第一个房屋和最后一个房屋是紧挨着的。同时,相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警 。给定一个代表每个房屋存放金额的非负整数数组,计算你 在不触动警报装置的情况下 ,今晚能够偷窃到的最高金额。
首尾的房屋是相连的,也就是说:如果偷了开头的房屋,那么结尾的房屋不能偷;如果偷了结尾的房屋,那么开头的房屋不能偷。范围[0,n-1)的解和范围[1,n-1]的解中的较大值即为解,这里n是数组的长度。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution {public : int robRange (vector<int >& nums, int start, int end) int first = nums[start], second = max (nums[start], nums[start + 1 ]); for (int i = start + 2 ; i <= end; i++) { int temp = second; second = max (first + nums[i], second); first = temp; } return second; } int rob (vector<int >& nums) int length = nums.size (); if (length == 1 ) { return nums[0 ]; } else if (length == 2 ) { return max (nums[0 ], nums[1 ]); } return max (robRange (nums, 0 , length - 2 ), robRange (nums, 1 , length - 1 )); } };
小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为 root 。
除了 root 之外,每栋房子有且只有一个“父“房子与之相连。一番侦察之后,聪明的小偷意识到“这个地方的所有房屋的排列类似于一棵二叉树”。 如果 两个直接相连的房子在同一天晚上被打劫 ,房屋将自动报警。
给定二叉树的 root 。返回 *在不触动警报的情况下 ,小偷能够盗取的最高金额* 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : pair<int ,int > dfs (TreeNode* node) { if (!node) { return {0 ,0 }; } auto [l1,l2] = dfs (node->left); auto [r1,r2] = dfs (node->right); int f1 = node->val + l2+r2; int f2 = max (l1,l2)+max (r1,r2); return {f1,f2}; } int rob (TreeNode* root) if (!root) { return 0 ; } auto [x1,x2] = dfs (root); return max (x1,x2); } };
不同路径
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : int uniquePaths (int m, int n) vector<int > dp (n,1 ) ; for (int i =1 ;i<m;i++) { for (int j =1 ;j<n;j++) { dp[j] += dp[j-1 ]; } } return dp[n-1 ]; } };
给定一个 m x n 的整数数组 grid。一个机器人初始位于 左上角 (即 grid[0][0])。机器人尝试移动到 右下角 (即 grid[m - 1][n - 1])。机器人每次只能向下或者向右移动一步。
网格中的障碍物和空位置分别用 1 和 0 来表示。机器人的移动路径中不能包含 任何 有障碍物的方格。
返回机器人能够到达右下角的不同路径数量。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : int uniquePathsWithObstacles (vector<vector<int >>& obstacleGrid) int m = obstacleGrid.size (); int n = obstacleGrid[0 ].size (); vector<vector<int >> dp (m, vector <int >(n)); for (int j = 0 ; j < n; j++) { if (obstacleGrid[0 ][j] == 0 ) { dp[0 ][j] = 1 ; } else { break ; } } for (int i = 0 ; i < m; i++) { if (obstacleGrid[i][0 ] == 0 ) { dp[i][0 ] = 1 ; } else { break ; } } for (int i = 1 ; i < m; i++) { for (int j = 1 ; j < n; j++) { if (obstacleGrid[i][j] == 1 ) { continue ; } dp[i][j] = dp[i - 1 ][j] + dp[i][j - 1 ]; } } return dp[m - 1 ][n - 1 ]; } };
零钱系列
给你一个整数数组 coins ,表示不同面额的硬币;以及一个整数 amount ,表示总金额。
计算并返回可以凑成总金额所需的 最少的硬币个数 。如果没有任何一种硬币组合能组成总金额,返回 -1 。
你可以认为每种硬币的数量是无限的。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : int coinChange (vector<int >& coins, int amount) vector<int > dp (amount + 1 , INT_MAX) ; dp[0 ] = 0 ; for (int i = 1 ; i <= amount; i++) { for (auto & coin : coins) { if (coin > i || dp[i - coin] == INT_MAX) { continue ; } dp[i] = min (dp[i - coin] + 1 ,dp[i]); } } return (dp[amount] == INT_MAX) ? -1 : dp[amount]; } };
给你一个整数数组 coins 表示不同面额的硬币,另给一个整数 amount 表示总金额。
请你计算并返回可以凑成总金额的硬币组合数。如果任何硬币组合都无法凑出总金额,返回 0 。
假设每一种面额的硬币有无限个。 题目数据保证结果符合 32 位带符号整数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 class Solution {public : int change (int amount, vector<int >& coins) int n = coins.size (); vector<int > dp (amount + 1 ) ; dp[0 ] = 1 ; for (int i = 0 ; i < n; ++i) { for (int j = 1 ; j <= amount; j++) { if (j >= coins[i] && dp[j]<INT_MAX-dp[j-coins[i]]) { dp[j] += dp[j - coins[i]]; } } } return dp[amount]; } }; class Solution {public : int change (int amount, vector<int >& coins) int n = coins.size (); vector<vector<int >> memo (n, vector <int >(amount + 1 , -1 )); return dfs (0 , amount, coins, memo); } private : int dfs (int index, int target, vector<int >& coins, vector<vector<int >>& memo) if (target == 0 ) return 1 ; if (index == coins.size () || target < 0 ) return 0 ; if (memo[index][target] != -1 ) return memo[index][target]; int res = dfs (index, target - coins[index], coins, memo) + dfs (index + 1 , target, coins, memo); return memo[index][target] = res; } };
解动态规划类问题,分析过程是有章可循的,通过对阶段、子问题和状态的拆解基本可以得到解决问题的框架 。具体的求解过程一般可以通过推导状态转移方程或填状态转移表这两种方法来实现。
动态规划问题通常伴随着滚动数组的技巧,从而在空间上达到更优,这正是其相对于记忆化递归而言最大的优点,还有一个好处是动态规划避免了递归产生的额外调用栈的性能开销。
递归调用子问题时会出现很多重复的子问题计算。一个显而易见的想法是将已经计算过的子问题结果保存起来以备后面使用。如此处理之后,在下一次遇到同样的子问题时直接返回结果可以大大地降低计算的时间复杂度。这种解题思路被称为带“记忆”的递归调用(也被称为自顶向下的动态规划)。
动态规划-可重复装背包问题-排列数和组合数理解 2025.3.17完全背包问题中,求组合数是外层遍历物品,内层遍历背包容 - 掘金
动态规划:01背包理论基础 | 代码随想录
背包问题总结【0-1背包、完全背包、排列组合问题】_背包问题 排列 组合-CSDN博客
1 背包问题
场景 :有 $N$ 件物品和一个容量为 $W$ 的背包。每件物品仅有一件 ,只有“装(1)”或“不装(0)”两种选择。核心矛盾 :在容量有限的情况下,如何抉择才能让价值最大。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 #include <bits/stdc++.h> using namespace std;int main () int n, bagweight; cin >> n >> bagweight; vector<int > weight (n, 0 ) ; vector<int > value (n, 0 ) ; for (int i = 0 ; i < n; ++i) { cin >> weight[i]; } for (int j = 0 ; j < n; ++j) { cin >> value[j]; } vector<vector<int >> dp (weight.size (), vector <int >(bagweight + 1 , 0 )); for (int j = weight[0 ]; j <= bagweight; j++) { dp[0 ][j] = value[0 ]; } for (int i = 1 ; i < weight.size (); i++) { for (int j = 0 ; j <= bagweight; j++) { if (j < weight[i]) dp[i][j] = dp[i - 1 ][j]; else { dp[i][j] = max (dp[i - 1 ][j], dp[i - 1 ][j - weight[i]] + value[i]); } } } cout << dp[n - 1 ][bagweight] << endl; return 0 ; }
倒序遍历是为了保证物品i只被放入一次 。如果一旦正序遍历了,那么物品0就会被重复加入多次
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 #include <iostream> #include <vector> using namespace std;int main () int M, N; cin >> M >> N; vector<int > costs (M) ; vector<int > values (M) ; for (int i = 0 ; i < M; i++) { cin >> costs[i]; } for (int j = 0 ; j < M; j++) { cin >> values[j]; } vector<int > dp (N + 1 , 0 ) ; for (int i = 0 ; i < M; ++i) { for (int j = N; j >= costs[i]; --j) { dp[j] = max (dp[j], dp[j - costs[i]] + values[i]); } } cout << dp[N] << endl; return 0 ; }
完全背包
场景 :基本背景相同,但每种物品都有无限件 。只要背包装得下,你可以一直拿同一种物品。核心矛盾 :不再是“拿不拿”,而是“拿几个1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 #include <iostream> #include <vector> using namespace std;int main () int n, bagWeight; int w, v; cin >> n >> bagWeight; vector<int > weight (n) ; vector<int > value (n) ; for (int i = 0 ; i < n; i++) { cin >> weight[i] >> value[i]; } vector<vector<int >> dp (n, vector <int >(bagWeight + 1 , 0 )); for (int j = weight[0 ]; j <= bagWeight; j++) dp[0 ][j] = dp[0 ][j - weight[0 ]] + value[0 ]; for (int i = 1 ; i < n; i++) { for (int j = 0 ; j <= bagWeight; j++) { if (j < weight[i]) dp[i][j] = dp[i - 1 ][j]; else dp[i][j] = max (dp[i - 1 ][j], dp[i][j - weight[i]] + value[i]); } } cout << dp[n - 1 ][bagWeight] << endl; return 0 ; }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 #include <iostream> #include <vector> using namespace std;int main () int N, bagWeight; cin >> N >> bagWeight; vector<int > weight (N, 0 ) ; vector<int > value (N, 0 ) ; for (int i = 0 ; i < N; i++) { int w; int v; cin >> w >> v; weight[i] = w; value[i] = v; } vector<int > dp (bagWeight + 1 , 0 ) ; for (int j = 0 ; j <= bagWeight; j++) { for (int i = 0 ; i < weight.size (); i++) { if (j - weight[i] >= 0 ) dp[j] = max (dp[j], dp[j - weight[i]] + value[i]); } } cout << dp[bagWeight] << endl; return 0 ; }
为什么需要滚动数组?
在二维状态 $dp[i][j]$ 中,计算第 $i$ 行只依赖于第 $i-1$ 行。因此我们可以只用一个一维数组 $dp[j]$,通过不断“覆盖”旧值来节省空间
对于纯完全背包问题,其for循环的先后循环是可以颠倒的
求组合数 (Combinations) —— 顺序无关
场景 :硬币 {1, 2} 和 {2, 1} 算同一种。秘籍 :外层遍历物品,内层遍历容量 。逻辑 :先算完只用硬币 1 的方案,再往里加硬币 2。这保证了硬币 2 只会出现在硬币 1 之后。
求排列数 (Permutations) —— 顺序有关
场景 :硬币 {1, 2} 和 {2, 1} 算两种(比如爬楼梯,先走 1 阶再走 2 阶不同于先 2 后 1)。
秘籍 :外层遍历容量,内层遍历物品 。逻辑 :对于每一个容量 $j$,我们都重新尝试所有的硬币。这样在凑出 3 的时候,既可以从 $dp[3-1]$ 转移(最后一步是 1),也可以从 $dp[3-2]$ 转移(最后一步是 2)。物理层:解决“选几次” (01 vs 完全) 这主要体现在内层循环的遍历方向 上。
逆序遍历:解决“01 背包”
场景 :每个物品只能选 1 次。逻辑 :我们需要用“上一行(即不包含当前物品)”的数据。原因 :因为是从大到小更新,当我们更新 $dp[j]$ 时,$dp[j - weight]$ 还是旧的值,还没有被当前物品污染过。正序遍历:解决“完全背包”
场景 :每个物品可以选无限次。逻辑 :我们需要用“当前行(即已经考虑过放入当前物品)”的数据。原因 :从小到大更新,更新 $dp[j]$ 时,$dp[j - weight]$ 可能已经在本轮循环中放入过当前物品了,现在是在它的基础上“再多拿一个”。逻辑层:解决“怎么排” (组合 vs 排列) 这主要体现在内、外层循环谁包着谁 。
外层物品,内层容量 $\rightarrow$ 组合 (Combination)
适用问题 :{1, 5} 和 {5, 1} 算同一种方案。
代表题 :LeetCode 518. 零钱兑换 II。
底层原理 :
我们是挨个处理物品的。处理完 1 号硬币,再处理 2 号。这就意味着,在任何一个状态下,硬币的编号只能是递增的。你不可能在放入 2 号硬币后的某个状态里,又跑回去拿 1 号硬币。
结论 :这种顺序强制去掉了“乱序”的可能性,只留下唯一的一种组合。
外层容量,内层物品 $\rightarrow$ 排列 (Permutation)
适用问题 :{1, 5} 和 {5, 1} 算两种不同的方案。
代表题 :LeetCode 377. 组合总和 Ⅳ(虽然叫组合总和,其实求的是排列)。
底层原理 :
对于每一个容量 $j$,我们都把所有物品拿出来试一遍。
比如容量为 6:
结论 :这种顺序允许同一个容量被不同的“最后一步”推导出来,从而计入所有排列。
极值问题:对顺序“迟钝”
适用问题 :求“最少硬币数”或“最大价值”。代表题 :LeetCode 322. 零钱兑换(求最少硬币数)。现象 :你会发现,求最少硬币数时,外层是物品还是容量,代码都能过。原因 :极值问题($\min / \max$)只关心最终结果 ,不关心你是通过 {1, 5} 还是 {5, 1} 凑出来的。反正它们凑出来的硬币数都是 2,取 $\min$ 的结果是一样的。当你看到一道背包题,请按以下步骤决定你的 for 循环:
步骤 提问 决定 1. 看次数 物品只能用一次吗? 是 :内层逆序;否 :内层正序。2. 看性质 是求最大价值吗? 是 :外层物品/容量皆可,通常选外层物品(逻辑更顺)。3. 看顺序 是求方案数且 {1,2} != {2,1} 吗? 是 :外层容量,内层物品。4. 看顺序 是求方案数且 {1,2} == {2,1} 吗? 是 :外层物品,内层容量。
单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。注意: 不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
定义 dp [i ] 表示字符串 s 前 i 个字符组成的字符串 s [0..i −1] 是否能被空格拆分成若干个字典中出现的单词。
dp [i ]=dp [j ] && check (s [j ..i −1])
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 class Solution {public : bool wordBreak (string s, vector<string>& wordDict) int sz = s.size (); vector<bool > dp (sz + 1 ) ; dp[0 ] = true ; unordered_set<string> wordSet (wordDict.begin(),wordDict.end()) ; for (int i = 1 ;i<=sz;i++) { for (int j = 0 ;j<i;j++) { string word = s.substr (j,i-j); if (wordSet.count (word)) { dp[i] = dp[i] || dp[j]; } } } return dp[sz]; } };
给定一个字符串 s 和一个字符串字典 wordDict ,在字符串 s 中增加空格来构建一个句子,使得句子中所有的单词都在词典中。以任意顺序 返回所有这些可能的句子。注意: 词典中的同一个单词可能在分段中被重复使用多次。
对于字符串 s,如果某个前缀是单词列表中的单词,则拆分出该单词,然后对 s 的剩余部分继续拆分。如果可以将整个字符串 s 拆分成单词列表中的单词,则得到一个句子。在对 s 的剩余部分拆分得到一个句子之后,将拆分出的第一个单词(即 s 的前缀)添加到句子的头部,即可得到一个完整的句子。上述过程可以通过回溯实现。
假设字符串 s 的长度为 n,回溯的时间复杂度在最坏情况下高达 O(n )。时间复杂度高的原因是存在大量重复计算,可以通过记忆化的方式降低时间复杂度。
具体做法是,使用哈希表存储字符串 s 的每个下标和从该下标开始的部分可以组成的句子列表,在回溯过程中如果遇到已经访问过的下标,则可以直接从哈希表得到结果,而不需要重复计算。如果到某个下标发现无法匹配,则哈希表中该下标对应的是空列表,因此可以对不能拆分的情况进行剪枝优化。
还有一个可优化之处为使用哈希集合存储单词列表中的单词,这样在判断一个字符串是否是单词列表中的单词时只需要判断该字符串是否在哈希集合中即可,而不再需要遍历单词列表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : unordered_map<int , vector<string>> memo; vector<string> dfs (string& s, int index, unordered_set<string>& wordSet) { if (index == s.size ()) { return {"" }; } if (memo.count (index)) { return memo[index]; } vector<string> res; for (int j = index; j < s.size (); j++) { string str = s.substr (index, j - index + 1 ); if (wordSet.count (str)) { auto ans = dfs (s, j + 1 , wordSet); for (auto & sstr : ans) { if (sstr == "" ) { res.push_back (str); } else { res.push_back (str + " " + sstr); } } } } memo[index] = res; return res; } vector<string> wordBreak (string s, vector<string>& wordDict) { unordered_set<string> wordSet (wordDict.begin(), wordDict.end()) ; return dfs (s, 0 , wordSet); } };
股票系列
给定一个数组 prices ,它的第 i 个元素 prices[i] 表示一支给定股票第 i 天的价格。
你只能选择 某一天 买入这只股票,并选择在 未来的某一个不同的日子 卖出该股票。设计一个算法来计算你所能获取的最大利润。返回你可以从这笔交易中获取的最大利润。如果你不能获取任何利润,返回 0 。
1 2 3 4 5 6 7 8 9 10 11 12 13 class Solution {public : int maxProfit (vector<int >& prices) int min_price{INT_MAX}; int ans{}; for (int i = 0 ;i<prices.size ();i++) { min_price = min (min_price,prices[i]); ans = max (prices[i] - min_price,ans); } return ans; } };
每次遍历,相对于比较当前价格与其前边的每个价格来寻找最大差值max_diff,我们只需要对比前面出现过的那个最小值即可。定义并使用变量min_price来保存遇到的最小价格,将循环内操作的时间复杂度降低至常数阶,算法的总体时间复杂度也就降至为O(n)。
一个整数数组 prices ,其中 prices[i] 表示某支股票第 i 天的价格。在每一天,你可以决定是否购买和/或出售股票。你在任何时候 最多 只能持有 一股 股票。然而,你可以在 同一天 多次买卖该股票,但要确保你持有的股票不超过一股。返回 你能获得的 最大 利润 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : int maxProfit (vector<int >& prices) int sz = prices.size (); vector<vector<int >> dp (sz, vector <int >(2 )); dp[0 ][1 ] = -prices[0 ]; for (int i = 1 ; i < sz; i++) { dp[i][0 ] = max (dp[i - 1 ][0 ], prices[i] + dp[i - 1 ][1 ]); dp[i][1 ] = max (dp[i - 1 ][1 ], -prices[i] + dp[i - 1 ][0 ]); } return dp[sz - 1 ][0 ]; } };
注意到上面的状态转移方程中,每一天的状态只与前一天的状态有关,而与更早的状态都无关,因此我们不必存储这些无关的状态,只需要将 dp[i−1][0] 和 dp[i−1][1] 存放在两个变量中,通过它们计算出 dp[i][0] 和 dp[i][1] 并存回对应的变量,以便于第 i+1 天的状态转移即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : int maxProfit (vector<int >& prices) int sz = prices.size (); vector<vector<int >> dp (sz, vector <int >(2 )); int soldPrice{}; int buyPrice = -prices[0 ]; for (int i = 1 ; i < sz; i++) { int tmp = soldPrice; soldPrice = max (soldPrice,buyPrice+prices[i]); buyPrice = max (buyPrice,-prices[i]+tmp); } return soldPrice; } };
给定一个整数数组 prices,其中 prices[i]表示第 i 天的股票价格 ;整数 fee 代表了交易股票的手续费用。
你可以无限次地完成交易,但是你每笔交易都需要付手续费。如果你已经购买了一个股票,在卖出它之前你就不能再继续购买股票了。返回获得利润的最大值。
注意: 这里的一笔交易指买入持有并卖出股票的整个过程,每笔交易你只需要为支付一次手续费。
考虑 dp[i][0] 的转移方程,如果这一天交易完后手里没有股票,那么可能的转移状态为前一天已经没有股票,即 dp[i−1][0],或者前一天结束的时候手里持有一支股票,即 dp[i−1][1],这时候我们要将其卖出,并获得 prices[i] 的收益,但需要支付 fee 的手续费。因此为了收益最大化,我们列出如下的转移方程:
dp[i][0]=max{dp[i−1][0],dp[i−1][1]+prices[i]−fee}
dp[i][1]=max{dp[i−1][1],dp[i−1][0]−prices[i]}
因此,我们只要从前往后依次计算状态即可。由于全部交易结束后,持有股票的收益一定低于不持有股票的收益,因此这时候 dp[n−1][0] 的收益必然是大于 dp[n−1][1] 的,最后的答案即为 dp[n−1][0]。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int maxProfit (vector<int >& prices, int fee) int n = prices.size (); vector<vector<int >> dp (n, vector <int >(2 )); dp[0 ][0 ] = 0 , dp[0 ][1 ] = -prices[0 ]; for (int i = 1 ; i < n; ++i) { dp[i][0 ] = max (dp[i - 1 ][0 ], dp[i - 1 ][1 ] + prices[i] - fee); dp[i][1 ] = max (dp[i - 1 ][1 ], dp[i - 1 ][0 ] - prices[i]); } return dp[n - 1 ][0 ]; } }; class Solution {public : int maxProfit (vector<int >& prices, int fee) int sz = prices.size (); int soldPrice{}; int buyPrice = -prices[0 ]; for (int i =1 ;i<prices.size ();i++) { int newSoldPrice = max (soldPrice,buyPrice-fee+prices[i]); int newBuyPrice = max (buyPrice,soldPrice-prices[i]); soldPrice = newSoldPrice; buyPrice = newBuyPrice; } return soldPrice; } };
给定一个整数数组prices,其中第 prices[i] 表示第 *i* 天的股票价格 。
设计一个算法计算出最大利润。在满足以下约束条件下,你可以尽可能地完成更多的交易(多次买卖一支股票):卖出股票后,你无法在第二天买入股票 (即冷冻期为 1 天)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 class Solution {public : int maxProfit (vector<int >& prices) int sz= prices.size (); int dp0{},dp1{},dp2{}; dp0 = -prices[0 ]; for (int i = 1 ;i<sz;i++) { int newDp0 = max (dp0,dp2-prices[i]); int newDp1 = max (dp1,dp0+prices[i]); int newDp2 = dp1; dp0 = newDp0; dp1 = newDp1; dp2 = newDp2; } return max (dp1,dp2); } };
给你一个整数数组 prices 和一个整数 k ,其中 prices[i] 是某支给定的股票在第 i 天的价格。
设计一个算法来计算你所能获取的最大利润。你最多可以完成 k 笔交易。也就是说,你最多可以买 k 次,卖 k 次。注意: 你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : int maxProfit (int k, vector<int >& prices) if (prices.empty ()) { return 0 ; } int n = prices.size (); k = min (k, n / 2 ); vector<vector<int >> buy (n, vector <int >(k + 1 , -1e9 )); vector<vector<int >> sell (n, vector <int >(k + 1 , -1e9 )); if (k >= 1 ) { buy[0 ][1 ] = -prices[0 ]; } sell[0 ][0 ] = 0 ; for (int i = 1 ; i < n; ++i) { sell[i][0 ] = 0 ; for (int j = 1 ; j <= k; ++j) { buy[i][j] = max (buy[i - 1 ][j], sell[i - 1 ][j - 1 ] - prices[i]); sell[i][j] = max (sell[i - 1 ][j], buy[i - 1 ][j] + prices[i]); } } return *max_element (sell[n - 1 ].begin (), sell[n - 1 ].end ()); } };
每一笔交易都包含“买入”和“卖出”两个动作。对于最多 $k$ 次交易,我们在每一天可能处于以下 $2k$ 种状态之一:
buy[j]sell[j]这里 $j$ 的取值范围是 $1$ 到 $k$。
对于每一天的价格 price,我们要更新这 $2k$ 个状态:
第 $j$ 次持有 (buy[j]) :
保持现状:昨天就持有第 $j$ 次的股票。 今天买入:由上一次交易完成 的状态 sell[j-1] 减去今天的价格。 公式:buy[j] = max(buy[j], sell[j-1] - price) 第 $j$ 次卖出 (sell[j]) :
保持现状:昨天就已经完成了第 $j$ 次交易。 今天卖出:由本次持有 的状态 buy[j] 加上今天的价格。 公式:sell[j] = max(sell[j], buy[j] + price) 核心思维是一致的:用状态记录你的“处境”,用转移方程描述“动作”。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 class Solution {public : int maxProfit (int k, vector<int >& prices) int sz = prices.size () ; k = min (k, sz/2 ); vector<int > buy (k + 1 , INT_MIN) ; vector<int > sell (k + 1 ) ; for (int i = 0 ; i < sz; i++) { for (int j = 1 ; j <= k; j++) { buy[j] = max (sell[j - 1 ] - prices[i], buy[j]); sell[j] = max (prices[i] + buy[j], sell[j]); } } return sell[k]; } };
给定一个数组,它的第 i 个元素是一支给定的股票在第 i 天的价格。设计一个算法来计算你所能获取的最大利润。你最多可以完成 两笔 交易。注意: 你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : int maxProfit (vector<int >& prices) int n = prices.size (); int buy1 = -prices[0 ], sell1 = 0 ; int buy2 = -prices[0 ], sell2 = 0 ; for (int i = 1 ; i < n; ++i) { buy1 = max (buy1, -prices[i]); sell1 = max (sell1, buy1 + prices[i]); buy2 = max (buy2, sell1 - prices[i]); sell2 = max (sell2, buy2 + prices[i]); } return sell2; } }; class Solution {public : int maxProfit (vector<int >& prices) vector<int > buy (3 , INT_MIN) ; vector<int > sell (3 ) ; for (int i = 0 ; i < prices.size (); i++) { for (int j = 1 ; j <= 2 ; j++) { buy[j] = max (buy[j], -prices[i] + sell[j - 1 ]); sell[j] = max (sell[j], prices[i] + buy[j]); } } return sell[2 ]; } };
给你两个下标从 0 开始的数组 present 和 future ,present[i] 和 future[i] 分别代表第 i 支股票现在和将来的价格。每支股票你最多购买 一次 ,你的预算为 budget 。求最大的收益。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : int maximumProfit (vector<int >& present, vector<int >& future, int budget) vector<int > dp (budget+1 ) ; int sz = present.size (); vector<int > value (sz) ; for (int i =0 ;i<sz;i++) { value[i] = future[i] - present[i]; } for (int i = 0 ;i<sz;i++) { for (int j = budget;j>=0 ;j--) { if (j>=present[i]) { dp[j] = max (dp[j],dp[j-present[i]]+value[i]); } } } return dp[budget]; } };
当股票收益最大时,应购买哪些股票?如果有多种方案,返回其中任意一种。
要找出具体的股票清单(路径回溯),我们不能直接使用状态压缩后的一维数组,因为一维数组丢弃了“这个最优值是从哪个物品转移过来”的信息。我们需要使用 二维数组 dp[i][j] 。
从最后一支股票 $n$ 和总预算 budget 开始。
如果 $dp[i][j] == dp[i-1][j]$,说明第 $i$ 支股票没买 ,继续检查 $dp[i-1][j]$。
如果 $dp[i][j] \neq dp[i-1][j]$,说明第 $i$ 支股票买了 ,记录下标 $i$,然后剩余预算变为 $j - \text{present}[i]$,继续检查 $dp[i-1][j - \text{present}[i]]$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Solution {public : pair<int , vector<int >> getStocks (vector<int >& present, vector<int >& future, int budget) { int n = present.size (); vector<vector<int >> dp (n + 1 , vector <int >(budget + 1 , 0 )); for (int i = 1 ; i <= n; ++i) { int cost = present[i-1 ]; int profit = max (0 , future[i-1 ] - present[i-1 ]); for (int j = 0 ; j <= budget; ++j) { if (j >= cost) { dp[i][j] = max (dp[i-1 ][j], dp[i-1 ][j - cost] + profit); } else { dp[i][j] = dp[i-1 ][j]; } } } vector<int > selectedStocks; int curBudget = budget; for (int i = n; i >= 1 ; --i) { if (dp[i][curBudget] > dp[i-1 ][curBudget]) { selectedStocks.push_back (i - 1 ); curBudget -= present[i-1 ]; } } return {dp[n][budget], selectedStocks}; } };
滑动窗口是双指针的特殊应用,该题型本身并不复杂,但有些具体细节需要注意。滑动窗口常用于解决数组、字符串的子元素问题,它可以将嵌套的循环展开,通过减少内层循环次数来降低算法的时间复杂度。滑动窗口类题目通常需要用到双指针,还可能用到其他的数据结构,比如哈希表、队列。
按照滑动窗口的窗口大小是否固定,以及可变窗口中求最大窗口还是最小窗口,可以分类如下。
● 固定窗口类型
● 可变窗口类型。此类题目不会给出窗口大小,而是求符合条件的最大窗口或最小窗口。
➢ 求最大窗口。例如第424题。
➢ 求最小窗口。例如第72题。
通常会使用双指针来界定窗口的边界,两个指针之间的部分属于窗口内,反之属于窗口外。固定窗口类型的题目,两个指针要同时移动;而可变窗口类型的题目,则移动其中一个指针来实现窗口大小的变化。
滑动窗口类型的题目是有“套路”可循的,用两个指针分别表示窗口的左右端点,然后右指针不断地去扩充右侧窗口边界,左指针不断地缩小左边窗口边界,同时维护窗口的信息,在这个过程中不断判断窗口信息是否满足条件,如果是,则更新答案;如果不是,则继续移动窗口(收缩、扩展或平移)。
滑动窗口最大值
给你一个整数数组 nums,有一个大小为 k 的滑动窗口从数组的最左侧移动到数组的最右侧。你只可以看到在滑动窗口内的 k 个数字。滑动窗口每次只向右移动一位。
返回 滑动窗口中的最大值
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : vector<int > maxSlidingWindow (vector<int >& nums, int k) { vector<int > res; list<int > lst; int sz = nums.size (); for (int i = 0 ;i<k;i++) { while (!lst.empty () && nums[i]>lst.back ()) { lst.pop_back (); } lst.push_back (nums[i]); } res.push_back (lst.front ()); for (int i = k;i<sz;i++) { while (!lst.empty () && nums[i]>lst.back ()) { lst.pop_back (); } lst.push_back (nums[i]); if (nums[i-k] == lst.front ()) { lst.pop_front (); } res.push_back (lst.front ()); } return res; } };
最小覆盖子串
给定两个字符串 s 和 t,长度分别是 m 和 n,返回 s 中的 最短窗口 子串 ,使得该子串包含 t 中的每一个字符(包括重复字符 )。如果没有这样的子串,返回空字符串 ""。
测试用例保证答案唯一。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 class Solution {public : string minWindow (string s, string t) { unordered_map<char , int > cnts; int targetCnt{}; for (auto & ch : t) { cnts[ch]++; targetCnt++; } int slen{INT_MAX}; int start_pos{}; int totalCnt{}; int left{}; for (int i = 0 ; i < s.size (); i++) { if (cnts.count (s[i])) { if (cnts[s[i]] >= 1 ) { totalCnt++; } cnts[s[i]]--; while (left <= i && totalCnt == targetCnt) { int len = i - left + 1 ; if (len < slen) { start_pos = left; slen = len; } if (cnts.count (s[left])) { if (cnts[s[left]] >= 0 ) { totalCnt--; } cnts[s[left]]++; } left++; } } } return INT_MAX == slen ? "" : s.substr (start_pos, slen); } };
替换后的最长重复字符
你一个字符串 s 和一个整数 k 。你可以选择字符串中的任一字符,并将其更改为任何其他大写英文字符。该操作最多可执行 k 次。在执行上述操作后,返回 包含相同字母的最长子字符串的长度
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : int characterReplacement (string s, int k) unordered_map<char , int > cnts; int ans{}; int left{}; int max_cnt{}; for (int i = 0 ; i < s.size (); i++) { cnts[s[i]]++; max_cnt = max (max_cnt, cnts[s[i]]); while (left<=i && i-left+1 >max_cnt+k) { cnts[s[left]]--; left++; } ans = max (ans,i-left+1 ); } return ans; } };
字符串的排列
给你两个字符串 s1 和 s2 ,写一个函数来判断 s2 是否包含 s1 的 排列。如果是,返回 true ;否则,返回 false 。换句话说,s1 的排列之一是 s2 的 子串
此问题的关键点是,如果能在S2中找到一个子串的长度与S1相等,并且S1中每个字符对应的个数与S2中这个子串的每个字符对应的个数相等,那S2就一定包含S1的一个排列。因此可以使用与S1等长的滑动窗口,判断S2在这个窗口内的字符出现个数和S1的字符出现个数是否相等。又因为题目中给出了条件,所有的字符都是小写字母,因此可以通过哈希表来统计每个字符出现的个数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : bool checkInclusion (string s1, string s2) int sz = s1. size (); if (sz>s2. size ()) { return false ; } vector<int > cnts (26 ) ; for (auto & ch : s1) { cnts[ch - 'a' ]++; } vector<int > targets (26 ) ; for (int i = 0 ; i < s1. size (); i++) { targets[s2[i] - 'a' ]++; } if (targets == cnts) { return true ; } for (int i = sz; i < s2. size (); i++) { targets[s2[i] - 'a' ]++; targets[s2[i - sz] - 'a' ]--; if (targets == cnts) { return true ; } } return false ; } };
滑动窗口大多用于解决数组、字符串、链表的子区间题型,如果题目中出现求解子数组、子串,或者寻找符合某个特征的子数组、子串问题,就可以考虑使用滑动窗口的方法。滑动窗口问题的优化思路主要包括:是否可以通过某个条件来缩减检测的子序列个数;是否可以通过使用特定的数据结构(如字典)来降低检测子序列的某个特征是否符合条件的复杂度。其中,缩减子序列的方法包括改变序列的大小、边界的提前退出等。
石子游戏
lice 和 Bob 用几堆石子在做游戏。一共有偶数堆石子,排成一行 ;每堆都有 正 整数颗石子,数目为 piles[i] 。游戏以谁手中的石子最多来决出胜负。石子的 总数 是 奇数 ,所以没有平局。
Alice 和 Bob 轮流进行,Alice 先开始 。 每回合,玩家从行的 开始 或 结束 处取走整堆石头。 这种情况一直持续到没有更多的石子堆为止,此时手中 石子最多 的玩家 获胜 。
假设 Alice 和 Bob 都发挥出最佳水平,当 Alice 赢得比赛时返回 true ,当 Bob 赢得比赛时返回 false
预测赢家
给你一个整数数组 nums 。玩家 1 和玩家 2 基于这个数组设计了一个游戏。
玩家 1 和玩家 2 轮流进行自己的回合,玩家 1 先手。开始时,两个玩家的初始分值都是 0 。每一回合,玩家从数组的任意一端取一个数字(即,nums[0] 或 nums[nums.length - 1]),取到的数字将会从数组中移除(数组长度减 1 )。玩家选中的数字将会加到他的得分上。当数组中没有剩余数字可取时,游戏结束。
如果玩家 1 能成为赢家,返回 true 。如果两个玩家得分相等,同样认为玩家 1 是游戏的赢家,也返回 true 。你可以假设每个玩家的玩法都会使他的分数最大化。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : bool predictTheWinner (vector<int >& nums) int n = nums.size (); vector<vector<int >> dp (n,vector <int >(n)); for (int i = n-2 ;i>=0 ;i--) { for (int j = i;j<n;j++) { if (j == i) { dp[i][j] = nums[i]; }else { dp[i][j] = max (nums[i] - dp[i+1 ][j],nums[j] - dp[i][j-1 ]); } } } return dp[0 ][n-1 ]>=0 ; } };
猜数字游戏
我们正在玩一个猜数游戏,游戏规则如下:
我从 1 到 n 之间选择一个数字。 你来猜我选了哪个数字。 如果你猜到正确的数字,就会 赢得游戏 。 如果你猜错了,那么我会告诉你,我选的数字比你的 更大或者更小 ,并且你需要继续猜数。 每当你猜了数字 x 并且猜错了的时候,你需要支付金额为 x 的现金。如果你花光了钱,就会 输掉游戏 。 给你一个特定的数字 n ,返回能够 确保你获胜 的最小现金数,不管我选择那个数字
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : int getMoneyAmount (int n) vector<vector<int >> dp (1 + n, vector <int >(1 + n)); for (int i = n - 1 ; i >= 1 ; i--) { for (int j = 1 + i; j <= n; j++) { dp[i][j] = j+dp[i][j-1 ]; for (int k = i; k < j; k++) { dp[i][j] = min (dp[i][j], k + max (dp[i][k - 1 ], dp[k + 1 ][j])); } } } return dp[1 ][n]; } };
实现方面,创建行数和列数都是 n+1 的二维数组 f,其中 f[i][j] 即为状态 f(i,j)。在根据状态转移方程计算时需要注意下标的边界问题,当 j=n 时,如果 k=j 则 k+1>n,此时 f[k][j] 会出现下标越界。为了避免出现下标越界,计算 f[i][j] 的方法是:首先令 f[i][j]=j+f[i][j−1],然后遍历 i≤k<j 的每个 k,更新 f[i][j] 的值。
分治法是一种很重要的算法,属于五大常用算法之一。其字面意思是“分而治之”,具体可以分为3个步骤。
“分”指的是将一个复杂的问题分成多个性质相同但规模更小的子问题,而子问题同样能够继续分解直到能够被解决。
“治”指的是对子问题分别进行处理。 “合”就是将子问题的解进行合并,从而得到原问题的解。
与动态规划一样,分治法很大程度上也基于递归的思想,两者的区别在于动态规划分解后的子问题是有重复的(重叠子问题性质),而分治法的子问题通常不会重复。因此,分治法所能解决的问题一般具有以下几个特征。1.问题的规模缩小到一定程度后可以被很容易地解决。
2.问题可以分解为若干个规模较小的相同性质的问题。
3.问题的解等于子问题解的合并。
4.问题分解的各个子问题相互独立,没有重复。
上述前3点决定了问题能否通过分治法来解决。而最后一点涉及分治法的效率,原因在于如果各个子问题不相互独立,则会产生重复的工作,此时虽然可以使用分治法,但使用动态规划效率会更高。
下面我们列出常见的可以使用分治法的经典问题
● 二分搜索。
● 大整数的乘法。
核心思路(分→治→合)
传统大数乘法(逐位相乘再相加)时间复杂度是 O(n2),而 Karatsuba 算法通过分治将复杂度降到 O(nlog23)≈O(n1.585),核心步骤:
分(Divide)
设两个 n 位大数 x和 y,拆分为高位和低位:x = a 10^(n/2) + b,y = c 10^(n/2) + d
(比如 x=1234,拆为 a=12,b=34;y=5678,拆为 c=56,d=78)
治(Conquer)
递归计算 3 个子问题(而非传统的 4 个,这是优化核心):
ac = 分治乘法(a, c)bd = 分治乘法(b, d)ad_bc = 分治乘法(a+b, c+d) - ac - bd 合(Combine)
原结果 = ac 10^n + ad_bc 10^(n/2) + bd
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 def karatsuba (x: int , y: int ) -> int : if x < 10 or y < 10 : return x * y n = max (len (str (x)), len (str (y))) half = n // 2 a, b = divmod (x, 10 **half) c, d = divmod (y, 10 **half) ac = karatsuba(a, c) bd = karatsuba(b, d) ad_bc = karatsuba(a + b, c + d) - ac - bd return ac * 10 **(2 *half) + ad_bc * 10 **half + bd
● strassen矩阵乘法。
● 棋盘覆盖问题。● 归并排序和快速排序。● 最接近点对问题。● 汉诺塔问题。
合并K个升序链表
给你一个链表数组,每个链表都已经按升序排列。请你将所有链表合并到一个升序链表中,返回合并后的链表.
用分治的方法进行合并。
将 k 个链表配对并将同一对中的链表合并;
核心逻辑:
将 lists 分为左右两半。 递归处理左半部分,递归处理右半部分。 最后调用“合并两个有序链表”的函数将两部分合并 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 class Solution {public : ListNode* mergeTwoLists (ListNode* node1, ListNode* node2) { ListNode* dummy = new ListNode; ListNode* cur = dummy; while (node1 && node2) { if (node1->val < node2->val) { cur->next = node1; node1 = node1->next; } else { cur->next = node2; node2 = node2->next; } cur = cur->next; } if (node1) { cur->next = node1; } if (node2) { cur->next = node2; } return dummy->next; } ListNode* mergeLists (int left, int right, vector<ListNode*>& lists) { if (left > right) { return nullptr ; } if (left == right) { return lists[left]; } int mid = (right - left) / 2 + left; ListNode* l1 = mergeLists (left, mid, lists); ListNode* l2 = mergeLists (mid + 1 , right, lists); return mergeTwoLists (l1, l2); } ListNode* mergeKLists (vector<ListNode*>& lists) { int sz = lists.size (); if (sz == 0 ) { return nullptr ; } ListNode* res = mergeLists (0 , sz - 1 , lists); return res; } }; class Solution {public : ListNode* mergeKLists (vector<ListNode*>& lists) { auto comp = [](ListNode* a, ListNode* b) { return a->val > b->val; }; priority_queue<ListNode*, vector<ListNode*>, decltype (comp)> pq (comp); for (auto l : lists) { if (l) { pq.push (l); } } ListNode *dummy = new ListNode, *cur = dummy; while (!pq.empty ()) { cur->next = pq.top (); pq.pop (); cur = cur->next; if (cur->next) { pq.push (cur->next); } } return dummy->next; } };
数组中的第K个最大元素
给定整数数组 nums 和整数 k,请返回数组中第 **k** 个最大的元素。请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。你必须设计并实现时间复杂度为 O(n) 的算法解决此问题。
在计算机科学中,快速选择(quick select)作为一种在无序列表中获得第k小元素的选择算法,是分治思想的经典应用之一。它和快速排序(quick sort)算法一样,都来自Tony Hoare,因此也被称为Hoare’s selection algorithm。快速排序算法在实践中拥有非常好的平均性能,很多工业界的排序算法都有其身影(比如各种高级编程语言官方库中的排序方法)。与快速排序算法思想相近的快速选择算法及其变种,同样拥有非常好的平均性能,但缺点也是类似的,即该算法在最坏情况下性能很差。回归到题目,求第k大元素可以直接转换成求第n-k+1小的元素,这里的n是数组的大小,也就是说我们可以在这里使用快速选择算法 。
速选择算法和快速排序算法共用了partition子过程,也就是分治法中的分解操作。而两者之间的区别在于,快速排序算法会将问题划分为两个子问题分开递归解决,其只需要递归处理一个子问题即可。快速选择算法的逻辑很简单,如下所示。1.随机选择一个pivot(支点)。2.使用partition子过程将pivot放在数组中合适的位置,将其设为pos。partition的作用就是将小于pivot的元素移到左边,大于或等于pivot的元素移到右边。
partition之后,我们先判断pos是否是想要的结果,如果是,则直接得到答案(这里也是上面讲述分治法时提到的可以直接求解的最简单子问题)。
如果不是,判断答案是在pos的左边还是右边,然后在新的范围中重复步骤1和2。这就是将问题拆分成子问题,并对子问题进行递归处理的过程。这里随机选择一个pivot是为了尽量降低快速选择算法中最坏情况发生的可能性。另外一种技巧是随机化打乱数组的预处理。
通常来讲,有两种partition方式:Lomuto partition和Hoare partition。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : int partition (vector<int >& nums, int left, int right, int k) if (left == right) { return nums[left]; } int i = left - 1 , j = right + 1 ; int pivot = nums[left]; while (true ) { do { i++; } while (nums[i] < pivot); do { j--; } while (nums[j] > pivot); if (i >= j) { break ; } swap (nums[i], nums[j]); } if (k <= j) { return partition (nums, left, j, k); } else { return partition (nums, j + 1 , right, k); } } int findKthLargest (vector<int >& nums, int k) return partition (nums, 0 , nums.size () - 1 , nums.size () - k); } };
Hoare 分区的特点是:
基准值最终可能在任意位置 只保证 left..j的元素 ≤ 基准值 只保证 j+1..right的元素 ≥ 基准值 为什么 Hoare 分区可以用于快速选择?关键在于:不需要知道 pivot 的确切位置,只需要知道目标元素 k在哪一边分区即可。 1 2 3 4 5 6 if (k <= j) search left; else search right;
lumoto分区特点. 基准值放在正确位置 ,对重复元素处理较差
1 2 3 4 5 6 7 if (k == p) return nums[p];else if (k < p) search left;else search right;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 int lomutoPartition (vector<int >& arr, int low, int high) int pivot = arr[high]; int i = low - 1 ; for (int j = low; j < high; j++) { if (arr[j] <= pivot) { i++; swap (arr[i], arr[j]); } } swap (arr[i + 1 ], arr[high]); return i + 1 ; } int quickSelect2 (vector<int >&nums,int l,int r) int target = nums[l]; int i = l,j = r; while (i<j) { while (i<j && nums[j]>=target) { j--; } while (i<j && nums[i]<=target) { i++; } if (i>=j) { break ; } swap (nums[i],nums[j]); } swap (nums[i],nums[l]); return i; } int hoarePartition (vector<int >& arr, int low, int high) int pivot = arr[low]; int i = low - 1 ; int j = high + 1 ; while (true ) { do { i++; } while (arr[i] < pivot); do { j--; } while (arr[j] > pivot); if (i >= j) return j; swap (arr[i], arr[j]); } }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 int lomutoPartition (vector<int >& arr, int low, int high) int randIdx = low + rand () % (high - low + 1 ); swap (arr[randIdx], arr[high]); int pivot = arr[high]; int i = low - 1 ; for (int j = low; j < high; ++j) { if (arr[j] <= pivot) { ++i; swap (arr[i], arr[j]); } } swap (arr[i + 1 ], arr[high]); return i + 1 ; } int hoarePartition (vector<int >& arr, int low, int high) int randIdx = low + rand () % (high - low + 1 ); swap (arr[randIdx], arr[low]); int pivot = arr[low]; int i = low - 1 ; int j = high + 1 ; while (true ) { do { ++i; } while (arr[i] < pivot); do { --j; } while (arr[j] > pivot); if (i >= j) { return j; } swap (arr[i], arr[j]); } }
特性 Lomuto 分区 Hoare 分区 指针方向 同向移动(都向右) 对向移动 (向中间靠拢)代码简洁度 非常简洁 略复杂(有死循环风险,需谨慎处理) 交换频率 高 低(效率更高) Pivot 位置 结束后 Pivot 就在最终排序位置 结束后 Pivot 可能不在最终位置 重复元素处理 较差(容易造成分区不平衡) 更好 (能更均匀地分配重复元素)
搜索二维矩阵
编写一个高效的算法来搜索 *m* x *n* 矩阵 matrix 中的一个目标值 target 。该矩阵具有以下特性:
每行的元素从左到右升序排列。 每列的元素从上到下升序排列。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : bool searchValue (vector<vector<int >>& matrix, int target, int row, int col) if (row >= matrix.size () || col < 0 ) { return false ; } if (matrix[row][col] == target) { return true ; } else if (matrix[row][col] < target) { return searchValue (matrix, target, row + 1 , col); } else { return searchValue (matrix, target, row, col - 1 ); } } bool searchMatrix (vector<vector<int >>& matrix, int target) int m = matrix.size (); int n = matrix[0 ].size (); return searchValue (matrix, target, 0 , n - 1 ); } };
如果能够满足本章开头说的分治法特征,就可以尝试使用分治法来处理,具体如下所示。● 问题的规模缩小到一定程度后可以被很容易地解决。● 问题可以分解为若干个规模较小的相同性质的问题。● 问题的解等于子问题解的合并。● 问题分解的各个子问题相互独立,没有重复。而在具体使用分治法时,紧紧抓住“分解”“解决”和“合并”这3个步骤
寻找两个正序数组的中位数
给定两个大小分别为 m 和 n 的正序(从小到大)数组 nums1 和 nums2。请你找出并返回这两个正序数组的 中位数 。算法的时间复杂度应该为 O(log (m+n)) 。
要达到 O (log (m+n)) 的时间复杂度,必须使用二分查找 而非简单的合并数组(合并数组的时间复杂度是 O (m+n))。核心思路是:
将问题转化为寻找两个有序数组中的第 k 小元素 (中位数本质上就是第 (m+n)/2 小的元素)。 通过二分法不断缩小搜索范围:每次比较两个数组中第 k/2 位置的元素,排除不可能包含第 k 小元素的部分,直到 k=1 时直接取较小值。 处理奇偶情况:如果 m+n 是奇数,中位数就是第 (m+n+1)/2 小的元素;如果是偶数,就是第 (m+n)/2 和 (m+n)/2 +1 小的元素的平均值。 如何找第k小?
假设我们要找第 k 小元素:
比较两个数组的第 k/2个元素 较小的那个数组的前 k/2个元素都不可能是第 k 小 排除这些元素,问题规模减小 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : double findMedianSortedArrays (vector<int >& nums1, vector<int >& nums2) int m = nums1. size (), n = nums2. size (); int total = m + n; if (total % 2 == 1 ) { return findKth (nums1, 0 , nums2, 0 , (total + 1 ) / 2 ); } else { int left = findKth (nums1, 0 , nums2, 0 , total / 2 ); int right = findKth (nums1, 0 , nums2, 0 , total / 2 + 1 ); return (left + right) / 2.0 ; } } private : double findKth (vector<int >& nums1, int i, vector<int >& nums2, int j, int k) int m = nums1. size (), n = nums2. size (); if (i >= m) return nums2[j + k - 1 ]; if (j >= n) return nums1[i + k - 1 ]; if (k == 1 ) return min (nums1[i], nums2[j]); int mid1 = min (i + k / 2 - 1 , m - 1 ); int mid2 = min (j + k / 2 - 1 , n - 1 ); if (nums1[mid1] <= nums2[mid2]) { return findKth (nums1, mid1 + 1 , nums2, j, k - (mid1 - i + 1 )); } else { return findKth (nums2, i, nums2, mid2 + 1 , k - (mid2 - j + 1 )); } } };
在成千上万个文件中找第 $k$ 大的数
这个问题将之前的“有序数组排除法”推向了分布式计算 和大数据处理 的实战领域。
当数据量大到无法装入内存,且分布在成千上万个文件中时,我们不能再依赖简单的指针移动,而要利用“值域划分” 或“分桶统计” 的思想。这本质上是把“对索引的二分”转变成了“对数值范围的二分” 。
以下是三种最主流的解决策略:
桶计数法(最推荐:MapReduce 思想) 这是处理海量数据最稳健的方法。它的核心是将“寻找第 k 大”转化为“统计落在各个区间的数字个数”。
步骤:
确定值域 :假设数字是 32 位整数,范围是 [0,232−1]。分桶 :将这个范围均匀分成 M 个桶(例如 1024 个桶)。每个桶代表一个数值区间(如桶 0 代表 [0,4×10⁶])。第一轮扫描(Map) :遍历成千上万个文件,统计落入每个桶中的数字总数。结果示例 :桶 0 有 10 亿个数,桶 1 有 5 亿个数……定位目标桶(Reduce) :从大到小累加桶的计数。如果前 2 个桶的总数小于 k ,但前 3 个桶的总数大于等于 k ,那么第 k 大的数一定在桶 2 中。 精细化搜索 :
如果桶 2 中的数据量已经足够小(能装进内存),直接读入内存用 QuickSelect 解决。 如果依然太大,对桶 2 的值域范围再次进行“分桶”,重复上述过程。 外部快速选择(External QuickSelect)
这种方法是 QuickSelect 的分布式版本,适合数据分布在多台服务器上的场景。
步骤:
选基准值(Pivot) :从随机一个文件中选一个数作为 Pivot。分布式分区 :所有节点同时扫描自己负责的文件,将数字分为“大于 Pivot”、“等于 Pivot”和“小于 Pivot”三类,并记录每类的总数 。判断路径 :如果“大于 Pivot”的总数 ≥k ,则第 k 大在这一半,抛弃其余数据,在这一半中继续找。 如果总数 <k 且(大于+等于)的总数 ≥k ,则 Pivot 就是答案。 否则,去“小于 Pivot”的那一半找第 k −(大于+等于) 大。 缺点 :如果 Pivot 选得不好(比如选到了极值),需要频繁扫描磁盘,I/O 开销极大。
堆排序法(仅限 k 较小时) 如果你要找的是“前 1000 大”,而不是“中位数”或“第 10 亿大”,那么堆是无敌的。
步骤:
建立一个大小为 k 的最小堆 。 逐个读取文件中的数字: 扫描完所有文件后,堆顶即为所求。 优点 :只需要扫描一遍数据,内存占用极低(仅 O (k ))。
计算右侧小于当前元素的个数
给你一个整数数组 nums ,按要求返回一个新数组 counts 。数组 counts 有该性质: counts[i] 的值是 nums[i] 右侧小于 nums[i] 的元素的数量。
在归并排序的“合并(Merge)”阶段,我们将两个有序的子数组合并。假设左子数组为 L,右子数组为 R。
当我们从 L 中取出一个元素放入结果数组时,如果 R 中已经有若干个元素先被放入了结果数组,那么这些先被放入的 R 中的元素,一定是原数组中位于该 L 元素右侧且比它小的数 。 我们只需要在合并时,记录 R 中有多少个元素已经被移动到了 L 元素的前面即可。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : void merge (vector<pair<int , int >>& nums, int left, int right, vector<int >& cnt) if (left >= right) return ; int mid = (right - left) / 2 + left; merge (nums, left, mid, cnt); merge (nums, 1 + mid, right, cnt); vector<pair<int , int >> tmp (right - left + 1 ); int i = left, j = mid + 1 ; int rightCount{}; int idx{}; while (i <= mid && j <= right) { if (nums[i].first <= nums[j].first) { cnt[nums[i].second] += rightCount; tmp[idx++] = nums[i++]; } else { rightCount++; tmp[idx++] = nums[j++]; } } while (i <= mid) { cnt[nums[i].second] += rightCount; tmp[idx++] = nums[i++]; } while (j <= right) { tmp[idx++] = nums[j++]; } for (int i = left; i <= right; i++) { nums[i] = tmp[i - left]; } } vector<int > countSmaller (vector<int >& nums) { vector<pair<int , int >> index_nums; int sz = nums.size (); for (int i = 0 ; i < sz; i++) { index_nums.push_back ({nums[i], i}); } vector<int > cnt (sz) ; merge (index_nums, 0 , sz - 1 , cnt); return cnt; } };
交易逆序对的总数
在股票交易中,如果前一天的股价高于后一天的股价,则可以认为存在一个「交易逆序对」。请设计一个程序,输入一段时间内的股票交易记录 record,返回其中存在的「交易逆序对」总数
逆序对定义 :对于 i < j,如果 record[i] > record[j],则 (i, j)是一个逆序对归并排序法的核心思想 :分治:将数组分成两半 合并时统计:如果左半部分的元素大于右半部分的元素,则左半部分剩余的所有元素都与右半部分的该元素构成逆序对 时间复杂度:O(nlogn),空间复杂度:O(n) 为什么归并排序法有效 :在合并两个有序子数组时,可以高效地统计跨越两个子数组的逆序对 递归地统计每个子数组内部的逆序对 这是面试中常见的问题,归并排序法 是必须掌握的标准解法。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 class Solution {public : int reversePairs (vector<int >& record) int n = record.size (); if (n < 2 ) return 0 ; vector<int > temp (n) ; return mergeSort (record, temp, 0 , n - 1 ); } int mergeSort (vector<int >& nums, vector<int >& temp, int left, int right) if (left >= right) return 0 ; int mid = left + (right - left) / 2 ; int count = 0 ; count += mergeSort (nums, temp, left, mid); count += mergeSort (nums, temp, mid + 1 , right); int i = left, j = mid + 1 , k = left; while (i <= mid && j <= right) { if (nums[i] > nums[j]) { count += (mid - i + 1 ); j++; } else { i++; } } i = left, j = mid + 1 , k = left; while (i <= mid && j <= right) { if (nums[i] <= nums[j]) { temp[k++] = nums[i++]; } else { temp[k++] = nums[j++]; } } while (i <= mid) temp[k++] = nums[i++]; while (j <= right) temp[k++] = nums[j++]; for (int idx = left; idx <= right; idx++) { nums[idx] = temp[idx]; } return count; } };
漂亮数组
如果长度为 n 的数组 nums 满足下述条件,则认为该数组是一个 漂亮数组 :
nums 是由范围 [1, n] 的整数组成的一个排列。对于每个 0 <= i < j < n ,均不存在下标 k(i < k < j)使得 2 * nums[k] == nums[i] + nums[j] 。 给你整数 n ,返回长度为 n 的任一 漂亮数组 。本题保证对于给定的 n 至少存在一个有效答案。
通过以下步骤递归构造长度为 $n$ 的漂亮数组:
分 :将 $n$ 个数分成两部分,左边是 $(n+1)/2$ 个数,右边是 $n/2$ 个数。变换 :左边由长度为 $(n+1)/2$ 的漂亮数组通过 $2x - 1$ 变换得到(映射为奇数)。 右边由长度为 $n/2$ 的漂亮数组通过 $2x$ 变换得到(映射为偶数)。 合 :将左右两部分拼接。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : unordered_map<int , vector<int >> memo; vector<int > dfs (int n) { if (memo.count (n)) { return memo[n]; } vector<int > res (n) ; int i{}; vector<int > l = dfs ((n + 1 ) / 2 ); for (auto & n : l) { res[i++] = 2 * n - 1 ; } vector<int > r = dfs (n / 2 ); for (auto & n : r) { res[i++] = 2 * n; } memo[n] = res; return res; } vector<int > beautifulArray (int n) { memo[1 ] = {1 }; return dfs (n); } };
每次根据问题的当前状态,选择一个局部最优策略,并且能够不断迭代,最后产生一个全局最优解。换句话说,每次都是从当前问题出发,而不考虑之前或之后的问题的状态,然后做出一个最有利于当前问题的决策,迭代更新问题,不断重复同样的操作直到问题得到解决,此时得到的解为全局最优解。
一般而言,贪心法的题目只要求我们想到一个合理的局部最优策略,并且通过自己举例测试局部最优策略是否会出问题即可,而不需要去关注如何证明这个策略能够产生一个全局最优解。
分发饼干
为了尽可能满足最多数量的孩子,从贪心的角度考虑,应该按照孩子的胃口从小到大的顺序依次满足每个孩子,且对于每个孩子,应该选择可以满足这个孩子的胃口且尺寸最小的饼干。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : int findContentChildren (vector<int >& g, vector<int >& s) sort (g.begin (), g.end ()); sort (s.begin (), s.end ()); int i{}, j{}; while (i < g.size () && j < s.size ()) { if (g[i] <= s[j]) { i++; j++; } else { j++; } } return i; } };
跳跃游戏
给你一个非负整数数组 nums ,你最初位于数组的 第一个下标 。数组中的每个元素代表你在该位置可以跳跃的最大长度。
判断你是否能够到达最后一个下标,如果可以,返回 true ;否则,返回 false 。
依次遍历数组中的每一个位置,并实时维护 最远可以到达的位置。对于当前遍历到的位置 x,如果它在 最远可以到达的位置 的范围内,那么我们就可以从起点通过若干次跳跃到达该位置,因此我们可以用 x+nums[x] 更新 最远可以到达的位置。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 class Solution {public : bool canJump (vector<int >& nums) int max_step{}; for (int i = 0 ; i < nums.size (); i++) { if (i <= max_step) { max_step = max (max_step, nums[i] + i); if (max_step >= nums.size () - 1 ) { return true ; } } else { break ; } } return false ; } };
任务调度器
给你一个用字符数组 tasks 表示的 CPU 需要执行的任务列表,用字母 A 到 Z 表示,以及一个冷却时间 n。每个周期或时间间隔允许完成一项任务。任务可以按任何顺序完成,但有一个限制:两个 相同种类 的任务之间必须有长度为 n 的冷却时间。返回完成所有任务所需要的 最短时间间隔 。
假设出现次数最多的任务是 A,它的频率为 max_freq。 为了让时间最短,我们应该尽可能把 A 均匀地排开,中间填入冷却时间或其它任务。
计算出的结果可能面临两种情况:
结论 :最终结果是 $\max(\text{tasks.size()}, (max_f - 1) \times (n + 1) + max_count)$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : int leastInterval (vector<char >& tasks, int n) vector<int > cnts (26 ) ; int max_cnt{}; for (auto & ch:tasks) { cnts[ch-'A' ]++; max_cnt = max (max_cnt,cnts[ch-'A' ]); } int max_chars{}; for (int i = 0 ;i<26 ;i++){ if (cnts[i] == max_cnt) { max_chars++; } } int res = (n+1 )*(max_cnt-1 ) + max_chars; return max <int >(tasks.size (),res); } };
分发糖果
n 个孩子站成一排。给你一个整数数组 ratings 表示每个孩子的评分。
你需要按照以下要求,给这些孩子分发糖果:
每个孩子至少分配到 1 个糖果。 相邻两个孩子中,评分更高的那个会获得更多的糖果。 请你给每个孩子分发糖果,计算并返回需要准备的 最少糖果数目 。
我们可以将「相邻的孩子中,评分高的孩子必须获得更多的糖果」这句话拆分为两个规则,分别处理。
左规则:当 ratings[i−1]<ratings[i] 时,i 号学生的糖果数量将比 i−1 号孩子的糖果数量多。
右规则:当 ratings[i]>ratings[i+1] 时,i 号学生的糖果数量将比 i+1 号孩子的糖果数量多。
我们遍历该数组两次,处理出每一个学生分别满足左规则或右规则时,最少需要被分得的糖果数量。每个人最终分得的糖果数量即为这两个数量的最大值。
具体地,以左规则为例:我们从左到右遍历该数组,假设当前遍历到位置 i,如果有 ratings[i−1]<ratings[i] 那么 i 号学生的糖果数量将比 i−1 号孩子的糖果数量多,我们令 left[i]=left[i−1]+1 即可,否则我们令 left[i]=1。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : int candy (vector<int >& ratings) int sz = ratings.size (); vector<int > left (sz, 1 ) ; vector<int > right (sz, 1 ) ; for (int i = 1 ; i < sz; i++) { if (ratings[i] > ratings[i - 1 ]) { left[i] = left[i - 1 ] + 1 ; } } int ans{}; for (int i = sz - 2 ; i >= 0 ; i--) { if (ratings[i] > ratings[i + 1 ]) { right[i] = right[i + 1 ] + 1 ; } } for (int i = 0 ;i<sz;i++) { ans += max (left[i],right[i]); } return ans; } };
无重叠区间
给定一个区间的集合 intervals ,其中 intervals[i] = [starti, endi] 。返回 需要移除区间的最小数量,使剩余区间互不重叠 。
注意 只在一点上接触的区间是 不重叠的 。例如 [1, 2] 和 [2, 3] 是不重叠的
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : int eraseOverlapIntervals (vector<vector<int >>& intervals) sort (intervals.begin (), intervals.end ()); int lastTime = intervals[0 ][1 ]; int res{}; for (int i = 0 ; i < intervals.size () - 1 ; i++) { if (lastTime <= intervals[i + 1 ][0 ]) { lastTime = intervals[i + 1 ][1 ]; } else { lastTime = min (lastTime, intervals[i + 1 ][1 ]); res++; } } return res; } }; class Solution {public : int eraseOverlapIntervals (vector<vector<int >>& intervals) auto comp = [](vector<int >& a,vector<int >& b){ return a[1 ]<b[1 ]; }; sort (intervals.begin (),intervals.end (),comp); int lastTime = intervals[0 ][1 ]; int cnt{1 }; for (int i = 1 ;i<intervals.size ();i++) { if (lastTime<=intervals[i][0 ]) { cnt++; lastTime = intervals[i][1 ]; }else { } } return intervals.size ()-cnt; } };
跳跃游戏II
给定一个长度为 n 的 0 索引 整数数组 nums。初始位置在下标 0。
每个元素 nums[i] 表示从索引 i 向后跳转的最大长度。换句话说,如果你在索引 i 处,你可以跳转到任意 (i + j) 处:
0 <= j <= nums[i] 且i + j < n返回到达 n - 1 的最小跳跃次数。测试用例保证可以到达 n - 1。
目标是:在当前跳跃能达到的范围内,寻找下一跳能跳得最远的位置
当你从索引 i 遍历到 end 之间时,你会不断更新 farthest(即 max(farthest, i + nums[i]))。当你真正走到 end 这个边界时,说明你不得不 再跳一次了。此时,你把跳跃次数 jumps 加 1,并将新的边界 end 设置为刚才探测到的 farthest。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution {public : int jump (vector<int >& nums) int n = nums.size (); if (n <= 1 ) return 0 ; int jumps = 0 ; int farthest = 0 ; int end = 0 ; for (int i = 0 ; i < n - 1 ; i++) { farthest = max (farthest, i + nums[i]); if (i == end) { jumps++; end = farthest; if (end >= n - 1 ) break ; } } return jumps; } };
移掉k位数字
给你一个以字符串表示的非负整数 num 和一个整数 k ,移除这个数中的 k 位数字,使得剩下的数字最小。请你以字符串形式返回这个最小的数字。
让越小的数字尽可能排在越左边(高位) 。这本质上是一个贪心问题,而实现这个贪心策略的最佳工具是 单调栈 (Monotonic Stack) 。想象一个数字序列,如果左边的数字比右边的大(例如 ...43...),那么删掉左边的这个“大数”,整个数字就会立刻变小。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : string removeKdigits (string num, int k) { if (num.length () == k) return "0" ; string res = "" ; for (char d : num) { while (k > 0 && !res.empty () && res.back () > d) { res.pop_back (); k--; } res.push_back (d); } while (k > 0 ) { res.pop_back (); k--; } int start = 0 ; while (start < res.size () && res[start] == '0' ) { start++; } string ans = res.substr (start); return ans.empty () ? "0" : ans; } };
根据身高重建队列
假设有打乱顺序的一群人站成一个队列,数组 people 表示队列中一些人的属性(不一定按顺序)。每个 people[i] = [hi, ki] 表示第 i 个人的身高为 hi ,前面 正好 有 ki 个身高大于或等于 hi 的人。
请你重新构造并返回输入数组 people 所表示的队列。返回的队列应该格式化为数组 queue ,其中 queue[j] = [hj, kj] 是队列中第 j 个人的属性(queue[0] 是排在队列前面的人)。
先安置“高个子”,再让“矮个子”插队 。因为高个子的相对位置只受比他更高或一样高的人影响,而矮个子对他来说是“隐形”的。
我们可以通过两个步骤来搞定:
第一步:排序
我们要对数组进行排序:
身高 $h$ 降序 :高个子排在前面。人数 $k$ 升序 :如果身高一样,要求前面人少的排在前面。第二步:插入
遍历排序后的数组,直接将每个人插入到他对应的 $k$ 位置。
逻辑保证 :当我们处理第 $i$ 个人时,已经在队列里的所有人身高都 $\ge$ 他的身高。此时,他要求前面有 $k$ 个比他高或相等的人,我们就直接把他放在索引 $k$ 的位置。哪怕后面有更矮的人插到他前面,也不会影响他的 $k$ 值。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 class Solution {public : vector<vector<int >> reconstructQueue (vector<vector<int >>& people) { auto comp = [](vector<int >& a,vector<int >& b) { if (a[0 ] == b[0 ]) { return a[1 ]<b[1 ]; } return a[0 ]>b[0 ]; }; sort (people.begin (),people.end (),comp); vector<vector<int >> res; for (auto & p:people) { res.insert (res.begin ()+p[1 ],p); } return res; } };
用最少数量的箭引爆气球
有一些球形气球贴在一堵用 XY 平面表示的墙面上。墙面上的气球记录在整数数组 points ,其中points[i] = [xstart, xend] 表示水平直径在 xstart 和 xend之间的气球。你不知道气球的确切 y 坐标。
一支弓箭可以沿着 x 轴从不同点 完全垂直 地射出。在坐标 x 处射出一支箭,若有一个气球的直径的开始和结束坐标为 xstart,xend, 且满足 xstart ≤ x ≤ xend,则该气球会被 引爆 。可以射出的弓箭的数量 没有限制 。 弓箭一旦被射出之后,可以无限地前进。
给你一个数组 points ,返回引爆所有气球所必须射出的 最小 弓箭数 。
按照气球的结束坐标 ($x_{end}$) 进行升序排序。
为什么选结束坐标? 如果我们按照结束坐标排序,第一支箭的最优射出位置一定是第一个气球的结束位置 。因为这样射出的箭,在引爆当前气球的同时,最有机会引爆后面那些“开始得很早”的气球。
算法步骤:
排序 :将气球按 $x_{end}$ 从小到大排序。初始化 :至少需要 1 支箭(假设数组不为空),初始射箭位置设为第一个气球的结束坐标。遍历 :从第二个气球开始遍历:如果当前气球的开始坐标 $x_{start}$ 大于 上一次射箭的位置:说明这支箭射不到这个气球。 更新 :我们需要一支新箭,增加箭的计数,并将射箭位置更新为当前气球的结束坐标。否则:这支箭可以顺便引爆当前气球,位置保持不变。 按区间的开始位置(Start)进行升序排序。
核心思路:贪心加排序为什么要按开始位置排序? 因为排序后,可以合并的区间一定是连续出现的 。我们只需要比较当前区间的“开始”和上一个合并区间的“结束”即可。
算法步骤:
排序 :按照每个区间的 start 从小到大排序。初始化 :创建一个空的结果数组 res,先把第一个区间放进去。遍历 :从第二个区间开始遍历:取 res 中最后一个区间的末尾 last_end。 取当前遍历区间的开头 curr_start 和末尾 curr_end。 判断重叠 :如果 curr_start <= last_end,说明重叠了!合并 :将 res 中最后一个区间的末尾更新为 max(last_end, curr_end)。不重叠 :如果 curr_start > last_end,说明这两个区间接不上。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : int findMinArrowShots (vector<vector<int >>& points) if (points.empty ()) return 0 ; sort (points.begin (), points.end (), [](const vector<int >& a, const vector<int >& b) { return a[1 ] < b[1 ]; }); int arrows = 1 ; int last_end = points[0 ][1 ]; for (int i = 1 ; i < points.size (); ++i) { if (points[i][0 ] > last_end) { arrows++; last_end = points[i][1 ]; } } return arrows; } };
合并区间
以数组 intervals 表示若干个区间的集合,其中单个区间为 intervals[i] = [starti, endi] 。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : vector<vector<int >> merge (vector<vector<int >>& intervals) { auto comp = [](vector<int >& a,vector<int >&b) { if (a[0 ] == b[0 ]) { return a[1 ]<b[1 ]; } return a[0 ]<b[0 ]; }; sort (intervals.begin (),intervals.end (),comp); vector<vector<int >> res; res.push_back (intervals[0 ]); for (int i = 1 ;i<intervals.size ();i++) { auto & lastInterval = res.back (); if (lastInterval[1 ]>=intervals[i][0 ]) { lastInterval[1 ] = max (lastInterval[1 ],intervals[i][1 ]); }else { res.push_back (intervals[i]); } } return res; } };
合并区间(本题) :我们需要知道谁先开始,因为合并是向前推进的。如果按 End 排序,一个跨度极大的区间(如 [1, 100])可能会排在最后,导致你之前合并好的所有小片段都要重新去和它比对,逻辑会变复杂。
射气球/不重叠区间 :我们需要尽早结束当前区间,好给后面的区间留位置。所以“谁先结束”是最重要的贪心标准。
插入区间
给你一个 无重叠的 , 按照区间起始端点排序的区间列表 intervals,其中 intervals[i] = [starti, endi] 表示第 i 个区间的开始和结束,并且 intervals 按照 starti 升序排列。同样给定一个区间 newInterval = [start, end] 表示另一个区间的开始和结束。
在 intervals 中插入区间 newInterval,使得 intervals 依然按照 starti 升序排列,且区间之间不重叠(如果有必要的话,可以合并区间)。
返回插入之后的 intervals。注意 你不需要原地修改 intervals。你可以创建一个新数组然后返回它。
可以把处理过程想象成在一条时间轴上排队,把 newInterval 插入进去,并把受到波及的人“融合”掉:
阶段一:左侧无重叠
直接把所有结束时间 早于 newInterval 开始时间 的区间丢进结果集。它们完全在左边,互不干扰。
阶段二:中间重叠区(融合)
只要当前的区间没有完全在 newInterval 的右边 (即当前区间的开始时间 $\le$ newInterval 的结束时间),就说明有重叠。
融合策略 :更新 newInterval 的起点为 min(起点),终点为 max(终点)。阶段三:右侧无重叠
把合并后的 newInterval 放进结果集,然后把剩下的还没处理的区间(它们都在右边,开始时间晚于 newInterval 的结束时间)全部接在后面。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : vector<vector<int >> insert (vector<vector<int >>& intervals, vector<int >& newInterval) { vector<vector<int >> res; int i{}; while (i < intervals.size () && intervals[i][1 ] < newInterval[0 ]) { res.push_back (intervals[i]); i++; } while (i < intervals.size () && intervals[i][0 ] <= newInterval[1 ]) { newInterval[0 ] = min (newInterval[0 ], intervals[i][0 ]); newInterval[1 ] = max (newInterval[1 ], intervals[i][1 ]); i++; } res.push_back (newInterval); while (i < intervals.size ()) { res.push_back (intervals[i]); i++; } return res; } };
灌溉花园的最少水龙头数目
在 x 轴上有一个一维的花园。花园长度为 n,从点 0 开始,到点 n 结束。
花园里总共有 n + 1 个水龙头,分别位于 [0, 1, ..., n] 。
给你一个整数 n 和一个长度为 n + 1 的整数数组 ranges ,其中 ranges[i] (下标从 0 开始)表示:如果打开点 i 处的水龙头,可以灌溉的区域为 [i - ranges[i], i + ranges[i]] 。
请你返回可以灌溉整个花园的 最少水龙头数目 。如果花园始终存在无法灌溉到的地方,请你返回 -1 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 class Solution {public : int minTaps (int n, vector<int >& ranges) vector<int > max_reach (n + 1 , 0 ) ; for (int i = 0 ; i <= n; i++) { int left = max (0 , i - ranges[i]); int right = min (n, i + ranges[i]); max_reach[left] = max (max_reach[left], right); } int taps = 0 ; int cur_end = 0 ; int farthest = 0 ; for (int i = 0 ; i <n; i++) { farthest = max (farthest, max_reach[i]); if (i >= farthest) return -1 ; if (i == cur_end) { taps++; cur_end = farthest; if (cur_end >= n) break ; } } return cur_end >= n ? taps : -1 ; } };
总体而言贪心类型的题目难度级别大部分只有中等,对应的解题技巧主要包括3个步骤。
● 掌握常见的贪心策略,例如本章的内容或其他人总结的经典贪心思想。
● 不断练习,积累题目经验,补充贪心策略,开拓自己的眼界和认知。
● 面对一道新颖的贪心类型的题目,要敢于设想一个局部最优策略。寻找局部最优策略的过程就是试错的过程,可以基于自己的生活经验或解题经验,并对策略的可行性进行简单的推理论证。
回溯法是一种复杂度很高的暴力搜索算法,实现简单且有固定模板,常被用于搜索排列组合问题的所有可行性解。不同于普通的暴力搜索,回溯法会在每一步判断状态是否合法,而不是等到状态全部生成后再进行确认。当某一步状态非法时,它将回退到上一步中正确的位置,然后继续搜索其他不同的状态。前进和后退是回溯法的关键动作,因此可以使用递归去模拟整个过程,即使用递归实现回溯法。
组合总和
给你一个 无重复元素 的整数数组 candidates 和一个目标整数 target ,找出 candidates 中可以使数字和为目标数 target 的 所有 不同组合 ,并以列表形式返回。你可以按 任意顺序 返回这些组合。
candidates 中的 同一个 数字可以 无限制重复被选取 。如果至少一个数字的被选数量不同,则两种组合是不同的。 对于给定的输入,保证和为 target 的不同组合数少于 150 个。
回溯法的本质是深度优先遍历,具体的实现方法是递归,因此需要定义一个递归函数来模拟整个搜索过程,即dfs()。不断向下递归的过程,也就是搜索前进的过程,那么在这个过程中需要注意哪些问题呢?这些问题与递归函数的内容及参数息息相关,值得我们关注理解。
(i)如何区别不同的递归?或者如何知道现在搜索到哪里了?每一层递归的函数内容是固定的,有所区别的只有参数信息,因此可以将参数信息作为区分的标记。通过获取当前递归的参数信息,也就能够认识到搜索的位置了。也可以称这些参数信息为递归携带的状态,模板中定义了3个状态,分别是idx、cur和path。其中,idx标记位置信息,例如idx=1可以表示搜索到数组的第1个数字,idx=2可以表示搜索到数组的第2个数字;cur和path实际上都是从出发点到当前位置的路径上的某个信息,需要根据题目的要求灵活定义。
(ii)递归如何结束?有几个结束出口?搜索的目标就是找到可行性解。通常情况下找到可行性解就应该结束搜索,但在一些特殊场景下,不同的解可能会重叠,例如找到解后继续搜索可能会得到新的解,此时就不能结束搜索。此外,当无法继续搜索时也应该结束搜索,例如依次遍历数组元素,如果递归过程中idx等于数组末尾的下标,则不能继续往下搜索,否则会发生程序错误。
(iii)递归过程中状态可能会互相影响,如何解决?这个问题可能不是很好理解。举个例子来说,假设当前可以向左前进,也可以向右前进,并且需要保存走过的路径。基于上述第一个问题,应该在递归中携带状态path来保存当前路径,并在进入下一层递归之前改变状态:向左前进则path.append(left),向右前进则path.append(right)。如果先选择向左前进,path已经发生变化,包括向左的一些路径信息,再选择向右前进就会存在问题。一种简单的解决方案是:每次进入下一层递归时重新复制path,但复制path的时间复杂度为O(n),时间开销太大,无法充分利用path。可以考虑另外一种解决方案:在递归结束的地方恢复原来path的状态,即在下一层递归前通过path.append(num)改变状态,并在递归结束时通过path.pop()恢复状态。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : void backtrace (vector<vector<int >>& res, vector<int >& r, vector<int >& nums, int idx, int sum_val, int target) if (idx == nums.size ()) { return ; } if (sum_val == target) { res.push_back (r); return ; } for (int i = idx; i < nums.size () && (nums[i] + sum_val <= target); i++) { r.push_back (nums[i]); backtrace (res, r, nums, i, sum_val + nums[i], target); r.pop_back (); } } vector<vector<int >> combinationSum (vector<int >& candidates, int target) { vector<vector<int >> res; vector<int > r; sort (candidates.begin (), candidates.end ()); backtrace (res, r, candidates, 0 , 0 , target); return res; } };
组合总和II
给定一个候选人编号的集合 candidates 和一个目标数 target ,找出 candidates 中所有可以使数字和为 target 的组合。candidates 中的每个数字在每个组合中只能使用 一次 。
注意: 解集不能包含重复的组合。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 class Solution {private : vector<vector<int >> result; vector<int > path; void backtracking (vector<int >& candidates, int target, int sum, int startIndex, vector<bool >& used) if (sum == target) { result.push_back (path); return ; } for (int i = startIndex; i < candidates.size () && sum + candidates[i] <= target; i++) { if (i > 0 && candidates[i] == candidates[i - 1 ] && used[i - 1 ] == false ) { continue ; } sum += candidates[i]; path.push_back (candidates[i]); used[i] = true ; backtracking (candidates, target, sum, i + 1 , used); used[i] = false ; sum -= candidates[i]; path.pop_back (); } } public : vector<vector<int >> combinationSum2 (vector<int >& candidates, int target) { vector<bool > used (candidates.size(), false ) ; path.clear (); result.clear (); sort (candidates.begin (), candidates.end ()); backtracking (candidates, target, 0 , 0 , used); return result; } };
组合总和III
找出所有相加之和为 n 的 k 个数的组合,且满足下列条件:
返回 所有可能的有效组合的列表 。该列表不能包含相同的组合两次,组合可以以任何顺序返回。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : void backtrace (vector<vector<int >>& res, int sum_val, int idx, vector<int >& r, int k, int n) if (r.size () == k) { if (sum_val == n) { res.push_back (r); } return ; } for (int i = idx; i <= 9 && i + sum_val <= n; i++) { r.push_back (i); backtrace (res, sum_val + i, i + 1 , r, k, n); r.pop_back (); } } vector<vector<int >> combinationSum3 (int k, int n) { vector<vector<int >> res; vector<int > r; backtrace (res, 0 , 1 , r, k, n); return res; } };
子集
给你一个整数数组 nums ,数组中的元素 互不相同 。返回该数组所有可能的子集(幂集)。解集 不能 包含重复的子集。你可以按 任意顺序 返回解集。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution {public : void backtrace (vector<vector<int >>& res,vector<int >& r,vector<int >& nums,int idx) res.push_back (r); for (int i = idx;i<nums.size ();i++) { r.push_back (nums[i]); backtrace (res,r,nums,i+1 ); r.pop_back (); } } vector<vector<int >> subsets (vector<int >& nums) { vector<vector<int >> res; vector<int > r; backtrace (res,r,nums,0 ); return res; } };
全排列
给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 class Solution {public : void backtrace (vector<vector<int >>& res, vector<int >& r, vector<int >& nums, int idx, vector<bool >& used) if (r.size () == nums.size ()) { res.push_back (r); return ; } for (int i = 0 ; i < nums.size (); i++) { if (used[i]) { continue ; } r.push_back (nums[i]); used[i] = true ; backtrace (res, r, nums, i + 1 , used); used[i] = false ; r.pop_back (); } } vector<vector<int >> permute (vector<int >& nums) { vector<vector<int >> res; vector<int > r; int sz = nums.size (); vector<bool > used (sz) ; backtrace (res, r, nums, 0 , used); return res; } };
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 class Solution {public : void backtrack (vector<vector<int >>& res, vector<int >& output, int first, int len) if (first == len) { res.emplace_back (output); return ; } for (int i = first; i < len; ++i) { swap (output[i], output[first]); backtrack (res, output, first + 1 , len); swap (output[i], output[first]); } } vector<vector<int >> permute (vector<int >& nums) { vector<vector<int > > res; backtrack (res, nums, 0 , (int )nums.size ()); return res; } };
解数独
给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。
编写一个程序,通过填充空格来解决数独问题。
数独的解法需 遵循如下规则 :
数字 1-9 在每一行只能出现一次。 数字 1-9 在每一列只能出现一次。 数字 1-9 在每一个以粗实线分隔的 3x3 宫内只能出现一次。(请参考示例图) 数独部分空格内已填入了数字,空白格用 '.' 表示。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 class Solution {public : bool isValid (vector<vector<char >>& grid, int row, int col, int num) int m = grid.size (); int n = grid[0 ].size (); for (int j = 0 ; j < n; j++) { if (grid[row][j] == '0' + num) { return false ; } } for (int i = 0 ; i < m; i++) { if (grid[i][col] == '0' + num) { return false ; } } int start_i = row / 3 * 3 ; int start_j = col / 3 * 3 ; for (int i = start_i; i < start_i + 3 ; i++) { for (int j = start_j; j < start_j + 3 ; j++) { if (grid[i][j] == '0' + num) { return false ; } } } return true ; } bool backtrace (vector<vector<char >>& board) int m = board.size (); int n = board[0 ].size (); for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (board[i][j] != '.' ) { continue ; } for (int num = 1 ; num <= 9 ; num++) { if (isValid (board, i, j, num)) { board[i][j] = '0' + num; if (backtrace (board)) { return true ; } board[i][j] = '.' ; } } return false ; } } return true ; } void solveSudoku (vector<vector<char >>& board) int m = board.size (); int n = board[0 ].size (); backtrace (board); } };
全排列II
给定一个可包含重复数字的序列 nums ,按任意顺序
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : void backtrace (vector<vector<int >>& res, vector<int >& r, vector<bool >& used, vector<int >& nums) if (r.size () == nums.size ()) { res.push_back (r); return ; } for (int i = 0 ; i < nums.size (); i++) { if (i>0 && (nums[i] == nums[i-1 ]) && !used[i-1 ]) { continue ; } if (used[i]) { continue ; } used[i] = true ; r.push_back (nums[i]); backtrace (res, r, used, nums); r.pop_back (); used[i] = false ; } } vector<vector<int >> permuteUnique (vector<int >& nums) { vector<vector<int >> res; vector<int > r; vector<bool > used (nums.size()) ; sort (nums.begin (),nums.end ()); backtrace (res, r, used, nums); return res; } };
N皇后
按照国际象棋的规则,皇后可以攻击与之处在同一行或同一列或同一斜线上的棋子。
n 皇后问题 研究的是如何将 n 个皇后放置在 n×n 的棋盘上,并且使皇后彼此之间不能相互攻击。
给你一个整数 n ,返回所有不同的 n 皇后问题 的解决方案。
每一种解法包含一个不同的 n 皇后问题 的棋子放置方案,该方案中 'Q' 和 '.' 分别代表了皇后和空位。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 class Solution {public : bool isValid (vector<string>& board, int i, int j) int n = board.size (); for (int col = 0 ; col < n; col++) { if (board[i][col] == 'Q' ) { return false ; } } for (int row = 0 ; row < n; row++) { if (board[row][j] == 'Q' ) { return false ; } } for (int row = i, col = j; row >= 0 && col >= 0 ; col--, row--) { if (board[row][col] == 'Q' ) { return false ; } } for (int row = i, col = j; row >= 0 && col < n; col++, row--) { if (board[row][col] == 'Q' ) { return false ; } } return true ; } void backtrace (vector<vector<string>>& res, vector<string>& board, int row) int n = board.size (); if (n == row) { res.push_back (board); return ; } for (int j = 0 ; j < n; j++) { if (isValid (board, row, j)) { board[row][j] = 'Q' ; backtrace (res, board, row + 1 ); board[row][j] = '.' ; } } } vector<vector<string>> solveNQueens (int n) { vector<vector<string>> res; string tmp (n, '.' ) ; vector<string> board (n, tmp) ; backtrace (res, board, 0 ); return res; } };
组合
给定两个整数 n 和 k,返回范围 [1, n] 中所有可能的 k 个数的组合。
你可以按 任何顺序 返回答案。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 class Solution {public : void backtrace (vector<vector<int >>& res, int n, vector<int >& r, int idx, int cnt, int k) if (cnt == k) { res.push_back (r); return ; } for (int i = idx; cnt+n-i+1 >=k; i++) { r.push_back (i); backtrace (res, n, r, i + 1 , cnt + 1 , k); r.pop_back (); } } vector<vector<int >> combine (int n, int k) { vector<vector<int >> res; vector<int > r; backtrace (res, n, r, 1 , 0 , k); return res; } };
子集II
给你一个整数数组 nums ,其中可能包含重复元素,请你返回该数组所有可能的 子集(幂集)。
解集 不能 包含重复的子集。返回的解集中,子集可以按 任意顺序 排列。
在递归时,若发现没有选择上一个数,且当前数字与上一个数相同,则可以跳过当前生成的子集
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution {public : void backtrace (vector<vector<int >>& res, vector<int >& r, vector<int >& nums, int idx, vector<bool >& used) res.push_back (r); int sz = nums.size (); for (int i = idx; i < sz; i++) { if (i > 0 && nums[i] == nums[i - 1 ] && used[i - 1 ] == false ) { continue ; } used[i] = true ; r.push_back (nums[i]); backtrace (res, r, nums, i + 1 , used); r.pop_back (); used[i] = false ; } } vector<vector<int >> subsetsWithDup (vector<int >& nums) { int sz = nums.size (); vector<bool > used (sz) ; vector<vector<int >> res; vector<int > r; sort (nums.begin (),nums.end ()); backtrace (res, r, nums, 0 , used); return res; } };
黄金矿工
你要开发一座金矿,地质勘测学家已经探明了这座金矿中的资源分布,并用大小为 m * n 的网格 grid 进行了标注。每个单元格中的整数就表示这一单元格中的黄金数量;如果该单元格是空的,那么就是 0。
为了使收益最大化,矿工需要按以下规则来开采黄金:
每当矿工进入一个单元,就会收集该单元格中的所有黄金。 矿工每次可以从当前位置向上下左右四个方向走。 每个单元格只能被开采(进入)一次。 不得开采 (进入)黄金数目为 0 的单元格。矿工可以从网格中 任意一个 有黄金的单元格出发或者是停止。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 class Solution {public : int res{}; vector<pair<int , int >> dirs = {{0 , 1 }, {0 , -1 }, {1 , 0 }, {-1 , 0 }}; void backtrace (vector<vector<int >>& grid, int x, int y, int val) res = max (res, val); int m = grid.size (); int n = grid[0 ].size (); for (auto & dir : dirs) { int nx = x + dir.first; int ny = y + dir.second; if (nx < 0 || nx >= m || ny < 0 || ny >= n) { continue ; } if (grid[nx][ny] == 0 ) { continue ; } int tmp = grid[nx][ny]; grid[nx][ny] = 0 ; backtrace (grid, nx, ny, val + tmp); grid[nx][ny] = tmp; } } int getMaximumGold (vector<vector<int >>& grid) int m = grid.size (); int n = grid[0 ].size (); for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (grid[i][j] != 0 ) { int val = grid[i][j]; grid[i][j] = 0 ; backtrace (grid, i, j, val); grid[i][j] = val; } } } return res; } };
组合总和IV
给你一个由 不同 整数组成的数组 nums ,和一个目标整数 target 。请你从 nums 中找出并返回总和为 target 的元素排列的个数。题目数据保证答案符合 32 位整数范围。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : int combinationSum4 (vector<int >& nums, int target) vector<long long > dp (target + 1 ,0 ) ; sort (nums.begin (), nums.end ()); dp[0 ] = 1 ; for (int i = 1 ; i <= target; i++) { for (auto n : nums) { if (n <= i && dp[i]+dp[i-n]<=INT_MAX) { dp[i] += dp[i - n]; } } } return dp[target]; } };
回溯算法能解决如下问题:
组合问题:N个数里面按一定规则找出k个数的集合 排列问题:N个数按一定规则全排列,有几种排列方式 切割问题:一个字符串按一定规则有几种切割方式 子集问题:一个N个数的集合里有多少符合条件的子集 棋盘问题:N皇后,解数独等等 多数元素
给定一个大小为 n 的数组 nums ,返回其中的多数元素。多数元素是指在数组中出现次数 大于 ⌊ n/2 ⌋ 的元素。你可以假设数组是非空的,并且给定的数组总是存在多数元素。
摩尔投票法,想象数组中每一个数字都是一个国家的士兵。因为题目保证存在一个“多数元素”(出现次数大于 $n/2$),这意味着这个国家的士兵人数比其他所有国家士兵加起来还要多。
算法规则:
阵地防守 :我们选定一个候选人 candidate,并给他的血量 count 设为 1。遇到盟友 :遍历到下一个数,如果它等于 candidate,血量 count++(阵地加固)。遇到敌人 :如果它不等于 candidate,血量 count--(同归于尽)。阵地失守 :如果 count 减到了 0,说明当前的候选人已经被耗尽了。我们立即更换当前遍历到的数字为新的 candidate,并将 count 重新设为 1。结论 :由于多数元素的人数超过了一半,即便它和其他所有数字“同归于尽”,最后剩下的那个 candidate 一定就是多数元素。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : int majorityElement (vector<int >& nums) int res{}; int cnt{}; for (auto & n:nums) { if (cnt == 0 ) { res = n; } if (n == res) { cnt++; }else { cnt--; } } return res; } };
求众数II
给定一个大小为n的数组,找出其中所有出现次数超过n/3 次的元素。说明:要求算法的时间复杂度为O(n),空间复杂度为O(1)。
在处理超过 $n/2$ 的问题时,我们只需要 1 个候选人;现在我们要找超过 $n/3$ 的,就得维护 2 个候选人 和 2 个计数器 。
算法规则:
初始化 :选定两个不同的候选人 cand1, cand2,计数器 cnt1, cnt2 均为 0。遍历数组 :如果是老面孔 :如果 num == cand1,则 cnt1++;如果 num == cand2,则 cnt2++。如果是新势力 :如果此时 cnt1 == 0,则让当前数字当 cand1,并设 cnt1 = 1;同理处理 cnt2 == 0 的情况。三方同归于尽 :如果当前数字既不是 cand1 也不是 cand2,且两个阵地都有人,那么当前数字与两个候选人同时各消耗 1 个血量 (即 cnt1--, cnt2--)。最终验证 :由于题目不保证这两个候选人一定超过 $n/3$,所以最后必须再遍历一遍数组,核实这两个人的实际出现次数。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : vector<int > majorityElement (vector<int >& nums) { int n = nums.size (); int cand1 = 0 , cand2 = 0 ; int cnt1 = 0 , cnt2 = 0 ; for (int num : nums) { if (num == cand1) { cnt1++; } else if (num == cand2) { cnt2++; } else if (cnt1 == 0 ) { cand1 = num; cnt1 = 1 ; } else if (cnt2 == 0 ) { cand2 = num; cnt2 = 1 ; } else { cnt1--; cnt2--; } } cnt1 = 0 ; cnt2 = 0 ; for (int num : nums) { if (num == cand1) cnt1++; else if (num == cand2) cnt2++; } vector<int > res; if (cnt1 > n / 3 ) res.push_back (cand1); if (cnt2 > n / 3 ) res.push_back (cand2); return res; } };
检查一个数在数组中占绝大多数
给出一个按 非递减 顺序排列的数组 nums,和一个目标数值 target。假如数组 nums 中绝大多数元素的数值都等于 target,则返回 True,否则请返回 False。所谓占绝大多数,是指在长度为 N 的数组中出现必须 超过 N/2 次
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : int lower_bound (vector<int >& nums,int target) int left = 0 ,right = nums.size (); while (left<right) { int mid = (right-left)/2 +left; if (nums[mid]>=target) { right = mid; }else { left = mid+1 ; } } return right; } bool isMajorityElement (vector<int >& nums, int target) int idx = lower_bound (nums,target); int lastPos = idx+nums.size ()/2 ; if (lastPos<nums.size () && nums[lastPos] == target) { return true ; } return false ; } };
柱状图中最大的矩形
给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。求在该柱状图中,能够勾勒出来的矩形的最大面积。
核心思路:寻找左右边界.对于任何一根柱子 $i$,如果以它的高度 $h_i$ 作为矩形的高度 ,那么这个矩形能向左右延伸多远呢?
左边界 :左边第一个比 $h_i$ 矮 的柱子位置。右边界 :右边第一个比 $h_i$ 矮 的柱子位置。如果我们能为每一根柱子快速找到这两个边界,面积就等于 $h_i \times (右边界 - 左边界 - 1)$。
为什么使用单调栈?单调栈能以 $O(n)$ 的时间复杂度找到所有元素的“左右第一个更小值”。
算法逻辑:
维护一个单调递增栈 :栈中存放的是柱子的下标 。遍历柱子 :如果当前柱子高度 $\ge$ 栈顶柱子高度:入栈。 如果当前柱子高度 $<$ 栈顶柱子高度:说明找到了栈顶柱子的右边界 (即当前柱子)。 弹出栈顶元素,记录其高度为 $h$。 弹出后的新栈顶就是该柱子的左边界 。 计算面积并更新最大值。 技巧:哨兵节点 :在原高度数组的前后各加一个高度为 0 的柱子。前面的 0 避免空栈判断,后面的 0 确保遍历结束时栈内所有元素都能被弹出计算。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 class Solution {public : int largestRectangleArea (vector<int >& heights) stack<int > stk; heights.insert (heights.begin (), 0 ); heights.push_back (0 ); int res{}; for (int i = 0 ; i < heights.size (); i++) { while (!stk.empty () && heights[i] < heights[stk.top ()]) { int curHeight = heights[stk.top ()]; stk.pop (); res = max (res, curHeight * (i - 1 - stk.top ())); } stk.push (i); } return res; } };
每日温度
下一个更大的元素I
接雨水
最大矩形
给定一个仅包含 0 和 1 、大小为 rows x cols 的二维二进制矩阵,找出只包含 1 的最大矩形,并返回其面积。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : int maximalRectangle (vector<vector<char >>& matrix) int m = matrix.size (); int n = matrix[0 ].size (); vector<vector<int >> row (m, vector <int >(n)); for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (matrix[i][j] == '1' ) { if (j == 0 ) { row[i][j] = 1 ; } else { row[i][j] = 1 + row[i][j - 1 ]; } } } } int res{}; for (int j = 0 ; j < n; j++) { stack<int > stk; vector<int > left (m) ; vector<int > right (m,m) ; for (int i = 0 ; i < m; i++) { while (!stk.empty () && row[stk.top ()][j] > row[i][j]) { right[stk.top ()] = i; stk.pop (); } if (!stk.empty ()) { left[i] = stk.top (); }else { left[i] = -1 ; } stk.push (i); } for (int i = 0 ; i < m; i++) { int h = row[i][j]; res = max (res, h * (right[i] - left[i] - 1 )); } } return res; } };
一周中的第几天
给你一个日期,请你设计一个算法来判断它是对应一周中的哪一天。输入为三个整数:day、month 和 year,分别表示日、月、年。
您返回的结果必须是这几个值中的一个 {"Sunday", "Monday", "Tuesday", "Wednesday", "Thursday", "Friday", "Saturday"}。
注意 :1971 年 1 月 1 日是星期五。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 class Solution {public : bool isLeapYear (int year) if (year % 400 == 0 ) { return true ; } if (year % 4 == 0 && year % 100 != 0 ) { return true ; } return false ; } string dayOfTheWeek (int day, int month, int year) { int startYear = 1971 ; int leaps{}; while (startYear < year) { if (isLeapYear (startYear)) { leaps++; } startYear++; } int cnt = (year - 1971 ) * 365 + leaps; int daysOfMonth[] = {0 , 31 , 28 , 31 , 30 , 31 , 30 , 31 , 31 , 30 , 31 , 30 , 31 }; int start_month{1 }; int monthDays{}; while (start_month < month) { if (start_month == 2 ) { if (isLeapYear (year)) { monthDays++; } } monthDays += daysOfMonth[start_month]; start_month++; } int res = cnt + monthDays + day - 1 ; string weekDay[] = { "Friday" , "Saturday" , "Sunday" , "Monday" , "Tuesday" , "Wednesday" , "Thursday" , }; return weekDay[res % 7 ]; } };
水壶问题
有两个水壶,容量分别为 x 和 y 升。水的供应是无限的。确定是否有可能使用这两个壶准确得到 target 升。
你可以:
装满任意一个水壶 清空任意一个水壶 将水从一个水壶倒入另一个水壶,直到接水壶已满,或倒水壶已空。 贝祖定理:简单来说,如果你有两个整数 $a$ 和 $b$,贝祖定理告诉你,你一定能找到另外两个整数 $x$ 和 $y$,使得它们的某种“组合”恰好等于它们的最大公约数。
对于不全为零的整数 $a$ 和 $b$,设 $d = \text{gcd}(a, b)$,则:
必然存在整数 $x$ 和 $y$,使得:
更进一步,对于任何整数 $z$,$ax + by = z$ 有整数解的充分必要条件 是:$z$ 是 $d$ 的倍数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution {public : int gcd (int x, int y) return (y == 0 ) ? x : gcd (y, x % y); } bool canMeasureWater (int x, int y, int target) if (target>x+y) { return false ; } int g = gcd (x, y); if (target % g == 0 ) { return true ; } return false ; } };
虽然定理保证了 $x$ 和 $y$ 存在,但它没直接告诉你它们是谁。在实际操作中,我们使用扩展欧几里得算法(Extended Euclidean Algorithm) 来反向推导。
核心步骤:
先用普通的欧几里得算法(辗转相除法)算出 $d$。 将除法过程中的余数逐层反向代入,最终凑出 $ax + by = d$ 的形式。 重要的推论:互质的情况,如果 $a$ 和 $b$ 互质 (即 $\text{gcd}(a, b) = 1$),那么:必然存在整数 $x$ 和 $y$,使得 $ax + by = 1$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 int extended_gcd (int a, int b, int &x, int &y) if (b == 0 ) { x = 1 ; y = 0 ; return a; } int d = extended_gcd (b, a % b, y, x); y -= (a / b) * x; return d; }
可怜的小猪
有buckets 桶液体,其中 正好有一桶 含有毒药,其余装的都是水。它们从外观看起来都一样。为了弄清楚哪只水桶含有毒药,你可以喂一些猪喝,通过观察猪是否会死进行判断。不幸的是,你只有 minutesToTest 分钟时间来确定哪桶液体是有毒的。
喂猪的规则如下:
选择若干活猪进行喂养 可以允许小猪同时饮用任意数量的桶中的水,并且该过程不需要时间。 小猪喝完水后,必须有 minutesToDie 分钟的冷却时间。在这段时间里,你只能观察,而不允许继续喂猪。 过了 minutesToDie 分钟后,所有喝到毒药的猪都会死去,其他所有猪都会活下来。 重复这一过程,直到时间用完。 给你桶的数目 buckets ,minutesToDie 和 minutesToTest ,返回 在规定时间内判断哪个桶有毒所需的 最小 猪数 。
核心思路:猪的状态与实验轮数
首先,我们需要算出总共能进行多少轮实验。
设 $T = \lfloor \text{minutesToTest} / \text{minutesToDie} \rfloor$。
对于一头小猪,在整个实验结束时,它可能处于以下 $T + 1$ 种状态 :
在第 1 轮实验后死去。
在第 2 轮实验后死去。
…
T. 在第 $T$ 轮实验后死去。
T+1. 实验全部结束,它依然活着。
关键直觉 :如果有 $p$ 头小猪,每头猪有 $T+1$ 种可能的状态,那么这 $p$ 头猪组合起来一共可以表示 $(T+1)^p$ 种不同的状态。
每一种“状态组合”都可以对应一桶水。为了能够从 buckets 桶水中定位出那一桶毒药,小猪们能表示的总状态数必须大于或等于桶数:
我们的目标是求最小的整数 $p$。对等式两边取对数:
所以,$p = \lceil \log_{T+1}(\text{buckets}) \rceil$。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : int poorPigs (int buckets, int minutesToDie, int minutesToTest) int rounds = minutesToTest / minutesToDie; int states = rounds + 1 ; int pigs = 0 ; long long max_buckets = 1 ; while (max_buckets < buckets) { max_buckets *= states; pigs++; } return pigs; } };
字符串模拟 。要攻克它们,我建议你按这个分级练习路径 来:
第一关:入门级(固定映射)
LC 13. 罗马数字转整数 :练习基本的哈希映射。LC 12. 整数转罗马数字 :练习贪心凑数思想。第二关:进阶级(带有进制逻辑)
LC 168. Excel表列名称 :理解 26 进制与偏移量的关系(这是你之前刚看过的)。LC 171. Excel表列序号 :反向模拟。第三关:大模拟级(细节控)
LC 8. 字符串转换整数 (atoi) :练习处理空格、正负号、边界溢出(面试高频)。LC 43. 字符串相乘 :练习手写竖式计算,理解大数处理逻辑。第四关:终极 Boss
LC 273. 整数转换英文表示 :这就是你现在的目标。LC 68. 文本左右对齐 :字符串模拟题的“噩梦”整数转换英文表示
将非负整数 num 转换为其对应的英文表示。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 class Solution {public : vector<string> tens = {"" , "Ten" , "Twenty" , "Thirty" , "Forty" , "Fifty" , "Sixty" , "Seventy" , "Eighty" , "Ninety" }; vector<string> singles = {"" , "One" , "Two" , "Three" , "Four" , "Five" , "Six" , "Seven" , "Eight" , "Nine" , "Ten" , "Eleven" , "Twelve" , "Thirteen" , "Fourteen" , "Fifteen" , "Sixteen" , "Seventeen" , "Eighteen" , "Nineteen" }; vector<string> units = {"" , "Thousand" , "Million" , "Billion" }; string helper (int num) { if (num == 0 ) { return "" ; } else if (num < 20 ) { return singles[num] + " " ; } else if (num < 100 ) { return tens[num / 10 ] + " " + helper (num % 10 ); } else { return singles[num / 100 ] + " Hundred " + helper (num % 100 ); } } string numberToWords (int num) { if (num == 0 ) { return "Zero" ; } string res; int i{}; while (num) { if (num % 1000 ) { res = helper (num % 1000 ) + units[i] + " " + res; } num /= 1000 ; i++; } while (!res.empty () && res.back () == ' ' ) { res.pop_back (); } return res; } };
汉字数字转阿拉伯数字
处理它的核心思路是:分权累加,遇“大单位”结算 。
核心逻辑:
映射表 :准备好数字(一:1)和单位(十:10, 百:100, 万:10000)。
状态变量 :
section_sum: 当前小节(万以下)的累加和。total_sum: 最终的总和。temp_val: 当前读到的数字。遍历规则 :
读到数字 :存入 temp_val。 读到小单位 (十、百、千):用 temp_val 乘以单位,加进 section_sum。 读到大单位 (万、亿):将 section_sum 加上 temp_val 后,整体乘以大单位,并入 total_sum,然后清空 section_sum。 汉字数字的逻辑是“权重累加” 。核心在于区分:
小单位 (十、百、千):仅修饰前一个数字。大单位 (万、亿):修饰前面整整一截数字。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 #include <iostream> #include <string> #include <unordered_map> long long cnToAr (std::u16string s) std::unordered_map<char16_t , int > digits = { {u'零' , 0 }, {u'一' , 1 }, {u'二' , 2 }, {u'三' , 3 }, {u'四' , 4 }, {u'五' , 5 }, {u'六' , 6 }, {u'七' , 7 }, {u'八' , 8 }, {u'九' , 9 } }; std::unordered_map<char16_t , long long > units = { {u'十' , 10 }, {u'百' , 100 }, {u'千' , 1000 }, {u'万' , 10000 }, {u'亿' , 100000000 } }; long long total = 0 ; long long section = 0 ; long long num = 0 ; for (char16_t ch : s) { if (digits.count (ch)) { num = digits[ch]; } else if (units.count (ch)) { long long unit = units[ch]; if (unit == 10000 || unit == 100000000 ) { section = (section + num) * unit; total += section; section = 0 ; } else { if (num == 0 && unit == 10 ) num = 1 ; section += num * unit; } num = 0 ; } } return total + section + num; }
处理亿万级别
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 #include <iostream> #include <string> #include <unordered_map> using namespace std;class Solution { inline static const unordered_map<char16_t , long long > vals = { {u'零' , 0 }, {u'一' , 1 }, {u'二' , 2 }, {u'三' , 3 }, {u'四' , 4 }, {u'五' , 5 }, {u'六' , 6 }, {u'七' , 7 }, {u'八' , 8 }, {u'九' , 9 } }; inline static const unordered_map<char16_t , long long > units = { {u'十' , 10 }, {u'百' , 100 }, {u'千' , 1000 } }; inline static const unordered_map<char16_t , long long > segments = { {u'万' , 10000 }, {u'亿' , 100000000 } }; public : long long chineseNumsToArabicNums (u16string s) long long res = 0 ; long long section = 0 ; long long val = 0 ; for (char16_t ch : s) { if (vals.count (ch)) { val = vals.at (ch); } else if (units.count (ch)) { long long unit = units.at (ch); if (val == 0 && unit == 10 ) val = 1 ; section += val * unit; val = 0 ; } else if (segments.count (ch)) { long long segUnit = segments.at (ch); section = (section + val) * segUnit; if (segUnit == 100000000 ) { res += section; section = 0 ; } else { } val = 0 ; } else { val = 0 ; } } return res + section + val; } };
阿拉伯数字转汉字数字
反过来的核心逻辑是“四位一组” 。中国数字是每 4 位(一个“万”)进一级,而不是英文的每 3 位。
处理重点:
零的处理 :中间连续的 0 只读一个“零”(如 1005 $\rightarrow$ 一千零五)。末尾的零 :每组末尾的 0 不读(如 120 $\rightarrow$ 一百二十)。整数转罗马数字
罗马数字是通过添加从最高到最低的小数位值的转换而形成的。将小数位值转换为罗马数字有以下规则:
如果该值不是以 4 或 9 开头,请选择可以从输入中减去的最大值的符号,将该符号附加到结果,减去其值,然后将其余部分转换为罗马数字。 如果该值以 4 或 9 开头,使用 减法形式 ,表示从以下符号中减去一个符号,例如 4 是 5 (V) 减 1 (I): IV ,9 是 10 (X) 减 1 (I):IX。仅使用以下减法形式:4 (IV),9 (IX),40 (XL),90 (XC),400 (CD) 和 900 (CM)。 只有 10 的次方(I, X, C, M)最多可以连续附加 3 次以代表 10 的倍数。你不能多次附加 5 (V),50 (L) 或 500 (D)。如果需要将符号附加4次,请使用 减法形式 。 给定一个整数,将其转换为罗马数字。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : string intToRoman (int num) { vector<pair<int , string>> vecs = { {1000 , "M" }, {900 , "CM" }, {500 , "D" }, {400 , "CD" }, {100 , "C" }, {90 , "XC" }, {50 , "L" }, {40 , "XL" }, {10 , "X" }, {9 , "IX" }, {5 , "V" }, {4 , "IV" }, {1 , "I" }}; string res; for (auto & p : vecs) { while (num >= p.first) { num -= p.first; res += p.second; } if (num == 0 ) break ; } return res; } };
罗马字转整数
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : int romanToInt (string s) unordered_map<char , int > umap = { {'I' , 1 }, {'V' , 5 }, {'X' , 10 }, {'L' , 50 }, {'C' , 100 }, {'D' , 500 }, {'M' , 1000 }, }; int res{}; for (int i = 0 ; i < s.size (); i++) { if (i < s.size () - 1 && umap[s[i]] < umap[s[i + 1 ]]) { res -= umap[s[i]]; } else { res += umap[s[i]]; } } return res; } };
Excel表列名称
给你一个整数 columnNumber ,返回它在 Excel 表中相对应的列名称。
例如:
1 2 3 4 5 6 7 8 A -> 1 B -> 2 C -> 3 ... Z -> 26 AA -> 27 AB -> 28 ...
1 2 3 4 5 6 7 8 9 10 11 12 13 class Solution {public : string convertToTitle (int columnNumber) { string res{}; while (columnNumber) { columnNumber--; char ch = ('A' + (columnNumber % 26 )); res = ch + res; columnNumber /= 26 ; } return res; } };
表列序号
给你一个字符串 columnTitle ,表示 Excel 表格中的列名称。返回 该列名称对应的列序号 。
1 2 3 4 5 6 7 8 9 10 class Solution {public : int titleToNumber (string columnTitle) int res{}; for (auto & ch : columnTitle) { res = res * 26 + (ch - 'A' + 1 ); } return res; } };
字符串转换整数
请你来实现一个 myAtoi(string s) 函数,使其能将字符串转换成一个 32 位有符号整数。
函数 myAtoi(string s) 的算法如下:
空格: 读入字符串并丢弃无用的前导空格(" ")符号: 检查下一个字符(假设还未到字符末尾)为 '-' 还是 '+'。如果两者都不存在,则假定结果为正。转换: 通过跳过前置零来读取该整数,直到遇到非数字字符或到达字符串的结尾。如果没有读取数字,则结果为0。舍入: 如果整数数超过 32 位有符号整数范围 [−231, 231 − 1] ,需要截断这个整数,使其保持在这个范围内。具体来说,小于 −231 的整数应该被舍入为 −231 ,大于 231 − 1 的整数应该被舍入为 231 − 1 。返回整数作为最终结果
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : int myAtoi (string s) int idx{}; while (idx < s.size ()) { if (s[idx] == ' ' ) { idx++; continue ; } else { break ; } } bool neg{}; if (s[idx] == '-' ) { idx++; neg = true ; } else if (s[idx] == '+' ) { idx++; } int num{}; for (int i = idx; i < s.size (); i++) { if (s[i] < '0' || s[i] > '9' ) { break ; } if (num > INT_MAX / 10 || ((num == INT_MAX / 10 )&& (s[i]-'0' ) > INT_MAX % 10 )) { return neg ? INT_MIN : INT_MAX; } num = num * 10 + (s[i] - '0' ); } return neg ? -num : num; } };
为什么溢出判断是 INT_MAX / 10?
这是这道题最容易写错的地方。
INT_MAX 是 2147483647 。假设当前 res 是 214748364 :如果你下一位 digit 是 8 ,那么 214748364 * 10 + 8 就会变成 2147483648 ,这已经超过了 INT_MAX。 所以,如果 res > 214748364,或者 res == 214748364 且 digit > 7,我们就直接根据正负号返回最大值或最小值。 字符串相乘
给定两个以字符串形式表示的非负整数 num1 和 num2,返回 num1 和 num2 的乘积,它们的乘积也表示为字符串形式。注意: 不能使用任何内置的 BigInteger 库或直接将输入转换为整数。
我们可以把乘法拆解为每一位的乘积。假设 num1 长度为 $m$,num2 长度为 $n$:
结果长度 :$num1 \times num2$ 的积,其位数最多为 $m + n$(例如 $99 \times 99 = 9801$,$2+2=4$ 位)。
下标映射(关键) :
如果我们从右往左遍历:
num1[i] 与 num2[j] 相乘的结果 mul。mul 的低位 会累加到结果数组的下标 i + j + 1。mul 的高位(进位) 会累加到结果数组的下标 i + j。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 #include <iostream> #include <vector> #include <string> using namespace std;class Solution {public : string multiply (string num1, string num2) { if (num1 == "0" || num2 == "0" ) return "0" ; int m = num1. size (), n = num2. size (); vector<int > res (m + n, 0 ) ; for (int i = m - 1 ; i >= 0 ; i--) { for (int j = n - 1 ; j >= 0 ; j--) { int mul = (num1[i] - '0' ) * (num2[j] - '0' ); int sum = mul + res[i + j + 1 ]; res[i + j + 1 ] = sum % 10 ; res[i + j] += sum / 10 ; } } string ans = "" ; for (int i = 0 ; i < res.size (); i++) { if (ans.empty () && res[i] == 0 ) continue ; ans += to_string (res[i]); } return ans.empty () ? "0" : ans; } };
模拟竖式乘法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 class Solution {public : string add (string num1, string num2) { int i = num1. size () - 1 ; int j = num2. size () - 1 ; string r; int car{}; while (i >= 0 || j >= 0 ) { int val = ((i >= 0 ) ? (num1[i] - '0' ) : 0 ) + ((j >= 0 ) ? (num2[j] - '0' ) : 0 ) + car; car = val / 10 ; r = to_string (val % 10 ) + r; i--; j--; } if (car) { r = "1" + r; } return r; } string multiply (string num1, string num2) { if (num1 == "0" || num2 == "0" ) { return "0" ; } string res = "0" ; for (int i = num1. size () - 1 ; i >= 0 ; i--) { char & ch1 = num1[i]; string r{}; int car{}; for (int j = num2. size () - 1 ; j >= 0 ; j--) { char & ch2 = num2[j]; int val = car + (ch1 - '0' ) * (ch2 - '0' ); car = val / 10 ; val = val % 10 ; r = to_string (val) + r; } if (car) { r = to_string (car) + r; } int offset = num1. size () - 1 - i; r += string (offset, '0' ); res = add (r, res); } return res; } };
KMP
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 class Solution {public : void getNext (int * next, const string& s) int j = -1 ; next[0 ] = j; for (int i = 1 ; i < s.size (); i++) { while (j >= 0 && s[i] != s[j + 1 ]) { j = next[j]; } if (s[i] == s[j + 1 ]) { j++; } next[i] = j; } } int strStr (string haystack, string needle) if (needle.size () == 0 ) { return 0 ; } vector<int > next (needle.size()) ; getNext (&next[0 ], needle); int j = -1 ; for (int i = 0 ; i < haystack.size (); i++) { while (j >= 0 && haystack[i] != needle[j + 1 ]) { j = next[j]; } if (haystack[i] == needle[j + 1 ]) { j++; } if (j == (needle.size () - 1 ) ) { return (i - needle.size () + 1 ); } } return -1 ; } };
合并有序链表
将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 class Solution {public : ListNode* mergeTwoLists (ListNode* list1, ListNode* list2) { ListNode* dummy = new ListNode; ListNode* cur = dummy; while (list1 && list2) { if (list1->val < list2->val) { cur->next = list1; list1 = list1->next; } else { cur->next = list2; list2 = list2->next; } cur = cur->next; } if (list1) { cur->next = list1; } if (list2) { cur->next = list2; } return dummy->next; } };
排序链表
给你链表的头结点 head ,请将其按 升序 排列并返回 排序后的链表 。
归并排序链表可以分为三个步骤:
切分(Split) :使用快慢指针 找到链表的中点,将链表断开成左右两部分。递归(Recursive Sort) :递归地对左右两部分进行排序。合并(Merge) :将两个有序的小链表合并成一个大的有序链表(类似于“合并两个有序链表”)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 class Solution {public : ListNode* sortList (ListNode* head) { if (!head || !head->next) return head; ListNode* mid = getMid (head); ListNode* rightHead = mid->next; mid->next = nullptr ; ListNode* left = sortList (head); ListNode* right = sortList (rightHead); return merge (left, right); } private : ListNode* getMid (ListNode* head) { ListNode *slow = head, *fast = head->next; while (fast && fast->next) { slow = slow->next; fast = fast->next->next; } return slow; } ListNode* merge (ListNode* l1, ListNode* l2) { ListNode dummy (0 ) ; ListNode* tail = &dummy; while (l1 && l2) { if (l1->val < l2->val) { tail->next = l1; l1 = l1->next; } else { tail->next = l2; l2 = l2->next; } tail = tail->next; } tail->next = l1 ? l1 : l2; return dummy.next; } };
反转链表
给你单链表的头节点 head ,请你反转链表,并返回反转后的链表。
1 2 3 4 5 6 7 8 ListNode* reverseNode (ListNode* node, ListNode* prev = nullptr ) { if (node == nullptr ) { return prev; } ListNode* n = node->next; node->next = prev; return reverseNode (n, node); }
反转链表II
给你单链表的头指针 head 和两个整数 left 和 right ,其中 left <= right 。请你反转从位置 left 到位置 right 的链表节点,返回 反转后的链表 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 class Solution {public : ListNode* reverseNode (ListNode* node, ListNode* prev = nullptr ) { if (node == nullptr ) { return prev; } ListNode* n = node->next; node->next = prev; return reverseNode (n, node); } ListNode* reverseBetween (ListNode* head, int left, int right) { ListNode* dummy = new ListNode; dummy->next = head; ListNode* cur = dummy; left--; while (left--) { cur = cur->next; } ListNode* pre = cur; cur = dummy; while (right--) { cur = cur->next; } ListNode* rightNode = cur; ListNode* tail = rightNode->next; rightNode->next = nullptr ; ListNode* start = pre->next; pre->next = reverseNode (pre->next); start->next = tail; return dummy->next; } };
删除链表的倒数第 N 个结点
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : ListNode* removeNthFromEnd (ListNode* head, int n) { ListNode* dummy = new ListNode; dummy->next = head; ListNode *slow = dummy, *fast = dummy; while (n--) { fast = fast->next; } while (fast && fast->next) { fast = fast->next; slow = slow->next; } slow->next = slow->next->next; return dummy->next; } };
回文链表
给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : ListNode* getPreMidNode (ListNode* node) { if (!node) { return nullptr ; } ListNode *slow = node, *fast = node; while (fast->next && fast->next->next) { fast = fast->next->next; slow = slow->next; } return slow; } ListNode* reverseNode (ListNode* node, ListNode* prev = nullptr ) { if (!node) { return prev; } ListNode* next_node = node->next; node->next = prev; return reverseNode (next_node, node); } bool isPalindrome (ListNode* head) ListNode* preNode = getPreMidNode (head); ListNode* mid = preNode->next; preNode->next = nullptr ; mid = reverseNode (mid); ListNode* cur = head; while (cur && mid) { if (cur->val != mid->val) { return false ; } cur = cur->next; mid = mid->next; } return true ; } };
链表的中间节点
给你单链表的头结点 head ,请你找出并返回链表的中间结点。如果有两个中间结点,则返回第二个中间结点
1 2 3 4 5 6 7 8 9 10 11 class Solution {public : ListNode* middleNode (ListNode* head) { ListNode* slow = head,*fast = head; while (fast && fast->next) { fast = fast->next->next; slow = slow->next; } return slow; } };
删除链表的中间节点
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution {public : ListNode* deleteMiddle (ListNode* head) { ListNode* dummy = new ListNode; dummy->next = head; ListNode *slow = dummy, *fast = head; while (fast && fast->next) { fast = fast->next->next; slow = slow->next; } slow->next = slow->next->next; return dummy->next; } };
重排链表
给定一个单链表 L 的头节点 head ,单链表 L 表示为:
1 L0 → L1 → … → Ln - 1 → Ln
请将其重新排列后变为:
1 L0 → Ln → L1 → Ln - 1 → L2 → Ln - 2 → …
不能只是单纯的改变节点内部的值,而是需要实际的进行节点交换。
寻找链表中点 + 链表逆序 + 合并链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 class Solution {public : void reorderList (ListNode* head) if (!head || !head->next || !head->next->next) return ; ListNode *slow = head, *fast = head; while (fast->next && fast->next->next) { slow = slow->next; fast = fast->next->next; } ListNode* mid = slow; ListNode* l2 = mid->next; mid->next = nullptr ; l2 = reverseList (l2); ListNode* l1 = head; while (l1 && l2) { ListNode* next1 = l1->next; ListNode* next2 = l2->next; l1->next = l2; l2->next = next1; l1 = next1; l2 = next2; } } private : ListNode* reverseList (ListNode* head) { ListNode* prev = nullptr ; ListNode* curr = head; while (curr) { ListNode* nextTemp = curr->next; curr->next = prev; prev = curr; curr = nextTemp; } return prev; } };
环形链表
给你一个链表的头节点 head ,判断链表中是否有环。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos 不作为参数进行传递 。仅仅是为了标识链表的实际情况。
如果链表中存在环 ,则返回 true 。 否则,返回 false 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution {public : bool hasCycle (ListNode *head) ListNode* slow = head,*fast = head; while (fast && fast->next) { slow = slow->next; fast = fast->next->next; if (slow == fast) { return true ; } } return false ; } };
环形链表II 给定一个链表,返回链表开始入环的第一个节点。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : ListNode *detectCycle (ListNode *head) { ListNode* slow= head,*fast = head; while (fast && fast->next) { slow = slow->next; fast = fast->next->next; if (slow == fast) { ListNode* cur = head; while (cur!=slow) { cur = cur->next; slow = slow->next; } return cur; } } return nullptr ; } };
相交链表
给定两个单链表的头节点 headA 和 headB ,请找出并返回两个单链表相交的起始节点。如果两个链表没有交点,返回 null
1 2 3 4 5 6 7 8 9 10 11 class Solution {public : ListNode *getIntersectionNode (ListNode *headA, ListNode *headB) { ListNode* cur1 = headA,*cur2 = headB; while (cur1!=cur2) { cur1 = (cur1 == nullptr )? headB:cur1->next; cur2 = (cur2 == nullptr )? headA:cur2->next; } return cur1; } };
链表最大孪生和
在一个大小为 n 且 n 为 偶数 的链表中,对于 0 <= i <= (n / 2) - 1 的 i ,第 i 个节点(下标从 0 开始)的孪生节点为第 (n-1-i) 个节点 。
比方说,n = 4 那么节点 0 是节点 3 的孪生节点,节点 1 是节点 2 的孪生节点。这是长度为 n = 4 的链表中所有的孪生节点。 孪生和 定义为一个节点和它孪生节点两者值之和。
给你一个长度为偶数的链表的头节点 head ,请你返回链表的 最大孪生和 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Solution {public : ListNode* midNode (ListNode* node) { ListNode *slow = node, *fast = node; while (fast && fast->next) { fast = fast->next->next; slow = slow->next; } return slow; } ListNode* revereNode (ListNode* node) { ListNode* prev{}; while (node) { ListNode* n = node->next; node->next = prev; prev = node; node = n; } return prev; } int pairSum (ListNode* head) ListNode* mid = midNode (head); ListNode* l=revereNode (mid); int max_val{INT_MIN}; while (head && l) { max_val = max (max_val,head->val+l->val); head = head->next; l = l->next; } return max_val; } };
K 个一组翻转链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 class Solution {public : ListNode* reverseKGroup (ListNode* head, int k) { ListNode* dummy = new ListNode (0 ); dummy->next = head; ListNode* prev = dummy; ListNode* end = dummy; while (end->next != nullptr ) { for (int i = 0 ; i < k && end != nullptr ; i++) { end = end->next; } if (end == nullptr ) { break ; } ListNode* start = prev->next; ListNode* nextGroup = end->next; end->next = nullptr ; prev->next = reverseList (start); start->next = nextGroup; prev = start; end = prev; } ListNode* result = dummy->next; delete dummy; return result; } private : ListNode* reverseList (ListNode* head) { ListNode* prev = nullptr ; ListNode* curr = head; while (curr != nullptr ) { ListNode* next = curr->next; curr->next = prev; prev = curr; curr = next; } return prev; } };
两两交换链表中的节点
给你一个链表,两两交换其中相邻的节点,并返回交换后链表的头节点。你必须在不修改节点内部的值的情况下完成本题(即,只能进行节点交换)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : ListNode* swapPairs (ListNode* head) { if (!head) { return nullptr ; } ListNode* dummy = new ListNode; dummy->next = head; ListNode* pre = dummy; ListNode* next_node = head; while (next_node && next_node->next) { ListNode* secondNode = next_node->next; pre->next = secondNode; next_node->next = secondNode->next; secondNode->next = next_node; pre = next_node; next_node = pre->next; } return dummy->next; } };
递归,递归的终止条件是链表中没有节点,或者链表中只有一个节点,此时无法进行交换。
递归过程 :
设当前头节点为 head,下一个节点为 next。 head 的下一个节点应该是“后续所有节点两两交换后”的结果。next 的下一个节点指向当前的 head。返回 next 作为这部分交换后的新头节点。 1 2 3 4 5 6 7 8 9 10 11 12 class Solution {public : ListNode* swapPairs (ListNode* head) { if (head == nullptr || head->next == nullptr ) { return head; } ListNode* newHead = head->next; head->next = swapPairs (newHead->next); newHead->next = head; return newHead; } };
交换链表中的节点
给你链表的头节点 head 和一个整数 k 。
交换 链表正数第 k 个节点和倒数第 k 个节点的值后,返回链表的头节点(链表 从 1 开始索引 )
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : ListNode* swapNodes (ListNode* head, int k) { ListNode *slow = head, *fast = head; k--; while (k--) { fast = fast->next; } ListNode* node1 = fast; while (fast && fast->next) { fast = fast->next; slow = slow->next; } ListNode* node2 = slow; swap (node1->val,node2->val); return head; } };
翻转偶数长度组的节点
给你一个链表的头节点 head 。
链表中的节点 按顺序 划分成若干 非空 组,这些非空组的长度构成一个自然数序列(1, 2, 3, 4, ...)。一个组的 长度 就是组中分配到的节点数目。换句话说:
节点 1 分配给第一组 节点 2 和 3 分配给第二组 节点 4、5 和 6 分配给第三组,以此类推 注意,最后一组的长度可能小于或者等于 1 + 倒数第二组的长度 。
反转 每个 偶数 长度组中的节点,并返回修改后链表的头节点 head
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 class Solution {public : ListNode* reverseEvenLengthGroups (ListNode* head) { ListNode* dummy = new ListNode (0 ); dummy->next = head; ListNode* pre = dummy; ListNode* tail = dummy; int groupSize = 1 ; while (tail->next != nullptr ) { int actualCount = 0 ; for (int i = 0 ; i < groupSize && tail->next != nullptr ; i++) { tail = tail->next; actualCount++; } if (actualCount % 2 == 0 ) { ListNode* groupStart = pre->next; ListNode* nextGroupStart = tail->next; tail->next = nullptr ; ListNode* reversedGroupHead = reverseList (groupStart); pre->next = reversedGroupHead; groupStart->next = nextGroupStart; pre = groupStart; tail = groupStart; } else { pre = tail; } groupSize++; } ListNode* result = dummy->next; delete dummy; return result; } private : ListNode* reverseList (ListNode* head) { ListNode* prev = nullptr ; ListNode* curr = head; while (curr != nullptr ) { ListNode* nextNode = curr->next; curr->next = prev; prev = curr; curr = nextNode; } return prev; } };
删除链表的倒数第N个节点
给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : ListNode* removeNthFromEnd (ListNode* head, int n) { ListNode* dummy = new ListNode; dummy->next = head; ListNode *slow = dummy, *fast = dummy; while (n--) { fast = fast->next; } while (fast && fast->next) { fast = fast->next; slow = slow->next; } slow->next = slow->next->next; return dummy->next; } };
分隔链表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 class Solution {public : vector<ListNode*> splitListToParts (ListNode* head, int k) { int n = 0 ; ListNode* curr = head; while (curr) { n++; curr = curr->next; } int avg_len = n / k; int remainder = n % k; vector<ListNode*> res (k, nullptr ) ; curr = head; for (int i = 0 ; i < k && curr != nullptr ; ++i) { res[i] = curr; int current_part_size = avg_len + (i < remainder ? 1 : 0 ); for (int j = 1 ; j < current_part_size; ++j) { curr = curr->next; } ListNode* next_part_start = curr->next; curr->next = nullptr ; curr = next_part_start; } return res; } };
数根又称数字根(Digital root),是自然数的一种性质,每个自然数都有一个数根。对于给定的自然数,反复将各个位上的数字相加,直到结果为一位数,则该一位数即为原自然数的数根。
计算数根的最直观的方法是模拟计算各位相加的过程,直到剩下的数字是一位数。利用自然数的性质,则能在 O(1) 的时间内计算数根。
给定一个非负整数 num,反复将各个位上的数字相加,直到结果为一位数。返回这个结果。
对 num 分类讨论:
num 不是 9 的倍数时,其数根即为 num 除以 9 的余数。
num 是 9 的倍数时:
如果 num=0,则其数根是 0;
如果 num>0,则各位相加的结果大于 0,其数根也大于 0,因此其数根是
1 2 3 4 5 6 class Solution {public : int addDigits (int num) return (num - 1 ) % 9 + 1 ; } };
丑数
丑数 就是只包含质因数 2、3 和 5 的 正 整数。
给你一个整数 n ,请你判断 n 是否为 丑数 。如果是,返回 true ;否则,返回 false 。
1 2 3 4 5 6 7 8 9 10 11 12 13 class Solution {public : bool isUgly (int n) if (n<=0 ) return false ; vector<int > nums{2 ,3 ,5 }; for (auto & num:nums) { while (n%num==0 ) { n/=num; } } return n==1 ; } };
给你一个整数 n ,请你找出并返回第 n 个 丑数 。丑数 就是质因子只包含 2、3 和 5 的正整数
我们要维护一个有序的丑数列表。假设我们已经有了前几个丑数,下一个丑数一定是:
之前的某个丑数 $\times 2$ 之前的某个丑数 $\times 3$ 之前的某个丑数 $\times 5$ 为了保证列表的有序性,我们每次都选这三个乘积中最小 的那一个。
算法逻辑 :
定义数组 dp,dp[i] 表示第 $i+1$ 个丑数。初始化 dp[0] = 1。 定义三个指针 p2, p3, p5,初始都指向下标 0。 循环 $n-1$ 次:计算 next2 = dp[p2] * 2, next3 = dp[p3] * 3, next5 = dp[p5] * 5。 取三者最小值作为下一个丑数:dp[i] = min(next2, next3, next5)。 关键点 :哪个指针产生的最小值,就把哪个指针向后移一位 。如果多个指针产生的乘积相同(比如 $2 \times 3 = 6$ 和 $3 \times 2 = 6$),则这些指针都要移动 ,以实现去重。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class Solution {public : int nthUglyNumber (int n) vector<int > dp (n) ; dp[0 ] = 1 ; int n2{}, n3{}, n5{}; for (int i = 1 ; i < n; i++) { int p2 = dp[n2] * 2 ; int p3 = dp[n3] * 3 ; int p5 = dp[n5] * 5 ; int min_num = min (min (p2, p3), p5); dp[i] = min_num; if (min_num == p2) { n2++; } if (min_num == p3) { n3++; } if (min_num == p5) { n5++; } } return dp[n - 1 ]; } };
可以把寻找丑数的过程看作是合并三个有序链表 :
链表 1:$1\times2, 2\times2, 3\times2, 4\times2, 5\times2, \dots$ 链表 2:$1\times3, 2\times3, 3\times3, 4\times3, 5\times3, \dots$ 链表 3:$1\times5, 2\times5, 3\times5, 4\times5, 5\times5, \dots$ 由于我们每次都从这三个链表的“头部”取最小值,且“头部”的定义是由 p2, p3, p5 指向的 dp 元素决定的,因此我们能保证生成的 dp 数组是严格递增且不遗漏任何丑数的。
丑数是可以被 a 或 b 或 c 整除的 正整数 。
给你四个整数:n 、a 、b 、c ,请你设计一个算法来找出第 n 个丑数。 二分+容斥原理
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 class Solution {public : long long gcd (int a, int b) return b == 0 ? a : gcd (b, a % b); } long long lcm (int a, int b) return (long long )a / gcd (a, b) * b; } long long count (long long x, long long a, long long b, long long c, long long lcm_ab, long long lcm_ac, long long lcm_bc, long long lcm_abc) return (x / a + x / b + x / c - x / lcm_ab - x / lcm_ac - x / lcm_bc + x / lcm_abc); } int nthUglyNumber (int n, int a, int b, int c) long long lcm_ab = lcm (a, b); long long lcm_ac = lcm (a, c); long long lcm_bc = lcm (c, b); long long lcm_abc = lcm (lcm_ab, c); int left = 1 , right = 2e9 ; while (left < right) { int mid = (right - left) / 2 + left; if (count (mid, a, b, c, lcm_ab, lcm_ac, lcm_bc, lcm_abc) < n) { left = mid + 1 ; } else { right = mid; } } return left; } };
超级丑数 是一个正整数,并满足其所有质因数都出现在质数数组 primes 中。给你一个整数 n 和一个整数数组 primes ,返回第 n 个 超级丑数 。题目数据保证第 n 个 超级丑数 在 32-bit 带符号整数范围内。
定义数组 dp,其中 dp[i] 表示第 i 个超级丑数,第 n 个超级丑数即为 dp[n]。
由于最小的超级丑数是 1,因此 dp[1]=1。
如何得到其余的超级丑数呢?创建与数组 primes 相同长度的数组 pointers,表示下一个超级丑数是当前指针指向的超级丑数乘以对应的质因数。初始时,数组 pointers 的元素值都是 1。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : int nthSuperUglyNumber (int n, vector<int >& primes) vector<long > dp (n + 1 ) ; int m = primes.size (); vector<int > pointers (m, 0 ) ; vector<long > nums (m, 1 ) ; for (int i = 1 ; i <= n; i++) { long minNum = INT_MAX; for (int j = 0 ; j < m; j++) { minNum = min (minNum, nums[j]); } dp[i] = minNum; for (int j = 0 ; j < m; j++) { if (nums[j] == minNum) { pointers[j]++; nums[j] = dp[pointers[j]] * primes[j]; } } } return dp[n]; } };
快乐数
编写一个算法来判断一个数 n 是不是快乐数。
「快乐数」 定义为:
对于一个正整数,每一次将该数替换为它每个位置上的数字的平方和。 然后重复这个过程直到这个数变为 1,也可能是 无限循环 但始终变不到 1。 如果这个过程 结果为 1,那么这个数就是快乐数。 如果 n 是 快乐数 就返回 true ;不是,则返回 false
快慢指针,通过反复调用 getNext(n) 得到的链是一个隐式的链表。隐式意味着我们没有实际的链表节点和指针,但数据仍然形成链表结构。起始数字是链表的头 “节点”,链中的所有其他数字都是节点。next 指针是通过调用 getNext(n) 函数获得。意识到实际有个链表,那么这个问题就可以转换为检测一个链表是否有环 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : int getNext (int num) int res{}; while (num) { res += (num%10 )*(num%10 ); num/=10 ; } return res; } bool isHappy (int n) int slowNum = n,fastNum = getNext (n); while (fastNum!= 1 && fastNum!=slowNum) { slowNum = getNext (slowNum); fastNum = getNext (getNext (fastNum)); } return fastNum == 1 ; } };
加一
给定一个表示 大整数 的整数数组 digits,其中 digits[i] 是整数的第 i 位数字。这些数字按从左到右,从最高位到最低位排列。这个大整数不包含任何前导 0。将大整数加 1,并返回结果的数字数组。
只需要对数组 digits 进行一次逆序遍历,找出第一个不为 9 的元素,将其加一并将后续所有元素置零即可。如果 digits 中所有的元素均为 9,那么对应着「思路」部分的第三种情况,我们需要返回一个新的数组。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : vector<int > plusOne (vector<int >& digits) { int sz =digits.size (); for (int i = sz-1 ;i>=0 ;i--) { if (digits[i]!=9 ) { digits[i] +=1 ; for (int j = i+1 ;j<sz;j++) { digits[j] = 0 ; } return digits; } } vector<int > ans (1 +sz) ; ans[0 ] = 1 ; return ans; } };
给单链表加一
给定一个用链表 表示的非负整数, 然后将这个整数 再加上 1 。
这些数字的存储是这样的:最高位有效的数字位于链表的首位 head 。
算法步骤
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 class Solution {public : ListNode* plusOne (ListNode* head) { ListNode* dummy = new ListNode (0 ); dummy->next = head; ListNode* flag = dummy; while (head) { if (head->val != 9 ) { flag = head; } head = head->next; } flag->val += 1 ; flag = flag->next; while (flag) { flag->val = 0 ; flag = flag->next; } return (dummy->val == 0 )?dummy->next:dummy; } };
数组形式整数加法
整数的 数组形式 num 是按照从左到右的顺序表示其数字的数组。
例如,对于 num = 1321 ,数组形式是 [1,3,2,1] 。 给定 num ,整数的 数组形式 ,和整数 k ,返回 整数 num + k 的 数组形式 。
任何时候,若加法的结果大于等于 10,把进位的 1 加入到下一位的计算中,所以最终结果为 1035。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : vector<int > addToArrayForm (vector<int >& num, int k) { int sz = num.size (); vector<int > ans; for (int i = sz - 1 ; i >= 0 ; i--) { int val = num[i] + k % 10 ; k /= 10 ; k += val / 10 ; ans.push_back (val % 10 ); } while (k>0 ) { ans.push_back (k % 10 ); k /= 10 ; } reverse (ans.begin (),ans.end ()); return ans; } };
将整数减少到零需要的最少操作数
给你一个正整数 n ,你可以执行下述操作 任意 次:
返回使 n 等于 0 需要执行的 最少 操作数。
如果 x == 2i 且其中 i >= 0 ,则数字 x 是 2 的幂。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 class Solution {public : unordered_map<int , int > memo; int dfs (int num) if (memo.count (num)) { return memo[num]; } if ((num & 1 ) == 0 ) { memo[num] = dfs (num >> 1 ); } else { if ((num & 3 ) == 3 ) { memo[num] = 1 + dfs (num + 1 ); } else { memo[num] = 1 + dfs (num - 1 ); } } return memo[num]; } int minOperations (int n) memo[0 ] = 0 ; return dfs (n); } }; class Solution {public : unordered_map<int , int > memo; int dfs (int num) if (memo.count (num)) { return memo[num]; } int r{}; if ((num & (num - 1 )) == 0 ) { r = 1 ; } else { int lb = num & (-num); r = 1 + min (dfs (num + lb), dfs (num - lb)); } memo[num] = r; return r; } int minOperations (int n) memo[0 ] = 0 ; return dfs (n); } };
计算字符串的数字和
给你一个由若干数字(0 - 9)组成的字符串 s ,和一个整数。
如果 s 的长度大于 k ,则可以执行一轮操作。在一轮操作中,需要完成以下工作:
将 s 拆分 成长度为 k 的若干 连续数字组 ,使得前 k 个字符都分在第一组,接下来的 k 个字符都分在第二组,依此类推。注意 ,最后一个数字组的长度可以小于 k 。 用表示每个数字组中所有数字之和的字符串来 替换 对应的数字组。例如,"346" 会替换为 "13" ,因为 3 + 4 + 6 = 13 。 合并 所有组以形成一个新字符串。如果新字符串的长度大于 k 则重复第一步。返回在完成所有轮操作后的 s 。
以模拟题目中的操作过程更新字符串 s,具体在每一轮操作中:
我们用字符串(或数组,视不同语言字符串的实现方式而确定)tmp 来维护该轮操作的结果。随后,我们遍历字符串 s,以每 k 个字符为一组,计算该组的数字和 val,并转化为字符串添加至 tmp 尾部。最终,我们将 s 更新为 tmp 所表示的字符串。
我们执行上述操作直到 s 的长度小于等于 k 为止,并最终返回 s 作为答案。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 class Solution {public : string digitSum (string s, int k) { while (s.size () > k) { string ns; int sz = s.size (); for (int i = 0 ; i < s.size (); i += k) { int num{}; for (int j = i; j < i + k && j < sz; j++) { num += (s[j] - '0' ); } ns += to_string (num); } s = ns; } return s; } };
最短路是图论中的经典问题即:给出一个有向图,一个起点,一个终点,问起点到终点的最短路径。
dijkstra算法:在有权图(权值非负数)中求从起点到其他节点的最短路径算法。
需要注意两点:
dijkstra 算法可以同时求 起点到所有节点的最短路径 权值不能为负数 dijkstra 算法是贪心的思路,不断寻找距离 源点最近的没有访问过的节点。minDist数组 用来记录每一个节点距离源点的最小距离 。
dijkstra三部曲 :
第一步,选源点到哪个节点近且该节点未被访问过 第二步,该最近节点被标记访问过 第三步,更新非访问节点到源点的距离(即更新minDist数组) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 int main () int n, m, p1, p2, val; cin >> n >> m; vector<vector<int >> grid (n + 1 , vector <int >(n + 1 , INT_MAX)); for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid[p1][p2] = val; } int start = 1 ; int end = n; std::vector<int > minDist (n + 1 , INT_MAX) ; std::vector<bool > visited (n + 1 , false ) ; minDist[start] = 0 ; vector<int > parent (n + 1 , -1 ) ; for (int i = 1 ; i <= n; i++) { int minVal = INT_MAX; int cur = 1 ; for (int v = 1 ; v <= n; ++v) { if (!visited[v] && minDist[v] < minVal) { minVal = minDist[v]; cur = v; } } visited[cur] = true ; for (int v = 1 ; v <= n; v++) { if (!visited[v] && grid[cur][v] != INT_MAX && minDist[cur] + grid[cur][v] < minDist[v]) { minDist[v] = minDist[cur] + grid[cur][v]; parent[v] = cur; } } } for (int i = 1 ; i <= n; i++) { cout << parent[i] << "->" << i << endl; } }
邻接表存储+堆优化版本,其实思路依然是 dijkstra 三部曲:
第一步,选源点到哪个节点近且该节点未被访问过 第二步,该最近节点被标记访问过 第三步,更新非访问节点到源点的距离(即更新minDist数组) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 class mycomparison {public : bool operator () (const pair<int , int >& lhs, const pair<int , int >& rhs) return lhs.second > rhs.second; } }; struct Edge { int to; int val; Edge (int t, int w): to (t), val (w) {} }; int main () int n, m, p1, p2, val; cin >> n >> m; vector<list<Edge>> grid (n + 1 ); for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid[p1].push_back (Edge (p2, val)); } int start = 1 ; int end = n; std::vector<int > minDist (n + 1 , INT_MAX) ; std::vector<bool > visited (n + 1 , false ) ; priority_queue<pair<int , int >, vector<pair<int , int >>, mycomparison> pq; pq.push (pair <int , int >(start, 0 )); minDist[start] = 0 ; while (!pq.empty ()) { pair<int , int > cur = pq.top (); pq.pop (); if (visited[cur.first]) continue ; visited[cur.first] = true ; for (Edge edge : grid[cur.first]) { if (!visited[edge.to] && minDist[cur.first] + edge.val < minDist[edge.to]) { minDist[edge.to] = minDist[cur.first] + edge.val; pq.push (pair <int , int >(edge.to, minDist[edge.to])); } } } if (minDist[end] == INT_MAX) cout << -1 << endl; else cout << minDist[end] << endl; }
带负权值的单源最短路问题 ,Bellman_ford算法的核心思想是 对所有边进行松弛n-1次操作(n为节点数量),从而求得目标最短路。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 int main () int n, m, p1, p2, val; cin >> n >> m; vector<vector<int >> grid; for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid.push_back ({p1, p2, val}); } int start = 1 ; int end = n; vector<int > minDist (n + 1 , INT_MAX) ; minDist[start] = 0 ; for (int i = 1 ; i < n; i++) { for (vector<int > &side : grid) { int from = side[0 ]; int to = side[1 ]; int price = side[2 ]; if (minDist[from] != INT_MAX && minDist[to] > minDist[from] + price) { minDist[to] = minDist[from] + price; } } } if (minDist[end] == INT_MAX) cout << "unconnected" << endl; else cout << minDist[end] << endl; }
队列优化版本(SPFA)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 struct Edge { int to; int val; Edge (int t, int w): to (t), val (w) {} }; int main () int n, m, p1, p2, val; cin >> n >> m; vector<list<Edge>> grid (n + 1 ); vector<bool > isInQueue (n + 1 ) ; for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid[p1].push_back (Edge (p2, val)); } int start = 1 ; int end = n; vector<int > minDist (n + 1 , INT_MAX) ; minDist[start] = 0 ; queue<int > que; que.push (start); while (!que.empty ()) { int node = que.front (); que.pop (); isInQueue[node] = false ; for (Edge edge : grid[node]) { int from = node; int to = edge.to; int value = edge.val; if (minDist[to] > minDist[from] + value) { minDist[to] = minDist[from] + value; if (isInQueue[to] == false ) { que.push (to); isInQueue[to] = true ; } } } } if (minDist[end] == INT_MAX) cout << "unconnected" << endl; else cout << minDist[end] << endl; }
判断负权回路:有负权回路的情况下,一直都会有更短的最短路,所以 松弛 第n次,minDist数组 也会发生改变再多松弛一次,看minDist数组 是否发生变化. 如果是SPFA,节点加入队列的次数超过了 n-1次 ,那么该图就一定有负权回路。
单源有限最短路径
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 int main () int src, dst,k ,p1, p2, val ,m , n; cin >> n >> m; vector<vector<int >> grid; for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid.push_back ({p1, p2, val}); } cin >> src >> dst >> k; vector<int > minDist (n + 1 , INT_MAX) ; minDist[src] = 0 ; vector<int > minDist_copy (n + 1 ) ; for (int i = 1 ; i <= k + 1 ; i++) { minDist_copy = minDist; for (vector<int > &side : grid) { int from = side[0 ]; int to = side[1 ]; int price = side[2 ]; if (minDist_copy[from] != INT_MAX && minDist[to] > minDist_copy[from] + price) { minDist[to] = minDist_copy[from] + price; } } } if (minDist[dst] == INT_MAX) cout << "unreachable" << endl; else cout << minDist[dst] << endl; }
多源最短路算法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 int main () int n, m, p1, p2, val; cin >> n >> m; vector<vector<int >> grid (n + 1 , vector <int >(n + 1 , 10005 )); for (int i = 0 ; i < m; i++){ cin >> p1 >> p2 >> val; grid[p1][p2] = val; grid[p2][p1] = val; } for (int k = 1 ; k <= n; k++) { for (int i = 1 ; i <= n; i++) { for (int j = 1 ; j <= n; j++) { grid[i][j] = min (grid[i][j], grid[i][k] + grid[k][j]); } } } int z, start, end; cin >> z; while (z--) { cin >> start >> end; if (grid[start][end] == 10005 ) cout << -1 << endl; else cout << grid[start][end] << endl; } }
如果遇到单源且边为正数,直接Dijkstra 。至于 使用朴素版还是 堆优化版 还是取决于图的稠密度 .一般情况下,可以直接用堆优化版本。
如果遇到单源边可为负数,直接 Bellman-Ford ,同样 SPFA 还是 Bellman-Ford 取决于图的稠密度。一般情况下,直接用 SPFA。
如果有负权回路,优先 Bellman-Ford , 如果是有限节点最短路 也优先 Bellman-Ford,理由是写代码比较方便。
如果是遇到多源点求最短路,直接 Floyd
最小生成树是所有节点的最小连通子图,即:以最小的成本(边的权值)将图中所有节点链接到一起。
第一步,选距离生成树最近节点 第二步,最近节点加入生成树 第三步,更新非生成树节点到生成树的距离(即更新minDist数组) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 int main () int v, e; int x, y, k; cin >> v >> e; vector<vector<int >> grid (v + 1 , vector <int >(v + 1 , 10001 )); while (e--) { cin >> x >> y >> k; grid[x][y] = k; grid[y][x] = k; } vector<int > parent (v + 1 , -1 ) ; vector<int > minDist (v + 1 , 10001 ) ; vector<bool > isInTree (v + 1 , false ) ; for (int i = 1 ; i < v; i++) { int cur = -1 ; int minVal = INT_MAX; for (int j = 1 ; j <= v; j++) { if (!isInTree[j] && minDist[j] < minVal) { minVal = minDist[j]; cur = j; } } isInTree[cur] = true ; for (int j = 1 ; j <= v; j++) { if (!isInTree[j] && grid[cur][j] < minDist[j]) { minDist[j] = grid[cur][j]; parent[j] = cur; } } } int result = 0 ; for (int i = 2 ; i <= v; i++) { result += minDist[i]; } cout << result << endl; }
kruscal的思路:
边的权值排序,因为要优先选最小的边加入到生成树里 遍历排序后的边如果边首尾的两个节点在同一个集合,说明如果连上这条边图中会出现环 如果边首尾的两个节点不在同一个集合,加入到最小生成树,并把两个节点加入同一个集合 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 struct Edge { int l, r, val; }; int n = 10001 ;vector<int > father (n, -1 ) ; void init () for (int i = 0 ; i < n; ++i) { father[i] = i; } } int find (int u) return u == father[u] ? u : father[u] = find (father[u]); } void join (int u, int v) u = find (u); v = find (v); if (u == v) return ; father[v] = u; } int main () int v, e; int v1, v2, val; vector<Edge> edges; int result_val = 0 ; cin >> v >> e; while (e--) { cin >> v1 >> v2 >> val; edges.push_back ({v1, v2, val}); } sort (edges.begin (), edges.end (), [](const Edge& a, const Edge& b) { return a.val < b.val; }); vector<Edge> result; init (); for (Edge edge : edges) { int x = find (edge.l); int y = find (edge.r); if (x != y) { result.push_back (edge); result_val += edge.val; join (x, y); } } cout << result_val << endl; for (Edge edge : result) { cout << edge.l << " - " << edge.r << " : " << edge.val << endl; } return 0 ; }
Kruskal 与 prim 的关键区别在于,prim维护的是节点的集合,而 Kruskal 维护的是边的集合。 如果 一个图中,节点多,但边相对较少,那么使用Kruskal 更优。
拓扑排序 是在图上的一种排序。概括来说,给出一个 有向图,把这个有向图转成线性的排序 就叫拓扑排序 。当然拓扑排序也要检测这个有向图 是否有环,即存在循环依赖的情况,因为这种情况是不能做线性排序的。拓扑排序也是图论中判断有向无环图的常用方法 。
同样,拓扑排序也可以检测这个有向图 是否有环,即存在循环依赖的情况。拓扑排序的一些应用场景,例如:大学排课,文件下载依赖 等等。
只要记住如下两步拓扑排序的过程,代码就容易写了:
找到入度为0 的节点,加入结果集 将该节点从图中移除 概括来说,给出一个 有向图,把这个有向图转成线性的排序 就叫拓扑排序 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 int main () int m, n, s, t; cin >> n >> m; vector<int > inDegree (n, 0 ) ; unordered_map<int , vector<int >> umap; vector<int > result; while (m--) { cin >> s >> t; inDegree[t]++; umap[s].push_back (t); } queue<int > que; for (int i = 0 ; i < n; i++) { if (inDegree[i] == 0 ) que.push (i); } while (que.size ()) { int cur = que.front (); que.pop (); result.push_back (cur); vector<int > files = umap[cur]; if (files.size ()) { for (int i = 0 ; i < files.size (); i++) { inDegree[files[i]] --; if (inDegree[files[i]] == 0 ) que.push (files[i]); } } } if (result.size () == n) { for (int i = 0 ; i < n - 1 ; i++) cout << result[i] << " " ; cout << result[n - 1 ]; } else cout << -1 << endl; }
并查集常用来解决连通性问题。
大白话就是当我们需要判断两个元素是否在同一个集合里的时候,我们就要想到用并查集。
并查集主要有两个功能:
将两个元素添加到一个集合中。 判断两个元素在不在同一个集合 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 int n = 1005 ; vector<int > father = vector <int > (n, 0 ); void init () for (int i = 0 ; i < n; ++i) { father[i] = i; } } int find (int u) return u == father[u] ? u : father[u] = find (father[u]); } bool isSame (int u, int v) u = find (u); v = find (v); return u == v; } void join (int u, int v) u = find (u); v = find (v); if (u == v) return ; father[v] = u; }
join函数中如何合并两棵树呢?
一定是 rank 小的树合入 到 rank大 的树,这样可以保证最后合成的树rank 最小,降低在树上查询的路径长度。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 int n = 1005 ; vector<int > father = vector <int > (n, 0 ); vector<int > rank = vector <int > (n, 1 ); void init () for (int i = 0 ; i < n; ++i) { father[i] = i; rank[i] = 1 ; } } int find (int u) return u == father[u] ? u : find (father[u]); } bool isSame (int u, int v) u = find (u); v = find (v); return u == v; } void join (int u, int v) u = find (u); v = find (v); if (rank[u] <= rank[v]) father[u] = v; else father[v] = u; if (rank[u] == rank[v] && u != v) rank[v]++; }
注意到在上面的模板代码中,我是没有做路径压缩的,因为一旦做路径压缩,rank记录的高度就不准了,根据rank来判断如何合并就没有意义。其实在优化并查集查询效率的时候,只用路径压缩的思路就够了,不仅代码实现精简,而且效率足够高。按秩合并的思路并没有将树形结构尽可能的扁平化,所以在整理效率上是没有路径压缩高的。
普通二分法
1 2 3 4 5 6 7 8 9 10 11 12 l=0 ,h=nums.size()-1 ; while (l<=h) { mid = (h-l)/2 +l; if (nums[mid ] == target) { return mid ; }else if (nums[mid ]<target) { l = mid +1 ; }else { h = mid -1 ; } } return -1 ;
二分法变种
二分法变种有些二分法类型的题目,在二分时无法直接判断中间元素是否为目标元素 ,这类问题被称作二分法变种问题。例如在有序数组里面查找第1个大于或等于5的元素,每次判断中间元素时,无法直接断定这个元素是否是第1个大于或等于5的元素,它可能是第2个或第3个大于或等于5的元素。对于这种问题,一个简单的思路是不断地缩小查找范围,直到剩下一个元素,即目标元素。二分法变种问题大致分为两种情况。
● 查找第一个满足条件的元素,例如查找第一个大于或等于x的元素。
● 查找最后一个满足条件的元素,例如查找最后一个小于或等于x的元素。
此外需要注意边界的控制,这是二分法变种问题最容易出错的地方。若我们在循环中让l=mid,则可能产生死循环(具体细节可翻阅第6章的内容),解决方案是通过判断当前搜索范围内元素是否剩下两个(l+1==h)来跳转出去,并在最后筛选出目标元素。
回溯法的本质是回溯思想,通常使用递归实现,因此实现回溯法的重点是实现递归。递归的实现需要考虑3个方面:搜索的设计、递归的状态及递归的结束条件。
搜索的设计对求解的空间进行划分,让每一层递归都去尝试搜索一部分的解空间,直至搜索完所有可能的解空间。递归的状态状态是用来区别不同递归的,实际上也是为了搜索而设计的,应该根据搜索过程中的需求进行合理的设计。一般而言,我们至少携带一种状态——当前位置idx,它用于找到当前可以继续前进的搜索空间,以此进入下一层递归。此外,由于题目的要求,我们可能还需要携带多个状态,用来标记当前路径解的某些信息,例如携带状态path来记录当前的路径及状态cur来记录路径上的某个信息。递归的结束条件通常包括两个方面:找到可行性解,提前结束搜索;搜索完毕,已经没有可搜索的解空间。
并查集是一种树型结构,经常被用来处理一些不相交集合的查询和合并问题。具体而言,当我们遇到需要快速连接任意两个点,并且判断任意两个点是否连通的问题时,就可以使用并查集模板来实现 。
例如,班上有n名学生,其中有些人是朋友,有些则不是,他们的友谊具有传递性。如果已知A是B的朋友,B是C的朋友,那么我们可以认为A也是C的朋友。所谓的朋友圈,是指所有朋友的集合。
给定一个n×n的矩阵M,表示班级中学生之间的朋友关系。如果M[i][j]=1,表示已知第i个和第j个学生互为朋友关系,否则为未知。你必须输出所有学生中已知的朋友圈总数
基于队列的广度优先遍历,将起始节点放入队列中,循环遍历队列中的节点,扩展节点相邻的有效节点,并将其放入队列中。
借助双指针表示窗口的左边界和右边界,并根据题目要求不断移动指针,搜索可能存在的有效值。根据窗口大小是否固定,以及最优解为最大或最小窗口,可以将滑动窗口分为3种类型。
滑动窗口Ⅰ特征是窗口大小固定,最优解与窗口大小无关。整体的主要流程为初始化大小为init_len的滑动窗口,检查窗口是否满足条件,更新最优解,然后循环移动窗口直到抵达边界,每次将右指针right及左指针left向右移动一步,并再次检查窗口内的信息是否满足条件,更新最优解。
滑动窗口Ⅱ特征是窗口大小不固定,最优解为最小窗口。整体的主要流程为初始化大小为0的滑动窗口;然后循环移动窗口直到抵达边界,每次右指针right向右移动一步,并检查窗口是否满足条件,如果是,则循环向右移动左指针left,每次移动一步,不断尝试缩小窗口直到窗口不满足条件,更新最优解。
滑动窗口Ⅲ特征是窗口大小不固定,最优解为最大窗口。整体的主要流程为初始化大小为0的滑动窗口;然后循环移动窗口直到抵达边界,每次右指针right向右移动一步,并检查窗口是否不满足条件,如果是,则循环向右移动左指针left,每次移动一步直到满足条件,然后更新最优解。
质数判断,开根号法
数只能被1和它本身整除,而非素数除它们之外,至少还有两个除数a和b。为了判断num是否为非素数,我们可以在[2,num-1]区间查找是否存在num的除数。进一步观察非素数的因子的特征,a和b是相互配对的,且必然有一个比较小,假设较小的数为min,我们只要去搜索[2,min]区间即可。现在问题就转换为如何求min 的最大值了,小数×大数=n,为了让小数尽可能地大,缩小大数,最后变成小数×小数=n,则min的最大值为sqrt(n)
对于素数判断的问题,该算法的时间复杂度还是可以接受的,但对于计数问题,如求解n以内的素数个数,1至n中的每个数都要调用一次函数来验证,时间复杂度将达到O(n$\sqrt{n}$),耗时过大
埃氏筛法
利用质数的倍数是合数的性质,从小到大遍历每个数字,如果数字为质数,则筛掉其倍数。
线性筛法
线性筛法(Linear Sieve),通常也被称为欧拉筛(Euler Sieve) 。它是对埃氏筛(Sieve of Eratosthenes)的极致优化。
埃氏筛的问题在于:同一个合数会被多个质因数重复筛去 。例如 $30$,会被 $2$ 筛一次,$3$ 筛一次,$5$ 筛一次。这导致了 $O(n \log \log n)$ 的复杂度。而线性筛的核心思想是:让每一个合数只被它的“最小质因数”筛掉一次 ,从而达到真正的 $O(n)$ 复杂度。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 #include <vector> #include <iostream> using namespace std;void linearSieve (int n) vector<int > primes; vector<bool > isNotPrime (n + 1 , false ) ; for (int i = 2 ; i <= n; ++i) { if (!isNotPrime[i]) { primes.push_back (i); } for (int p : primes) { if (i * p > n) break ; isNotPrime[i * p] = true ; if (i % p == 0 ) break ; } } cout << "Total primes up to " << n << ": " << primes.size () << endl; }
最大公约数根据欧几里得算法的定理:两个整数的最大公约数等于其中较小的那个数和两数相除余数的最大公约数,我们可以通过递归,不断缩小这两个数字,直到某个数字为0,则另外一个数字为最大公约数
最小公倍数最大公约数和最小公倍数存在一个性质:两个数的乘积等于这两个数的最大公约数和最小公倍数的乘积,因此,两数最小公倍数=两数乘积 / 两数最大公约数
KMP:改进的字符串匹配算法。经典的应用场景是查找字符串A在字符串B的起始位置。
马拉车:处理回文字符串问题的算法。经典的应用场景是查找字符串的最长回文字串。
树状数组:实现单点修改,区间查询的数据结构。实现难度较低,功能有限。
线段树:实现区间修改,区间查询的数据结构。实现难度较高,功能强大。
循环移位是一类非常经典的问题,通常涉及数组、字符串和链表等线性数据结构,包括移动问题、查找问题和包含问题等类型。虽然表现形式有很多,但其问题本质是相似的,只要理解其背后的算法思想,你便能掌握不同数据结构下的实现。
轮转数组
给定一个整数数组 nums,将数组中的元素向右轮转 k 个位置,其中 k 是非负数。
1.空间复杂度为O(n)的解法
如果采用原地旋转的方法,那么部分数据可能会因为在操作过程中被覆盖而丢失,解决这个问题最简单的做法是在开始时复制一个完全一样的数组,每次移动时从新的数组取数,但是这样占用的额外空间会随着数组大小的变化而线性增加,算法的空间复杂度为O(n)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 class Solution {public : void rotate (vector<int >& nums, int k) int sz = nums.size (); k = k % nums.size (); if (k == 0 ) { return ; } vector<int > copy_nums = nums; for (int i = 0 ; i < nums.size (); i++) { nums[(i + k) % sz] = copy_nums[i]; } } };
2.空间换时间
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class Solution {public : void rotate (vector<int >& nums, int k) int sz = nums.size (); k = k % nums.size (); if (k == 0 ) { return ; } vector<int > copy_nums = nums; for (int i = 0 ; i < sz; i++) { copy_nums.push_back (nums[i]); } int start_pos = sz - k; for (int i = start_pos; i < start_pos + sz; i++) { nums[i - start_pos] = copy_nums[i]; } } };
3.三次翻转法
1 2 3 4 5 6 7 8 9 10 11 class Solution {public : void rotate (vector<int >& nums, int k) int sz = nums.size (); k = k % nums.size (); reverse (nums.begin (),nums.end ()); reverse (nums.begin (),nums.begin ()+k); reverse (nums.begin ()+k,nums.end ()); } };
旋转链表
给你一个链表的头节点 head ,旋转链表,将链表每个节点向右移动 k 个位置。
由于 $k$ 可能大于链表的长度 $n$,首先我们需要知道链表的长度。
算法步骤:
计算长度 $n$ :遍历链表得到长度 $n$,同时找到当前的尾节点 tail。处理 $k$ :实际旋转的步数是 $k \% n$。如果 $k \% n = 0$,说明旋转后还是原样,直接返回 head。闭合成环 :将尾节点的 next 指向头节点,使链表变成一个循环链表 。寻找断开点 :向右移动 $k$ 个位置,相当于从头节点向后走 $n - (k \% n) - 1$ 步找到新的尾节点 。断开环 :新的头节点就是 new_tail->next,然后将 new_tail->next 设为 nullptr。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 class Solution {public : ListNode* rotateRight (ListNode* head, int k) { if (!head || !head->next || k == 0 ) return head; int n = 1 ; ListNode* tail = head; while (tail->next) { tail = tail->next; n++; } k = k % n; if (k == 0 ) return head; tail->next = head; ListNode* new_tail = head; for (int i = 0 ; i < n - k - 1 ; i++) { new_tail = new_tail->next; } ListNode* new_head = new_tail->next; new_tail->next = nullptr ; return new_head; } };
编辑距离算法被数据科学家广泛应用,是用作机器翻译和语音识别评价标准的基本算法。
最直观的方法是暴力检查所有可能的编辑方法,取最短的一个。所有可能的编辑方法达到指数级,但我们不需要进行这么多计算,因为我们只需要找到距离最短的序列而不是所有可能的序列。
给你两个单词 word1 和 word2, 请返回将 word1 转换成 word2 所使用的最少操作数 。
你可以对一个单词进行如下三种操作:
定义 $dp[i][j]$ 为将 word1 的前 $i$ 个字符转换成 word2 的前 $j$ 个字符所需要的最少操作数
假设我们要计算 $dp[i][j]$:
如果 word1[i-1] == word2[j-1] (当前字符相同):
不需要任何操作,操作数等于之前的状态:$dp[i][j] = dp[i-1][j-1]$。 如果 word1[i-1] != word2[j-1] (当前字符不同):
我们需要从以下三种操作中选一个步数最少的:
插入 :在 word1 插入一个字符,相当于匹配 word1 的前 $i$ 个和 word2 的前 $j-1$ 个:$dp[i][j-1] + 1$。删除 :把 word1 的第 $i$ 个字符删掉,相当于匹配 word1 的前 $i-1$ 个和 word2 的前 $j$ 个:$dp[i-1][j] + 1$。替换 :把 word1 的第 $i$ 个字符换成 word2 的第 $j$ 个,相当于匹配 word1 的前 $i-1$ 个和 word2 的前 $j-1$ 个:$dp[i-1][j-1] + 1$。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int minDistance (string word1, string word2) int m = word1.l ength(); int n = word2.l ength(); vector<vector<int >> dp (m + 1 , vector <int >(n + 1 )); for (int j = 0 ; j <= n; j++) dp[0 ][j] = j; for (int i = 0 ; i <= m; i++) dp[i][0 ] = i; for (int i = 1 ; i <= m; i++) { for (int j = 1 ; j <= n; j++) { if (word1[i - 1 ] == word2[j - 1 ]) { dp[i][j] = dp[i - 1 ][j - 1 ]; } else { dp[i][j] = min ({dp[i - 1 ][j - 1 ], dp[i - 1 ][j], dp[i][j - 1 ]}) + 1 ; } } } return dp[m][n]; } };
编辑距离是自然语言处理(NLP)中拼写检查、DNA 序列比对的基础。进阶: 实际上因为每次计算 $dp[i][j]$ 只依赖于上一行和当前行的前一个元素,我们可以用滚动数组 将空间复杂度优化到 $O(n)$。
它的变种非常多,比如:
最长公共子序列 (LCS) :其实就是只有删除和插入操作,没有替换操作。两个字符串的删除操作 :求最少步数使两个字符串相等。最长重复子数组
给两个整数数组 nums1 和 nums2 ,返回 两个数组中 公共的 、长度最长的子数组的长度 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 class Solution {public : int findLength (vector<int >& nums1, vector<int >& nums2) int sz1 = nums1. size (); int sz2 = nums2. size (); vector<vector<int >> dp (sz1 + 1 , vector <int >(sz2 + 1 )); int res{}; for (int i = 1 ; i <= sz1; i++) { for (int j = 1 ; j <= sz2; j++) { if (nums1[i - 1 ] == nums2[j - 1 ]) { dp[i][j] = dp[i - 1 ][j - 1 ] + 1 ; } else { dp[i][j] = 0 ; } res = max (res,dp[i][j]); } } return res; } };
力扣(LeetCode)中有关第k的题目一共有8道,其中包含1道简单级别、5道中等级别和2道困难级别的题目。
第60题第k个排列,第779题第k个语法符号,属于找规律的题目。
第215题数组中的第k个最大元素,第703题数据流中的第k大元素,可以用堆来解决。
第230题二叉搜索树中第k小的元素,这个比较特殊,用到了二叉搜索树这种数据结构,因此可以尝试用二分法解决,也可以使用前序遍历来解决,不过复杂度会更高一点。
第378题有序矩阵中第k小的元素,这道题可以利用横向/纵向分别有序的性质使用二分法解决。
第668题乘法表中第k小的数,可以使用二分法解决。
第k问题往往有3种解法:堆、二分法和找规律
堆的一个经典的实现是完全二叉树,如果用完全二叉树来实现的话就是二叉堆,当然相应地也有其他种类的堆。堆的任意非叶子节点至少满足以下性质之一。
● 性质1:nodes[i]<=nodes[2i+1]and nodes[i]<=nodes[2i+2]。
● 性质2:nodes[i]>=nodes[2i+1]and nodes[i]>=nodes[2i+2]。即任一非叶子节点的值不大于或不小于其左/右孩子节点的值
堆分为大顶堆和小顶堆,满足性质1的是小顶堆,满足性质2的则是大顶堆。由上述性质可知大顶堆的堆顶的值是最大的,小顶堆的堆顶的值是最小的。堆有两个操作:一个是push,一个是pop。不管哪种操作,都会破坏堆的性质,因此每次操作之后都需要进行调整,使之重新满足堆的性质。
数组中第k个最大元素
给定整数数组 nums 和整数 k,请返回数组中第 **k** 个最大的元素。
请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素。
你必须设计并实现时间复杂度为 O(n) 的算法解决此问题。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Solution {public : int partition (vector<int >& nums,int i,int j,int k) if (i == j) { return nums[k]; } int left = i-1 ; int right = j+1 ; int pivot = nums[i]; while (true ) { do { left++; }while (nums[left]<pivot); do { right--; }while (nums[right]>pivot); if (left>=right) { break ; } swap (nums[left],nums[right]); } if (k<=right) { return partition (nums,i,right,k); }else { return partition (nums,1 +right,j,k); } } int findKthLargest (vector<int >& nums, int k) return partition (nums,0 ,nums.size ()-1 ,nums.size ()-k); } };
也可以建立小根堆,堆大小为k,堆顶元素最小,如果要添加的元素大于堆顶元素且容量超过k,则弹出堆顶元素。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 int findKthLargest (vector<int >& nums, int k) priority_queue<int ,vector<int >,greater<int >> q; for (auto & n:nums) { int sz = q.size (); if (sz<k) { q.push (n); }else { if (q.top ()<n) { q.pop (); q.push (n); } } } return q.top (); }
也可以建立一个大根堆,做 k −1 次删除操作后堆顶元素就是我们要找的答案
数据流中第K大元素
设计一个找到数据流中第 k 大元素的类(class)。注意是排序后的第 k 大元素,不是第 k 个不同的元素。
请实现 KthLargest 类:
KthLargest(int k, int[] nums) 使用整数 k 和整数流 nums 初始化对象。int add(int val) 将 val 插入数据流 nums 后,返回当前数据流中第 k 大的元素。可以使用一个大小为 k 的优先队列来存储前 k 大的元素,其中优先队列的队头为队列中最小的元素,也就是第 k 大的元素。
在单次插入的操作中,我们首先将元素 val 加入到优先队列中。如果此时优先队列的大小大于 k,我们需要将优先队列的队头元素弹出,以保证优先队列的大小为 k。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 class KthLargest {public : priority_queue<int , vector<int >, greater<int >> q; int k; KthLargest (int k, vector<int >& nums) { this ->k = k; for (auto & x: nums) { add (x); } } int add (int val) q.push (val); if (q.size () > k) { q.pop (); } return q.top (); } };
二叉搜索树中第K小的元素
给定一个二叉搜索树的根节点 root ,和一个整数 k ,请你设计一个算法查找其中第 k 小的元素(k 从 1 开始计数)。
找第 $k$ 小的元素,本质上就是找中序遍历序列中的第 $k$ 个元素 。
核心思路:迭代式中序遍历
虽然递归实现很简单,但在面试中,迭代法(使用栈)通常更受青睐。因为迭代法允许我们在找到第 $k$ 个元素时立即停止 ,而不需要走完整个遍历过程。
算法步骤:
初始化 :准备一个栈 st 和一个当前指针 curr 指向根节点。向左深钻 :只要 curr 不为空,就把它压入栈中,并向左子节点移动。这保证了我们总是先处理最小的元素。弹出与计数 :当左边走到底了,从栈中弹出一个节点:计数器 $k$ 减 1。 如果 $k == 0$,当前的节点值就是答案。 向右转向 :将 curr 指向当前弹出节点的右子节点,重复上述过程。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution {public : int kthSmallest (TreeNode* root, int k) stack<TreeNode*> st; TreeNode* curr = root; while (curr != nullptr || !st.empty ()) { while (curr != nullptr ) { st.push (curr); curr = curr->left; } curr = st.top (); st.pop (); if (--k == 0 ) { return curr->val; } curr = curr->right; } return -1 ; } };
如果二叉搜索树经常被修改(插入/删除操作)并且你需要频繁地查找第 k 小的值,你将如何优化算法?
最有效的优化方案是构建一棵顺序统计树(Order Statistic Tree) 。核心思想是:空间换时间 。通过在每个节点中维护额外的统计信息,将查找复杂度从 $O(H + k)$ 降低到稳定且高效的 $O(H)$ (在平衡状态下为 $O(\log N)$ )。
在传统的 BST 节点结构中增加一个 size 变量,用于存储以当前节点为根的子树中的节点总数 。
1 2 3 4 5 6 struct TreeNode { int val; int size; TreeNode *left, *right; TreeNode (int x) : val (x), size (1 ), left (nullptr ), right (nullptr ) {} };
查询逻辑:利用 size 进行“二分剪枝” 有了 size 字段,我们就不再需要完整的中序遍历,而是可以像二分查找一样直接定位:
设当前节点为 root,其左子树节点数为 left_size(如果左子树为空则为 0)。 情况 A: k == left_size + 1说明当前节点正好是第 $k$ 小的元素,直接返回。 情况 B: k <= left_size说明第 $k$ 小的元素一定在左子树中,递归进入左子树查找。 情况 C: k > left_size + 1说明前 left_size + 1 个小的元素(左子树 + 根节点)都不符合要求。 我们需要去右子树寻找,此时目标变为寻找右子树中的第 k - (left_size + 1) 查询复杂度:$O(H)$ ($H$ 为树高)。
维护逻辑:插入与删除 由于树会频繁修改,我们必须在每次 insert 或 delete 操作时更新路径上所有节点的 size:
插入: 沿着插入路径向下寻找位置时,对路径上的每个节点执行 size++。删除: 沿着删除路径寻找目标节点时,对路径上的每个节点执行 size--。如果 BST 退化成链表,$H$ 会变成 $N$,查询效率依然会降到 $O(N)$。为了确保在频繁修改下性能始终稳定在 $O(\log N)$ ,必须配合平衡二叉搜索树(Balanced BST) 使用:
AVL 树或红黑树: 在旋转(Rotation)操作时,除了更新父子关系,还需要重新计算旋转涉及到的两个节点的 size。node->size = get_size(node->left) + get_size(node->right) + 1;有序矩阵中第k小的元素
给定一个n×n的矩阵,其中每行和每列元素均按升序排序,找到矩阵中第k小的元素。请注意,它是排序后的第k小元素,而不是第k个元素
这种方法的思路不是在“下标”上二分,而是在“数值范围”上二分。矩阵中最小的元素是 matrix[0][0],最大的是 matrix[n-1][n-1]。
核心步骤:
确定值域 :左边界 $left = matrix[0][0]$,右边界 $right = matrix[n-1][n-1]$。取中间值 :$mid = left + (right - left) / 2$。阶梯计数 :利用矩阵行列有序的特性,在 $O(n)$ 时间内统计矩阵中小于或等于 $mid$ 的元素个数 count。从左下角开始走:如果当前值 $\le mid$,说明这一列上方的元素全符合要求,count += (i + 1),然后向右移。 如果当前值 $> mid$,说明当前值太大,向上移。 调整边界 :如果 count >= k,说明第 $k$ 小的数可能就是 $mid$ 或者在 $mid$ 左侧,令 $right = mid$。 如果 count < k,说明 $mid$ 太小了,令 $left = mid + 1$。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 class Solution {public : int kthSmallest (vector<vector<int >>& matrix, int k) int n = matrix.size (); int left = matrix[0 ][0 ]; int right = matrix[n - 1 ][n - 1 ]; while (left < right) { int mid = left + (right - left) / 2 ; if (check (matrix, mid, k, n)) { right = mid; } else { left = mid + 1 ; } } return left; } private : bool check (vector<vector<int >>& matrix, int mid, int k, int n) int count = 0 ; int i = n - 1 ; int j = 0 ; while (i >= 0 && j < n) { if (matrix[i][j] <= mid) { count += (i + 1 ); j++; } else { i--; } } return count >= k; } };
乘法表中第k小的数
几乎每一个人都用 乘法表 。但是你能在乘法表中快速找到第 k 小的数字吗?
乘法表是大小为 m x n 的一个整数矩阵,其中 mat[i][j] == i * j(下标从 1 开始)。
给你三个整数 m、n 和 k,请你在大小为 m x n 的乘法表中,找出并返回第 k 小的数字。
既然我们要找的是第 $k$ 小的数,这个数的取值范围一定在 $[1, m \times n]$ 之间。
可以在这个值域内进行二分查找。对于每一个中间值 $mid$,去计算:乘法表中有多少个数小于或等于 $mid$?
在 $m \times n$ 的乘法表中,第 $i$ 行($i$ 从 1 开始)的数字序列是:
如果要找出第 $i$ 行中有多少个数 $\le mid$,只需要满足 $i \times j \le mid$,即 $j \le mid / i$。
由于一列最多只有 $n$ 个数,所以第 $i$ 行中符合条件的个数为:
我们只需要遍历 $m$ 行,将每一行的结果累加,就能在 $O(m)$ 的时间内得到整个矩阵中 $\le mid$ 的总数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 class Solution {public : bool check (int mid,int k,int m,int n) int cnt{}; for (int i = 1 ;i<=m;i++) { cnt += min (n,mid/i); } return cnt>=k; } int findKthNumber (int m, int n, int k) int left = 1 ; int right = m*n; while (left<right) { int mid = (right-left)/2 +left; if (check (mid,k,m,n)) { right = mid; }else { left = mid+1 ; } } return right; } };
150逆波兰表达式求值
给你一个字符串数组 tokens ,表示一个根据 逆波兰表示法 表示的算术表达式。
请你计算该表达式。返回一个表示表达式值的整数。
注意:
有效的算符为 '+'、'-'、'*' 和 '/' 。 每个操作数(运算对象)都可以是一个整数或者另一个表达式。 两个整数之间的除法总是 向零截断 。 表达式中不含除零运算。 输入是一个根据逆波兰表示法表示的算术表达式。 答案及所有中间计算结果可以用 32 位 整数表示。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 class Solution {public : int evalRPN (vector<string>& tokens) stack<int > nums; for (int i = 0 ; i < tokens.size (); i++) { auto t = tokens[i]; if ((t.size ()>1 && t[0 ] == '-' ) || isdigit (t[0 ])) { nums.push (stoi (t)); continue ; } int val1 = nums.top (); nums.pop (); int val2 = nums.top (); nums.pop (); int res{}; if (t== "+" ) { res = val1 + val2; } else if (t== "-" ) { res = val2 - val1; } else if (t == "*" ) { res = val2 * val1; } else { res = val2 / val1; } nums.push (res); } return nums.top (); } };
241为运算表达式设计优先级
给你一个由数字和运算符组成的字符串 expression ,按不同优先级组合数字和运算符,计算并返回所有可能组合的结果。你可以 按任意顺序 返回答案。
生成的测试用例满足其对应输出值符合 32 位整数范围,不同结果的数量不超过 104 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 class Solution {public : unordered_map<string, vector<int >> memo; vector<int > diffWaysToCompute (string expression) { if (expression.empty ()) { return {}; } if (memo.count (expression)) { return memo[expression]; } vector<int > res; for (int i = 0 ; i < expression.size (); i++) { char & ch = expression[i]; if (!isdigit (ch)) { string leftExpression = expression.substr (0 , i); string rightExpression = expression.substr (i + 1 ); vector<int > leftAns = diffWaysToCompute (leftExpression); vector<int > rightAns = diffWaysToCompute (rightExpression); for (auto & val1 : leftAns) { for (auto & val2 : rightAns) { int r{}; if (ch == '+' ) { r = val1 + val2; } else if (ch == '-' ) { r = val1 - val2; } else if (ch == '*' ) { r = val1 * val2; } else { r = val1 / val2; } res.push_back (r); } } } } if (res.empty ()) { int r = stoi (expression); res.push_back (r); } memo[expression] = res; return res; } };
224计算器
给你一个字符串表达式 s ,请你实现一个基本计算器来计算并返回它的值。
注意:不允许使用任何将字符串作为数学表达式计算的内置函数,比如 eval() 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 class Solution {public : int calculate (string s) int res{}; int sz = s.size (); int sign = 1 ; stack<int > ops; ops.push (1 ); for (int i = 0 ; i < sz; i++) { char & ch = s[i]; if (isdigit (ch)) { long long num{}; while (i < sz && isdigit (s[i])) { num = num * 10 + s[i] - '0' ; i++; } res += sign * num; i--; } else if (ch == '+' ) { sign = ops.top (); } else if (ch == '-' ) { sign = -ops.top (); } else if (ch == '(' ) { ops.push (sign); } else if (ch == ')' ) { ops.pop (); } } return res; } };
227基本计算器II
给你一个字符串表达式 s ,请你实现一个基本计算器来计算并返回它的值。
整数除法仅保留整数部分。
你可以假设给定的表达式总是有效的。所有中间结果将在 [-231, 231 - 1] 的范围内。
注意: 不允许使用任何将字符串作为数学表达式计算的内置函数,比如 eval() 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Solution {public : int calculate (string s) int sz = s.size (); int num{}; vector<int > nums; char preSign = '+' ; for (int i = 0 ; i < sz; i++) { char & ch = s[i]; if (isdigit (ch)) { num = num * 10 + (ch - '0' ); } if ((!isdigit (ch) && ch != ' ' ) || i == sz - 1 ) { if (preSign == '+' ) { nums.push_back (num); } else if (preSign == '-' ) { nums.push_back (-num); } else if (preSign == '*' ) { nums.back () *= num; } else { nums.back () /= num; } preSign = ch; num = 0 ; } } return accumulate (nums.begin (), nums.end (), 0 ); } };
772基本计算器
实现一个基本的计算器来计算简单的表达式字符串。
表达式字符串只包含非负整数,算符 +、-、*、/ ,左括号 ( 和右括号 ) 。整数除法需要 向下截断 。你可以假定给定的表达式总是有效的。所有的中间结果的范围均满足 [-231, 231 - 1] 。
注意: 你不能使用任何将字符串作为表达式求值的内置函数,比如 eval() 。
最经典且稳健的方法是使用 双栈法 :一个栈用于存储数字(nums),另一个栈用于存储操作符(ops)。
核心逻辑
为了处理运算符的优先级(比如乘除优于加减,括号优先级最高),我们需要定义一套规则:
优先级定义 :给运算符设定等级,加减为 1,乘除为 2。括号处理 :遇到左括号 ( 直接入栈;遇到右括号 ) 则不断计算,直到弹出左括号。计算时机 :当准备入栈的操作符优先级 小于或等于 栈顶操作符时,说明栈顶的运算可以执行了。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 class Solution {public : void compute (stack<int >& nums, stack<char >& ops) if (nums.size () < 2 || ops.empty ()) { return ; } char & op = ops.top (); ops.pop (); int b = nums.top (); nums.pop (); int a = nums.top (); nums.pop (); if (op == '+' ) { nums.push (a + b); } else if (op == '-' ) { nums.push (a - b); } else if (op == '*' ) { nums.push (a * b); } else { nums.push (a / b); } } unordered_map<char , int > order = { {'+' , 1 }, {'-' , 1 }, {'*' , 2 }, {'/' , 2 }, }; int calculate (string s) stack<int > nums; stack<char > ops; int sz = s.size (); for (int i = 0 ; i < sz; i++) { char & ch = s[i]; if (ch == ' ' ) { continue ; } if (isdigit (ch)) { int num{}; while (i < sz && isdigit (s[i])) { num = num * 10 + (s[i] - '0' ); i++; } i--; nums.push (num); } else if (ch == '(' ) { ops.push (ch); } else if (ch == ')' ) { while (!ops.empty () && ops.top () != '(' ) { compute (nums, ops); } ops.pop (); } else { if (i > 0 && s[i - 1 ] == '(' ) { nums.push (0 ); } while (!ops.empty () && ops.top () != '(' && order[ops.top ()] >= order[ch]) { compute (nums, ops); } ops.push (ch); } } while (!ops.empty ()) { compute (nums, ops); } return nums.top (); } };
很多时候限制条件也起到提示的作用。
数据规模
除了数据规模,还有一个比较重要的信息是时间复杂度的限制。比如题目要求时间复杂度是对数复杂度,我们就很容易想到二分查找。又如题目要求常数的空间复杂度,我们很容易想到原地算法
转化为全零矩阵的最少反转次数
由于题目给出的矩阵规模非常小($m, n \le 3$),总格子数最多只有 $9$ 个,这意味着矩阵的总状态数只有 $2^9 = 512$ 种。对于这种状态空间极小且要求“最少操作次数”的问题,广度优先搜索(BFS) 是最理想的解法。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 class Solution {public : int minFlips (vector<vector<int >>& mat) int m = mat.size (); int n = mat[0 ].size (); int startState{}; for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (mat[i][j]) { startState |= (1 << (i * n + j)); } } } queue<pair<int , int >> q; unordered_set<int > vis; q.push ({startState, 0 }); vector<pair<int , int >> points = { {0 , 0 }, {1 , 0 }, {-1 , 0 }, {0 , 1 }, {0 , -1 }}; vis.insert (startState); while (!q.empty ()) { auto [s, step] = q.front (); q.pop (); if (s == 0 ) { return step; } for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { int next_state = s; for (auto & dir : points) { int nr = i + dir.first; int nc = j + dir.second; if (nr < 0 || nr >= m || nc < 0 || nc >= n) { continue ; } next_state ^= (1 << (nr * n + nc)); } if (!vis.count (next_state)) { vis.insert (next_state); q.push ({next_state, step + 1 }); } } } } return -1 ; } };
矩阵置零
可以使用用两个标记数组分别记录每一行和每一列是否有零出现。
具体地,我们首先遍历该数组一次,如果某个元素为 0,那么就将该元素所在的行和列所对应标记数组的位置置为 true。最后我们再次遍历该数组,用标记数组更新原数组即可。
此外,为了O(1)的空间复杂度.可以用矩阵的第一行和第一列代替两个标记数组。但这样会导致原数组的第一行和第一列被修改,无法记录它们是否原本包含 0。因此我们需要额外使用两个标记变量分别记录第一行和第一列是否原本包含 0。
在实际代码中,我们首先预处理出两个标记变量,接着使用其他行与列去处理第一行与第一列,然后反过来使用第一行与第一列去更新其他行与列,最后使用两个标记变量更新第一行与第一列即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 class Solution {public : void setZeroes (vector<vector<int >>& matrix) int m = matrix.size (); int n = matrix[0 ].size (); bool flag_row{}, flag_col{}; for (int i = 0 ; i < m; i++) { if (matrix[i][0 ] == 0 ) { flag_col = true ; break ; } } for (int i = 0 ; i < n; i++) { if (matrix[0 ][i] == 0 ) { flag_row = true ; break ; } } for (int i = 1 ; i < m; i++) { for (int j = 1 ; j < n; j++) { if (matrix[i][j] == 0 ) { matrix[i][0 ] = 0 ; matrix[0 ][j] = 0 ; } } } for (int i = 1 ; i < m; i++) { for (int j = 1 ; j< n; j++) { if (matrix[0 ][j] == 0 || matrix[i][0 ] == 0 ) { matrix[i][j] = 0 ; } } } if (flag_row) { for (int i = 0 ; i < n; i++) { matrix[0 ][i] = 0 ; } } if (flag_col) { for (int i = 0 ; i < m; i++) { matrix[i][0 ] = 0 ; } } } };
顺次数
我们定义「顺次数」为:每一位上的数字都比前一位上的数字大 1 的整数。
请你返回由 [low, high] 范围内所有顺次数组成的 有序 列表(从小到大排序)。
核心突破点在于:顺次数的数量非常有限 。
由于每一位都比前一位大 $1$,一旦确定了数字的长度 和起始数字 ,这个顺次数就是唯一的。例如,长度为 $3$ 且以 $1$ 开头的顺次数只能是 $123$。
核心思路:滑动窗口 / 枚举
所有可能的顺次数其实都源自一个基础字符串:"123456789"。
算法步骤:
构造母串 :定义字符串 s = "123456789"。枚举长度 :顺次数的长度至少为 $2$(题目要求 $low \ge 10$),至多为 $9$。滑动窗口截取 :在母串上移动一个固定长度的窗口。 将截取的子串转换为整数。 判断该整数是否在 $[low, high]$ 范围内。 排序输出 :由于我们是按长度从小到大、起始位置从左到右枚举的,生成的顺次数天然就是有序的。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 class Solution {public : vector<int > sequentialDigits (int low, int high) { vector<int > ans; for (int i = 1 ; i <= 9 ; ++i) { int num = i; for (int j = i + 1 ; j <= 9 ; ++j) { num = num * 10 + j; if (num >= low && num <= high) { ans.push_back (num); } } } sort (ans.begin (), ans.end ()); return ans; } }; class Solution {public : vector<int > sequentialDigits (int low, int high) { vector<int > res; string s = "123456789" ; for (int len = 2 ;len<=9 ;len++) { for (int start = 0 ;start<=9 -len;start++) { string r = s.substr (start,len); int result = stoi (r); if (result>=low && result<=high) { res.push_back (result); }else if (result>high) { break ; } } } return res; } };
单词接龙
给定两个单词(beginWord和endWord)和一个字典,找到从beginWord到endWord 的最短转换序列的长度。转换需遵循如下规则。每次转换只能改变一个字母;转换过程中的中间单词必须是字典中的单词。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 class Solution {public : int ladderLength (string beginWord, string endWord, vector<string>& wordList) unordered_set<string> wordSet (wordList.begin(), wordList.end()) ; if (!wordSet.count (endWord)) { return 0 ; } queue<pair<string, int >> q; q.push ({beginWord, 1 }); while (!q.empty ()) { auto [word, step] = q.front (); q.pop (); if (word == endWord) { return step; } for (int i = 0 ; i < word.size (); i++) { string next_word = word; for (char w = 'a' ; w <= 'z' ; w++) { if (word[i] != w) { next_word[i] = w; if (wordSet.count (next_word)) { q.push ({next_word, step + 1 }); wordSet.erase (next_word); } } } } } return 0 ; } };
暴力法可以给你提示,打开思路。暴力法可以给你相对直观的思路,当想到用暴力法解决时,你应该思考暴力法的瓶颈在哪里。比如经典的爬楼梯问题,如果采用暴力法,我们发现中间会有很多重复的运算,这里可以考虑使用哈希表将全部计算存起来从而避免重复计算,得到可用的解。
暴力法可以通过剪枝、预处理等方法减少程序的运行时间,进而通过所有的测试用例。暴力法之所以有问题,一方面是因为它产生重复的计算;另一方面暴力法往往还会去执行一些根本不可能是结果的代码。在这种情况下,上面的方案就变得不可行,可以通过剪枝来解决这个问题。剪枝在回溯法中应用得比较多。另一种可行的方法是数据预处理
统计全为 1 的正方形子矩阵
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 class Solution {public : int countSquares (vector<vector<int >>& matrix) int m = matrix.size (); int n = matrix[0 ].size (); vector<vector<int >> dp (m, vector <int >(n)); int res{}; for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (matrix[i][j] == 1 ) { if (i == 0 || j == 0 ) { dp[i][j] = 1 ; } else { dp[i][j] = min (dp[i][j - 1 ], min (dp[i - 1 ][j], dp[i - 1 ][j - 1 ])) + 1 ; } res += dp[i][j]; } } } return res; } };
最大正方形
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 class Solution {public : int maximalSquare (vector<vector<char >>& matrix) if (matrix.size () == 0 || matrix[0 ].size () == 0 ) { return 0 ; } int maxSide = 0 ; int rows = matrix.size (), columns = matrix[0 ].size (); vector<vector<int >> dp (rows, vector <int >(columns)); for (int i = 0 ; i < rows; i++) { for (int j = 0 ; j < columns; j++) { if (matrix[i][j] == '1' ) { if (i == 0 || j == 0 ) { dp[i][j] = 1 ; } else { dp[i][j] = min (min (dp[i - 1 ][j], dp[i][j - 1 ]), dp[i - 1 ][j - 1 ]) + 1 ; } maxSide = max (maxSide, dp[i][j]); } } } int maxSquare = maxSide * maxSide; return maxSquare; } };
子串的最大出现次数
给你一个字符串 s ,请你返回满足以下条件且出现次数最大的 任意 子串的出现次数:
子串中不同字母的数目必须小于等于 maxLetters 。 子串的长度必须大于等于 minSize 且小于等于 maxSize 。 题目要求子串长度在 [minSize, maxSize] 之间。但实际上,我们只需要统计长度正好为 minSize 的子串。
假设一个长度为 maxSize 的子串出现了 $k$ 次,那么它内部包含的长度为 minSize 的前缀子串也一定至少出现了 $k$ 次 。 同时,短子串包含的不同字母个数只会比长子串少或相等,因此更容易满足 maxLetters 的限制。 所以,出现次数最多的合法子串,一定可以在长度为 minSize 的子串中找到。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 class Solution {public : bool isValid (string& subs, int k) int charCount[26 ] = {0 }; int cnt{}; for (auto & ch : subs) { charCount[ch - 'a' ]++; if (charCount[ch - 'a' ] == 1 ) { cnt++; } } return cnt <= k; } int maxFreq (string s, int maxLetters, int minSize, int maxSize) int sz = s.size (); unordered_map<string, int > counts; int res{}; for (int i = 0 ; i < sz - minSize + 1 ; i++) { string subs = s.substr (i, minSize); if (isValid (subs, maxLetters)) { counts[subs]++; res = max (res, counts[subs]); } } return res; } };
状态压缩同样是一个很常见的算法,如“如何将 IP 地址用4个字节来表示等。在实际做题的过程中,很多时候并不会直接要求你进行状态压缩。更多的情况是若不进行状态压缩,则很可能发生内存溢出。为了减少内存占用,避免内存溢出,我们不得不使用状态压缩的技巧。
假如我们需要判断一个字符串中的字符是否全部唯一。简单起见,假设字符串仅包含小写英文字母。一个简单的思路是进行一次遍历并用集合记录出现过的字母。如果加入集合前发现集合中已经存在了当前的字母则直接返回False.假如我们需要判断一个字符串中的字符是否全部唯一。简单起见,假设字符串仅包含小写英文字母。一个简单的思路是进行一次遍历并用集合记录出现过的字母。如果加入集合前发现集合中已经存在了当前的字母则直接返回False.
由于字符串只包含小写字母,因此也可以使用一个长度为26的数组来统计每个字母出现的次数,如果某个字母出现次数大于1则直接返回False,但是这种做法并没有在空间上带来优化。下面我们使用状态压缩技巧来进行优化。仔细考虑上面的数组思路会发现,我们只关心某一个字母出现次数是否大于1,因此如果某个字母出现次数等于1,并且又出现了一个同样的字母,直接返回False 即可。也就是说,这里的数组的值只需要用一个二进制位保存即可,即0和1。
对于这种二值性的存储问题,都可以用位运算来压缩存储状态。只不过有些题目没有必要使用压缩也可以通过,有些题目则必须使用压缩。如果题目中的数据范围在32以内,需要存储的状态很多且具有二值性,那就可以考虑使用状态压缩。由于只有26个字母,因此使用一个int(32位)存储是足够的,这也是前面提到的数据范围在32以内的原因之一。只不过这里的26并不是题目显性给出的,而是一个需要大家自己发掘的条件。关于上面使用集合的那个算法,我们使用了集合的两个操作,分别是将元素添加到集合中和判断元素是否存在于集合中。这里使用位运算来实现这两个操作,用int来代替集合即可
生命游戏
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 class Solution {public : const vector<pair<int , int >> dirs = {{0 , 1 }, {0 , -1 }, {1 , 0 }, {-1 , 0 }, {1 , 1 }, {1 , -1 }, {-1 , 1 }, {-1 , -1 }}; void gameOfLife (vector<vector<int >>& board) int m = board.size (); int n = board[0 ].size (); for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { int neighbors{}; for (auto & dir : dirs) { int nx = i + dir.first; int ny = j + dir.second; if (nx < 0 || nx >= m || ny < 0 || ny >= n) { continue ; } if (board[nx][ny] == 1 || board[nx][ny] == 3 ) { neighbors++; } } if (neighbors < 2 && board[i][j] == 1 ) { board[i][j] = 3 ; } if (neighbors > 3 && board[i][j] == 1 ) { board[i][j] = 3 ; } if (neighbors == 3 && board[i][j] == 0 ) { board[i][j] = 2 ; } } } for (int i = 0 ; i < m; i++) { for (int j = 0 ; j < n; j++) { if (board[i][j] == 2 ) { board[i][j] = 1 ; } else if (board[i][j] == 3 ) { board[i][j] = 0 ; } } } } };
降维和状态压缩类似,降维指的是将高维的数据转化为低维的数据。比如将一个二维数组转化为一维的字符串,这种技巧在BFS中用的比较多。在BFS中,我们首先要明确的是开始状态和结束状态,而如果这个状态是一个二维数组,在通常情况下都需要对其进行降维处理,甚至降维之后还要再使用上面提到的状态压缩技巧
题目信息中会有很多关键词,这些关键词对于猜测tag至关重要。比如题目中出现连续子串、连续子数组,那么就可能使用滑动窗口。如果题目中出现有序,就有可能使用双指针。除此之外,复杂度也是一个很好的提示。O(1)空间复杂度意味着可能要使用原地算法,就有可能需要进行数据压缩。如果时间复杂度要求O(logn)就有可能需要二分法。比如题目要求最小距离、最小次数。那么就有可能需要使用BFS来解决。题目中提到树,并且数据规模不大,可以通过递归来解决。再比如让你求出所有的组合,那么就很有可能使用回溯法,但是一定要注意数据规模,并进行必要的剪枝处理,不然容易超时。再比如,题目中包含以下信息:
● 比当前元素更大的下一个元素;
● 比当前元素更大的前一个元素;
● 比当前元素更小的下一个元素;
● 比当前元素更小的前一个元素。
这就告诉我们很可能可以使用单调栈来解决。比如第42题接雨水,第84题柱状图中最大的矩形,第496题下一个更大的元素I,第503题下一个更大的元素II,第739题每日温度,第901题股票的价格跨度等。
① 单调递减栈:找“大佬”
当一个新元素 $X$ 准备入栈,发现它比栈顶元素 $Top$ 大 时,$Top$ 就被“踢出”了。
对 $Top$ 来说 :这个把扣踢出去的 $X$,就是它在右边遇到的第一个比它大 的元素。应用场景 :下一个更大元素 :如你刚才做的题目。接雨水 :寻找左右两边的高地,形成一个“凹槽”来存水。每日温度 :找多少天后气温会升高。② 单调递增栈:找“洼地”
当一个新元素 $X$ 准备入栈,发现它比栈顶元素 $Top$ 小 时,$Top$ 同样被“踢出”。
对 $Top$ 来说 :这个 $X$ 就是它右边遇到的第一个比它小 的元素。应用场景 :柱状图中最大的矩形 :为了让矩形尽可能宽,高度必须受限于两边第一个比它矮的柱子。去除重复字母 :在保证字典序最小的前提下保留字符。无论哪种栈,入栈和出栈的瞬间都隐藏了关键信息:
目标 使用哪种栈 什么时候记录答案? 右侧 第一个比它大 单调递减栈 元素 $X$ 弹出 栈顶 $Top$ 时,答案是 $X$ 左侧 第一个比它大 单调递减栈 元素 $X$ 压入 栈中后,答案是此时的新栈顶下方那个数 右侧 第一个比它小 单调递增栈 元素 $X$ 弹出 栈顶 $Top$ 时,答案是 $X$ 左侧 第一个比它小 单调递增栈 元素 $X$ 压入 栈中后,答案是此时的新栈顶下方那个数
数据结构之王:LRU 缓存 (Least Recently Used) 这道题是大厂出镜率最高 的题目,没有之一。它考察的不仅是算法,更是你对复合数据结构 的理解。
题目内容 :实现 LRU缓存 机制,要求 get 和 put 都是 $O(1)$ 时间复杂度。考察核心 :哈希表 + 双向链表 。面试官想看什么 :你是否能手写双向链表的节点删除和插入,是否考虑了线程安全(如果是 Java 面试),以及对空间复杂度的权衡。数组与指针:接雨水 (Trapping Rain Water) 如果说 LRU 是数据结构的必考,那么接雨水就是双指针和单调栈 的巅峰。
题目内容 :给定 $n$ 个非负整数表示每个柱子的高度,计算按此排列的柱子,下雨能接多少雨水。考察核心 :双指针 、单调栈 或动态规划 。面试官想看什么 :你能不能从 $O(n^2)$ 的暴力解法优化到 $O(n)$。这道题能一眼看出一个候选人的算法上限。树论基础:二叉树的最近公共祖先 (LCA) 二叉树题目中,LCA 是区分度最高的一道。
题目内容 :给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。考察核心 :递归 、回溯 。面试官想看什么 :你对递归边界的控制能力。很多候选人能写出代码,但说不清为什么当 left 和 right 都不为空时,当前节点就是祖先。排序与选择:前 K 个高频元素 / 第 K 大的数 这类题目直接对应业务场景(如:排行榜、热门搜索)。
考察核心 :堆排序 (Heap) 或 快速选择 (Quick Select) 。面试官想看什么 :如果你用 sort 函数,面试直接结束。他想看你能不能用 $O(n \log k)$ 甚至 $O(n)$ 的时间复杂度解决问题,并让你手写一个大顶堆或小顶堆。动态规划入门与进阶:最长递增子序列 (LIS) 大厂面试必有一道 DP(动态规划)。
考察核心 :状态转移方程的推导 。面试官想看什么 :你能写出 $O(n^2)$ 的 DP 是及格,如果你能写出 $O(n \log n)$ 的“贪心 + 二分查找”解法,那就是优秀。大厂面试高频分类表
类别 必刷经典题 核心技巧 链表 反转链表、环形链表 II 快慢指针、虚拟头节点 二叉树 层次遍历、锯齿形遍历 BFS、队列应用 字符串 无重复字符的最长子串 滑动窗口、哈希表 排序 手写快排、归并排序 分治法、递归 场景题 100亿个URL去重、大文件排序 布隆过滤器、外部排序
https://noworneverev.github.io/leetcode_101 krahets/LeetCode-Book: 《剑指 Offer》《图解算法数据结构》《Krahets 笔面试精选 88 题》Python, Java, C++ 解题代码 一个标星25.5k⭐开源的编程题解仓库:leetcode - 知乎 doocs/leetcode: 🔥LeetCode solutions in any programming language | 多种编程语言实现 LeetCode、《剑指 Offer(第 2 版)》、《程序员面试金典(第 6 版)》题解 算法 krahets/hello-algo https://github.com/halfrost/LeetCode-Go labuladong.online 代码随想录 CodeTop 面试题目总结 codeforces-go/leetcode/SOLUTIONS.md at master · EndlessCheng/codeforces-go 分享|如何科学刷题? - 讨论 - 力扣(LeetCode)