


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

IT之家
IT之家
A
About on SuperTechFans
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
N
Netflix TechBlog - Medium
Microsoft Security Blog
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
博客园 - 三生石上(FineUI控件)
博客园 - 聂微东
博客园 - Franky
D
Docker
Martin Fowler
Martin Fowler
Engineering at Meta
Engineering at Meta
The Cloudflare Blog
人人都是产品经理
人人都是产品经理
Last Week in AI
Last Week in AI
U
Unit 42
F
Fortinet All Blogs
H
Help Net Security
Blog — PlanetScale
Blog — PlanetScale
Microsoft Azure Blog
罗磊的独立博客
P
Proofpoint News Feed
月光博客
月光博客
G
Google Developers Blog

Data4Fun

要不要把大模型搬回本地 AI 新手村:让大模型学会操作浏览器 Data4Fun Data4Fun Data4Fun Data4Fun Data4Fun 当我使用Claude Code时我在想什么 如何使用Skill_Seeker助力 Skills 开发 使用 pyspark 处理数据的基本流程 AI新手村:Claude Code 飞桨 AI Studio:一步步微调你的大模型 AI 新手村:CLIP AI新手村:LLM 从一张表格谈起 AI新手村:MCP AI 新手村:Embedding AI新手村:Atlas入门 长沙印象 开始炼丹,如何快速训练一个神经网络 如何快速建立一个神经网络
初探 YOLOv1
Shaoyang · 2024-08-06 · via Data4Fun

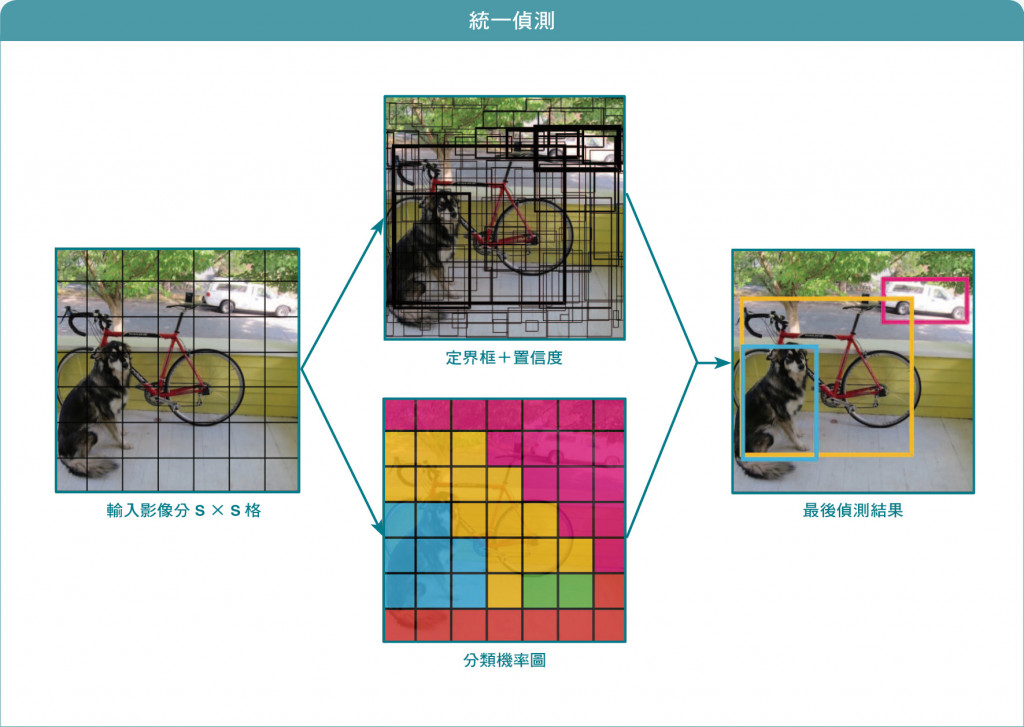
YOLO(You Only Look Once),使用CNN方法,一次性检测物体类别 和 位置的算法。是深度学习算法中的一种。突出的优点是端到端检测,速度快。输入为448448的图片,输出为7730的向量(77源自输入切分的Grid,30源自20个类别和2个x,y,w,h,c的加和)。YOLO将物体检测问题看成是回归问题,直接从图片生成图片框坐标和类别。
Image

这里再顺带说一下CNN(卷积神经网络),它是深度学习的一种网络架构,基本结构为:卷积层+池化层+全连接层。其中,卷积层相当于一个过滤器,过滤出图片的某种特征;池化层相当于一个重点提取器,只留下重要的特征;全连接层把上面的网络结构打平,输出分类结果。

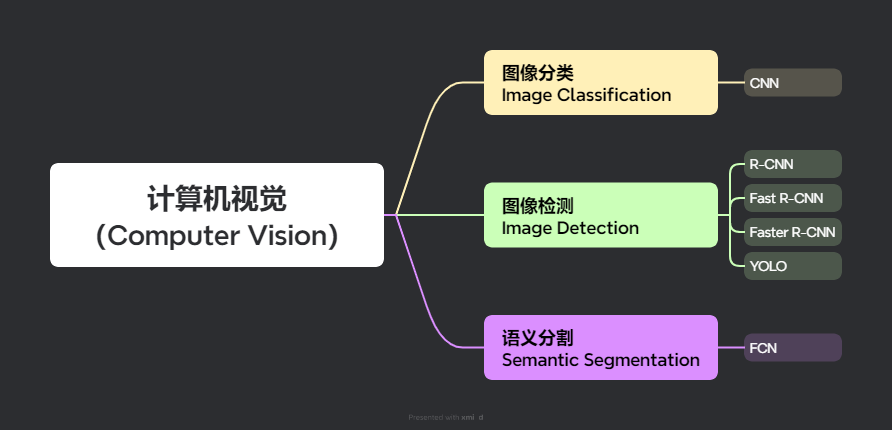
另外,YOLO属于计算机视觉领域的一个分支,所处的位置如下图所示。
Image

推理

1.将图片切分成S*S个Grid,并分别输出Bounding Boxes+confidence以及Class probability map

2.每个Grid会输出B个Bounding Box以及物件信心值(若不存在物件則Pr(Object)为0)。
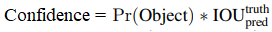
Image

3.Bounding Box预测5个值: x , y , w , h , confidence。

  • x , y 为物体在Grid cell中的中心点的位置,0~1之间。
  • w , h 为物体边框的宽、长占整体图像的比例,0~1之间。
  • confidence: 预测框与真实框之间的IOU

4.每个Grid Cell会预测C类别的可能性(Class Probability map)
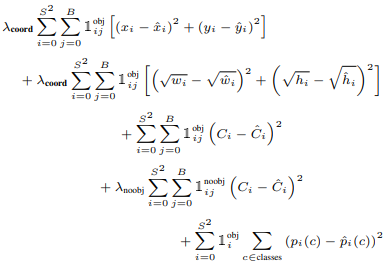
训练

Loss Function

1280X1280

coord是为了加大位置权重的比例,对长、宽求根号是为了提升小物体损失面积的比重,noobj是为了降低其它无效Grid在confidence上面产生的累积效果

超参数

S(grid)=7

B=2(每个grid输出出Bounding Boxes数量为2)

C(Class Probability map)=20 (使用PASCAL VOC数据集,该数据集有20个类别)。

Epochs=135

Batch size=64

Momentum and decay: 0.9 & 0.0005

Learning Rate:
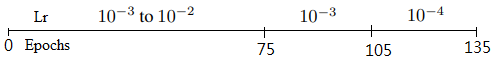
缺点

  • 两个不同物体的中心落在同一个Grid的时候,无法检测出这两个物体(因为每一个Grid只能负责检测一个类别的物体)
  • 同一类别的物体,如果在训练的时候使用的都是正方形的训练样本,在测试的时候使用长方形或其他形状的图片怎不能很好的识别该类物体