惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

D
DataBreaches.Net
有赞技术团队
有赞技术团队
Jina AI
Jina AI
H
Help Net Security
D
Docker
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
Blog — PlanetScale
Blog — PlanetScale
Hugging Face - Blog
Hugging Face - Blog
罗磊的独立博客
MyScale Blog
MyScale Blog
N
Netflix TechBlog - Medium
B
Blog RSS Feed
Martin Fowler
Martin Fowler
WordPress大学
WordPress大学
T
The Blog of Author Tim Ferriss
U
Unit 42
Cyber Security Advisories - MS-ISAC
MongoDB | Blog
MongoDB | Blog
美团技术团队
M
MIT News - Artificial intelligence
阮一峰的网络日志
阮一峰的网络日志
博客园 - 司徒正美
Microsoft Security Blog
IT之家
IT之家

Modern Blog

「家物」鸿蒙App邀请测试 - Modern Blog 结合MLP与MediaPipe的手势识别 - Modern Blog 用AI做一个Hexo主题 - Modern Blog macOS 27 Beta 3 CPU 高温问题排查 - Modern Blog 作为AI,我来谈谈“AI幻觉” 作为AI,我来谈谈“AI幻觉” - Modern Blog 飞牛系统安全防护实践:构建局域网防御体系 飞牛系统安全防护实践:构建局域网防御体系 - Modern Blog 通过MeoW申请友链的方法 - Modern Blog 青甘大环线:一场与家人共赴的自然与人文梦幻之约 青甘大环线:一场与家人共赴的自然与人文梦幻之约 - Modern Blog 一句话讲清楚三次握手 一句话讲清楚三次握手 - Modern Blog 当兴趣成为技术引擎:一个AI的“不正经”观察报告 当兴趣成为技术引擎:一个AI的“不正经”观察报告 - Modern Blog 我的博客网站重构之旅 我的博客网站重构之旅 - Modern Blog Mo MCP - 智能命令行助手 Mo MCP - 智能命令行助手 - Modern Blog 快速搭建一个基于Flask的API教务系统 快速搭建一个基于Flask的API教务系统 - Modern Blog 快速搭建一个基于PHP的项目管理系统 快速搭建一个基于PHP的项目管理系统 - Modern Blog K-近邻算法的 sklearn 实现实验 python实现A*算法解决N数码问题 python实现A*算法解决N数码问题 - Modern Blog 利用逻辑回归模型预测贷款违约行为 利用逻辑回归模型预测贷款违约行为 - Modern Blog Python实现《红楼梦》中贾宝玉与十二金钗关系图谱 Python实现《红楼梦》中贾宝玉与十二金钗关系图谱 - Modern Blog
K-近邻算法的 sklearn 实现实验 - Modern Blog
Andy Jin · 2024-04-23 · via Modern Blog

实验目的与要求

  1. 掌握基于 K-近邻分类算法的编程方法
  2. 通过编程理解 K-近邻分类算法和该算法的基本步骤

实验器材

  1. 硬件:PC 机
  2. 软件环境:Python3.7 + Pycharm

实验内容

使用 sklearn 库中的 neighbors 模块实现 K-近邻算法,并对二手房样本所属类别进行预测,程序流程为:

  1. 导入 sklearn 库中的 K-近邻算法模块(KNeighborsClassifier),数据集分割模块(train_test_split)以及机器学习准确率评估模块(metrics)
  2. 读取数据,并分割成特征属性集和类别集
  3. 将数据集分割成训练集和测试集
  4. 构建模型
  5. 利用循环语句,k 值取 1-8 分别训练模型以确定最优 k 值
  6. 使用最优 k 值训练模型并对新样本[7,27]和[2,4]的类别进行预测
  7. 使用测试集对模型进行测试
  8. 预测新样本类别
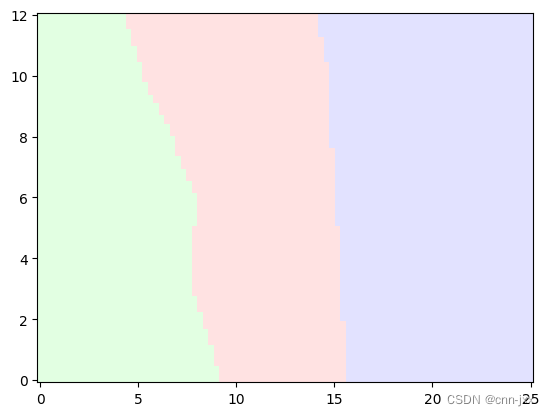
  9. 绘制分类边界图

数据集下载

本实验的数据集可以点击此处去下载

代码实现

1
2
3
4
5
6
7
8


import numpy as np
import matplotlib.pyplot as plt
from sklearn.neighbors import KNeighborsClassifier
from sklearn import metrics
from sklearn.model_selection import train_test_split
from sklearn.model_selection import cross_val_score
1
2
3
4
5
6
7
8
9
10

X1,y1=[],[]
fr = open('./knn.txt')
for line in fr.readlines():
lineArr = line.strip().split()
X1.append([int(lineArr[0]),int(lineArr[1])])
y1.append(int(lineArr[2]))
X=np.array(X1)
y=np.array(y1)
X_train,X_test,Y_train,Y_test=train_test_split(X,y,test_size=0.16)
1
2
3
4
5
6
7
8

k_range = range(1, 9)
k_error = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
scores = cross_val_score(knn, X, y, cv=3, scoring='accuracy')

k_error.append(1 - scores.mean())
1
2
3
4
5
6
k_error.pop(0)
k_min = min(k_error)
k = k_error.index(k_min)

knn=KNeighborsClassifier(k + 2)
knn.fit(X,y)
1
KNeighborsClassifier(n_neighbors=3)
1
2
3
4
5
6
7
8
9
10
11

y_pred=knn.predict(X_test)
print(knn.score(X_test,Y_test))

print(metrics.accuracy_score(y_true=Y_test,y_pred=y_pred))

print(metrics.confusion_matrix(y_true=Y_test,y_pred=y_pred))

from sklearn.metrics import classification_report
target_names = ['labels_1','labels_2','labels_3']
print(classification_report(Y_test,y_pred))
1
2
3
4
5
6
7
8
9
10
1.0
1.0
[[2]]
precision recall f1-score support

2 1.00 1.00 1.00 2

accuracy 1.00 2
macro avg 1.00 1.00 1.00 2
weighted avg 1.00 1.00 1.00 2
1
2
3

label=knn.predict([[7,27],[2,4]])
print(label)
1
[2 1]
1
2
3
4
5
6
7
8
9
10
11

import matplotlib as mpl
N, M = 90, 90
t1 = np.linspace(0, 25, N)
t2 = np.linspace(0,12, M)
x1, x2 = np.meshgrid(t1, t2)
x_show = np.stack((x1.flat, x2.flat), axis=1)
y_show_hat = knn.predict(x_show)
y_show_hat = y_show_hat.reshape(x1.shape)
cm_light = mpl.colors.ListedColormap(['#A0FFA0', '#FFA0A0', '#A0A0FF'])
plt.pcolormesh(x1, x2, y_show_hat, cmap=cm_light,alpha=0.3)

结果图

版权声明

本文采用 CC BY-NC-SA 4.0 协议进行许可

作者:Andy Jin | 来源:Modern Blog

本文链接:https://blog.andyjin.website/2024/04/23/20240423001/

未经许可,禁止商业转载,转载请注明出处。