





 OpenRouter на днях анонсував 50% знижки на OpenAI, і вирішили спробувати його.
Переключення будемо робити на LiteLLM, на яку вже йдуть запити від всіх наших сервісів – тому переключення буде доволі простим.
До OpenRouter в LiteLLM налаштуємо fallbacks напряму до OpenAI – на ті випадки, коли реквести до OpenRouter фейляться.
Зміст
Взагалі все, що треба – це описати новий LiteLLM Deployment, модель, і для неї вказати api_base == OpenRouter та власний API Key.
Єдина відмінність – це ім’я моделі: якщо при прямих викликах до OpenAI ми вказуємо model = openai/gpt-4.1-nano, то для OpenRouter це буде model = openrouter/openai/gpt-4.1-nano, див. OpenRouter Completion Models.
Отримати список всіх моделей можна з OpenRouter API, див. документацію Models.
$ curl -s "https://openrouter.ai/api/v1/models" | jq ".data[].id" | head
"qwen/qwen3.7-flash"
"anthropic/claude-opus-5-fast"
"anthropic/claude-opus-5"
"inclusionai/ling-3.0-flash:free"
"poolside/laguna-s-2.1"
"poolside/laguna-s-2.1:free"
"google/gemini-3.6-flash"
"google/gemini-3.6-flash:batch"
"google/gemini-3.5-flash-lite"
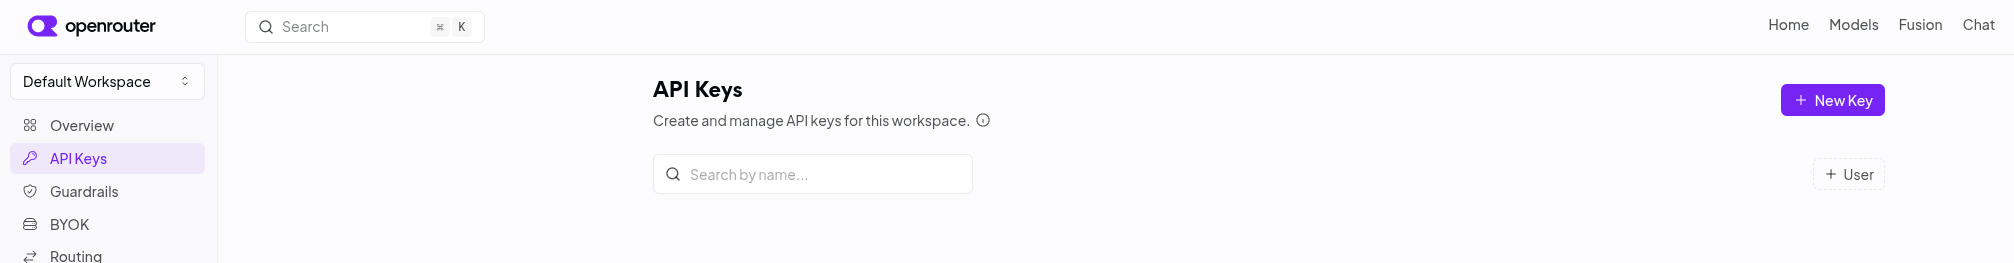
Реєструємось в OpenRouter, переходимо в API Keys потрібного OpenRouter Workspace, створюємо OpenRouter API Key:
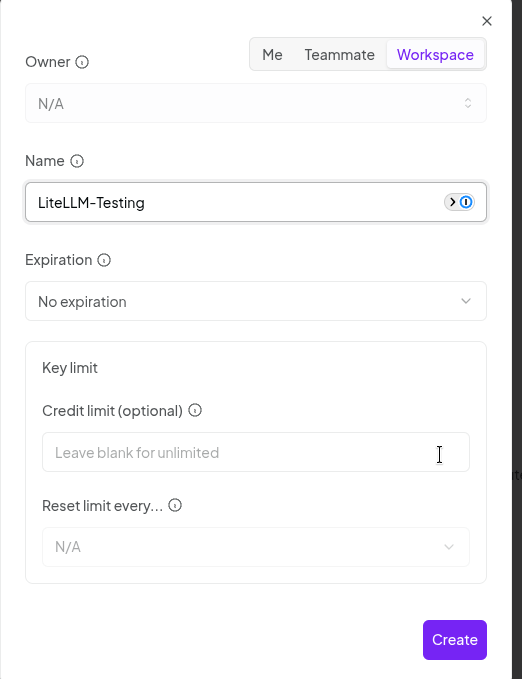
В OpenRouter, до речі, можна задати власні ліміти на ключі:
Додаємо нову модель, тут для тесту в model_name вкажемо власне ім’я – але в production використовуємо “загальне”, яке очікуємо від клієнтів.
В api_base перевизначаємо власний URL для OpenRouter API, див. Using the OpenRouter API, а в api_key – API Key, який створили вище:
...
    model_list:

      - model_name: or-gpt-4.1-mini
        litellm_params:
          model: openrouter/openai/gpt-4.1-mini
          api_base: https://openrouter.ai/api/v1
          api_key: os.environ/OPENROUTER_API_KEY
...
Поки тестуємо – змінну з ключем можна передати в Helm через envVars, в production це робиться через External Secrets Operator (див. AWS: Kubernetes та External Secrets Operator для AWS Secrets Manager та LiteLLM: AI Gateway в Kubernetes та метрики до VictoriaMetrics):
...
  envVars:
    OPENROUTER_API_KEY: "sk-or-v1-***"
...
Перевіряємо з curl:
$ curl -sS -D /tmp/headers 'https://aigw.test.example.co/chat/completions' -H 'Content-Type: application/json' -H "Authorization: Bearer $LITELLM_TESTING_KEY" --data ' { "model": "or-gpt-4.1-mini", "messages": [ { "role": "user", "content": "what llm are you" } ] } '  | jq
{
  "id": "gen-1785490640-Tbfwc5Rlx7cyhqpxzSB6",
  "created": 1785490640,
  "model": "or-gpt-4.1-mini",
  ...
В заголовках маємо всю цікаву інформацію (роблю через -D у файл, щоб jq нормально працював):
$ cat /tmp/headers
...
x-litellm-model-name: openrouter/openai/gpt-4.1-mini
x-litellm-model-api-base: https://openrouter.ai/api/v1
...
Але коли викотили OpenRouter на “тестовий production” – почали ловити 429 помилки, а тому треба було додати fallbacks на OpenAI.
Ліміти описані в Credit Limits and Rate Limits, і хоча у нас не free моделі – але помилки ловимо.
Да і в будь-якому випадку fallbacks мати треба.
OpenRouter теж підтримує Automatic failover between models, але для цього треба робити зміни в коді клієнтів – а ми хочемо максимально прозоро і з мінімум змін на клієнтах.
Тому налаштуємо з LiteLLM, див. Fallbacks (Provider Failover).
В документації LiteLLM трохи mess (вже не перший раз, btw), бо в одному прикладі описано як litellm_settings.fallbacks – а в іншому в router_settings.fallbacks.
Але більш коректним саме router_settings, бо він має пріорітет – router.py:
...

      _fallbacks = fallbacks or litellm.fallbacks

...
А fallbacks “приходить” саме із router_params в proxy_server.py:
...
router = litellm.Router(
    **router_params,
...
Формат доволі простий – “модель, для якої вказуємо fallback : список моделей, на які роутимо при проблемах”:
router_settings:
  fallbacks: [{"<QUERY_MODEL>": ["<FALLBACK_MODEL1>","<FALLBACK_MODEL2>"]}]
Плюс можна задати загальний, а не model-specific fallback, див. Default Fallbacks:
router_settings:
  default_fallbacks: ["claude-opus"]
(знов-таки – в документації він заданий в litellm_settings замість router_settings, хоча працює однаково в обох випадках)
Ну і давайте спробуємо, як це працює.
Додаємо fallback для нашої тестової моделі:
router_settings:
  fallbacks: [{"or-gpt-4.1-mini": ["gpt-4.1-mini"]}]
А в самій моделі – “ламаємо” api_base через неправильний порт:
model_list:
  - model_name: or-gpt-4.1-mini
    litellm_params:
      model: openrouter/openai/gpt-4.1-mini
      api_base: https://openrouter.ai:8000/api/v1
      api_key: os.environ/OPENROUTER_API_KEY
Повторюємо запит:
$ curl -sS -D /tmp/headers 'https://aigw.test.example.co/chat/completions' -H 'Content-Type: application/json' -H "Authorization: Bearer $LITELLM_TESTING_KEY" --data ' { "model": "or-gpt-4.1-mini", "messages": [ { "role": "user", "content": "what llm are you" } ] } '  | jq
{
  "id": "chatcmpl-E7eVkBzpdbWp5n6JagYlYHTlEEI1f",
  "created": 1785492728,
  "model": "gpt-4.1-mini-2025-04-14",
  ...
І заголовки – відповідь вже від OpenAI:
$ cat /tmp/headers | grep x-litellm-model
x-litellm-model-id: 8b2d27fc9982e18f87ed59ca8c8b0d02c52546f26ece314f17d14433ed6498c2
x-litellm-model-name: openai/gpt-4.1-mini
x-litellm-model-api-base: https://api.openai.com
x-litellm-model-group: gpt-4.1-mini
Див. Fallbacks + Retries + Timeouts + Cooldowns.
Для fallback routing можна задати кілька корисних опцій:
num_retries: скільки раз повторити запит в основній model group перед переходом до fallback-моделі
timeout: скільки часу чекати відповіді перед тим, як перенаправити запити до fallback model
timout починається наступний num_retries, якщо там задано більше 1, і тільки потім – до fallback modeallowed_fails: скільки failed requests до моделі допустимо перед тим, як модель перейти в cooldown
cooldown_time: скільки часу секундах модель буде “відключена” від загального роутингуТут знов-таки документація трохи… крива, бо, наприклад, описано “allowed_fails: 3 # cooldown model if it fails > 1 call in a minute“, ну і замість “in a minute“, мабуть, малось на увазі 30 секунд в прикладі з cooldown_time.
Звісно, спрацювання – і помилки – фолбеків бажано моніторити.
У LiteLLM з коробки є метрики, див. Fallback (Failover) Metrics:
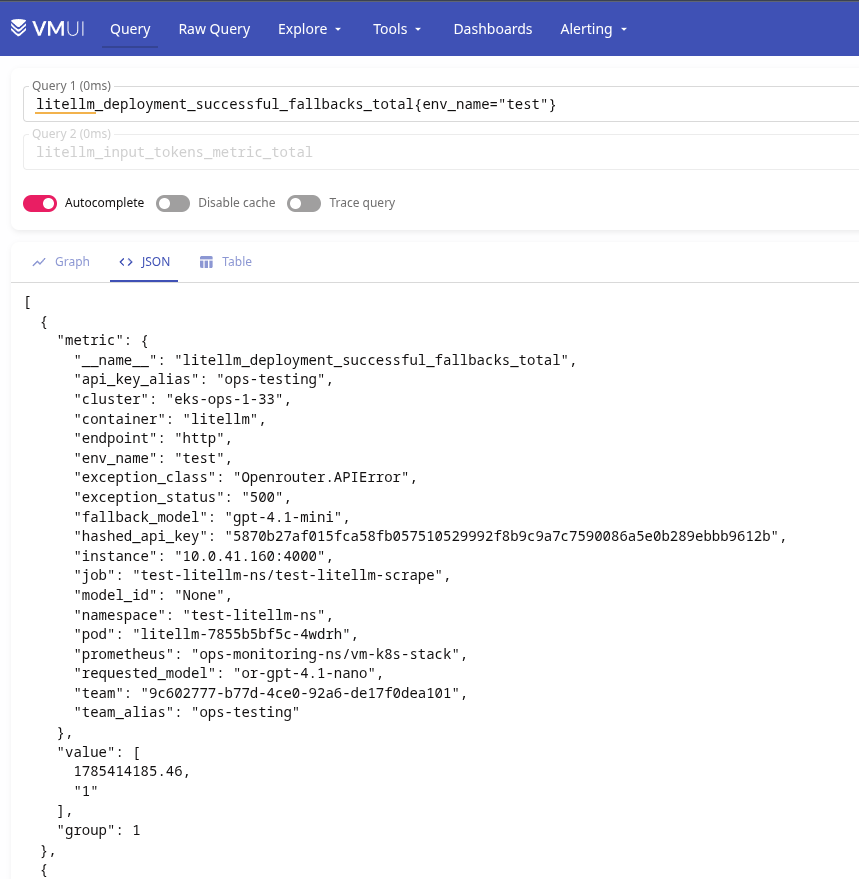
Тут:
litellm_deployment_cooled_down: скільки раз deployment (модель) переводилась в стан cooldownlitellm_deployment_successful_fallbacks: кількість успішних спрацювань fallbackslitellm_deployment_failed_fallbacks: кількість помилок при fallbacksІ приклад алерту:
- alert: LiteLLM Deployment Failed Fallback
  expr: |
    sum by (requested_model, fallback_model, api_key_alias, team_alias, exception_class, exception_status) (
      increase(litellm_deployment_failed_fallbacks_total[5m])
    ) > 0
  for: 30s
  labels:
    component: devops
    environment: ops
    severity: critical
    ilert_routingkey: devops-ops-critical
  annotations:
    summary: LiteLLM Deployment Failed Fallback
    description: |-
      LiteLLM failed to handle a request using a fallback model during the last 5 minutes.
      *Failed fallbacks*: `{{ "{{" }} $value }}`
      *Requested model*: `{{ "{{" }} $labels.requested_model }}`
      *Fallback model*: `{{ "{{" }} $labels.fallback_model }}`
      *API key alias*: `{{ "{{" }} $labels.api_key_alias }}`
      *Team alias*: `{{ "{{" }} $labels.team_alias }}`
      *Exception class*: `{{ "{{" }} $labels.exception_class }}`
      *Exception status*: `{{ "{{" }} $labels.exception_status }}`
      <https://{{ $.Values.monitoring.root_url }}/d/adtt9jj/adrmshg/litellm-system-overview |:grafana: LiteLLM System overview>
У нас є сервіси, які хочуть продовжувати ходити на OpenAI – але ми не хочемо нічого міняти в їх коді, тобто model_name має залишитись, як є.
Тут є кілька варіантів, див. документацію Tag Based Routing:
Створюємо новий ключ, правда при створенні ключа йому не мона відразу вказати Tags, бо “This feature is only available for LiteLLM Enterprise“.
Але можна створити ключ – а потім в його Settings вже задати потрібний Tag:
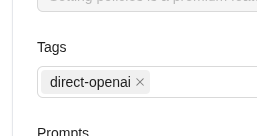
І аналогічно – ключ з тегом “direct-openrouter“.
До router_settings додаємо enable_tag_filtering=true, а в model_list описуємо model group – два деплоймента з однаковим model_name, але різними умовами в tags:
router_settings:
  enable_tag_filtering: True

model_list:

  - model_name: or-gpt-4.1-mini
    litellm_params:
      model: openrouter/openai/gpt-4.1-mini
      api_base: https://openrouter.ai/api/v1
      api_key: os.environ/OPENROUTER_API_KEY
      tags: ["direct-openrouter"]

  - model_name: or-gpt-4.1-mini
    litellm_params:
      model: openai/gpt-4.1-mini
      api_key: os.environ/OPENAI_API_KEY
      tags: ["direct-openai"]
Робимо запит з ключем “direct-openai“:
$ curl -sS -D /tmp/openai 'https://aigw.test.example.co/chat/completions' -H 'Content-Type: application/json' -H "Authorization: Bearer sk-***" --data ' { "model": "or-gpt-4.1-mini", "messages": [ { "role": "user", "content": "what llm are you" } ] } ' | jq
{
  "id": "chatcmpl-E7f89zMEtza5liQnm8uBVQaaBcyVv",
  "created": 1785495109,
  "model": "gpt-4.1-mini-2025-04-14",
  ...
Маємо відповідь від OpenAI:
$ cat /tmp/openai | grep x-litellm-model
x-litellm-model-id: b1cd50178d84ad641058301b47c9f171d86337bcc7f0c08dc425f9f44ec2dffd
x-litellm-model-name: openai/gpt-4.1-mini
x-litellm-model-api-base: https://api.openai.com
І з ключем “direct-openrouter“:
$ curl -sS -D /tmp/openrouter 'https://aigw.test.example.co/chat/completions' -H 'Content-Type: application/json' -H "Authorization: Bearer sk-***" --data ' { "model": "or-gpt-4.1-mini", "messages": [ { "role": "user", "content": "what llm are you" } ] } ' | jq
{
  "id": "gen-1785495093-Toi3dLdjHJ692Ue8bFgl",
  "created": 1785495093,
  "model": "or-gpt-4.1-mini",
  ...
Маємо відповідь від OpenRouter:
$ cat /tmp/openrouter | grep x-litellm-model
x-litellm-model-name: openrouter/openai/gpt-4.1-mini
x-litellm-model-api-base: https://openrouter.ai/api/v1
Інший варіант – не додавати теги вручну, а просто використати User Agent з headers.
В документації Regex-based tag routing (tag_regex) tag_regex описаний як “Use tag_regex on a deployment to match incoming requests by their headers” – тобто наче по будь-якому заголовку, але по факту враховується тільки User-Agent (якщо я правильно прочитав код):
...
        # Build header strings for regex matching from what the proxy already stores.
        # Currently we match against User-Agent; format matches "^User-Agent: claude-code/..."
        user_agent = metadata.get("user_agent", "")
        header_strings: list[str] = [f"User-Agent: {user_agent}"] if user_agent else []
...
Втім, в моєму випадку цього достатньо – бо один сервіс у нас це TypeScript з user-agent = "OpenAI/JS 6.26.0", а інший – Python з user-agent = "OpenAI/Python 2.45.0".
Міняємо умови в моделях, описуємо regex:
- model_name: or-gpt-4.1-mini
  litellm_params:
    model: openrouter/openai/gpt-4.1-mini
    api_base: https://openrouter.ai/api/v1
    api_key: os.environ/OPENROUTER_API_KEY
    tag_regex:
      - '^User-Agent: OpenAI/JS '

- model_name: or-gpt-4.1-mini
  litellm_params:
    model: openai/gpt-4.1-mini
    api_key: os.environ/OPENAI_API_KEY
    tag_regex:
      - '^User-Agent: OpenAI/Python '
Робимо запит з “основним” тестовим ключем (де нема тегів), але явно передаємо -H 'User-Agent: OpenAI/JS 6.26.0':
$ curl -sS -D /tmp/js-headers 'https://aigw.test.example.co/chat/completions' -H 'Content-Type: application/json' -H "Authorization: Bearer $LITELLM_TESTING_KEY" -H 'User-Agent: OpenAI/JS 6.26.0'   --data '{    "model": "or-gpt-4.1-mini",
    "messages": [{
      "role": "user",
      "content": "JS routing test unique-001"
    }]
  }' | jq
{
  "id": "gen-1785495531-69Gu3ziqrjBmlNyEx3Jo",
  "created": 1785495531,
  "model": "or-gpt-4.1-mini",
  ...
Відповідь отримали від OpenRouter:
$ cat /tmp/js-headers
...
x-litellm-model-name: openrouter/openai/gpt-4.1-mini
x-litellm-model-api-base: https://openrouter.ai/api/v1
...
І аналогічний запит, але з -H 'User-Agent: OpenAI/Python 2.45.0' :
$ curl -sS -D /tmp/python-headers   'https://aigw.test.example.co/chat/completions'   -H 'Content-Type: application/json'   -H "Authorization: Bearer $LITELLM_TESTING_KEY"   -H 'User-Agent: OpenAI/Python 2.45.0'   --data '{
    "model": "or-gpt-4.1-mini",
    "messages": [{
      "role": "user",
      "content": "Python routing test unique-001"
    }]
  }' | jq
{
  "id": "chatcmpl-E7fFeVdB0ZWynqc5JxO3d4lUA4Gqf",
  "created": 1785495574,
  "model": "gpt-4.1-mini-2025-04-14",
  ...
І отримали відповідь від OpenAI:
$ cat /tmp/python-headers
x-litellm-model-name: openai/gpt-4.1-mini
x-litellm-model-api-base: https://api.openai.com
Готово.

此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。