







接收者操作特征曲线(ROC)是二元分类器的另一个常用工具。它与精确度/召回率曲线非常相似,但 ROC 曲线不是绘制精确度与召回率的关系曲线,而是绘制真阳性率(召回率的另一个名称)与假阳性率(FPR)的关系曲线。FPR(也称 “下降率”)是阴性实例被错误归类为阳性实例的比率。它等于 1 - 真阴性率 (TNR),即正确分类为阴性的阴性实例的比率。TNR 也称为特异性。因此,ROC 曲线是灵敏度(召回率)与 1 - 特异性的关系图
要绘制 ROC 曲线,首先要使用 roc_curve() 函数计算不同阈值的 TPR 和 FPR:
from sklearn.metrics import roc_curve
fpr, tpr, thresholds = roc_curve(y_train_5, y_scores)
然后可以使用 Matplotlib 绘制 FPR 与 TPR 的对比图。下面的代码可以绘制出 见下图 所示的图形。要找到与 90% 精度相对应的点,我们需要查找所需阈值的索引。由于在这种情况下阈值是按递减顺序排列的,因此我们在第一行使用 <= 而不是 >=:
idx_for_threshold_at_90 = (thresholds <= threshold_for_90_precision).argmax()

tpr_90, fpr_90 = tpr[idx_for_threshold_at_90], fpr[idx_for_threshold_at_90]

plt.plot(fpr, tpr, linewidth=2, label="ROC curve")
plt.plot([0, 1], [0, 1], 'k:', label="Random classifier's ROC curve") plt.plot([fpr_90], [tpr_90], "ko", label="Threshold for 90% precision") [...]  # beautify the figure: add labels, grid, legend, arrow, and text plt.show()

这也是一种权衡:召回率(TPR)越高,分类器产生的误报(FPR)就越多。虚线表示纯随机分类器的 ROC 曲线;好的分类器会尽可能远离这条曲线(左上角)。
比较分类器的一种方法是测量曲线下面积(AUC)。完美分类器的 ROC AUC 等于 1,而纯粹随机分类器的 ROC AUC 等于 0.5。Scikit-Learn 提供了一个估算 ROC AUC 的函数:
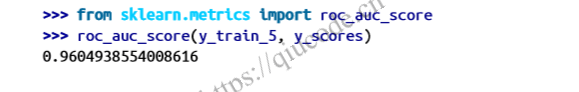
由于 ROC 曲线与精确度/召回(PR)曲线非常相似,您可能会想知道如何决定使用哪种曲线。根据经验,如果阳性类别很少,或者您更关心假阳性而不是假阴性,那么您应该首选 PR 曲线。否则,请使用 ROC 曲线。例如,看了前面的 ROC 曲线(和 ROC AUC 分数),你可能会认为分类器真的很不错。但这主要是因为阳性(5 分)与阴性(非 5 分)相比很少。相比之下,PR 曲线清楚地表明分类器还有改进的余地:曲线确实可以更靠近右上角。
现在,让我们创建一个 RandomForestClassifier,将其 PR 曲线和 F1 分数与 SGDClassifier 进行比较:
from sklearn.ensemble import RandomForestClassifier

forest_clf = RandomForestClassifier(random_state=42)
precision_recall_curve() 函数需要每个实例的标签和分数,因此我们需要训练随机森林分类器,让它为每个实例分配分数。但由于 RandomForestClassifier 类的工作方式,它没有 decision_function() 方法。幸运的是,它有一个 predict_proba()方法,可以返回每个实例的类概率,我们可以直接使用正类的概率作为得分,这样就可以正常工作了。我们可以调用 cross_val_predict() 函数,使用交叉验证训练随机森林分类器,并让它预测每张图片的类概率,如下所示:
y_probas_forest = cross_val_predict(forest_clf, X_train, y_train_5, cv=3, method="predict_proba")
让我们来看看训练集中前两幅图像的类别概率:
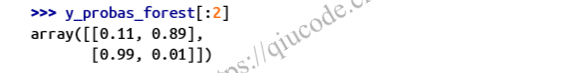
模型预测第一幅图像为正像的概率为 89%,预测第二幅图像为负像的概率为 99%。由于每幅图像要么是正像,要么是负像,因此每一行的概率相加等于 100%。
这些是估计概率,而不是实际概率。例如,如果您查看所有被模型归类为阳性的图像,估计概率在 50%-60%之间,那么其中大约 94% 的图像实际上是阳性的。因此,在这种情况下,模型的估计概率太低了,但模型也可能过于自信。
sklearn.calibration软件包包含校准估计概率的工具,可使其更接近实际概率。
第二列包含正分类的估计概率,我们将其传递给 precision_recall_curve() 函数:
y_scores_forest = y_probas_forest[:, 1] precisions_forest, recalls_forest, thresholds_forest = precision_recall_curve( y_train_5, y_scores_forest)
现在我们可以绘制 PR 曲线了。同时绘制第一条 PR 曲线,以了解两者之间的比较(见下图)
plt.plot(recalls_forest, precisions_forest, "b-", linewidth=2,         label="Random Forest")

plt.plot(recalls, precisions, "--", linewidth=2, label="SGD") [...]  # beautify the figure: add labels, grid, and legend plt.show()
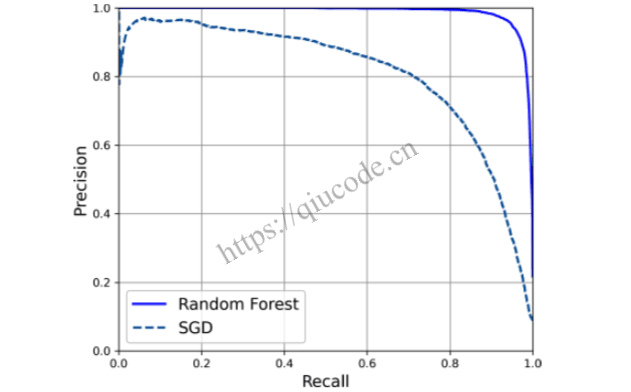
如图所示,RandomForestClassifier 的 PR 曲线比 SGDClassifier 好看得多:更接近右上角。其 F1 分数和 ROC AUC 分数也明显更好:
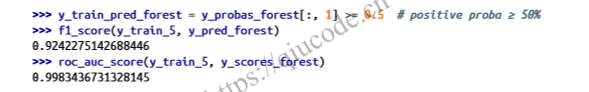
试着测量一下精确度和召回率:你会发现精确度约为 99.1%,召回率约为 86.6%。还不错!
现在,您已经知道如何训练二元分类器、为任务选择合适的指标、使用交叉验证评估分类器、选择适合您需要的精确度/召回率权衡,以及使用多种指标和曲线来比较各种模型。您已经准备好尝试检测更多信息,而不仅仅是 “5”。