












从N-gram的笨拙概率猜测到Transformer的量子阅读,AI已经完成了从7秒记忆到通用逻辑底座的惊人跃迁。2026年的文本大模型战场正演变为推理深度、工程效率和生态整合的多维战争,OpenAI、Google、Anthropic和DeepSeek各自押注不同未来。本文将带你穿透技术迷雾,看清那些让AI突然开窍的底层架构革命与工业炼金术。
2026 年的我们,已经很少再为“让AI干活”这件事感到惊讶了。
生活中遇到不懂的问题,下意识丢给豆包;查资料、写文章,DeepSeek、Chat GPT早已是默认选项;想生成简单视频,就找可灵或即梦。
这情景,就像人人都拥有了一个多啦A梦一样的魔幻。
从无人知晓,到小学生都开始用AI帮忙检查作业,也就只过去了两三年而已。
虽然大多数人已经把AI当成了一种“基础设施”,却很少有人去追问:这种能力究竟是怎么来的。
它看起来像是在某个瞬间突然出现的,但如果真的把时间轴拉开,就会发现,这条路走得一点也不突然,甚至可以说,走得相当艰难。
在大模型称霸之前,AI 圈主要有两类“祖先”较劲。
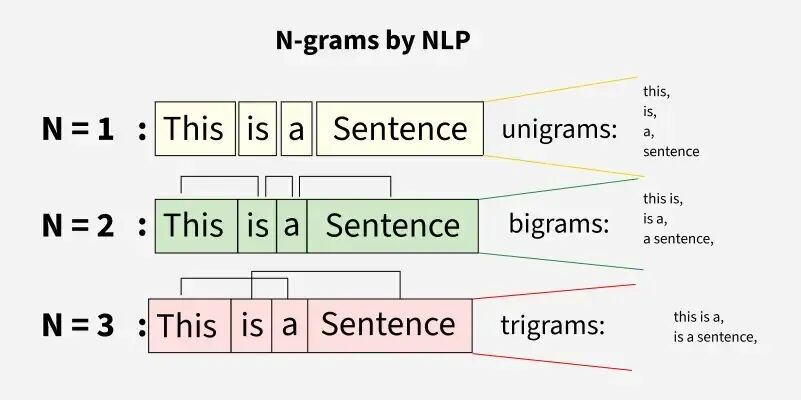
一类是老派的 N-gram。它纯粹靠概率:看到“北京是中国的首”,它根据统计猜下一个token是“都”,它完全不理解什么是国家或城市,只是个没有感情的概率预测机。
另一类则是神经网络派的 RNN(循环神经网络)及其进化版 LSTM。它们是文本大模型的直系祖先,第一次引入了“记忆”。但它们的记忆是一个词一个词地听,再一个词一个词地记,读到第 50 个词时,第 1 个词已经模糊了。最致命的是,这种串行结构,也让算力无法真正发挥作用,再强大的 GPU,在这里都只能排队等待。
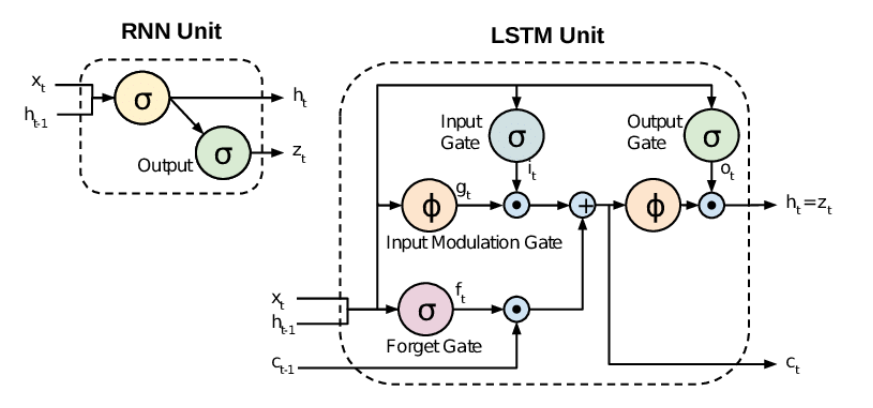
这种模型结构上的“天花板”,让 AI 的智力被死死锁在了原地。
在很长一段时间里,研究者们其实已经把能试的办法都试过了:更多数据、更复杂的门控、更深的网络、更大的参数量。但不管怎么折腾,模型依然被困在“顺序读取、逐步遗忘”的框架里。
转机发生在 2017 年。
那篇名为《Attention Is All You Need》的论文,在 2017 年横空出世,论文标题看起来略有点傲慢:别整那些没用的,只要有“注意力”就够了。
它提出了一种在当时看来颇为激进的想法:完全抛弃循环结构,只用注意力机制来建模序列关系,模型不再按顺序一步步推进,而是一次性看到所有词,通过计算彼此之间的关联强度,来决定信息如何流动。
后来我们把这种结构称为 Transformer,也正是从这里开始,文本大模型的时代,才真正拉开序幕。
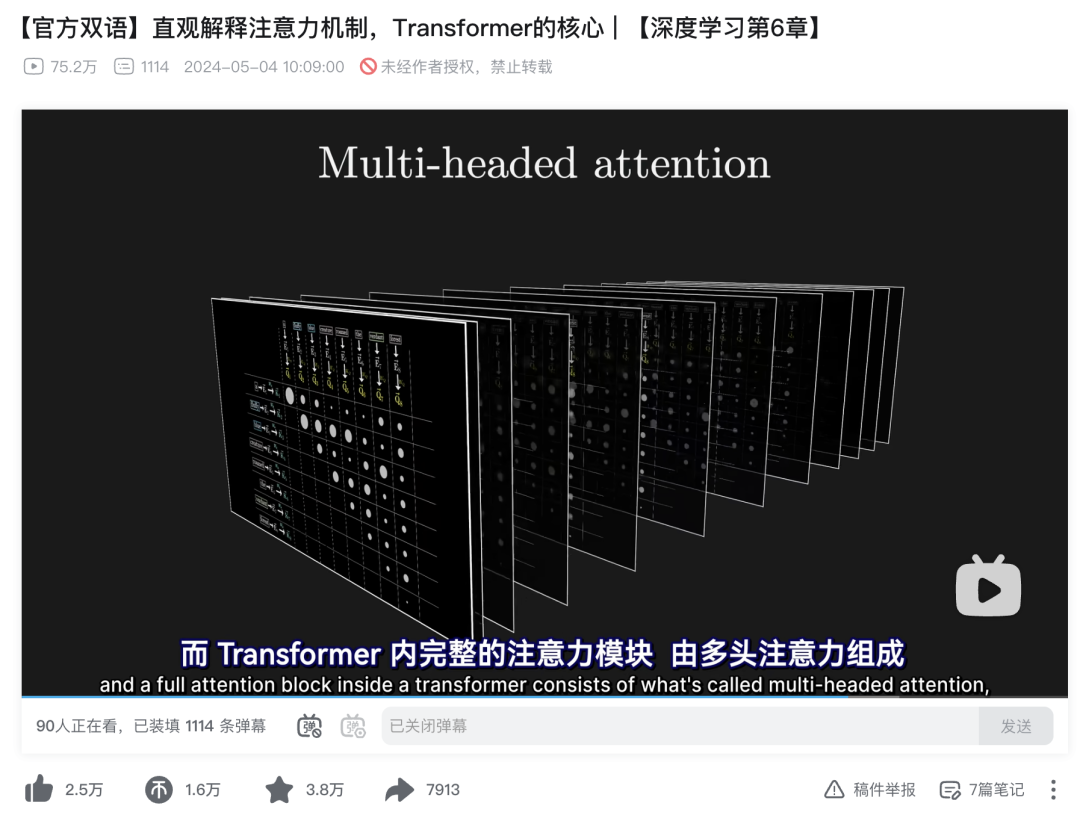
Transformer 放弃了串行处理方式,把“排队识字”变成了“量子阅读”,它引入了自注意力机制(Self-Attention),让模型学会了“找重点”,从此,机器可以同时处理整段文字,瞬间扫描并理解词与词之间跨越长距离的关联。
B站账号3Blue1Brown用视频清晰的解释了Transformer的原理,有兴趣可以去看原视频。
地址:https://www.bilibili.com/video/BV1TZ421j7Ke/?spm_id_from=333.1387.search.video_card.click&vd_source=46a6c59ab33ee91d2a13282c50bd501f
尴尬的是,Google 发明了火药,却没能点燃大烟花,这 8 位作者后来全部离开了 Google,散作满天星,成了 AI 创业浪潮里的主角。
其中最具代表性的,是一作 Ashish Vaswani。他离开后创立了Adept AI,试图把 Transformer 从“生成文本的模型”,推进到“能操作软件、完成任务的智能体”,继续探索模型与真实世界之间的连接方式。
另一位是 Noam Shazeer。他共同创立了Character.AI,把大模型带进角色扮演和情感陪伴等消费级场景,验证当语言足够自然时,人类会如何与模型建立关系。
其余作者则分散在基础研究、生物医药、分布式系统等不同方向。这种分散,本身说明了 Transformer 不仅是一种技术突破,更是一种底层通用的认知工具,点燃了一整代研究者和创业者对“智能可以如何生长”的想象力。
但有了 Transformer,并不代表智能就此诞生,要把这张图纸变成一个能写诗、会编程、懂情绪的数字生命,还需要经历一个极其漫长且昂贵的“淬炼”过程。
有了 Transformer ,并不代表智能就诞生了,顶级模型公司与其说是实验室,不如说更像是一座精密运转的超级工厂。无论公司背景、文化和路线如何不同,训练文本大模型的底层流程,基本都绕不开三个阶段。
我们大模型从业者常开玩笑说:有多少人工,就有多少智能。这不是开玩笑,不信你看。
在 2026 年,顶级大模型公司的内部已经形成了一条极其严密的“工业流水线”:
这种大规模、高精度的精英协作,才是“智能”能够被稳定生产出来的真相。这套“炼金术”的门槛极高,而在这群“炼金术士”中,最激进、最不计代价的一群人,组成了 OpenAI。
在很长一段时间里,当许多研究者仍然试图通过更精巧的结构来提升性能时,OpenAI 内部始终存在一种坚定的信念:只要模型足够大、数据足够多,就会出现无法通过小规模实验预测的能力涌现。这种看似粗暴的路径背后,有一个绕不开的名字——Ilya Sutskever。
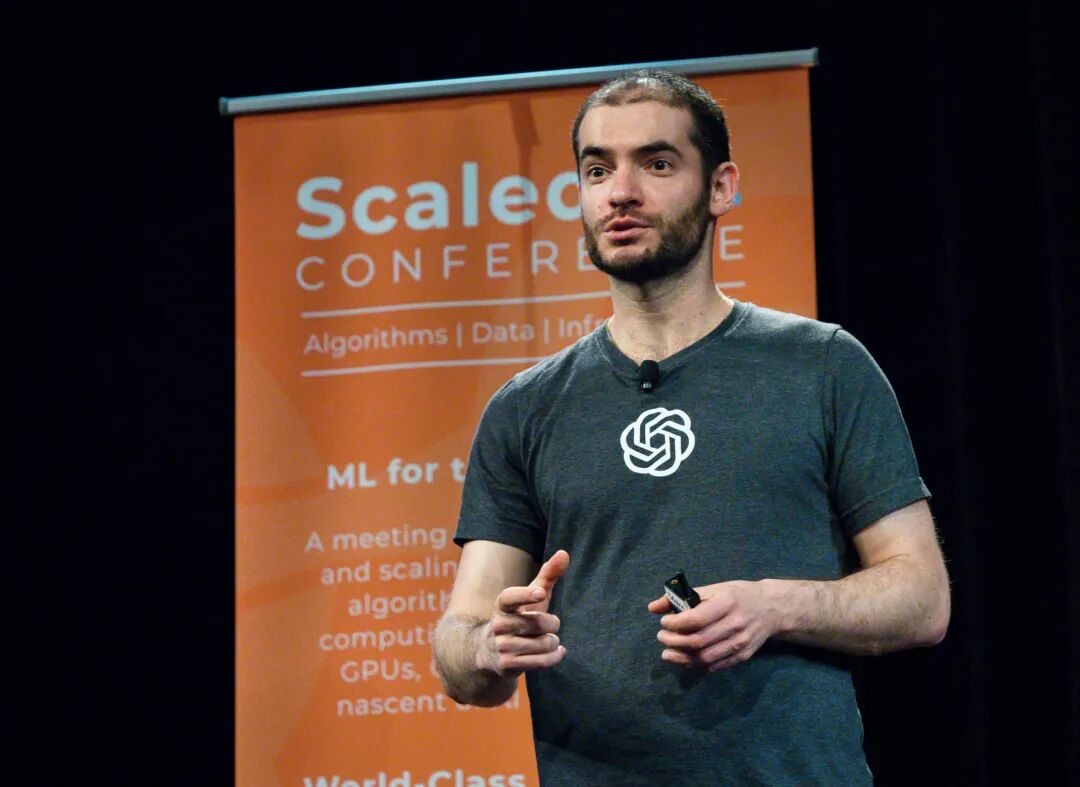
他长期坚持一个判断:智能并不是被“设计”出来的,而是会在足够大的模型和足够复杂的数据中自然涌现。后来从 GPT 系列到 ChatGPT 的一系列结果,逐步验证了这种判断的现实意义。
从 GPT-1 的尝试,到 GPT-2 的惊艳,再到 GPT-3 震撼世界。Open AI一次次打破了人类对机器智力的想象天花板。2022 年底 ChatGPT 的爆发,本质上就是对 Scaling Law“暴力美学”的一次集中体现。
虽然经历了一系列的“宫斗”事件,甚至那位曾指引航向的灵魂人物 Ilya 也最终选择了离开,但 OpenAI 已经完成了它最关键的历史使命:验证了 Scaling Law 在文本领域的普适性。
它对行业最实际的贡献,是把 AI 从“特定任务的专用模型”拉到了“通用逻辑底座”的赛道上。在 GPT 出现之前,工业界习惯于为每一个细分场景单独训练模型;而 OpenAI 证明了,只要基座模型的参数规模和预训练数据足够大,它就能通过极低成本的微调,适配绝大多数下游任务。这种工程范式的改变,直接降低了全球 AI 应用的开发门槛。
从产品表现上看,它正在经历从“预测概率”向“强化推理”的重心转移。
现在的 GPT-5系列 或 o系列 并不再一味追求更大的参数规模,而是引入了更多的测试时计算(Inference-time Compute)。说得通俗点,就是它学会了在输出答案前进行多次自我校对和逻辑推演。这种转变解决了早期 GPT 模型“说话不经大脑”的硬伤,使其在数学、编程和严谨的科研辅助领域更具可用性。
在商业层面,OpenAI 已经从一家研究机构彻底转型为一家极其务实的算力与 API 供应商。
它成功开辟了道路,但也因为这种成功,让它在 2026 年遇到了更多侧面战场的竞争。比如,当 OpenAI 还在死磕推理上限时,它的老对手 Anthropic 和黑马 DeepSeek,已经开始从“调性”和“性价比”上撕开缺口。
进入 2026 年,文本大模型的叙事已经从早期的“大力出奇迹”,演变为一场关于性格、生态与效率的多方混战。
OpenAI 的核心竞争力已经从“参数量”转向了“推理时长”。GPT-5系列 已经不再追求秒回,而是通过强化学习在后台进行逻辑复核。它现在的角色是极其务实的高阶逻辑供应商,专门解决科学发现、架构设计等复杂长链条难题。
Google 走的是端到端生态路子,Gemini 3 的优势在于原生多模态(文本、音视频同步处理)以及与 Android、Workspace 的深度整合,通过全场景覆盖,让用户在查邮件、改文档、刷视频时无缝调用 AI。
Anthropic 依然占据着专业协作市场,Claude 5 的技术路径侧重于超长上下文的极高忠诚度。在处理数百万字的技术文档或法律合规审查时,它的幻觉率依然是行业最低的。
作为最大的黑马,DeepSeek 靠的是极致的工程创新,用不到硅谷厂商 20% 的训练成本,实现了同水平的推理性能,直接把全球大模型 API 的价格压到了近乎免费。
回看文本大模型走过的这十年,人类其实只做对了一件事:我们终于找到了压缩并提取人类文明逻辑的最优解。
从 N-gram 那种笨拙的概率猜测,到 Transformer 这种“一眼万年”的架构,再到 2026 年各家大模型在推理深度上的极限拉扯,本质上都是在不断打磨那颗“数字大脑”的额叶皮层。
文本大模型已经完成了它的第一阶段使命——它向世界证明了,智能是可以被计算的。但如果你问我,2026 年的 AI 真的已经到达终点了吗?答案显然是否定的。
在大模型那看似全能的回答背后,其实还隐藏着几个足以改变行业走向的“秘密武器”:
在下一篇文章里,我想跳出宏大的叙事,拆解这些支撑起 AI 智力的底层技术概念,我们下周见。
本文由 @AI产品泡腾片 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。