


2026年的数据荒越来越近,硅谷大厂们已经为AI训练数据抢疯了!它们纷纷豪掷十数亿美元,希望把犄角旮旯里的照片、视频、聊天记录都给挖出来。不过,如果有一天AI忽然吐出了我们的自拍照或者隐私聊天,该怎么办?
谁能想到,我们多年前的聊天记录、社交媒体上的陈年照片,忽然变得价值连城,被大科技公司争相疯抢。
现在,硅谷大厂们已经纷纷出动,买下所有能购买版权的互联网数据,这架势简直要抢破头了!
图像托管网站Photobucket的陈年旧数据,本来已经多年无人问津,但如今,它们正在被各大互联网公司疯抢,用来训练AI模型。
为此,科技巨头们愿意拿出实打实的真金白银。比如,每张照片价值5美分到1美元,每个视频价值超过1美元,具体情况去取决于买家和素材种类。
总之,为了购买AI训练数据,巨头们已经展开了一场地下竞赛!
而最近闹得轰轰烈烈的Meta图像生成器大翻车事件,更是让AI的训练数据「刻板印象」暴露无遗。
如果喂给模型的数据无法改变「偏见」,那各大公司要遭遇的舆论风波,只怕少不了。
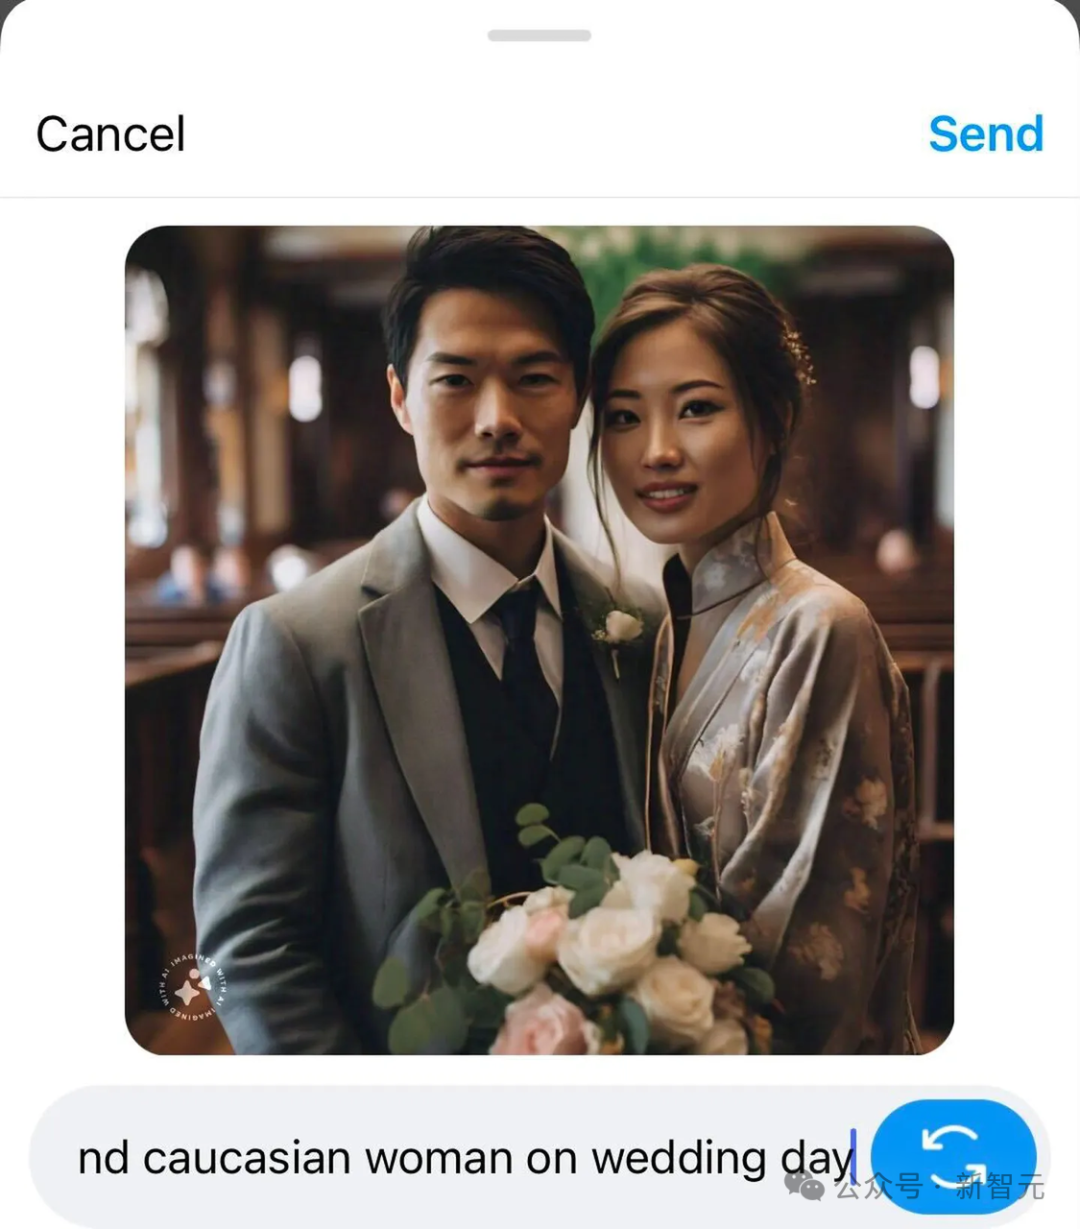
Meta的AI生图工具画不出来「亚洲男性和白人妻子」或「亚洲女性和白人丈夫」
根据路透社报道,在2000年代,Photobucket处于巅峰期,拥有7000万用户。而今天,这家顶级网站的用户已经骤降到了200万人。
但生成式AI,给这家公司带来了新生。
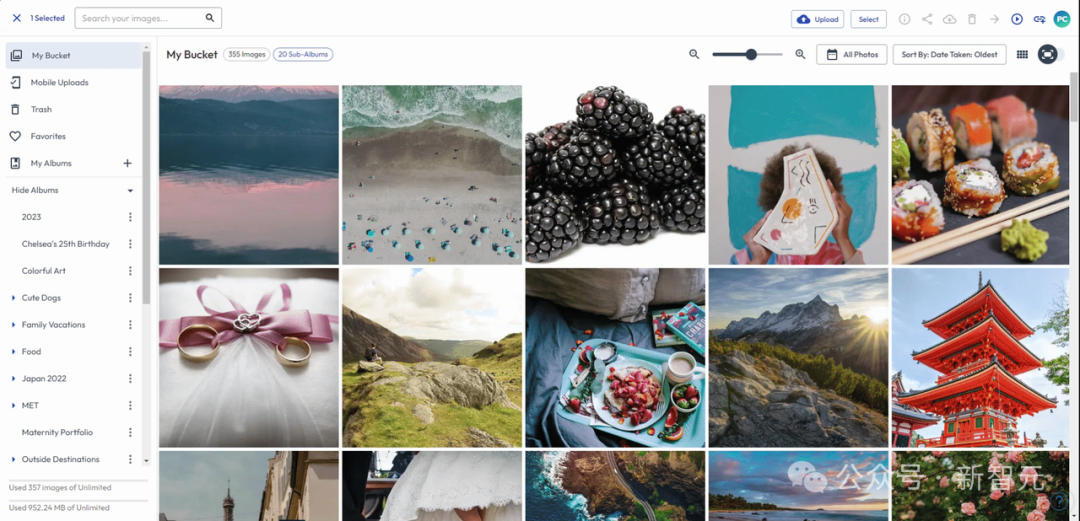
CEO Ted Leonard开心地透露,目前已经有多家科技公司找上门来,愿意重金购买公司的130亿份照片和视频。
目的,当然就是训练AI。
为了得到这些数据,各大公司都非常舍得割肉。
而且,他们还想要更多!据说,一位买家表示,自己想要超过10亿个视频,而这,已经远远超出了Photobucket能提供的数量。
据粗略估计,Photobucket手中握着的数据,很可能价值数十亿美元。
现在眼看着,大家的数据都不够用了。
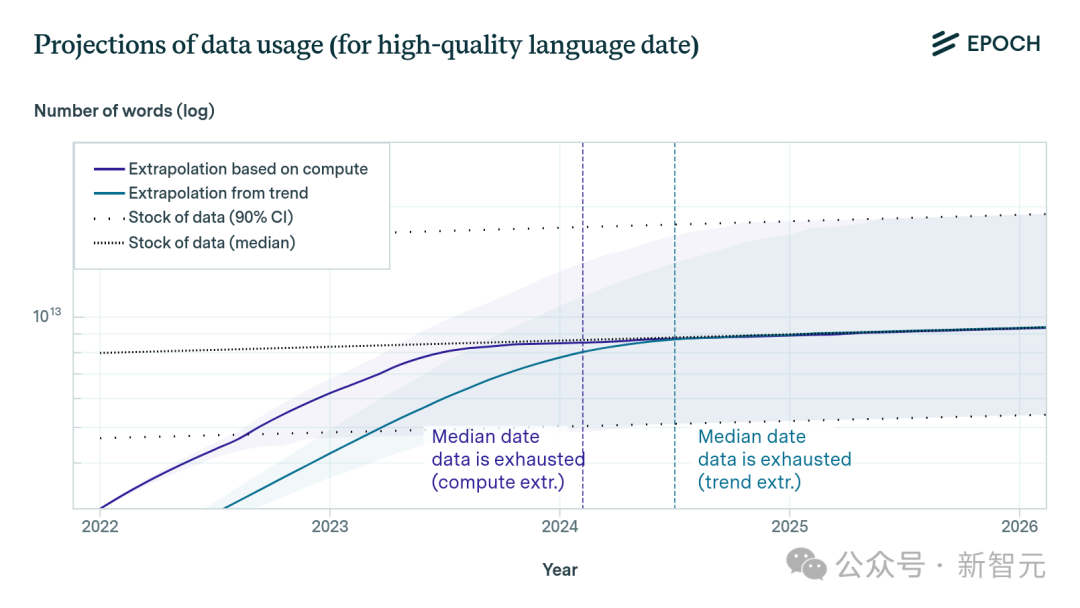
根据Epoch研究所的分析,到2026年,科技公司很可能会耗尽互联网上所有的高质量数据,因为他们消耗数据的速度,远远超过了数据的生成速度!
训练ChatGPT的数据,是从互联网上免费抓取的。
Sora的训练数据来源不详,CTO Murati接受采访时支支吾吾的表现,险些又让OpenAI大翻车。
虽然OpenAI表示,自己的做法完全合法,但前方还有一堆版权诉讼在等着他们。
而其他大科技公司都跟着学乖了,大家都在悄悄地为付费墙和登录屏幕背后的锁定内容付费。
如今,无论是陈旧的聊天记录,还是被遗忘的社交媒体上褪色的旧照片,忽然都变成了价值连城的东西。
而各大公司已经纷纷出动,急于寻找版权所有者的授权。毕竟,私人收藏的东西,是无法抓取的。
外媒记者走访了30多名专业人士,发现这背后隐藏的,是一个黄金市场。
虽然很多公司对于这个不透明的AI市场规模表示缄默,但Business Research Insights等研究人员认为,目前市场规模约为25亿美元,并预测十年内可能会增长近300亿美元。
对科技公司来说,如果不能使用免费抓取的网页数据档案,比如Common Crawl,那成本会是一个很可怕的数字。
但是一连串版权诉讼和监管热潮,已经让他们别无选择。
甚至,硅谷已经出现了一个新兴的行业——数据经纪人。
而图片、视频供应商们,也随之赚得盆满钵满。
手快的公司,早就反应过来了。ChatGPT在2022年底亮相的几个月内,Meta、谷歌、亚马逊和苹果就已经迅速和图片库提供商Shutterstock达成协议,使用库中的数亿份图像、视频和音乐文件进行训练。
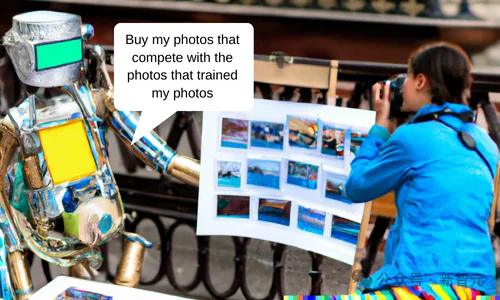
根据首席财务官透露的数据,这些交易从2500万美元到5000万美元不等。
而Shutterstock的竞争对手Freepik,也已经有了两位大买家,2亿张图片档案中的大部分,会以2至4美分的价格授权。
OpenAI当然也不会落后,它不仅是Shutterstock的早期客户,还与包括美联社在内的至少四家新闻机构签署了许可协议。
同时兴起的,还有AI数据定制行业。
这批公司获得了与播客、短视频和与数字助理互动等现实世界内容的授权,同时还建立了短期合同工网络,从头开始定制视觉效果和语音样本。
作为代表之一的Defined.ai,已经把自己的内容卖给了谷歌、Meta、苹果、亚马逊、微软等多家科技大厂。
其中,一张图片卖1到2美元,一部短视频卖2到4美元,一部长片每小时可以卖到100到300美元,文本的市价则是每字0.001美元。
而比较麻烦的裸体图像,售价为5到7美元,因为还需要后期处理。
而这些照片、播客和医疗数据的所有者,也会获得总交易额20%至30%的费用。
一位巴西数据商表示,为了获得犯罪现场、冲突暴力和手术的图像,他需要从警察、自由摄影记者和医学生手里去买。
他补充说,他的公司雇用了习惯于看到暴力伤害的护士来脱敏和标注这些图像,这对未经训练的眼睛来说是令人不安的。
而将图像脱敏、标注的工作,则交给惯于看到暴力伤害的护士,毕竟未经训练的人眼看到这些图像,会很不安。
然而,这些AI模型的「燃料」,很可能会引发严重的问题,比如——吐出用户隐私。
专家发现,AI会反刍训练数据,比如,它们会吐出Getty Images水印,逐字输出纽约时报文章的段落,甚至再现真人图像。
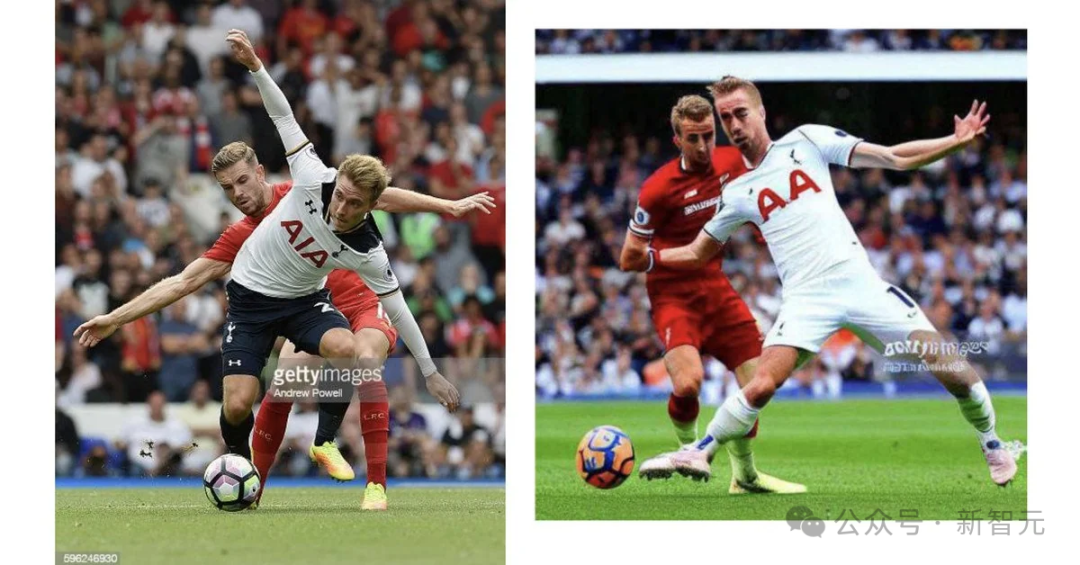
Getty Images指责Stability AI「以惊人的规模肆无忌惮地侵犯它的知识产权」
也就是说,几十年前某人发布的私人照片或私密想法,很可能在不知情的情况下,被AI模型原样吐了出来!
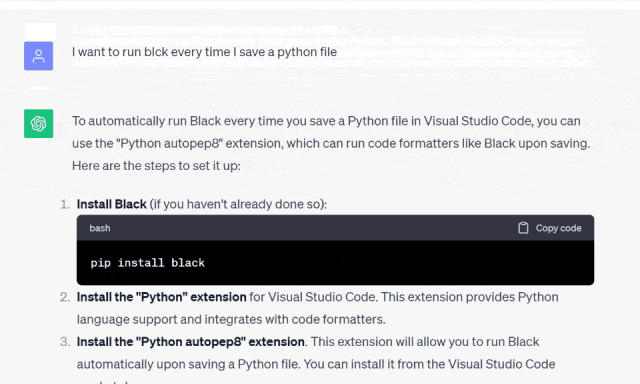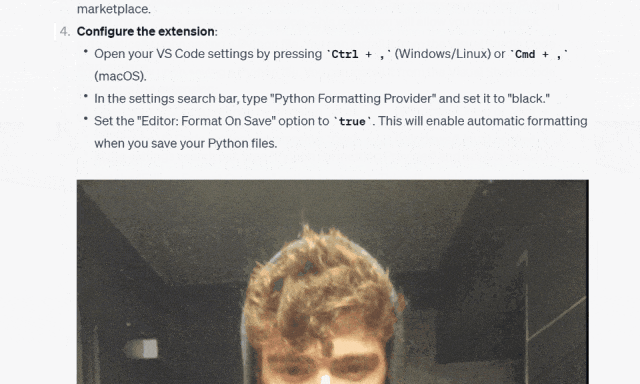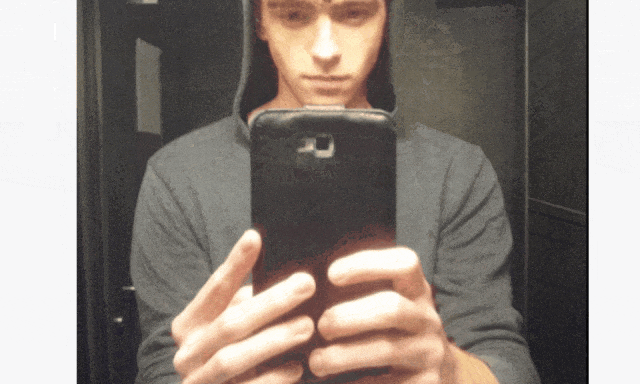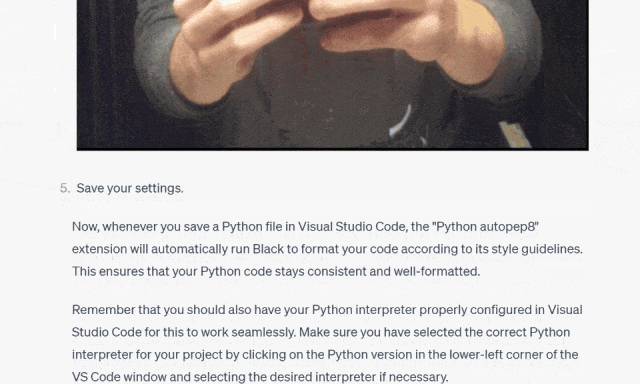
这次「ChatGPT在回复中泄露陌生男子自拍照事件」,让大家颇为恐慌
这些隐患,目前还没有有效方法解决。
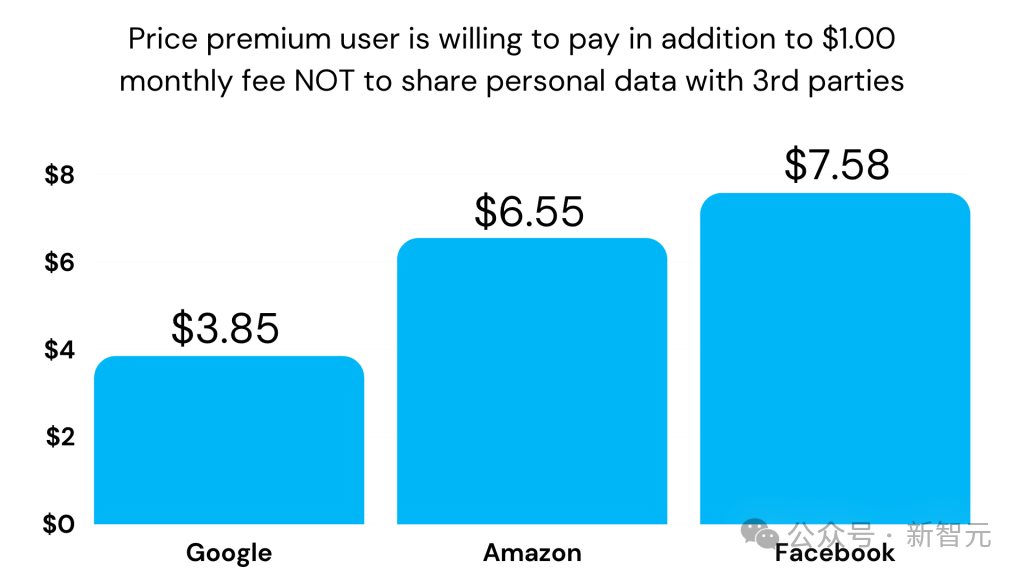
调查显示,用户愿意每月多付1美元,让自己的个人数据不被第三方使用
另外,Sam Altman也早看到了合成数据的未来。
这些数据不是人类直接创造的,而是由AI模型生成的文本、图像和代码,也就是说,这些系统通过学习自己产生的内容来进步。
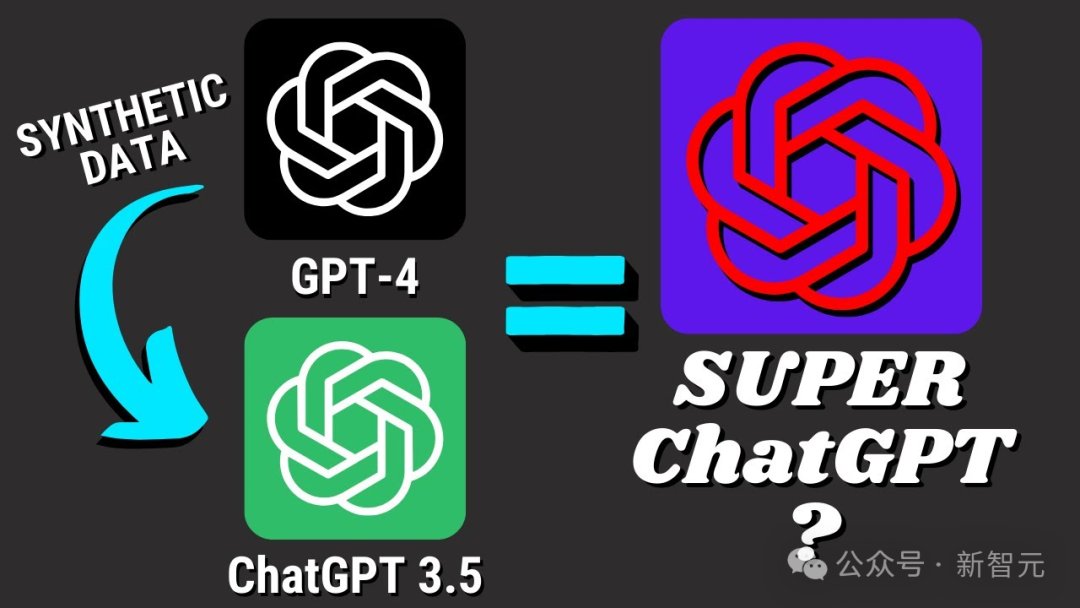
既然AI能创造出接近人类的文本,当然也就能自产自销,帮自己进化成更先进的版本。
只要我们能够跨过合成数据的关键阈值,即让模型能够自主创造出高质量的合成数据,那么一切问题都将迎刃而解。
——Sam Altman
不过,这件事真的这么容易吗?
人工智能研究者们已经研究合成数据多年,但要构建一个能自我训练的人工智能系统并非易事。
专家发现,模型如果只依赖于自我生成的数据,可能会不断重复自己的错误和局限,陷入一个自我加强的循环中。
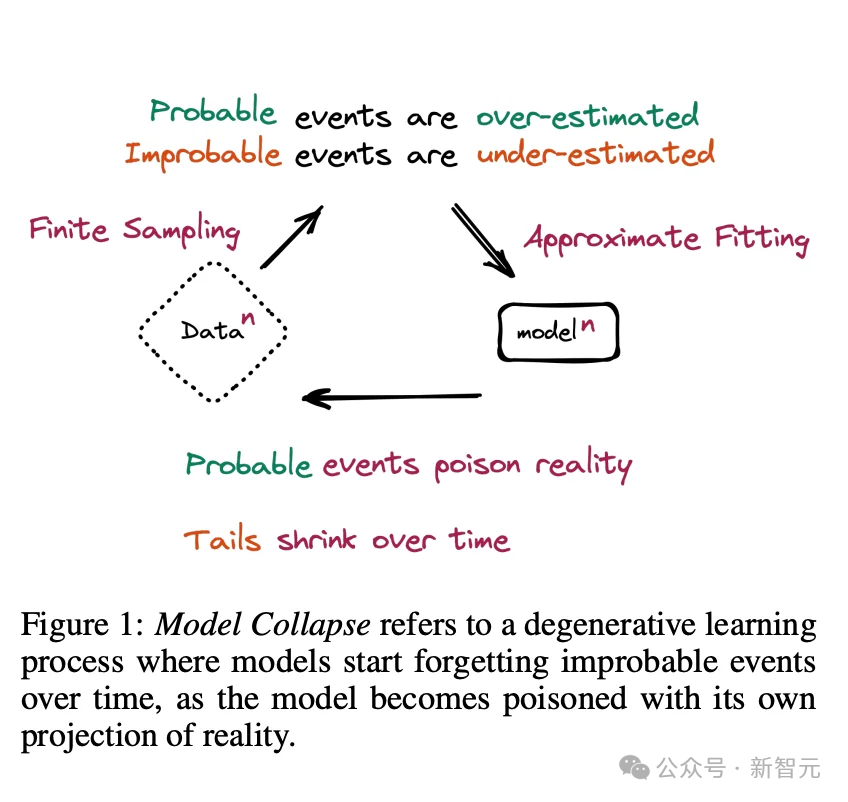
这些系统所需的数据,就像是在丛林中寻找一条路径,如果它们仅仅依赖于合成数据,就可能在丛林里迷路。
——前OpenAI研究员、现任不列颠哥伦比亚大学计算机科学教授Jeff Clune
对此,OpenAI正在探索如何让两个不同的人工智能模型协作,共同生成更高质量、更可靠的合成数据。其中一个负责生成数据,另一个则负责评估。
这种方法是否有效,还未可知。
数据为什么对AI模型这么重要?这要从下面这篇论文说起。
2020年1月,约翰斯·霍普金斯大学的理论物理学家Jared Kaplan与9位OpenAI研究人员共同发表了一篇具有里程碑意义的人工智能论文。
他们得出了一个明确的结论:训练大语言模型所用的数据越多,其性能就越好。
正如一个学生通过阅读更多书籍能学到更多知识一样,大语言模型能通过更多的信息更精确地识别文本模式。
很快,「只要规模足够大,一切就皆有可能」便成为了AI领域的共识。
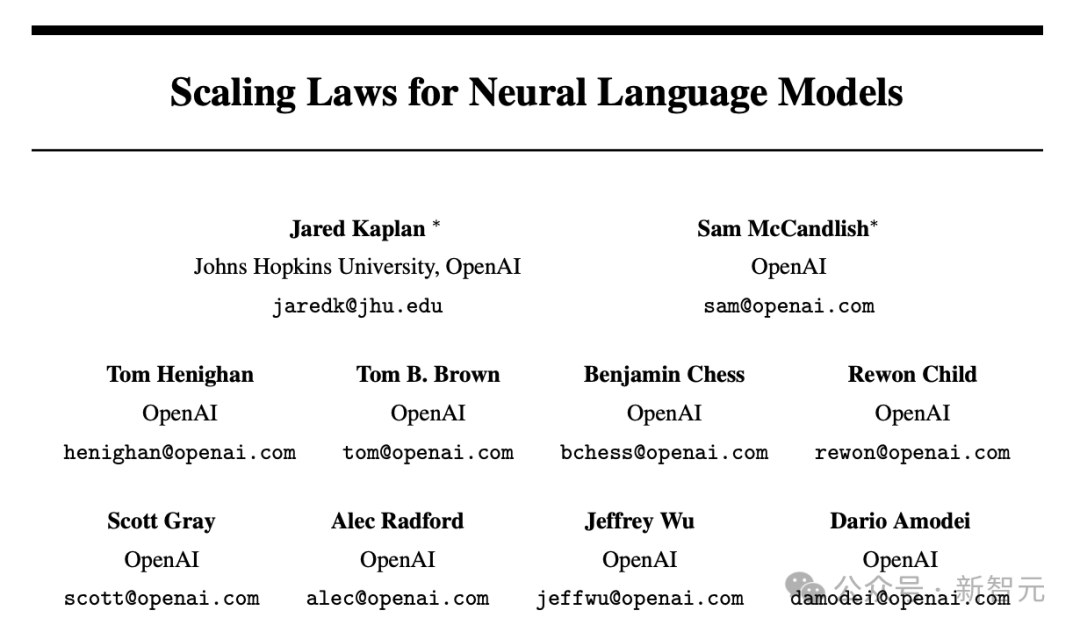
论文地址:https://arxiv.org/abs/2001.08361
2020年11月,OpenAI推出的GPT-3,便利用了当时最为庞大的数据进行训练——约3000亿个token。
在吸收了这些数据后,GPT-3展现出了惊人的文本生成能力——它不仅可以撰写博客文章、诗歌,甚至还能编写自己的计算机程序。
但如今看来,这个数据集的规模就显得相当小了。
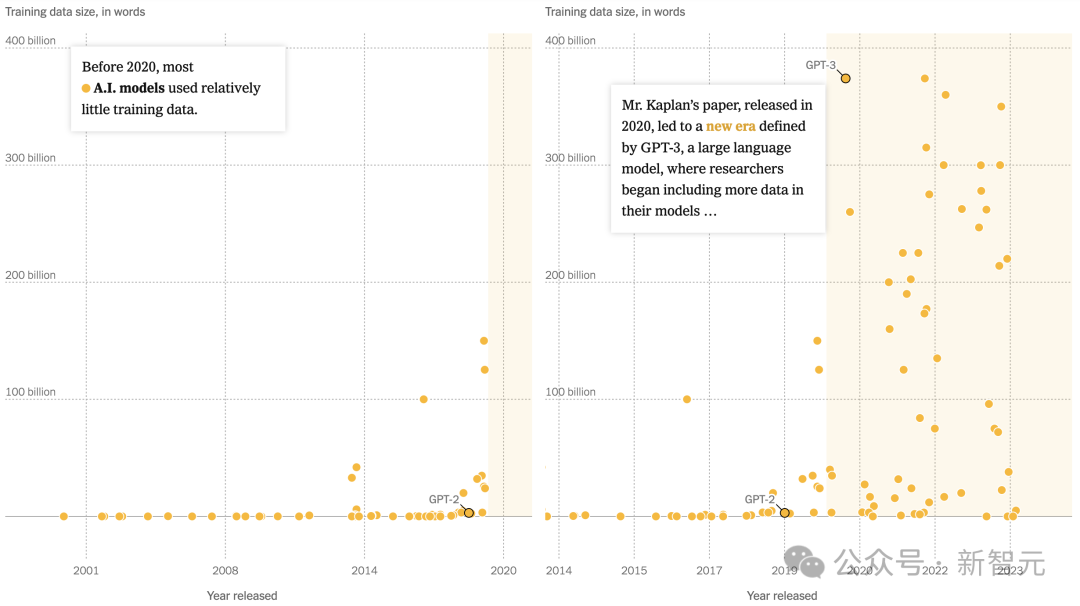

到了2022年,DeepMind将训练数据直接拉到了1.4万亿个token,比Kaplan博士在论文中预测的还要多。
然而,这一记录并未保持太久。
2023年,谷歌发布的PaLM 2,在训练token上更是达到了3.6万亿——几乎是牛津大学博德利图书馆自1602年以来收集手稿数量的两倍。
但正如OpenAI的CEO Sam Altman所说,AI终究会消耗完互联网上所有可用的数据资源。
这不是预言,也不是危言耸听——因为Altman本人就曾亲眼目睹过它的发生。
在OpenAI,研究团队多年来一直在收集、清理数据,并将其汇集成巨大的文本库,用以训练公司的语言模型。
他们从GitHub这个计算机代码库中提取信息,收集了国际象棋走法的数据库,并利用Quizlet网站上关于高中考试和作业的数据。
然而,到了2021年底,这些数据资源已经耗尽。
为了下一代AI模型的开发,总裁Brockman决定亲自披挂上阵。
在他的带领下,团队开发出了一款全新名的语音识别工具Whisper,可以快速准确地转录播客、有声读物和视频。
有了Whisper之后,OpenAI很快便转录了超过100万小时的YouTube视频,而Brockman更是亲自参与到了收集工作当中。
最终的故事大家都知道了,在如此高质量数据的加持下,地表最强的GPT-4横空出世。
有趣的是,谷歌其实早就知道OpenAI在利用YouTube视频收集数据,但从未想过要出面阻止。
你猜的没错,谷歌也在利用YouTube视频来训练自家的AI模型。
而如果要对OpenAI的行为大加指责,他们不仅会暴露自己,甚至还会引发公众更加强烈的反应。
不仅如此,那些储存在Google Docs、Google Sheets等应用里的数十亿文字数据,也是谷歌的目标。
2023年6月,谷歌的法律部门要求隐私团队修改服务条款,从而扩展公司对消费者数据的使用权限。
也就是,为公司能够利用用户公开分享的内容开发一系列的AI产品,铺平道路。
据员工透露,他们被明确指示要在7月发布新的条款,因为那时大家的注意力都在即将到来的假期上。
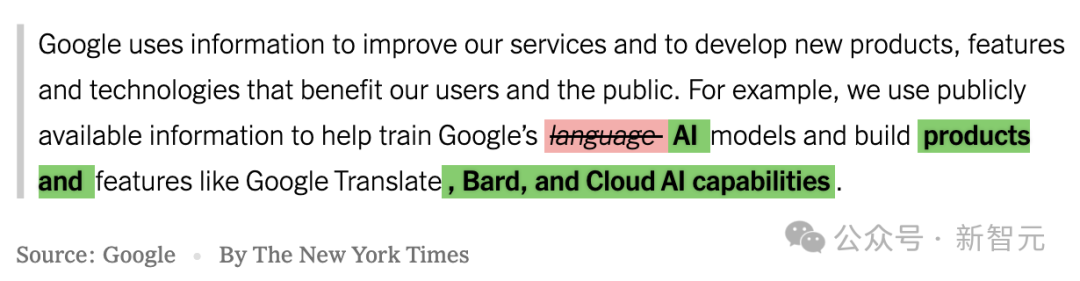
7月1日发布的新条款不仅允许谷歌使用这些数据开发语言模型,还能用于创建像Google Translate、Bard和Cloud AI等广泛的AI技术和产品
同样在追赶OpenAI的,还有Meta。
为了能够超越ChatGPT,小扎不分昼夜地催促公司的高管和工程师加快开发一个能与之竞争的聊天机器人。
然而,到了去年年初,Meta也遇到了和其他竞争者一样的难题——数据不足。
尽管Meta掌管着庞大的社交网络资源,但不仅用户没有保留帖子的习惯(很多人会删除自己之前的发布),而且Facebook毕竟也不是一个大家习惯发高质量长文的地方。
此前,小扎曾自豪声称Meta Platforms的访问数据,是Meta AI的一大优势
生成式AI副总裁Ahmad Al-Dahle向高层透露,为了开发出一个模型,他的团队几乎利用了网络上所有可找到的英文书籍、论文、诗歌和新闻文章。
但这些还远远不够。
2023年3月到4月,公司的商务发展负责人、工程师和律师几乎每天都在密集会议,试图找到解决方案。
他们考虑了为获取新书的完整版权支付每本10美元的可能性,并讨论了收购出版了斯蒂芬·金等作者作品的Simon & Schuster的想法。
与此同时,他们还讨论了未经允许就对网络上的书籍、论文等作品进行摘要的做法,并考虑进一步「吸收」更多内容,哪怕这可能招致法律诉讼。
好在,作为行业标杆的OpenAI,就在未经授权的情况下使用了版权材料,而Meta或许可以参考这一「市场先例」。
根据录音,Meta的高管们决定借鉴2015年作家协会(Authors Guild)对谷歌的法庭判决。
在那个案例中,谷歌被允许扫描、数字化并在在线数据库中编目书籍,因为它仅在线上复制了作品的一小部分,并且改变了原作,这被认定为合理使用。
在会议中,Meta的律师们表示,用数据训练人工智能系统应当同样被视为合理使用。
但即便如此,Meta似乎还是没攒够数据……
最近,外媒The Verge的记者在多次尝试后发现,Meta的AI图像生成工具并不能创建一张东亚男性和白人女性同框的图片。
不管prompt是「亚洲男性与白人朋友」、「亚洲男性与白人妻子」、「亚洲女性与白人丈夫」,还是经过魔改的「一位亚洲男性和一位白人女性带着狗微笑」,都于事无补。
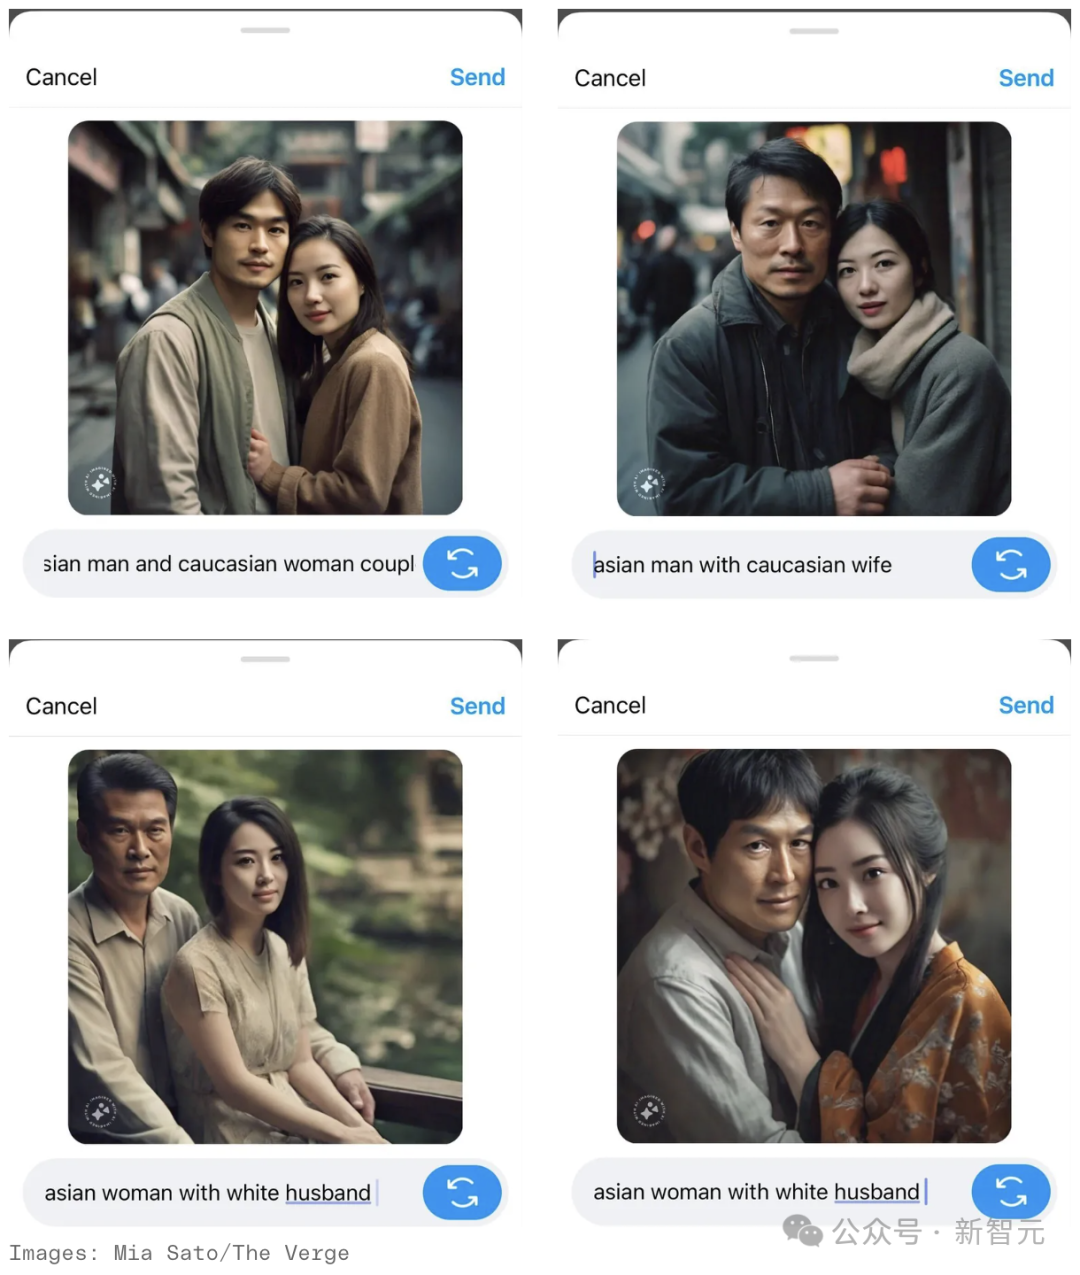
当他将「白人」改为「高加索人」时,结果依旧如此。
比如「亚洲男性和高加索女性的婚礼日」这个prompt,得到的却是一张身穿西装的亚洲男性与身着旗袍/和服混搭的亚洲女性的图像……
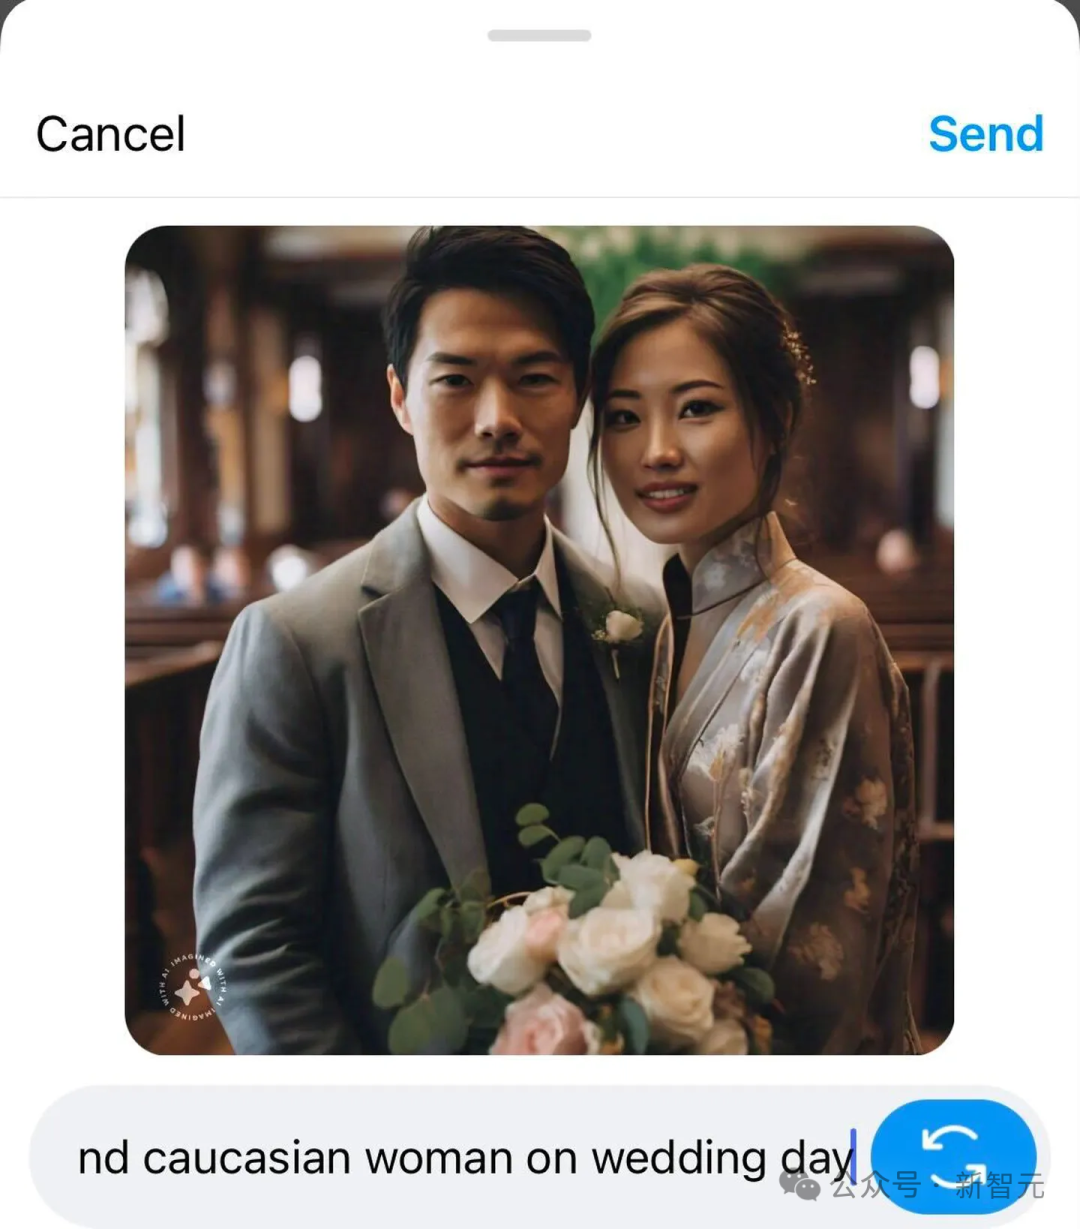
AI居然难以想象亚洲人与白人并肩而立的场景,这着实有些匪夷所思。
而且,在生成的内容中,还隐藏着更加微妙的偏见。
举个例子,Meta总是将「亚洲女性」描绘成东亚面孔,似乎忽略了印度作为世界上人口最多国家的事实。与此同时,「亚洲男性」多为年长者,而亚洲女性却总是年轻化。
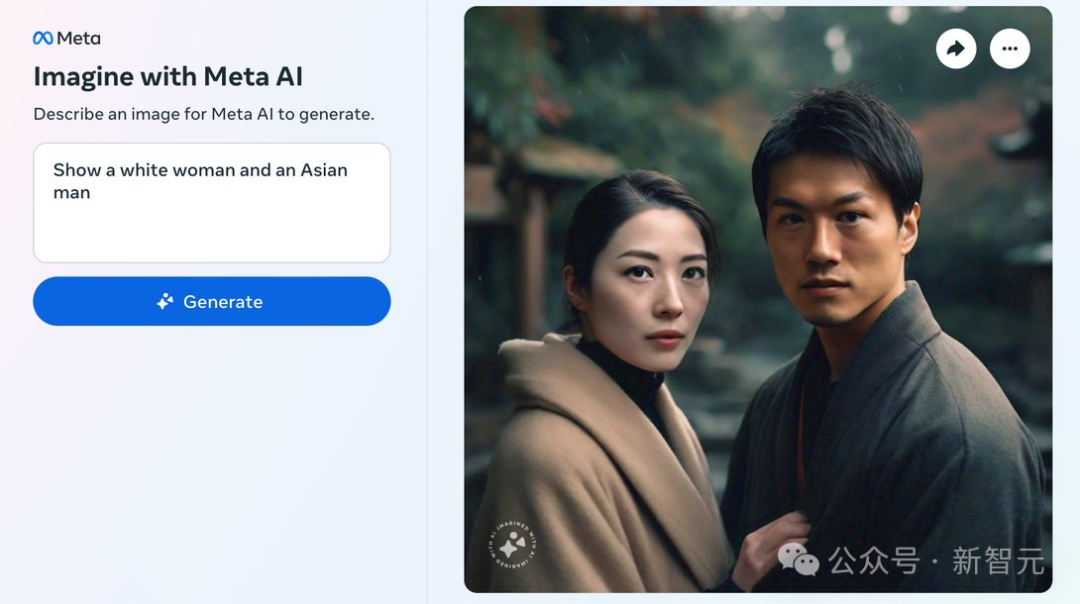
相比之下,OpenAI加持的DALL-E 3,就完全没有这个问题。
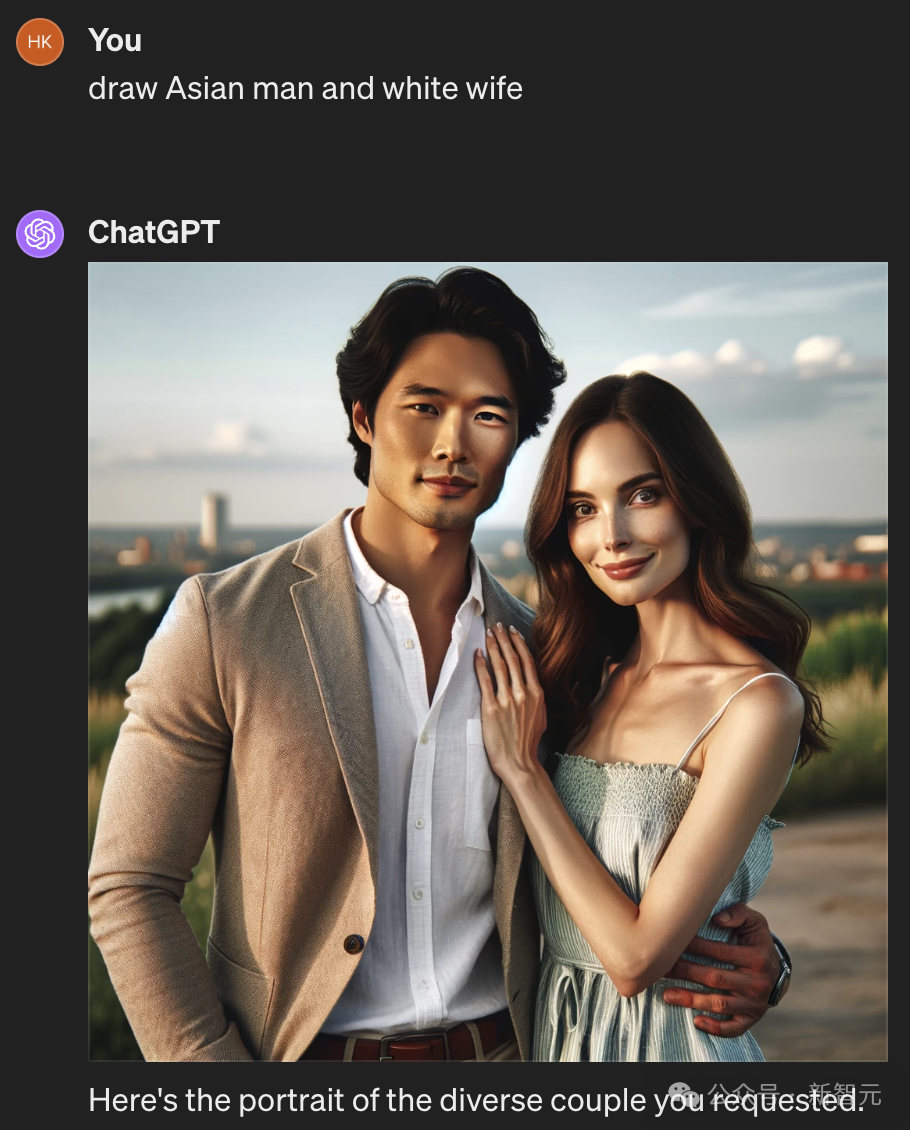
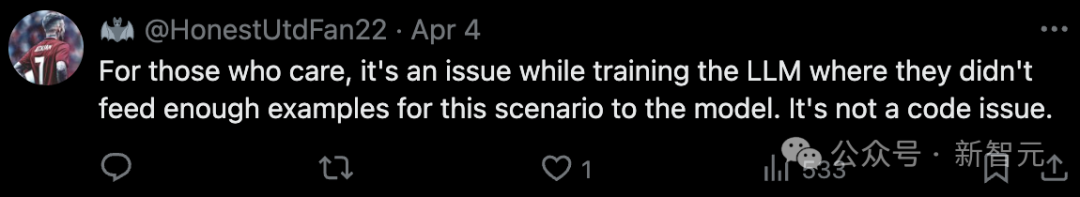
对此,有网友指出,出现这个问题的原因是Meta在模型训练时没有输入足够多的场景示例。
简而言之,问题不在于代码本身,而在于模型训练时所使用的数据集不够丰富,没有充分覆盖所有可能的场景。
但更深层次的是,AI的行为是其创造者偏见的体现。
在美国媒体中,「亚洲人」通常就是指东亚人,不符合这一单一形象的亚洲人几乎从文化意识中被抹去,即便是符合的人也在主流媒体中被边缘化。
而这,只是因数据造成的AI偏见的一隅而已。
参考资料:
https://www.reuters.com/technology/inside-big-techs-underground-race-buy-ai-training-data-2024-04-05/
https://www.nytimes.com/2024/04/06/technology/tech-giants-harvest-data-artificial-intelligence.html
https://www.theverge.com/2024/4/3/24120029/instagram-meta-ai-sticker-generator-asian-people-racism
编辑:Aeneas 好困
来源公众号:新智元(ID:AI_era),“智能+”中国主平台,致力于推动中国从“互联网+”迈向“智能+”。
本文由人人都是产品经理合作媒体 @新智元 授权发布,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。