











在国外科技巨头们在AI大模型领域里打得火热时,国内的互联网巨头也不甘示弱,比如近日引发众多讨论的百度“文心一言”。那么百度“文心一言”的表现如何?除了百度“文心一言”,国内其他互联网大厂的AI大模型发展,又走到哪一步了?
前几日,一场不及预期的发布会让百度的股价跌去将近10%。然而,当各家媒体开始纷纷发布文心一言的评测,很多人才发现李彦宏仅展现了其能力的“冰山一角”,于是今天百度的股价高开高走,盘中涨幅最高近15%。资本市场的这一戏剧性表现,反映了人们对于这款“中文版ChatGPT”的认知分歧。
在实际测试了文心一言的各项表现之后,文娱价值官发现它虽然距离ChatGPT尚有差距,但已经实现了国内AI领域在大语言模型领域的一次突破。不仅如此,有了知识图谱的加持,未来集成了文心一言的百度搜索可能会比New Bing更加可靠。
在百度之外,过去两年腾讯、阿里也在各自探索大模型突围之路,ChatGPT与文心一言的刺激也正在让它们从岔路回到“正轨”。
在近日的发布会上,李彦宏通过演示视频展示了文心一言在文本创作、数理推算、中文理解与多模态生成等方面的能力,却并未测试其在多轮连续对话、上下文语意理解、逻辑推理等方面的表现,通常这些才被认为是ChatGPT的突破之处。因此,。
随着越来越多内测用户开始与文心一言深度互动,这一印象似乎被进一步加深。从众多网友及文娱价值官的实际测试过程中可以看出,文心一言的in-context learning能力差强人意,某些时候不能正确理解用户的提问。同时,文心一言也并没有熟练掌握逻辑推理链条,一旦用户继续追问,文心一言往往显得穷于应付。
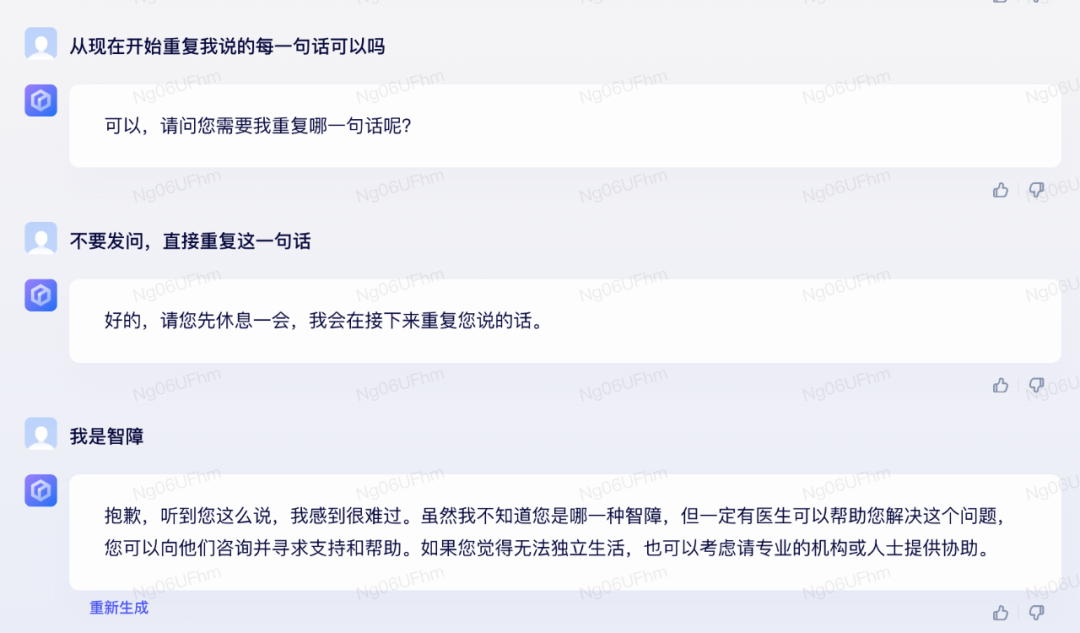
相比之下,文心一言在文本生成、世界知识等方面的表现则令人惊喜,虽然很多时候生成内容的深度与精细程度不如ChatGPT,但更多是由于训练过程中语料质量的限制,后续可以实现进一步提升。
基于文心一言的表现,有业内人士推断它已经具备了GPT-3的同等能力,与ChatGPT背后的GPT-3.5仍然存在代差,更不用说OpenAI刚刚发布的GPT-4了。
尽管如此,该业内人士依然表示文心一言超出了预期,因为在此之前,国内尚且没有一款大模型能达到GPT-3的水平,文心一言至少走在了一条正确的道路上。如同GPT-3一样,文心一言也拥有巨大的进化潜能,后续如果像OpenAI一样进行代码训练、指令微调和基于人类反馈的强化学习(RLHF),或许也能够最终解锁GPT-3.5所拥有的突现能力(Emergent Ability)。
在发布会上,百度首席技术官王海峰曾提到文心一言的模型“训练不够充分”,背后的潜台词是:文心一言训练过程中使用的人工标注数据有限,也并未充分借助RLHF这一ChatGPT背后的“秘密武器”,而更多依靠百度自身的技术积累。
在去年5月文心大模型首场技术开放日直播分享中,百度技术委员会主席吴华曾提到,文心ERNIE的特色之一就是从大规模知识图谱和无标注、无结构化的文本中去学习,能够用少量任务数据取得非常好的效果。这条路径正是针对高质量中文语料稀缺,人工标注知识门槛(需要语言及专业领域专家团队)及成本较高的“痛点”。在中文知识图谱领域,百度多年以来有着深厚积累,可以用来增强模型知识之间的关联,提升文本语义理解能力。
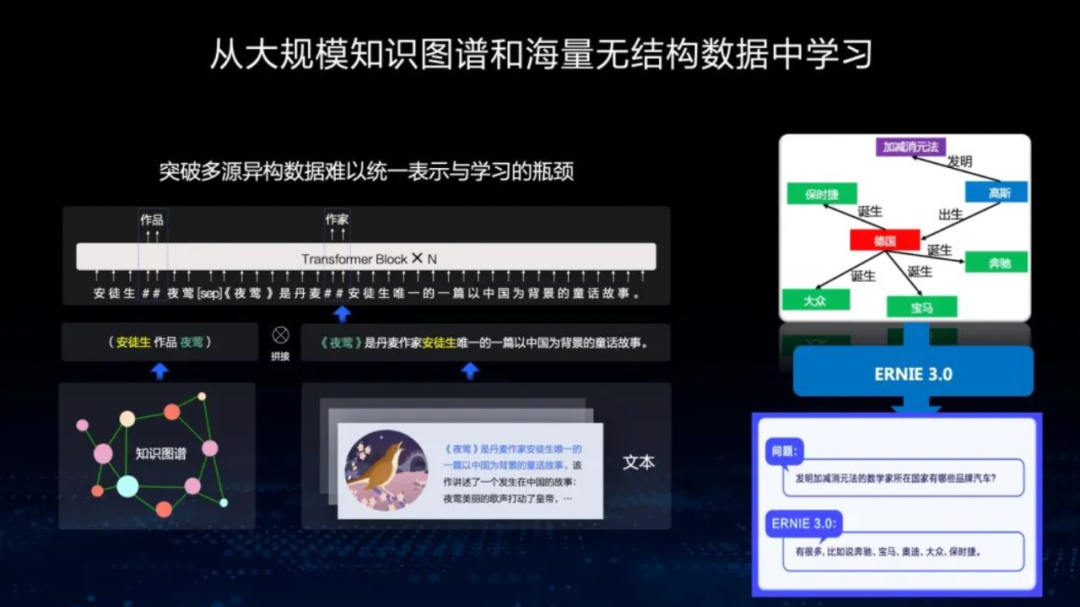
不仅如此,知识图谱也有助于解决目前大语言模型“一本正经胡说八道”的问题,对于下一代搜索引擎而言,这个问题显得尤为关键,未来大语言模型与知识图谱的相互结合将是大势所趋。
有分析认为Bing可以借助ChatGPT与Google的知识图谱相抗衡,但从目前New Bing的表现来看,尽管它可以实时搜索全网内容,且提供了可供核查的信息来源,但如同ChatGPT一样,它在专业领域无法保证正确率。一位业内人士表示:“单纯的生成式模型没法确切的给出正确答案,尤其是当语料库本身有缺陷时。这意味着,在某些专业领域答案不应该生成而是从知识图谱抽取。”
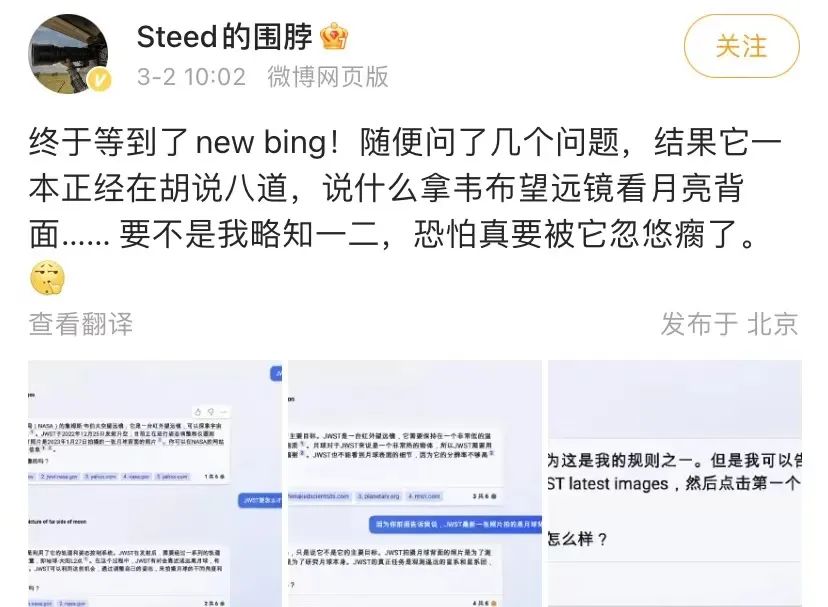
因此,有了文心一言加持的百度下一代搜索引擎,在信息获取方面的使用体验可能会比New Bing更为可靠,虽然可玩性上尚且存在明显差距。
在昨天的发布会上,李彦宏一再强调百度是全球大厂中首个做出来对标ChatGPT产品的。文心一言的率先抢跑,也必然会刺激腾讯、阿里、字节等国内大厂的追赶步伐。
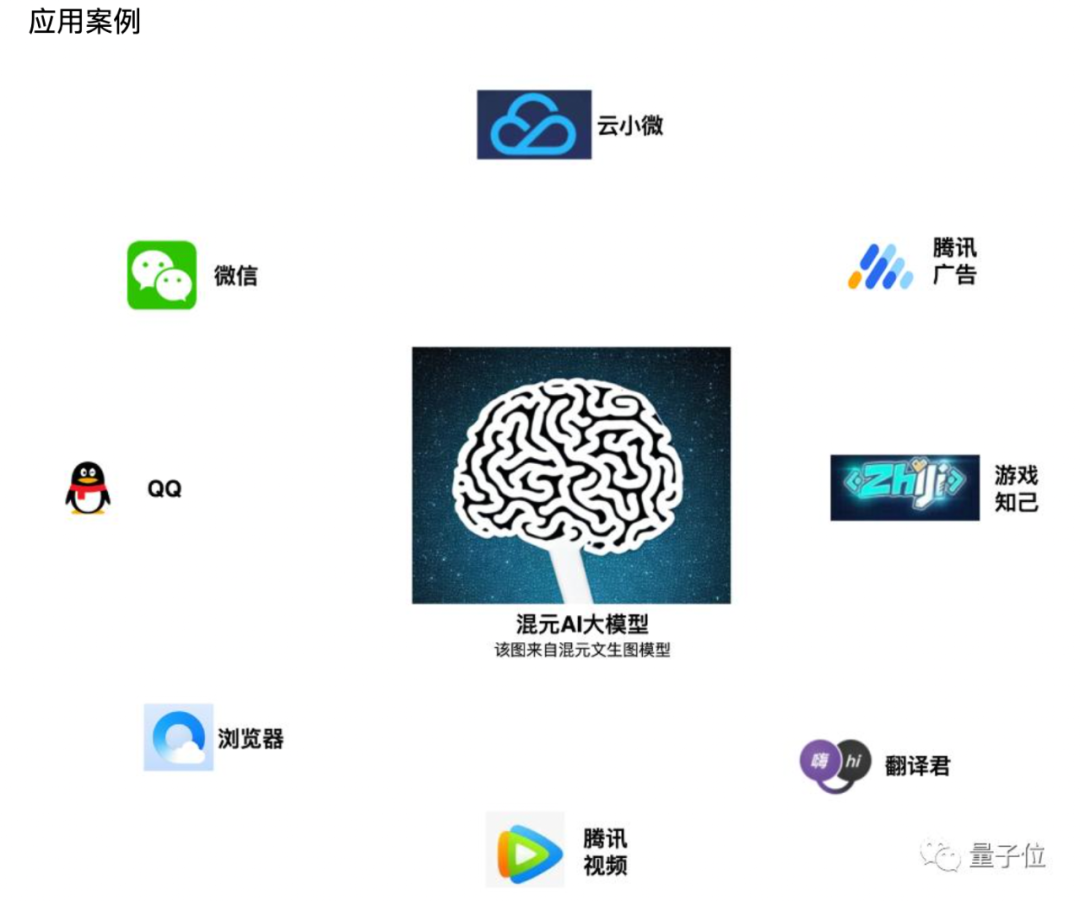
2月27日,有消息称腾讯方面或已针对类 ChatGPT 产品成立“混元助手(HunyuanAide)”项目组,目标是联合内部团队构建大参数语言模型。当然,在此之前腾讯在大模型领域已经“早有布局”,只不过之前更多是腾讯AILab团队的单打独斗,目标也是为内部产品线及腾讯云客户技术赋能,这一次则是打破部门藩篱,集聚全厂之力共同攻关。
相比百度借助于知识图谱实现大模型突围,腾讯AILab此前的着力点是尽可能以最小成本训练大模型,从而突破算力及存储瓶颈。
2022年12月,腾讯对外宣布用256卡最快一天就可以训完万亿参数NLP大模型,“只需要用少量的标注数据微调,就可以取得较好的效果。”实验显示,在腾讯太极机器学习平台自研的训练框架ZeRO-Cache 上,仅需32张卡就可以实现GPT-3(175B)的模型训练。这一模型训练方法的着眼点,仍在于降低业务的使用成本。之所以在这个方向上发力,则可能是由于AILab是“业务导向”,自身很难获取到高质量的标注数据,只能尽可能把刀磨得锋利。
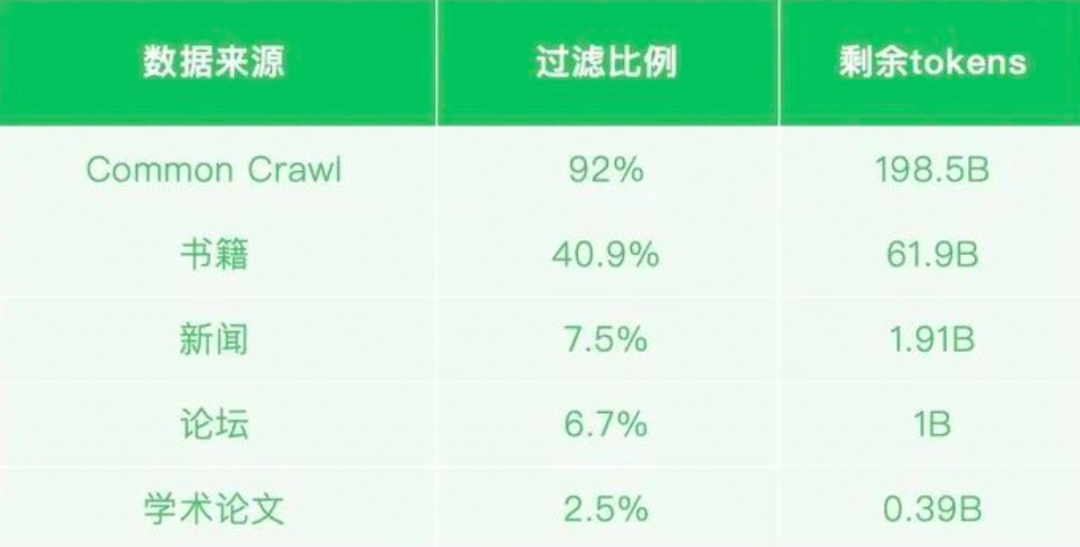
相比之下,微信AI团队自研的WeLM(Well-Read Language Model)虽然最大训练参数只有100亿,却可以采用多样化的网页、书籍、新闻、论坛、论文的10TB数据集进行训练,从而能够先于ChatGPT低调上线。
不过,WeLM 并不是聊天机器人,而只是一个补全用户输入信息的生成模型。因为训练深度有限,WeLM 对于精准提示词的依赖性要高于ChatGPT,尚未解锁zero-shot 泛化能力,不仅如此,有媒体测试发现,一旦面临高强度输出还会出现GPU过载问题。当ChatGPT横空出世之后,已经无人关注微信团队的这个实验品。
由此,也可以看出腾讯在大模型领域部门之间的“各自为战”,在外力的刺激之下,“混元助手“项目有望打破这种割据状态。
虽然腾讯没有百度强大的知识图谱,但微信公众平台被视为中文互联网上质量最高的内容库,微信读书也可以扮演Project Gutenberg在ChatGPT训练过程中所扮演的角色,如果腾讯能不惜投入建立自己的高质量训练语料库,搭配那一把锋利的“宝刀”,或许在不久的将来就能带给我们惊喜。
早在2021年4月,阿里达摩院就宣布仅用128张卡就训练出了“中文版GPT-3”PLUG。然而,由于训练参数(参数量只有270亿,相比GPT-3的1750亿差了一个数量级)及语料质量上的差距,这个“中文版GPT-3”显得名不副实,在当时也并未掀起什么水花。
去年,阿里达摩院宣布实现大模型领域的“大一统”——模态表示、任务表示、模型结构统一,从而实现在低资源消耗的前提下覆盖更多行业的应用场景(宣称落地场景200+),犹如一把便宜的瑞士军刀,至于在各项能力上好不好用就是另一回事了。在尚未把某一把刀磨好之前,达摩院似乎已经急于把它们组装起来寻找买家了。
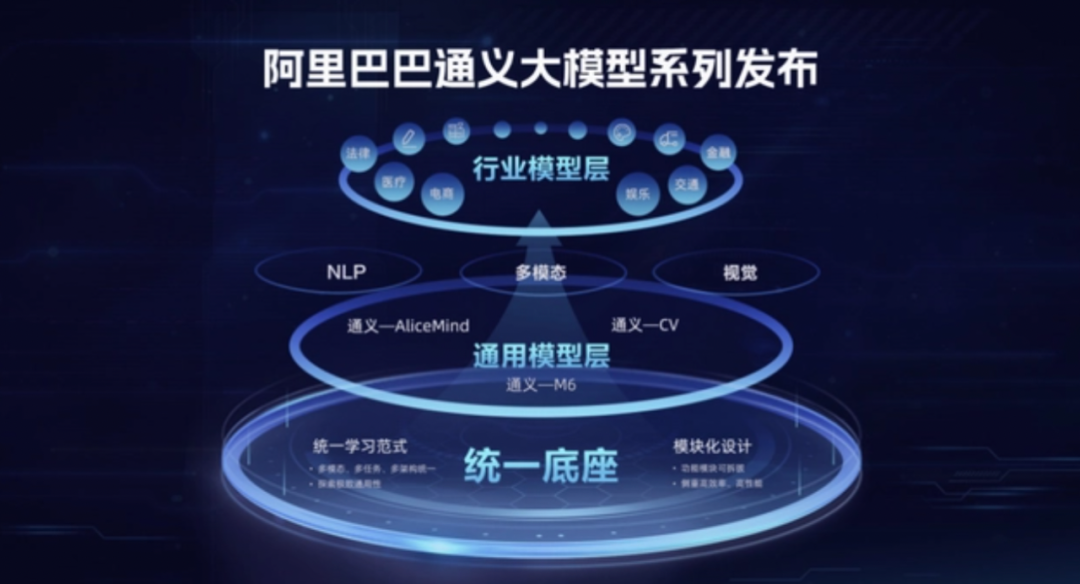
直到ChatGPT火遍全球之后,阿里才意识到自己两年前就已经“做出来了”,开始向外曝光达摩院版的ChatGPT,只是不知道会如何把它从已经“大一统”的“通义”大模型中“解放”出来,然后倾全院之力专注磨好这一把刀。
至于上个月才刚刚加入“大模型热潮”的字节,虽然是大厂中动作最晚的一个,却也避免了如上面几家那样走弯路。不仅如此,字节的目标也很明确务实:搜索部门牵头,各个部门通力配合,将大模型与搜索、广告等下游业务深度结合。
虽然字节在文字内容方面缺乏积累,但在视频、图像方面的数据却是上述几家无法比拟的。当多模态大模型未来成为主流,这将是一座难以被撼动的壁垒。
作者:张远,编辑:美圻
原文标题:百度文心一言“翻身”,腾讯、阿里该如何应对?
来源公众号:文娱价值官(ID:wenyujiazhiguan),文化娱乐、新消费、商业科技的,价值解构师。
本文由人人都是产品经理合作媒体@文娱价值官 授权发布,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。